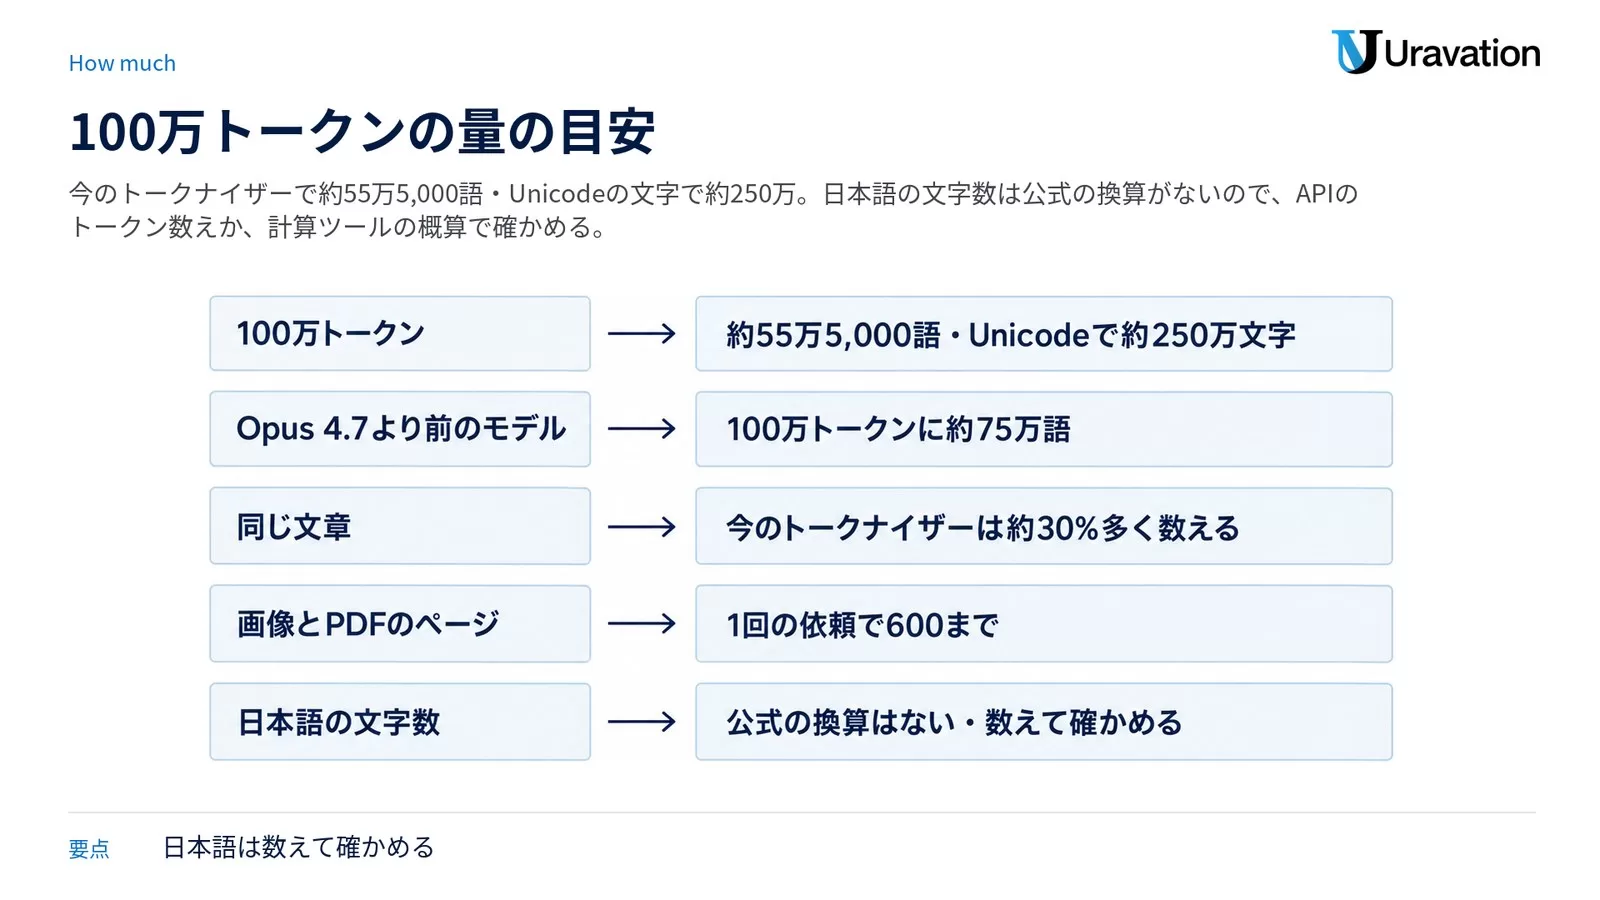
結論:100万トークン(1Mトークン)は、公式の目安で約55万5,000語、Unicode の文字で約250万文字の量です(今のトークナイザーの場合。Opus 4.7 より前のモデルでは約75万語)。日本語の文章で何文字になるかは、公式の換算がありません。日本語の資料は、当サイトのトークン計算ツールに貼ると概算でき、より正確に数えるなら Anthropic の API のトークン数え(token counting)を使います。この記事は2026年10月18日時点で確認した公式の資料をもとに整理したものです。
- 要点1:画像と PDF のページも文脈のトークンに数えられる。1回の依頼に入れられるのは600まで(文脈が20万トークンのモデルは100まで)
- 要点2:Claude Code では、Fable 5.1・Fable 5・Sonnet 5 以降・Haiku 5.5・Opus 4.7 以降が最初から100万で動き、設定は要らない。Pro・Max・Team・Enterprise・API の既定のモデルもこの中に入る。Opus 4.6 と Sonnet 4.6 だけは正式な名前に [1m] を付け、使えるかはプランで決まる
- 要点3:Anthropic の API では、20万トークンを超えても割増はない(Haiku 5.5 だけは10万トークンを超えると高くなる)
- 要点4:最初から100万のモデルは、既定で約96万7,000トークンで自動の要約(圧縮)が始まる。/autocompact で始まる量を決められる
- 要点5:会話が長いと、依頼のたびに会話の全部を送るので使用量が増える。別の仕事に移る時は /clear で新しく始める
対象読者:「100万トークン」がどのくらいの量かを知りたい人、Claude Code で長い資料や大きなコードを扱いたい人。この記事は Claude Code と Anthropic の API の話で、claude.ai のチャットは扱いません。
トークンの仕組みはAIのトークンとは、Claude 以外の AI が一度に扱える量との比較は主要AIモデルのコンテキスト長の比較、Claude Code そのものはClaude Codeとはで整理しています。
100万トークンはどれくらいの量か|約55万5,000語・Unicodeで約250万文字
トークンは、Claude が文章を区切って数える単位で、文章をトークンに区切る仕組みをトークナイザーと呼びます。100万トークンとは、Claude が応答を作る時に参照できる文脈(コンテキストウィンドウ)の大きさです。Claude Code では、会話の履歴、読み込んだファイル、コマンドの出力、CLAUDE.md、自動メモリー、読み込んだスキル、システムの指示が、すべてこの文脈に入ります。英語の公式の資料では、この大きさの文脈を「1M context window」と書きます(略して「1Mコンテキスト」とも言います)。
公式のモデルの一覧によると、100万トークンは、今のトークナイザーで約55万5,000語、Unicode の文字で約250万文字です。このトークナイザーは Opus 4.7 から使われていて、それより前のモデルでは、100万トークンに約75万語が入りました。同じ文章でも、今のトークナイザーでは、Opus 4.7 より前のモデルよりおよそ30%多いトークンに数えられます(増え方は中身で変わる)。
| 文脈の大きさ | 公式の目安(2026年10月18日時点) |
|---|---|
| 100万トークン(今のトークナイザー) | 約55万5,000語・Unicode の文字で約250万文字 |
| 100万トークン(Opus 4.7 より前のモデル) | 約75万語 |
| 20万トークン | 約15万語(どのトークナイザーでの数かは書かれていない) |
日本語の文章の文字数に直した換算は、公式の資料にありません。上の「約250万文字」は Unicode の文字で数えた目安で、どの言語の文章での目安かは公式に書かれていないので、日本語の文字数には当てはめられません。日本語の資料が何トークンになるかは、当サイトのトークン計算ツールに文章を貼ると、文字数と推定トークン数が出ます(決まった換算での概算です)。より正確に数えるなら、Anthropic の API のトークン数え(token counting)を使います。トークン数えは無料で使え(1分あたりの回数に上限があり、数は見積もりで、実際と少しずれることがある)、画像と PDF も数えられます。トークナイザーが変わったので、Opus 4.7 より前のモデルで数えた数を、今のモデルの費用や文脈に収まるかの見積もりに使わないよう、公式は書いています。
画像と PDF も、文脈のトークンに数えられます。1回の依頼に入れられる画像か PDF のページは600まで(文脈が20万トークンのモデルは100まで)で、たくさんの画像や大きな文書を送ると、トークンの上限より先に、依頼の大きさの上限に当たることがあります。Claude Code は依頼のたびに会話の全部を送るので、前に見せた画像も数に入ります。Claude Code は画像と PDF の合計の大きさにも上限を設けているので、大きなスクリーンショットは少ない枚数で上限に当たります。上限を超えそうになると、古い画像と PDF からまとめて外し、外した画像は Claude から見えなくなります(要る時はもう一度見せます)。
API の1回の依頼で出せる出力は、100万トークンのモデルでも最大12万8,000トークン(max_tokens)です。
Claude Codeで100万トークンを使えるモデル|最初から100万と[1m]
Pro・Max・Team・Enterprise・API の既定のモデルのまま使っているなら、Claude Code は最初から100万トークンで動いていて、設定は要りません。自分の場合は、次の順に確かめます。
- 今のモデルを見る:
/statusか、設定していればステータスラインで、今どのモデルで動いているかを見る - 表で判断する:下の表の「最初から100万」のモデルなら何もしない。Opus 4.6 か Sonnet 4.6 なら、プランの表で使えるかを見て、正式な名前に [1m] を付ける
- 100万になったかを見る:ステータスラインの文脈の大きさ(
context_window.context_window_size)が100万なら、100万の文脈で動いている
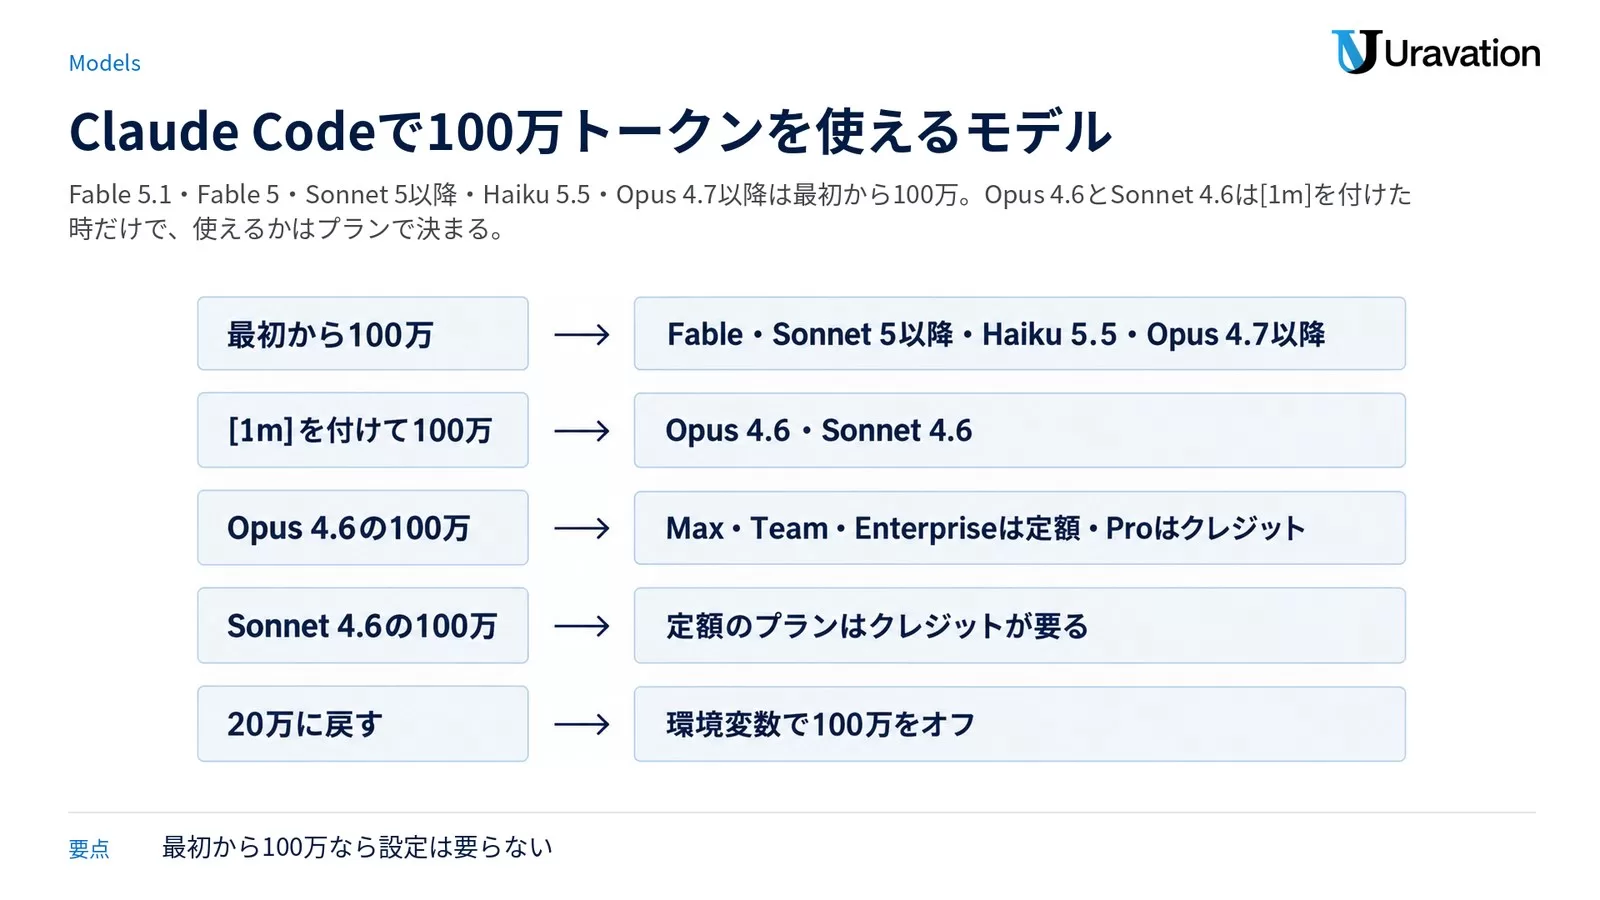
Claude Code の公式の資料では、100万トークンの文脈(extended context)に対応するのは、Fable 5.1・Fable 5・Sonnet 5 以降・Haiku 5.5・Opus 4.6 以降・Sonnet 4.6 です。このうち次の表の上の段のモデルは、最初から100万トークンで動き、[1m] を付ける必要はありません。
| 分け方 | モデル | 100万にするには |
|---|---|---|
| 最初から100万 | Fable 5.1・Fable 5・Sonnet 5 以降・Haiku 5.5・Opus 4.7 以降 | そのまま(設定は要らない) |
| [1m] を付けた時だけ100万 | Opus 4.6・Sonnet 4.6 | 正式な名前に [1m] を付ける(使えるかはプランで決まる) |
Amazon Bedrock・Google Cloud の Agent Platform・Microsoft Foundry のセッションでも、最初から100万のモデルを選べば100万で動きます。ただし、これらの提供元では、別名や既定のモデルが古いモデルを指すことがあります。Bedrock と Google Cloud の sonnet は Sonnet 4.5、Foundry の opus は Opus 4.6、Foundry の既定のモデルは Sonnet 4.5 です。Sonnet 4.5 は20万トークンのモデルなので、クラウドの提供元では、モデルを正式な名前で選び、/status で確かめます。
Opus 4.6 と Sonnet 4.6 の100万トークン版を使えるかは、プランで次のように決まります。Team は Standard と Premium のどちらの席も含みます。使用量のクレジットは、プランの使用量の上限を超えて使うための別払いの分で、Pro と Max では claude.ai の Settings > Usage で入れたり切ったりします。
| プラン | Opus 4.6 の100万トークン | Sonnet 4.6 の100万トークン |
|---|---|---|
| Max・Team・Enterprise | 定額に含まれる | 使用量のクレジットが要る |
| Pro | 使用量のクレジットが要る | 使用量のクレジットが要る |
| API・従量課金 | すべて使える | すべて使える |
最初から100万のモデルでも、Fable は、プランや席によって、プランに含まれる枠ではなく使用量のクレジットから引かれることがあります。その時は、/model の一覧の Fable の行に「Requires usage credits」と出ます。
Claude Code がこのプランの条件を確かめるのは、Anthropic の API に直接つなぐ時です。ANTHROPIC_BASE_URL で LLM ゲートウェイ(間に置く中継のサーバー)を通し、claude.ai のログインのまま使う時は、Claude Code はこの条件を確かめません。[1m] の版は /model に出たままで、通るかどうかはゲートウェイの側で決まります。
[1m]の付け方と20万トークンに戻す方法
Opus 4.6 か Sonnet 4.6 を100万トークンで使う時は、/model で、モデルの正式な名前の後ろに [1m] を付けます。
/model claude-opus-4-6[1m]
/model claude-sonnet-4-6[1m]
[1m] は別名にも付けられ、その別名が指すモデルに効きます。ただし Anthropic の API では今、opus は Opus 5.5、sonnet は Sonnet 5.5 を指します。どちらも最初から100万なので、opus[1m] や sonnet[1m] にしても変わらず、4.6 にもなりません。[1m] は、opus が Opus 4.7 以降、sonnet が Sonnet 5.5 か Sonnet 5 を指す時は効きません。別名で 4.6 になるのは、Microsoft Foundry の opus のように、別名が 4.6 を指す時だけです。今どのモデルで動いているかは、/status か、設定していればステータスラインで確かめます。
逆に、セッションを20万トークンにとどめたい時は、環境変数 CLAUDE_CODE_DISABLE_1M_CONTEXT=1 をシェルか設定ファイルで設定します。/model の一覧から [1m] の版が消え、最初から100万のモデルも20万トークンの文脈として扱われます。自動の要約が有効なら20万で要約され、要約が始まる量を20万より大きく決めても20万で止まります。自動の要約を切っている時は、20万で文脈の上限のエラーになって止まります。
100万トークンの料金|APIは20万を超えても割増なし
Anthropic の API では、100万トークンの文脈は通常の料金のままで、20万トークンを超えた分にも割増はありません。公式は「90万トークンの依頼も、9,000トークンの依頼と同じトークンあたりの料金」と書いています。プロンプトのキャッシュとバッチ処理の割引も、文脈の全体にそのまま効きます。API を直接呼ぶ時は、100万トークンのモデルは何も付けずに100万で使え、ベータのヘッダーも要りません([1m] は Claude Code でモデルを選ぶ時の書き方です)。
例外は Haiku 5.5 で、プロンプトが10万トークンを超える依頼は、トークンあたりの料金が高くなります。プロンプトの長さは、キャッシュの読み出しと書き込みも含めて、依頼ごとに数えます。
Claude の定額のプランで使う時は、100万トークンが定額に含まれる組み合わせ(Max・Team・Enterprise の Opus 4.6 など)なら定額の中で、使用量のクレジットで使う組み合わせならクレジットから引かれます。料金の額は変わることがあるので、公式の料金のページで確かめます。
長い会話で使用量が増える理由|定額のプランの注意
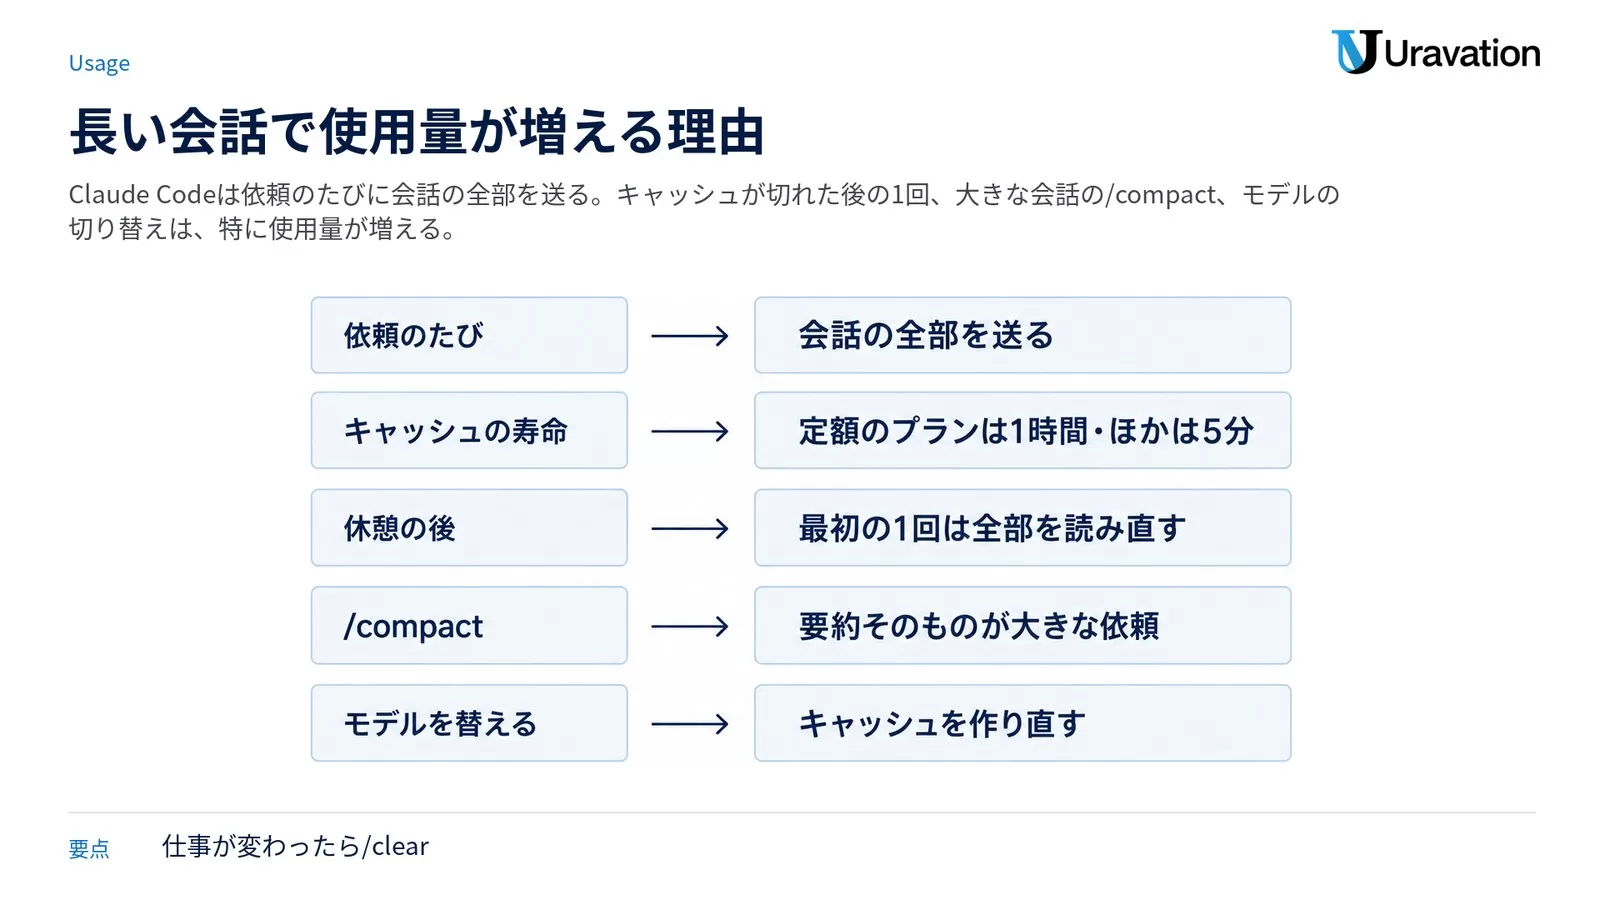
Claude のモデルは依頼と依頼の間で何も覚えていないので、Claude Code は依頼のたびに、会話の全部を送り直します。キャッシュは、前の依頼で読んだ所を使い回して、変わった所だけを読む仕組みで、使い回した分は安い料金で数えられます。公式の費用の資料と prompt caching の資料から、100万トークンの文脈で効きやすいものを4つ挙げます。
- 依頼のたびに会話の全部を送る:Claude Code は、依頼のたびに会話の全部を送り、ツールを使うたびに、その結果を載せた依頼をもう1回送る。キャッシュで読み直すので安くはなるが、1日開いたセッションでは、1行の質問でも会話全体を読む分の使用量がかかる
- 休憩の後はキャッシュが切れる:休憩がキャッシュの寿命より長いと、次の1回はキャッシュに当たらず、文脈の全部を読み直す。寿命は、定額のプランで1時間(元の会話の依頼の分。サブエージェントは定額のプランでも5分)、使用量のクレジットを使っている間は5分、API キーやクラウドの提供元では既定で5分
- /compact も大きな依頼:/compact は要約する会話を読むので、大きな文脈を要約すること自体が大きな依頼になる。続きが要らない時は、/clear なら使用量はかからない
- モデルを替えると読み直し:キャッシュはモデルごとに別なので、モデルを替えると、同じ内容でも依頼の全体を計算し直す(次の1回が遅く、高くなる)
このほか、放っておいた間に動く予定の作業や、ほかのセッションから届くメッセージ、ゴールの確かめも、そのたびに文脈の全部を送ります。Pro・Max・Team・Enterprise のプランでは、/usage に、最近の使用量の10%以上を占める使い方(長い文脈やキャッシュの外れなど)と、減らすコツが出ます。/usage の見方と effort の使い分けはClaude Codeの費用の見方で整理しています。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修6,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
自動の要約(圧縮)|約96万7,000トークンで始まる
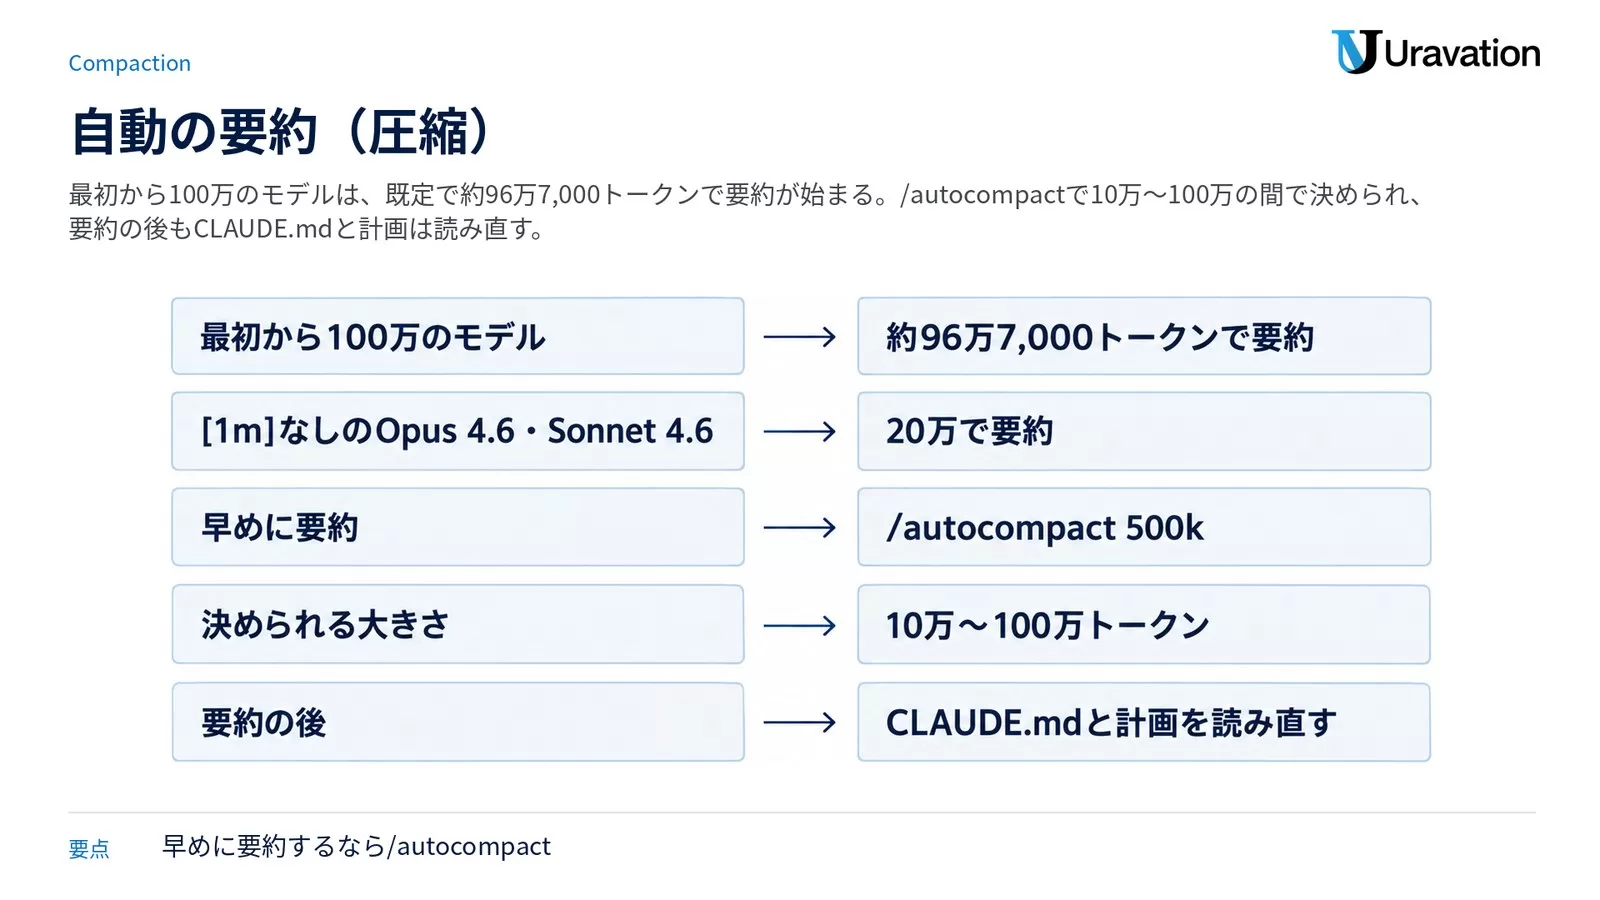
Claude Code は、文脈の上限に近づくと会話を自動で要約(圧縮)するので、文脈がいっぱいになってもセッションは終わりません。最初から100万で動くモデル(Fable・Sonnet 5 以降・Haiku 5.5・Opus 4.7 以降)は、既定では、文脈が埋まる前の約96万7,000トークンで要約が始まります。[1m] を付けない Opus 4.6 と Sonnet 4.6、20万に戻す設定をした時は、20万トークンで要約されます。[1m] を付けた Opus 4.6 と Sonnet 4.6 は、要約が始まる量を決めなければ、文脈の上限で要約されます。100万トークンでも、要約の仕組みは同じです。
要約が始まる量は、次の所で変えられます。
| どこで変えるか | 書き方 |
|---|---|
| 今のモデル(このセッションと次から) | /autocompact 500k のように送る(ユーザーの設定にモデルごとに残る) |
| すべてのモデル | 設定ファイルに "autoCompactWindow": 200000 |
| 1回の起動だけ | 起動の時に --autocompact 500k のように値を付ける |
| スクリプトとクラウドの環境 | 環境変数 CLAUDE_CODE_AUTO_COMPACT_WINDOW(ほかの指定より優先) |
/autocompact と --autocompact には、10万〜100万トークンを、200000 のような数、500k や 1M のような単位つき、100〜1000 の数(千の単位で、200 は20万)のどれでも書けます。環境変数は数だけです。モデルの文脈の大きさを超える値は、その上限で止まります。
要約の後に残るもの
自動の要約か /compact の後、会話は要約に置き換わります。会話の中で伝えただけの指示は、要約で消えることがあるので、守らせたい決まりは CLAUDE.md に書いておきます。次のものは、そのまま効くか、読み直されます。
| 中身 | 要約の後 |
|---|---|
| システムプロンプトと出力スタイル | そのまま効く |
プロジェクトのいちばん上のフォルダの CLAUDE.md と、paths: で対象を決めていない規則 | ディスクから読み直す |
| 自動メモリー | ディスクから読み直す |
| Plan Mode(計画を立てるモード)で書いた計画 | ディスクから読み直す |
paths: を決めた規則・サブディレクトリの CLAUDE.md | 対象のファイルを読むか書き換えた時に読み直す |
| 読んだ・直したファイル | 最近変わった順に5本まで読み直す(5,000トークンを超えるファイルは場所だけ) |
| 使ったスキルの本文 | 読み直す(1本5,000トークン・合計2万5,000トークンまで。古いものから外す) |
フックが前に足した文脈は、会話と一緒に要約されます。スキルの一覧(説明文)は読み直されず、使ったスキルの本文だけが残ります。要約の後も守らせたい規則は、paths: の指定を外すか、プロジェクトのいちばん上のフォルダの CLAUDE.md に移します。スキルは長いと先頭だけが残って後ろが切られるので、大事な指示は SKILL.md の上のほうに書きます。
今の量を見る|/context・ステータスライン・/usage
今の文脈の使い方は、/context で種類ごとの色分けの図として見られます。文脈を多く使うツールや、大きくなりすぎたメモリーへの助言、上限が近い時の警告も出て、読み込まれた CLAUDE.md と自動メモリーのファイルも分かります。会話が文脈の上限を超えた時は、どれだけ超えたかと、空ける方法が出ます。
作業しながらずっと見たい時は、ステータスラインに文脈の使用率を出します。/statusline で設定でき、ステータスラインに渡される情報には、次のものがあります。
- 文脈の大きさ(
context_window.context_window_size):既定は20万、100万の文脈のモデルは100万 - 使った割合(
context_window.used_percentage) - 残りの割合(
context_window.remaining_percentage)
使用量の合計とプランの上限は /usage で見ます。/context や /usage を含むコマンドの一覧はClaude Code コマンド一覧にまとめています。
文脈は埋まるほど性能が落ちる|公式の考え方
公式のベストプラクティスによると、勧めのほとんどは1つの制約から来ています。Claude の文脈は早く埋まり、埋まるほど性能が落ちる、というものです。文脈がいっぱいに近づくと、前の指示を「忘れる」ことや、間違いが増えることがあり、文脈は一番大事に管理するものだと書いています。
Anthropic の記事「Using Claude Code: session management and 1M context」は、この落ち方を「文脈の劣化(context rot)」と呼んでいます。文脈が増えると、注意がより多くのトークンに分かれ、古くて関係のない中身が今の仕事のじゃまをするためです。100万トークンになって長い仕事をより確実にこなせるようになっても、劣化は起こりうるとしています。文脈を小さく保つために、CLAUDE.md には次のことが効きます。
- CLAUDE.md は短く:CLAUDE.md は毎回読み込まれるので、特定の作業の手順はスキルに移す(公式の目安は200行以内)
- 要約で残すことを CLAUDE.md に書く:プロジェクトのいちばん上のフォルダの CLAUDE.md に「# Compact instructions」の節を作り、要約で残すこと(テストの結果やコードの変更など)を書いておける
Claude Code の始め方から自動化まではClaude Code 使い方で整理しています。
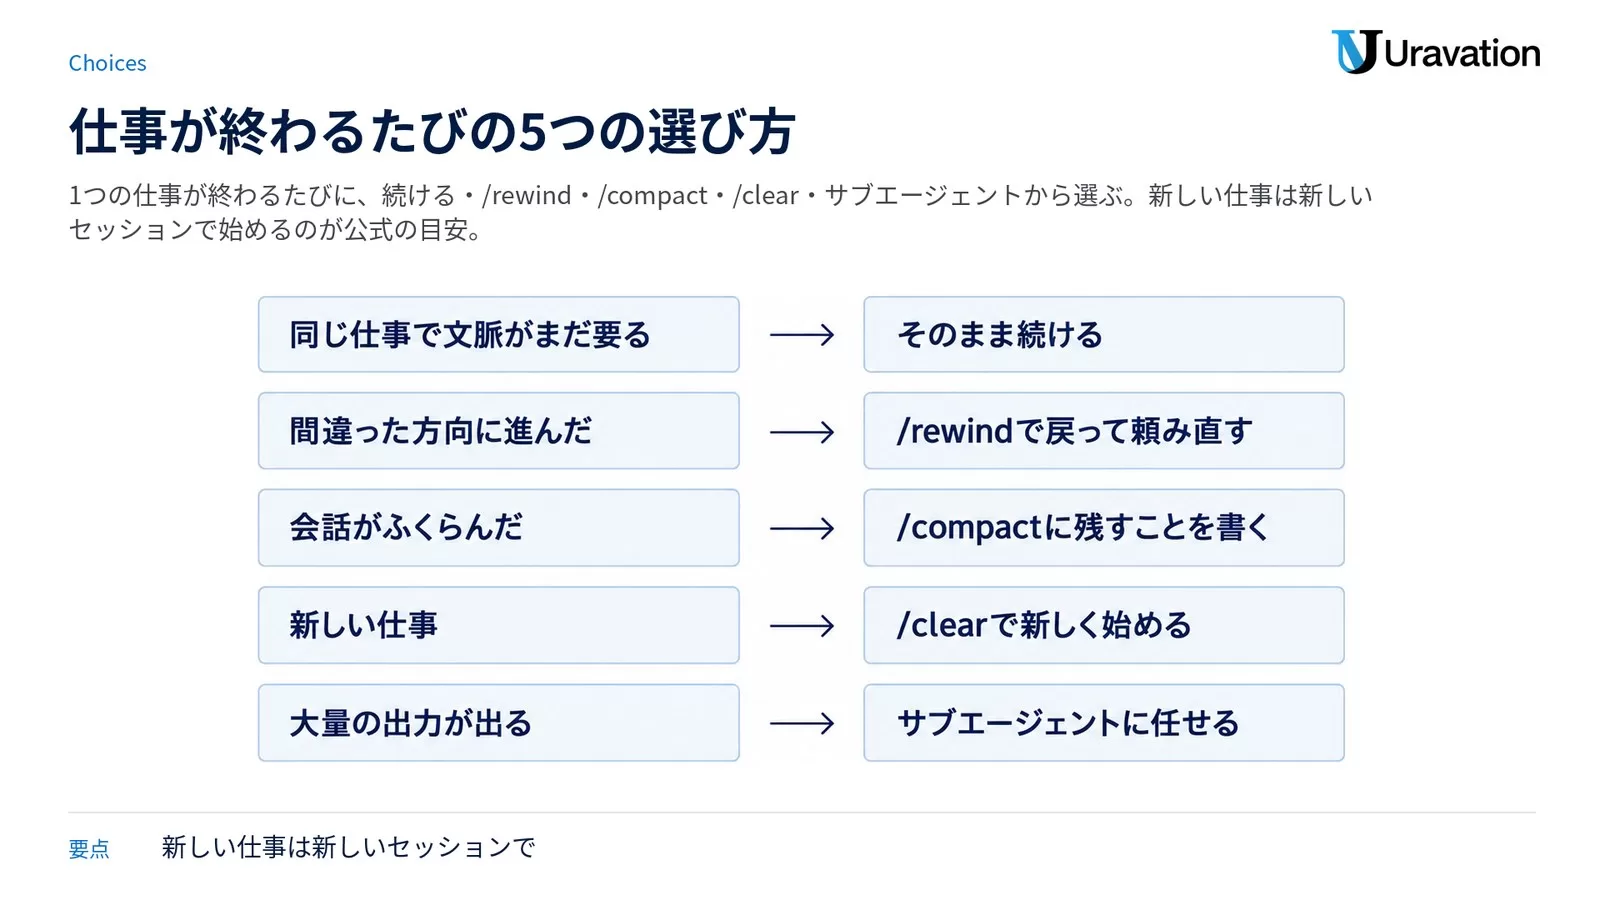
100万トークンの使いこなし方|仕事が終わるたびの5つの選び方
Anthropic の同じ記事(Using Claude Code: session management and 1M context)は、Claude が1つの仕事を終えるたびに、次の5つから選べるとしています。そのまま続けるのが自然ですが、ほかの4つは文脈を管理するためにあります。
| 場面 | 使うもの | 理由(公式の記事の表より) |
|---|---|---|
| 同じ仕事で、文脈がまだ要る | 続ける | 文脈の中身がまだ全部効いている。作り直す費用をかけない |
| Claude が間違った方向に進んだ | /rewind(入力欄が空の時に Esc を2回) | 役に立ったファイルの読み込みは残し、失敗した試みを消して、分かったことを添えて頼み直す |
| 仕事の途中で、古いデバッグや探索で会話がふくらんだ | /compact と、残すことの指示 | 手間が少ない。何が大事だったかは Claude が決め、要れば指示で向きを決める |
| まったく新しい仕事を始める | /clear | 文脈の劣化がない。次に持っていくものを自分で決められる |
| 次の作業で、結論しか要らない大量の出力が出る(コードの検索・確かめ・資料作り) | サブエージェント | 途中の出力はサブエージェントの文脈にとどまり、結果だけが戻る |
新しい仕事は新しいセッションで
公式の目安は「新しい仕事を始める時は、新しいセッションも始める」です。ただし、今の仕事と関係があり、文脈の一部がまだ要る仕事(直前に作った機能の説明書を書くなど)は、同じセッションで続けたほうが、作ったファイルを読み直さずに済み、速く安く済みます。
言い直すより /rewind で戻る
入力欄が空の時に Esc を2回押すか、/rewind を送ると、前の依頼に戻って頼み直せます。その後のやり取りは文脈から外れます。たとえば、Claude が5つのファイルを読んでから試したやり方が、うまくいかなかったとします。この時は「うまくいかなかったので別の方法で」と書き足すより、ファイルを読み終えた所まで戻って頼み直すほうがよいことが多い、と公式は書いています。頼み直す時は「A のやり方は使えない(foo モジュールがその機能を公開していないため)。B で進めて」のように、分かったことを添えます。
/compact と /clear の違い
/compact は、Claude にここまでの会話を要約させ、履歴を要約に置き換えます。抜け落ちることはありますが、自分で書く手間がなく、大事な学びやファイルを Claude が拾ってくれることもあります。/compact focus on the auth refactor, drop the test debugging のように、残すことと捨てることを指示もできます。/clear は、大事なこと(直している所・守る条件・関係するファイル・試してやめた方法)を自分でまとめ、/clear の後の最初の依頼に書いて始めます。手間は増えますが、次の文脈は自分で選んだものだけになります。
自動の要約がうまくいかない時
公式は、仕事がどちらへ進むかを Claude が読めない時に、自動の要約がうまくいかないことがあると書いています。たとえば長いデバッグの後に自動の要約が走ると、要約は調べた中身に寄り、次に「さっき見た bar.ts の別の警告を直して」と頼んでも、その警告が要約から落ちていることがあります。しかも文脈の劣化のせいで、要約する時点が Claude の一番賢くない時点になります。100万トークンなら上限までの余裕が大きいので、次にしたいことを書いて、早めに自分で /compact する時間があります。
サブエージェントに任せる目安
サブエージェントは、途中の出力がたくさん出て、後で要らないと分かっている仕事に向いています。サブエージェントは自分の新しい文脈で作業し、最後の報告だけが元の会話に戻ります。Anthropic の中で使う見分け方は「このツールの出力をまた使うか、結論だけでいいか」です。Claude Code は自分からサブエージェントを使いますが、次のようにはっきり頼むこともできます。
- 「この仕様のファイルをもとに、この作業の結果をサブエージェントに確かめさせて」
- 「別のコードベースの認証の流れをサブエージェントに読ませて要約させ、同じやり方で実装して」
- 「git の変更をもとに、この機能の説明書をサブエージェントに書かせて」
サブエージェントの使い方はClaude Code サブエージェントとはで整理しています。
よくある失敗と直し方
| よくある失敗 | 直し方 |
|---|---|
| 関係ない仕事を同じ会話で続け、毎回の依頼で古い文脈の分まで使用量を使う | 仕事が変わったら /clear で新しく始める |
| 休憩の後の最初の1回が遅く、使用量も多い | キャッシュの寿命(定額のプランは1時間)を超えた分。仕事が終わったなら /clear で区切る |
| モデルを途中で替えて、次の1回が遅く高い | キャッシュはモデルごとに別。モデルを替えるのは仕事の区切りで |
| 大きなログや資料をそのまま読み込み、文脈が埋まる | サブエージェントに読ませ、要約だけを受け取る |
| 日本語の資料が何トークンになるか分からない | トークン計算ツールで概算する。より正確に数えるなら API のトークン数え(token counting) |
/model opus[1m] で Opus 4.6 を選んだつもりが、別のモデルのままだった | Anthropic の API では opus は Opus 5.5 を指す。/model claude-opus-4-6[1m] のように正式な名前に [1m] を付ける |
ゲートウェイやクラウドの提供元の独自のモデル名で起動すると、isn't recognized · context assumed to be 200k tokens のような警告が出て、20万で要約される | Claude Code がそのモデル名を知らず、文脈を20万トークンとみなしている。Claude Code が古いなら claude update、Claude Code が知っているモデルの別名なら modelOverrides で Anthropic のモデルの名前と結びつけ、100万のモデルなら名前の後ろに [1m] を付ける |
よくある質問
100万トークンはどれくらいの量ですか?日本語で何文字ですか?
100万トークンは、Claude が一度に扱える文脈の大きさです。公式の目安は約55万5,000語、Unicode の文字で約250万文字です(今のトークナイザーの場合。Opus 4.7 より前のモデルでは約75万語)。ただし、どの言語の文章での目安かは公式に書かれていないので、日本語の文字数には当てはめられません。日本語の資料は、当サイトのトークン計算ツールに貼ると、文字数と推定トークン数(概算)が出ます。より正確に数えるなら、API のトークン数え(token counting)を使います。
Claude Codeで100万トークンを使うのに設定は必要ですか?
Pro・Max・Team・Enterprise・API の既定のモデルのまま使っているなら、最初から100万トークンで動くので、設定は要りません(Microsoft Foundry の既定は20万のモデルです)。Fable 5.1・Fable 5・Sonnet 5 以降・Haiku 5.5・Opus 4.7 以降も同じです。Opus 4.6 と Sonnet 4.6 は、/model claude-opus-4-6[1m] のように、正式な名前に [1m] を付けた時だけ100万になり、使えるかはプランで決まります。
Proプランでも Claude Codeで100万トークンを使えますか?
既定のモデルのままなら、最初から100万トークンで動きます。Opus 4.6 と Sonnet 4.6 の100万は、Pro では使用量のクレジット(プランの上限を超えて使う別払いの分)が要ります。Fable も、プランや席によってはクレジットから引かれ、/model の一覧に「Requires usage credits」と出ます。
100万トークンの文脈に追加料金はかかりますか?
Anthropic の API では、20万トークンを超えた分にも割増はなく、通常の料金です(Haiku 5.5 だけは、プロンプトが10万トークンを超える依頼の料金が高い)。定額のプランでは、100万が定額に含まれる組み合わせなら定額の中で、使用量のクレジットが要る組み合わせ(Sonnet 4.6 の100万など)はクレジットから引かれます。
画像やPDFは何枚まで入りますか?
画像と PDF も文脈のトークンに数えられ、1回の依頼に入れられるのは、画像か PDF のページで600まで(文脈が20万トークンのモデルは100まで)です。Claude Code は依頼のたびに会話の全部を送るので、前に見せた画像も数に入り、上限を超えそうになると古い画像から外されます(外した画像は Claude から見えなくなる)。大きな画像は、合計の大きさの上限に先に当たります。
100万トークンに対応しているモデルはどれですか?
Claude Code の資料では、Fable 5.1・Fable 5・Sonnet 5 以降・Haiku 5.5・Opus 4.6 以降・Sonnet 4.6 です。API を直接呼ぶ時は、100万トークンのモデルは何も付けずに100万で使えます([1m] は Claude Code でモデルを選ぶ時の書き方です)。API の資料には、これらのほかにも100万トークンのモデルが載っていて、Sonnet 4.5 などは20万トークンです。
文脈がいっぱいになるとどうなりますか?
上限に近づくと Claude Code が会話を自動で要約するので、セッションは続きます。最初から100万のモデルは、既定で約96万7,000トークンで要約が始まり、/autocompact で始まる量を決められます。要約の後は、プロジェクトのいちばん上のフォルダの CLAUDE.md と Plan Mode の計画を読み直し、読んだか直したファイルを、最近変わった順に5本まで読み直します。会話の中で伝えただけの指示は要約で消えることがあるので、守らせたい決まりは CLAUDE.md に書きます。
最終確認日: 2026年10月18日
まとめ:100万トークンは量と使用量を分けて考える
- 量:約55万5,000語・Unicode の文字で約250万文字(今のトークナイザー)。日本語の文字数は公式の換算がないので、トークン計算ツールで概算するか、API のトークン数えで数える
- モデル:既定のモデル(Pro・Max・Team・Enterprise・API)を含め、最初から100万のモデルは設定が要らない。Opus 4.6 と Sonnet 4.6 は正式な名前に [1m] を付けて、プランしだい
- 料金と使用量:API は20万を超えても割増なし(Haiku 5.5 を除く)。長い会話は依頼のたびに全部を送るので、仕事が変わったら /clear
- 要約:既定で約96万7,000トークンで自動の要約。/autocompact と /context で量を管理する
会社で AI を入れる順番はAI導入戦略ガイド、ChatGPT を業務で使う全体像はChatGPTビジネス活用ガイドにまとめています。Claude Code を社内で使いたい会社にはClaude Code 研修(法人向け)があります。ご質問はお問い合わせフォームからどうぞ。
参考・出典
この記事は2026年4月に公開した記事を、公式の資料で確かめられる範囲だけで作り直したものです。旧版にあった古いモデルでの量の目安と点数、出典を示せないコストの削減率、第三者のブログをもとにした説明は外しました。
Claude Code の公式ドキュメント(2026年10月18日確認)
- モデルと文脈: Model configuration・Explore the context window・How Claude Code uses prompt caching
- 費用と量の確かめ方: Manage costs effectively・Customize your status line・Commands
- Anthropic の記事: Using Claude Code: session management and 1M context
- 使い方: Best practices for Claude Code・Create custom subagents・How Claude remembers your project・Interactive mode・Glossary
Claude の API の公式ドキュメント(2026年10月18日確認)
著者: 佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。100社以上の企業向けAI研修・導入支援。著書『AIエージェント仕事術』『Claude仕事術』(SBクリエイティブ・シリーズ累計66,000部)、『AI推進担当になったら読む本』(大和書房)。SBクリエイティブ「ビジネス+IT」ほかで生成AI連載を執筆(NewsPicks最大1,125ピックス)。ご質問・ご相談はお問い合わせフォームからお気軽にどうぞ。
この記事の内容を社内展開する方へ: Claude Code × ビジネス活用 実践ガイド(無料・PDF 30ページ+Excel) をダウンロードできます。