AI検索対策をAIO・LLMO・GEOの傘として定義し、企業サイトで整える技術基盤、一次情報、信頼性、計測運用の4領域と優先順位を判断表・チェックリストで整理します。
- AI検索対策とはの定義、実務判断、確認項目をAI検索時代の情報源設計として整理する。
- 公式情報と一次情報を優先し、表示保証や順位改善の断定を避ける。
- 本文、FAQ、内部リンク、llms.txt、構造化データの整合性を継続確認する。
実務で見る観点
各AI検索サービスのクローラー名とrobots.txtでの扱いを公式情報で確認する。
サービス内容、料金、対象者、事例、会社情報を正規ページに集約して矛盾を減らす。
外部メディア、SNS、比較サイトに出ている説明と自社サイトの記述がずれていないか見る。
AI検索対策に必要なものは4つです。最初に、対策する「AI検索面」を決めます。
- 取得・検索基盤:必要なページへ検索エンジンや検索用クローラーが到達できる状態を作る
- 一次情報・回答設計:会社として答える内容を、判断条件や根拠とともに公開する
- 発信主体・信頼性:誰が、どの立場で、いつ確認した情報かを一貫させる
- 計測・更新運用:表示、参照元、流入、誤り、事業成果を分けて観測し、変更時に直す
Google AI Overviewだけを対象にするのか、ChatGPT検索やPerplexityまで含めるのかによって、確認するクローラーと計測画面は変わります。一方、本文の正確さ、技術的な到達性、発信主体の明確さは共通の土台です。用語ごとに別プロジェクトを作るより、4領域を一つの改善台帳で管理したほうが重複を防げます。
AI検索対策とは
AI検索対策とは、Google AI Overview・AI Mode、ChatGPT検索、Perplexity、Microsoft Copilotなど、AIが検索結果や回答を組み立てる接点を対象に、企業の公開情報を人と機械の双方が発見・理解・検証しやすい状態へ整え、その扱われ方を観測して更新する取り組みです。AI検索攻略では、AIO対策・LLMO対策・GEO対策をこの傘の下に置きます。特定サービスでの表示、引用、順位を保証する施策ではありません。
最初に、対策対象のAI検索面を決める
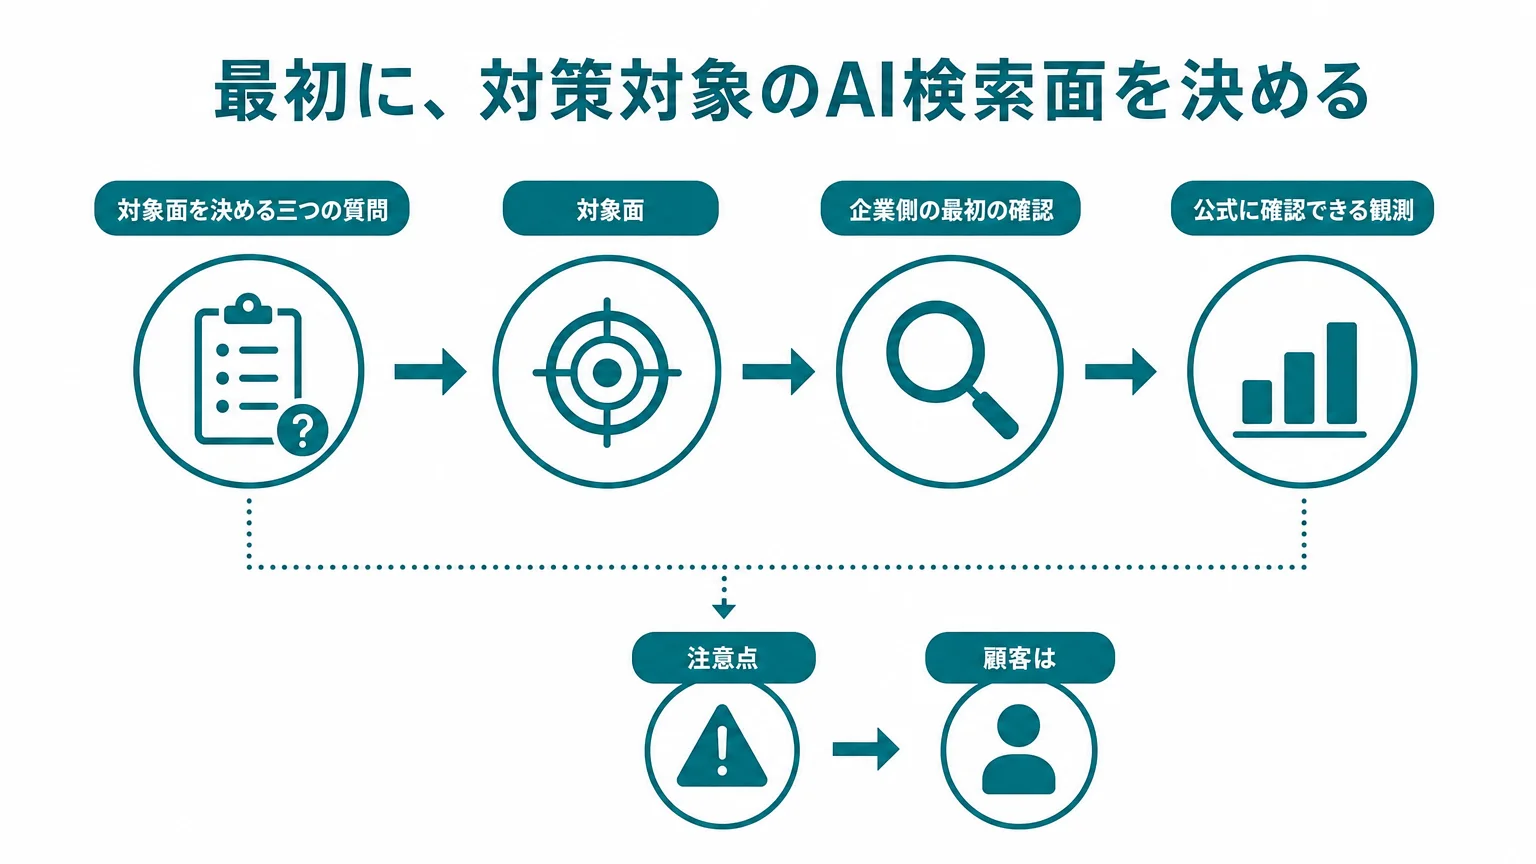
最初の作業は記事制作でも構造化データでもありません。顧客がどの検索面で、何を尋ね、どのページを確認してほしいかを決めます。同じ「AI検索」でも、公式に提供される制御方法と観測項目は共通ではないためです。
| 対象面 | 企業側の最初の確認 | 公式に確認できる観測 | 注意点 |
|---|---|---|---|
| Google AI Overview・AI Mode | 重要ページのインデックス、スニペット表示の適格性、生成AI機能への参加設定を確認する | Search Consoleの生成AIパフォーマンスレポートでインプレッションと対象ページなどを確認する | レポートは段階提供であり、すべてのプロパティに表示されるとは限らない |
| ChatGPT検索 | 公開したいページでOAI-SearchBotを意図せず拒否していないか確認する | 回答上の参照リンクと、ChatGPTからの流入をアクセス解析で分けて確認する | 検索用クローラーと学習用クローラーを同じ目的だと扱わない |
| Perplexity | PerplexityBotのrobots.txt設定と、WAF・CDNでの到達可否を確認する | 回答上の参照リンク、アクセス解析、サーバーログを別々に記録する | 自動クロールとユーザー操作に伴う取得では、公式に説明される挙動が異なる |
| Microsoft Copilot・BingのAI回答 | Bing Webmaster Toolsの所有権、インデックス、クロール状態を確認する | AI Performanceの対象環境では引用数、引用ページ、grounding queryなどを確認する | 公開プレビューの機能は対象範囲や表示項目が変わり得る |
Googleは、生成AI検索でも従来のSEO基盤が有効であり、AI OverviewやAI Modeの候補になる技術上の前提は、ページがGoogle検索にインデックスされ、スニペット付きで表示できる状態であることだと説明しています。ただし、要件を満たしてもクロール、インデックス、表示は保証されません。Googleの生成AI検索向け公式ガイドを基準にすると、AIO専用の裏技より先に通常の検索基盤を点検すべき理由が分かります。
Search Consoleの生成AIパフォーマンスレポートは、AI OverviewとAI Modeのインプレッションを、ページ、国、日付、端末などで確認するための公式画面です。検索語、回答全文、問い合わせへの因果関係をすべて示す画面ではありません。見える項目を確認してから、足りない観測だけを手動調査や別のツールで補います。
ChatGPTについては、OpenAIが公開サイトの検索向けアクセスにOAI-SearchBotを案内し、学習から除外したい場合のGPTBotとは役割を分けて説明しています。OpenAIクローラーの公式資料に照らし、検索露出、モデル学習、ユーザー起点のアクセスを一つの許可設定で済ませないことが重要です。
Perplexityも、検索結果へサイトを表示するためのPerplexityBotと、ユーザーの依頼に応じてページへアクセスするPerplexity-Userを区別しています。WAFを利用している場合はUser-Agent名だけでなく、公開IP情報や実ログも含めて確認します。判断の起点はPerplexityのクローラー公式資料です。
対象面を決める三つの質問
- 顧客は、会社名を確認したいのか、複数社を比較したいのか、課題の解決方法を探したいのか
- 回答に含まれてほしい公式情報は、会社概要、サービス、料金、実績、対応範囲、注意事項のどれか
- 誤った回答が出た場合、どのページを正本として修正し、誰が承認するのか
AI検索対策をAIO・LLMO・GEOの上位概念として整理する
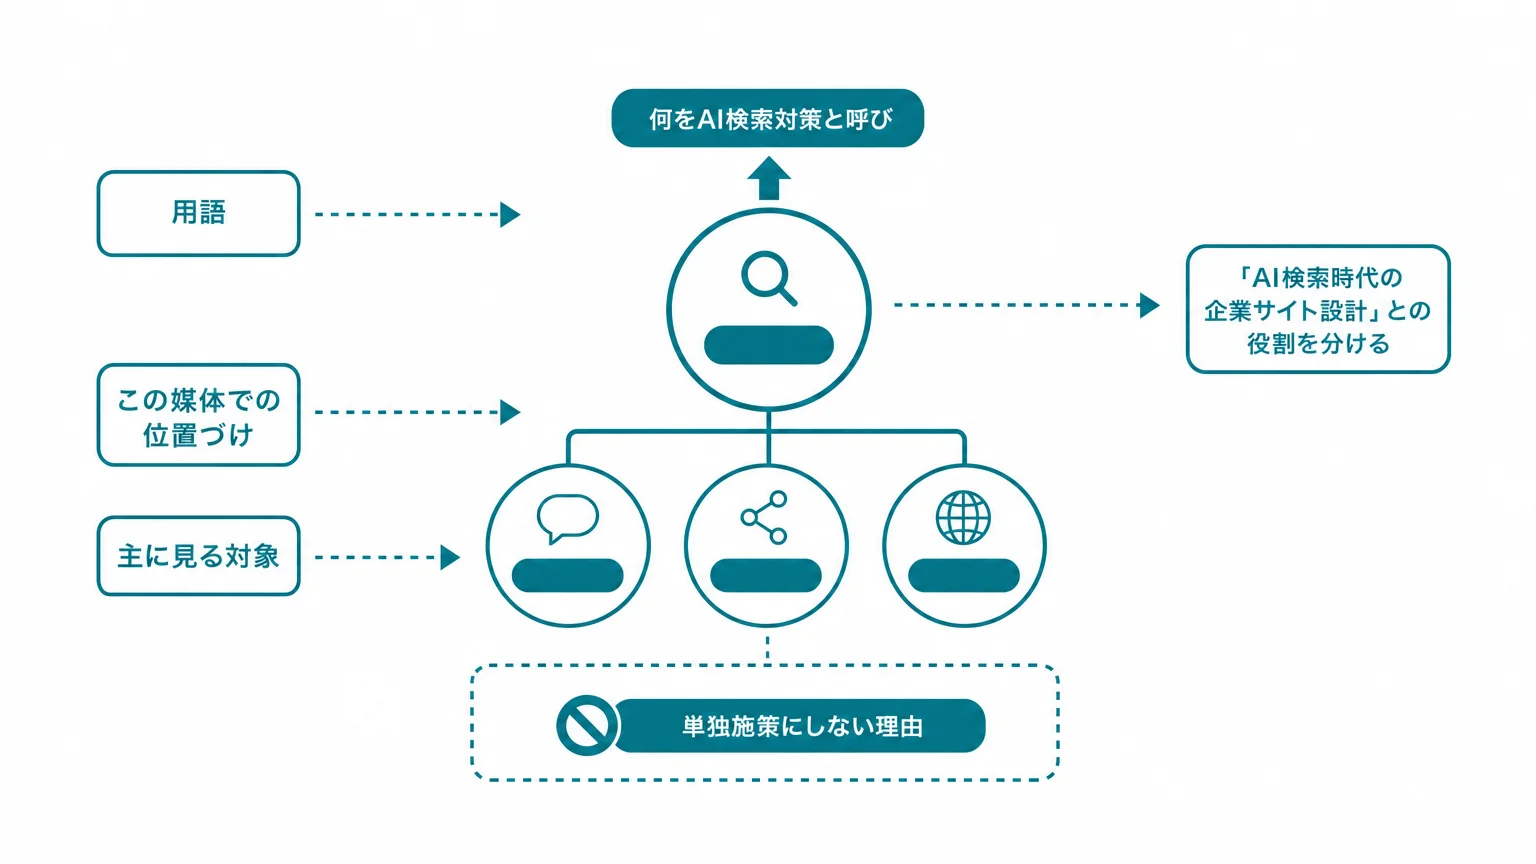
AI検索対策、AIO、LLMO、GEOには、全業界で統一された一つの用語体系があるわけではありません。Googleの公式ガイドも、AEOやGEOをAI検索での可視性改善に焦点を当てる呼び方として紹介しつつ、Google検索の立場では生成AI検索の最適化もSEOだと整理しています。
そこでAI検索攻略では、社内会議や発注時に施策範囲を取り違えないため、次のように使い分けます。
| 用語 | この媒体での位置づけ | 主に見る対象 | 単独施策にしない理由 |
|---|---|---|---|
| AI検索対策 | AIO・LLMO・GEOを束ねる実務上の傘 | 検索内AI要約、回答型検索、出典リンク、AIエージェントによる情報取得 | サービスごとの違いと、共通する企業サイト基盤を同時に管理する必要がある |
| SEO | 発見、クロール、インデックス、検索品質の共通基盤 | GoogleやBingなどの検索エンジン | Googleの生成AI検索も検索インデックスと検索品質の仕組みを土台にしている |
| AIO対策 | 主にGoogle AI Overview・AI Modeを対象にする実装・観測 | Google検索内の生成AI機能 | AIOはAI Optimization全般を指す場合もあり、契約や記事ごとに対象確認が必要である |
| LLMO対策 | LLMやAI検索に誤解されにくい責任ある情報源を作る考え方 | 会社情報、サービス情報、根拠、著者、更新履歴、ページ間の関係 | 特定モデルだけに通用する文章術ではなく、SEOや情報設計と重なる |
| GEO対策 | 生成エンジンの回答内で情報がどう扱われるかを考える研究・実務の視点 | 生成回答、参照元、言及、可視性の評価 | 研究上の枠組みを現在の各商用サービスの確定仕様へそのまま一般化できない |
GEOという名称は、2024年のACM KDD採択論文「GEO: Generative Engine Optimization」で、生成エンジン回答におけるコンテンツの可視性を扱う枠組みとして提示されました。KDD 2024の研究論文一覧で論文名と著者を確認できます。ただし、論文の実験結果を、現在のGoogle、ChatGPT、Perplexityで同じように再現できると断定してはいけません。
Google検索に限定した実装と計測はAIO対策の基本ガイド、責任ある情報源づくりはLLMO対策とは、生成回答での可視性という考え方はGEO対策とはへ進むと詳細を確認できます。従来検索との共通点と差分はSEOとLLMOの違いで整理しています。
「AI検索時代の企業サイト設計」との役割を分ける
このページの役割は、AI検索対策の定義、用語の全体地図、4領域、着手順を決めることです。一方、AI検索時代の企業サイト設計は、会社情報、サービス、料金、FAQ、事例などをどのように役割分担させるかという情報設計の原則を扱います。
- 何をAI検索対策と呼び、どこから着手するかを決めたい場合:このページ
- 企業サイト全体のページ構成と正本の置き方を見直したい場合:企業サイト設計の記事
- Google検索内の生成AI機能を詳しく確認したい場合:AIO対策の記事
- 誤解されにくい会社情報源を作りたい場合:LLMO対策の記事
優先順位は「入口の故障」から判定する
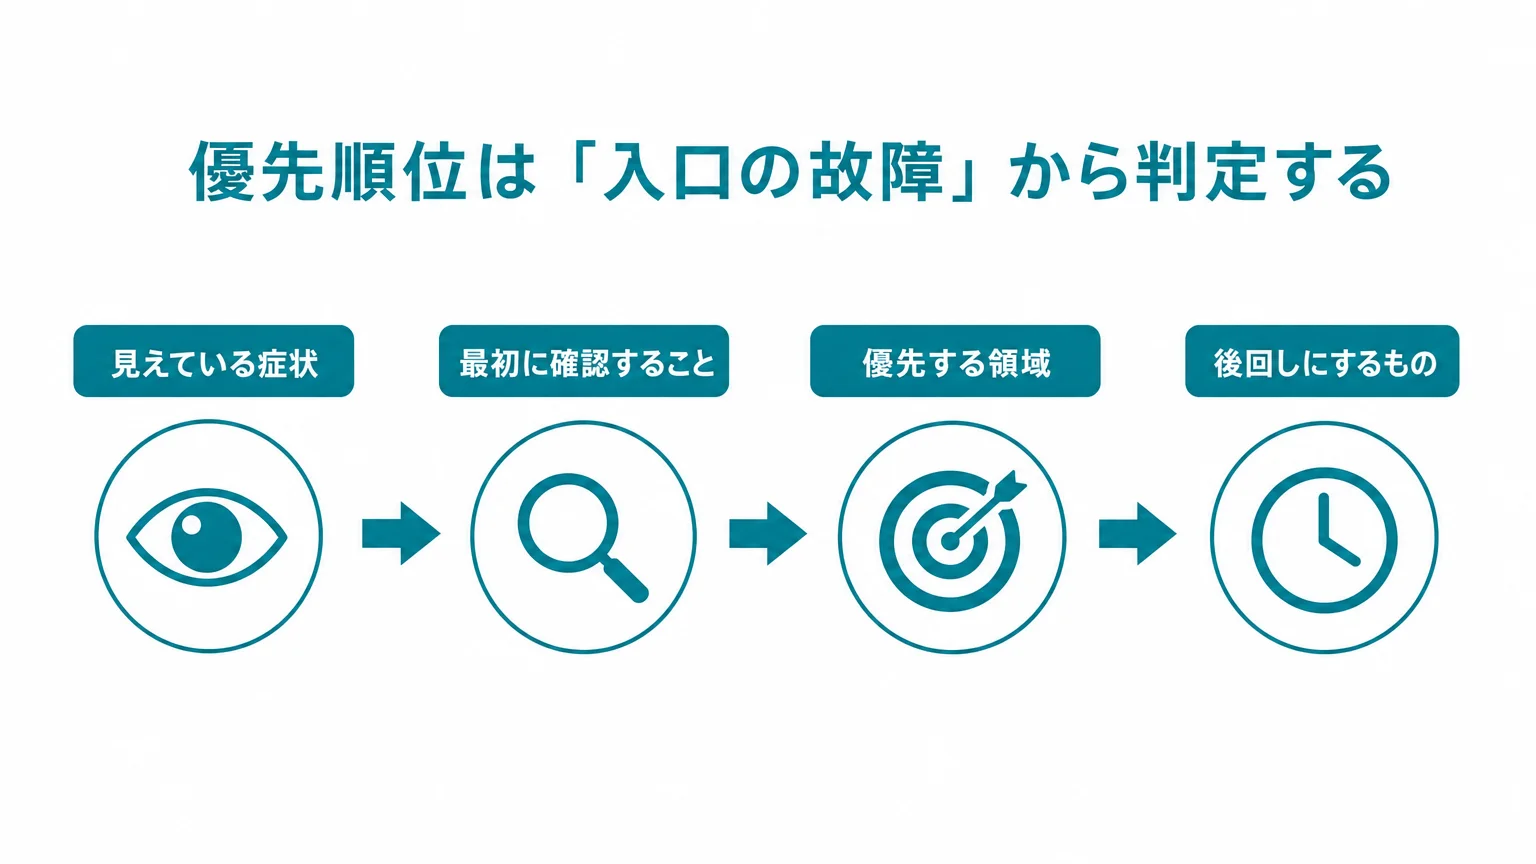
施策の優先順位は、流行している技術名ではなく、情報が届くまでのどこが壊れているかで決めます。変更前には、重要な質問、現在の回答、参照元URL、正誤を記録します。これは成果値ではなく、修正前後を混同しないための基準線です。
| 見えている症状 | 最初に確認すること | 優先する領域 | 後回しにするもの |
|---|---|---|---|
| 重要ページが検索に出ず、クローラーログにも到達記録がない | HTTP状態、noindex、robots.txt、canonical、WAF、内部リンク | 取得・検索基盤 | 記事の量産、llms.txtの装飾、独自スコアの導入 |
| 会社名は出るが、事業内容や対象顧客が間違っている | 会社概要とサービスページの記述、古い記事、外部プロフィールの不一致 | 一次情報・回答設計、発信主体・信頼性 | 回答文をAI向けに言い換えるだけの修正 |
| 比較質問で料金、対象範囲、条件が説明されない | 公式ページに判断材料と例外条件が公開されているか | 一次情報・回答設計 | 一般論だけのコラム追加 |
| 回答や参照は確認できるが、流入と問い合わせへの接続が分からない | 参照URL、UTM、ランディングページ、コンバージョン定義、CRM連携 | 計測・更新運用 | 一つの総合スコアへの集約 |
| ページごとに社名、サービス名、日付、監修者が揺れている | 正本ページ、表記ルール、更新責任者、構造化データとの一致 | 発信主体・信頼性 | 第三者サイトへの言及獲得 |
| 検索用クローラーを許可したいが、法務・セキュリティ要件が未整理である | 公開可能範囲、学習方針、ユーザー起点取得、認証が必要な領域 | 取得・検索基盤とガバナンス | 全クローラーの一括許可 |
優先順位には二つの例外があります。誤った価格、法的条件、対応地域など、顧客判断へ直接影響する誤情報は、観測件数にかかわらず修正を先にします。また、個人情報、会員限定情報、契約上非公開の情報は、AI検索への露出より保護を優先します。
「取得できる」「内容が正しい」「根拠を確認できる」「変化を測れる」の順で故障を直すと、施策同士の依存関係が見えます。計測の基準線だけは変更前に保存し、実装の拡張は故障箇所に合わせます。
企業サイトで整える4領域
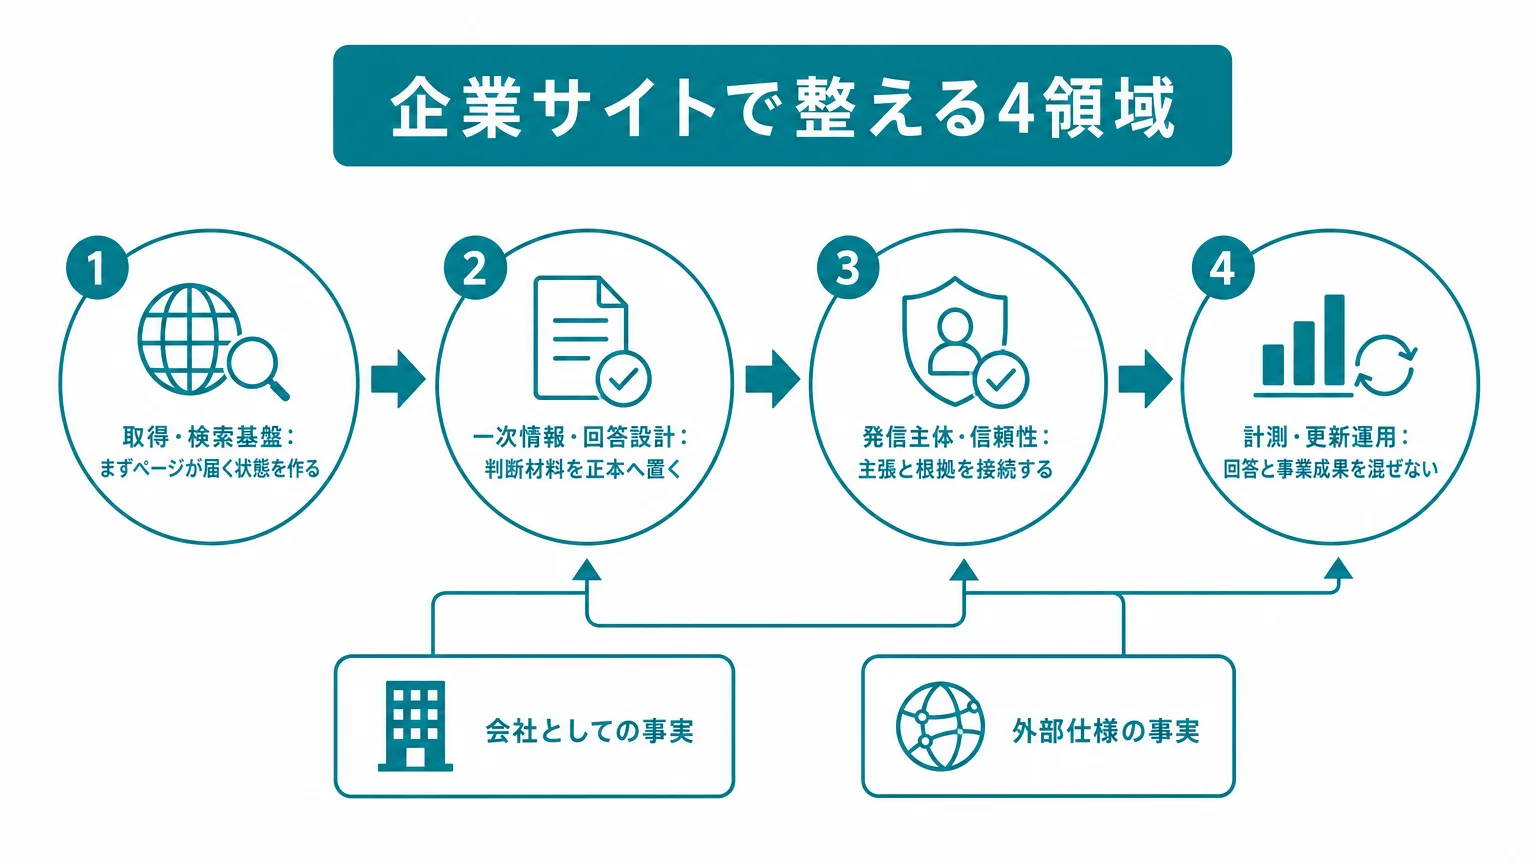
1. 取得・検索基盤:まずページが届く状態を作る
取得・検索基盤の目的は、公開すると決めた正本ページへ、対象サービスの検索システムが到達できる状態を作ることです。AI検索専用の技術基盤を別に作るのではなく、通常のSEO、CDN、WAF、CMS運用を点検します。
確認対象は、HTTP状態、robots.txt、noindex、canonical、XMLサイトマップ、内部リンク、JavaScriptで表示する本文、重複URL、モバイル表示、WAFのBot制御です。トップページだけが取得できても、料金、事例、FAQ、会社概要が遮断されていれば、企業の判断材料は揃いません。
クローラー設定では目的を分けます。Google検索はGooglebotの制御を基準にし、ChatGPT検索はOAI-SearchBot、Perplexity検索はPerplexityBotの公式説明を確認します。モデル学習用のBotやユーザー操作に伴う取得を、検索用クローラーと同一視しません。具体的な判定軸はrobots.txtでAIクローラーを許可するかの判断基準で確認できます。
構造化データは、画面上にある会社名、著者、日付、パンくず、記事情報などを機械向けに補足する用途で使います。Googleは生成AI検索向けの特別なschema.orgマークアップは不要であり、構造化データ自体も必須ではないと説明しています。本文にない事実を構造化データだけで足すのではなく、AI検索時代の構造化データを参照し、可視情報との一致を確認します。
llms.txtは、サイト概要と重要ページを案内するための提案です。llms.txtの提案仕様は2026年8月にv2へ更新されていますが、すべてのAI検索サービスが採用する共通標準だと扱うことはできません。Googleは自社検索でllms.txtを利用せず、設置してもGoogle検索での表示やランキングに影響しないと公式ガイドで明記しています。作る場合も、本文、正本ページ、内部リンクを直した後の補助目次に位置づけます。
2. 一次情報・回答設計:判断材料を正本へ置く
一次情報・回答設計の目的は、会社として責任を持てる答えを公開することです。AIが文章を生成する前に、参照できる事実がWeb上に存在しなければなりません。
サービスページなら、対象者、提供範囲、成果物、進め方、料金の考え方、対象外、顧客側に必要な体制を明記します。事例なら、業種、課題、実施内容、前提、制約、測定方法を分けます。FAQなら、商談で実際に聞かれるセキュリティ、契約、費用、対応範囲へ会社として回答します。
文章は、見出し直下で問いに直接答え、その後に条件、理由、例外、根拠を置くと、人も情報を確認しやすくなります。ただし、AI向けにすべてを短文へ分割する必要はありません。Googleも、生成AI検索のために内容を細切れにしたり、AI専用の書き方へ直したりする要件はないと説明しています。
優先すべきは、他サイトの一般論を言い換えた記事ではなく、自社しか確定できない情報です。対応できる業務、対応できない業務、料金の変動条件、現場で使う評価方法、更新履歴などが該当します。Googleの公式ガイドも、既存情報の再掲ではなく、独自の視点、経験、専門知識に基づく有用な内容を重視しています。
3. 発信主体・信頼性:主張と根拠を接続する
発信主体・信頼性の目的は、「誰の説明か」「何を根拠に言えるか」「現在も有効か」を確認できるようにすることです。権威らしく見せる装飾ではなく、読者が検証できる情報を増やします。
会社の正式名称、所在地、代表者、問い合わせ先、サービス名、対象地域、料金表記は、会社概要、サービスページ、構造化データ、外部の公式プロフィールで揃えます。略称や旧サービス名を残す場合は、現在の名称との関係を説明します。
記事では、執筆者、監修者、担当部署、確認範囲、公開日、更新日を実態に合わせます。「編集部監修」とだけ書くより、誰が技術仕様を確認し、誰が会社としての提供範囲を承認したかが分かるほうが検証可能です。更新日は自動で新しく見せるための表示ではなく、何を見直したかを示す記録にします。
主張は三種類に分けます。
- 会社としての事実:サービス範囲、価格、所在地、契約条件など、自社が正本になれる情報
- 外部仕様の事実:検索機能、クローラー、構造化データなど、公式資料を確認すべき情報
- 仮説:回答の変化やユーザー行動との関係など、観測条件によって変わる推測
外部仕様を説明する場合は一次情報へリンクし、確認日を管理します。仮説は事実のように言い切らず、何を観測すれば判断できるかを添えます。第三者サイトでの不自然な言及購入や、実在しない受賞歴・実績の追加は信頼性を損なうため、AI検索対策の対象外です。
4. 計測・更新運用:回答と事業成果を混ぜない
計測・更新運用の目的は、AI検索上の現象と、サイト流入や商談への影響を分けて記録することです。一つの「AI可視性スコア」に集約すると、何を直すべきか分からなくなります。
最低限、次の記録を分けます。
- 質問:誰が、どの状況で尋ねる質問か
- 回答状態:社名やサービスが言及されたか、内容に誤りがないか
- 出典状態:自社URLが示されたか、別の情報源が示されたか
- 取得状態:対象クローラーがページへ到達したか、エラーがなかったか
- 検索上の観測:インプレッション、参照ページ、grounding queryなど、各公式画面が提供する項目
- サイト行動:参照元、ランディングページ、回遊、設定済みのコンバージョン
- 事業成果:問い合わせ、商談、受注など、CRM側で定義する結果
- 修正履歴:どのページの何を変更し、どの仕様を根拠にしたか
GoogleではSearch Consoleの生成AIパフォーマンスレポート、ChatGPTでは回答上の参照リンクと流入、サーバー側ではクローラーログを確認できます。Microsoftは2026年2月、Bing Webmaster ToolsのAI Performanceを公開プレビューとして案内し、対応するAI体験での引用数、引用ページ、grounding queryなどを説明しています。Microsoftの公式発表は、引用数が順位、権威、回答内の位置を意味しない点も明記しています。
更新は日数ありきの計画にせず、価格変更、サービス改定、法令変更、拠点変更、担当者変更、重要な公式仕様変更を起点にします。変更が発生したら、正本ページ、関連記事、FAQ、構造化データ、外部プロフィールを同じ変更票から確認します。
ページの役割を4領域につなぐ
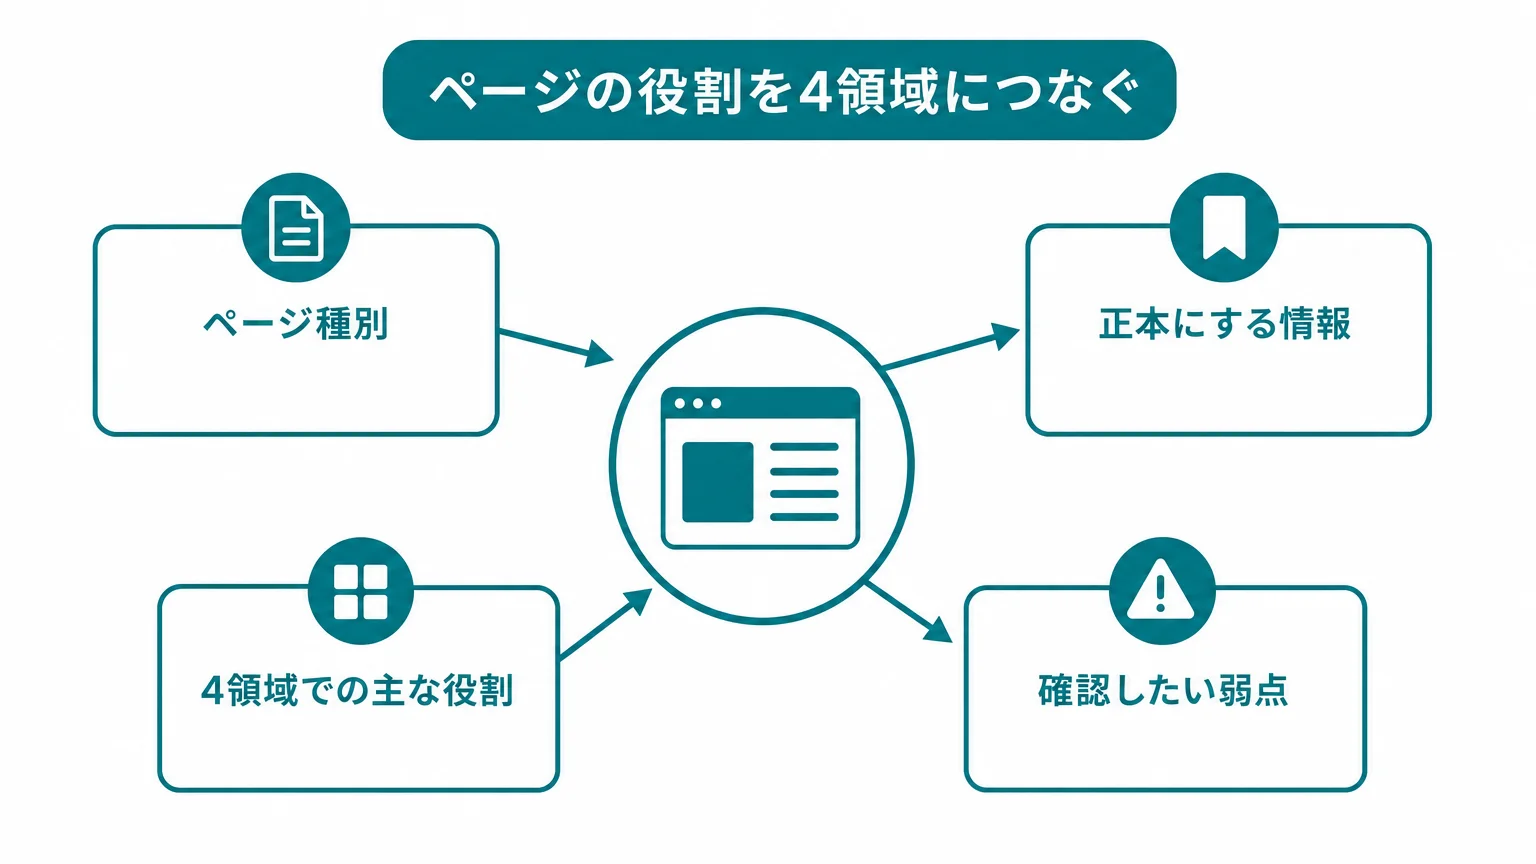
4領域は一つの記事へ詰め込むものではありません。ページごとに正本としての役割を持たせ、内部リンクで根拠をつなぎます。
| ページ種別 | 正本にする情報 | 4領域での主な役割 | 確認したい弱点 |
|---|---|---|---|
| 会社概要 | 正式名称、所在地、代表者、事業範囲、問い合わせ先 | 発信主体・信頼性 | 旧情報、表記揺れ、外部プロフィールとの矛盾 |
| サービスページ | 対象者、提供範囲、成果物、進め方、対象外 | 一次情報・回答設計 | 抽象語だけで、比較や導入判断に使えない状態 |
| 料金・契約ページ | 価格または算定条件、含むもの、追加条件、契約上の注意 | 一次情報・回答設計、信頼性 | 営業資料にしか存在しない条件、古い金額 |
| 導入事例 | 課題、実施内容、前提、制約、測定方法 | 一次情報・信頼性 | 成果だけがあり、対象条件や再現限界がない状態 |
| FAQ | 導入前後に繰り返し発生する質問への公式回答 | 回答設計、内部リンク | 一般論の水増し、回答とサービスページの矛盾 |
| 解説記事・用語集 | 定義、判断軸、手順、外部仕様の根拠 | 回答設計、検索基盤 | 一次情報のない要約、関連する正本ページへの導線不足 |
| 診断・計測ページ | 確認項目、判定条件、対象外、改善候補 | 計測・更新運用 | 採点根拠が不明な総合スコア、成果保証 |
業種別の記事は、この全体地図を各事業の判断材料へ翻訳する役割を持ちます。たとえば製造業・BtoBメーカーのLLMO対策では技術仕様や対応範囲、人材紹介・派遣会社の情報設計では求職者と採用企業で異なる質問、BtoB SaaSのLLMO対策では比較候補になるための製品情報を扱います。
業種記事では固有の料金、規制、商流、比較条件へ落とし込みます。計測の詳細はLLMOの効果測定へ分岐させます。
実装チェックリスト
チェックは「入っているか」だけでなく、「何の目的で、誰が確認したか」まで記録します。該当しない項目は未実装ではなく、対象外の理由を残します。
対象面と基準線
- 主対象、観測対象、対象外のAI検索面を明記した
- 顧客の質問を、情報収集、比較、導入判断、利用後の確認に分けた
- 各質問に対して、会社として答える正本URLを決めた
- 変更前の回答、参照元URL、正誤、確認条件を保存した
- 誤情報と機密情報が見つかった場合の停止・修正責任者を決めた
取得・検索基盤
- 重要ページが正常なHTTP状態で公開され、意図しない転送やエラーがない
- noindex、canonical、robots.txtがページの公開方針と一致している
- Google Search Consoleで重要ページのインデックス状態を確認した
- 会社概要、サービス、料金、事例、FAQへ通常の内部リンクで到達できる
- 重要な本文が画像、PDF、モーダル、クライアント側の不安定な処理だけに閉じていない
- 対象クローラーがWAFやCDNで拒否されていないか、実ログで確認した
- 構造化データが画面上の内容と一致し、AI検索専用の保証施策になっていない
- llms.txtを使う場合、対象サービス、管理責任、リンク切れの確認方法を決めた
一次情報・回答設計
- 会社概要に正式名称、事業内容、所在地、問い合わせ先がある
- サービスページに対象者、提供範囲、成果物、進め方、対象外がある
- 価格を公開できない場合も、金額が変わる条件と見積もり範囲を説明している
- 導入事例に前提、制約、実施内容、測定方法がある
- 見出し直下の段落だけを読んでも、問いへの結論が分かる
- 抽象的な強みを、対象業務、納品物、対応条件などの確認可能な情報へ置き換えた
- 一般論の再要約ではなく、自社が正本になれる情報を優先した
- 似た質問ごとに薄いページを複製せず、ページの意思決定上の役割を分けた
- 記事から会社情報、サービス、事例、FAQなどの根拠ページへ意味の分かる文言でリンクした
発信主体・信頼性
- 社名、サービス名、対象地域、料金表記がサイト内で統一されている
- 執筆者、監修者、担当部署、確認範囲が実態に合っている
- 公開日と更新日を分け、重要な変更内容を記録している
- 外部サービスの仕様は公式・一次情報で確認し、確認日を管理している
- 自社の事実、外部仕様、仮説を文章上で区別している
- 古い記事や外部の公式プロフィールが現在の事業説明と矛盾していない
- 実績、受賞、顧客事例、数値に確認可能な根拠がある
計測・更新運用
- Search Consoleで通常検索と生成AI機能の観測範囲を区別している
- 生成AIパフォーマンスレポートが見えない場合を失敗と決めつけていない
- ChatGPTなどからの参照流入を、参照元とランディングページで確認できる
- 手動観察では質問文、対象サービス、日時、地域、ログイン条件を保存している
- 第三者ツールの独自スコアを公式の順位や内部指標として扱っていない
- 回答の正確性と、問い合わせ・商談・受注を別の指標で管理している
- 価格、サービス、法令、拠点、担当、公式仕様の変更時に関連ページを見直す流れがある
- 修正履歴から、どの変更とどの観測を比較したか説明できる
失敗は施策の足し算から起きる
失敗1:llms.txtを最初の成果物にする
本文や正本ページが曖昧なままllms.txtだけを作ると、案内先の情報品質は変わりません。Google検索はllms.txtを利用しないため、AIO対策の必須成果物として扱う説明も不正確です。先に重要ページ、内部リンク、更新責任を整え、利用目的がある場合だけ補助目次として管理します。
失敗2:AIクローラーを一括で許可または拒否する
検索結果への掲載、モデル学習、ユーザー起点のページ取得では目的が違います。一括設定は、公開したいページを検索用クローラーから隠したり、保護すべき領域への方針を曖昧にしたりします。公式のUser-Agent説明、IP情報、WAF設定、アクセスログを照合し、公開範囲を先に決めます。
失敗3:AIO・LLMO・GEOごとに同じ記事を作る
用語だけを変えた定義記事や業種記事を増やすと、どのページが正本か分からなくなります。Googleも、検索語の派生を狙って大量の類似ページを作る考え方を推奨していません。傘記事で関係を定義し、Google固有、情報源設計、生成回答の分析など、意思決定が異なる場合にだけ記事を分けます。
失敗4:構造化データに本文以上の事実を書く
画面にない料金、評価、著者、FAQを構造化データだけに入れると、人が確認できる情報と機械向け情報が食い違います。構造化データは本文の代用品ではありません。まず画面上の正本を直し、その内容を適切な型で補足します。
失敗5:一度の回答や一つのスコアを成果にする
生成回答は質問文、日時、地域、ログイン状態、利用する検索面によって変わり得ます。一度社名が出たことも、一度出なかったことも、それだけで施策の成否を示しません。回答、出典、流入、事業成果、修正履歴を分け、同じ条件で観測できる記録にします。
AI検索対策に関するよくある質問
AI検索対策とは何ですか?
AI検索対策とは、AIが検索結果や回答を作る接点に向けて、企業の公開情報を発見・理解・検証しやすくし、その扱われ方を観測して更新する取り組みです。取得・検索基盤、一次情報・回答設計、発信主体・信頼性、計測・更新運用の4領域で管理します。
AI検索対策とSEOは別ですか?
別プロジェクトとして完全に切り離すべきものではありません。特にGoogleのAI Overview・AI Modeは、検索インデックスや検索品質の仕組みを土台にしています。SEOが発見と検索品質の共通基盤であり、AI検索対策は生成回答、出典、誤解、サービス別クローラー、計測まで視野を広げる関係です。
AIO対策・LLMO対策・GEO対策はどう違いますか?
AI検索攻略では、AIO対策を主にGoogleのAI Overview・AI Mode向け、LLMO対策をLLMに誤解されにくい情報源づくり、GEO対策を生成エンジン回答での可視性を考える視点として整理します。市場で意味が統一されているわけではないため、発注時は名称より対象サービスと成果物を確認します。
AI検索対策ではllms.txtが必要ですか?
全サイトに必須とは言えません。llms.txtはAIやエージェントへサイト概要と重要リンクを案内する提案ですが、Google検索は利用しないと明記しています。対象サービスが利用する根拠と運用目的がある場合に検討し、本文、正本ページ、内部リンクより先に置きません。
構造化データを入れればAI検索に表示されますか?
表示は保証されません。構造化データはページ上の情報を機械向けに補足する手段であり、生成AI検索専用の特別なSchema.org型もありません。画面上の内容との一致、検索エンジンが対応する型、実装エラーを確認します。
最初に何を確認すればよいですか?
顧客が実際に使う質問を選び、現在の回答、参照元、正誤、答えてほしい正本URLを記録します。そのうえで、重要ページのインデックスとクローラー到達、会社・サービス情報の不足、表記の矛盾を確認します。新しい記事やツールは、故障箇所が分かってから選びます。
AI検索対策の効果はどう測りますか?
回答での言及、出典リンク、公式画面のインプレッション、参照流入、サイト行動、問い合わせ・商談を別々に測ります。サービスごとに指標の定義が異なるため、単純合算しません。変更前の条件と修正履歴を残し、観測された変化と因果関係を区別します。
AI検索診断を外部へ相談したほうがよいのはどんな場合ですか?
複数のAI検索面で会社説明が食い違う、クローラー制御とセキュリティ方針が衝突する、重要ページが多く正本を決められない、計測値の定義を社内で揃えられない場合は、第三者と棚卸しする余地があります。相談前に対象URL、重要な質問、誤りの例、既存の計測環境をまとめると、診断範囲を絞れます。
結論
AI検索対策は、AI向けの記事を増やす施策ではありません。対象にする検索面を決め、次の4領域を同じ改善台帳で整える取り組みです。
- 取得・検索基盤で、正本ページへ到達できる状態を作る
- 一次情報・回答設計で、判断に必要な事実、条件、例外を公開する
- 発信主体・信頼性で、誰の説明か、何が根拠か、いつ確認したかを揃える
- 計測・更新運用で、回答、出典、流入、事業成果を分けて観測する
着手順は、流行語ではなく故障箇所で決めます。入口が遮断されていれば技術基盤、説明が間違っていれば正本と根拠、観測だけが不足していれば計測を優先します。AIO、LLMO、GEOは別々に買う施策ではなく、同じ企業サイトを異なる角度から見るためのレンズです。
自社で故障箇所を切り分ける場合は、LLMO診断で確認する項目を使って、重要URL、質問、根拠、クローラー、更新責任を棚卸しできます。複数部門にまたがり、正本や優先順位を決めにくい場合は、UravationのLLMO・AI検索診断の相談窓口で対象範囲を整理できます。表示や引用を約束する相談ではなく、何を確認し、どこから直すかを決めるための導線です。
公式情報で確認するポイント
AI検索まわりは仕様変更が多いため、記事公開前後に公式情報を確認し、本文の言い切りや実装方針を更新します。
- Google Search Central「Optimizing your website for generative AI features」 生成AI検索に対して、通常のSEO・技術要件・独自性の扱いを確認する公式ガイド。
- Google Search Central「Creating helpful, reliable, people-first content」 人間に役立つ信頼性の高いコンテンツを評価するための公式観点。
本体メディアであわせて確認する記事
この記事のテーマを、Uravation本体メディアで検索流入のあるAIツール・モデル解説にもつなげて確認できます。
AI活用書籍シリーズ累計59,900部の著者チームが監修。自社7メディアの実運用でAI検索からの引用・流入を継続計測しており、その一次データと公式情報に基づいて、企業サイトで実務的に使える形へ整理しています。仕様変更が多い領域のため、公開前後に公式情報と本文の整合性を確認します。
AI検索診断・情報源設計支援に進める
この記事のテーマを自社サイトに当てはめ、公開情報、根拠ページ、FAQ、内部リンク、構造化データ、llms.txtのどこを確認すべきかを整理します。
AI検索攻略の前後の記事
同じ連載の前後の記事へ進み、LLMO、AIO、GEO、AI検索の論点を順番に確認できます。
関連するUravationの導線
AI検索攻略は、Uravation本体のAI活用メディアとサービス導線につながる専門テーマとして運用します。