AIクローラーがJavaScriptを実行する保証を一次情報で整理。SPA・WordPressのタブ、AJAX料金表、FAQをcurlで点検し、SSR・静的生成への修正判断を示します。
- AIクローラー JavaScript レンダリング SPAの定義、実務判断、確認項目をAI検索時代の情報源設計として整理する。
- 公式情報と一次情報を優先し、表示保証や順位改善の断定を避ける。
- 本文、FAQ、内部リンク、llms.txt、構造化データの整合性を継続確認する。
実務で見る観点
各AI検索サービスのクローラー名とrobots.txtでの扱いを公式情報で確認する。
サービス内容、料金、対象者、事例、会社情報を正規ページに集約して矛盾を減らす。
外部メディア、SNS、比較サイトに出ている説明と自社サイトの記述がずれていないか見る。
AIクローラーが本文を取得できるかは、①到達、②初期HTML、③JavaScript実行後のDOM、④AI回答の4層を分ければ切り分けられます。
ブラウザで料金表やFAQが見えていても、サーバーが返す初期HTMLには見出しと空の枠しかなく、JavaScript実行後に本文が挿入されるページがあります。GoogleはGooglebotがJavaScriptを実行すると明示していますが、OpenAI・Anthropic・Perplexityの公式クローラー文書には、JavaScript実行の有無やレンダリング完了を保証する記載がありません。重要な公開情報は、JavaScriptを待たなくても初期HTMLから取得できる状態を基準にしてください。
定義:AIクローラーのJavaScriptレンダリング問題
URLへのアクセスは成功しているのに、料金、サービス条件、会社情報、FAQなどの重要本文がHTTPレスポンスの初期HTMLに含まれず、クライアント側JavaScriptの実行後にだけ現れる状態です。AIクローラーがそのJavaScriptを実行する仕様を公開していない場合、本文を取得できるとは断定できません。
判断基準は単純です。curlで重要文言が取れれば、少なくともJavaScriptなしのHTTPクライアントへ本文を返しています。通常ブラウザだけで見えるならクライアント描画依存です。ただし、初期HTMLに本文があることは取得可能性の入口であり、引用や表示の保証ではありません。
「来た」と「読めた」は同じログに残らない
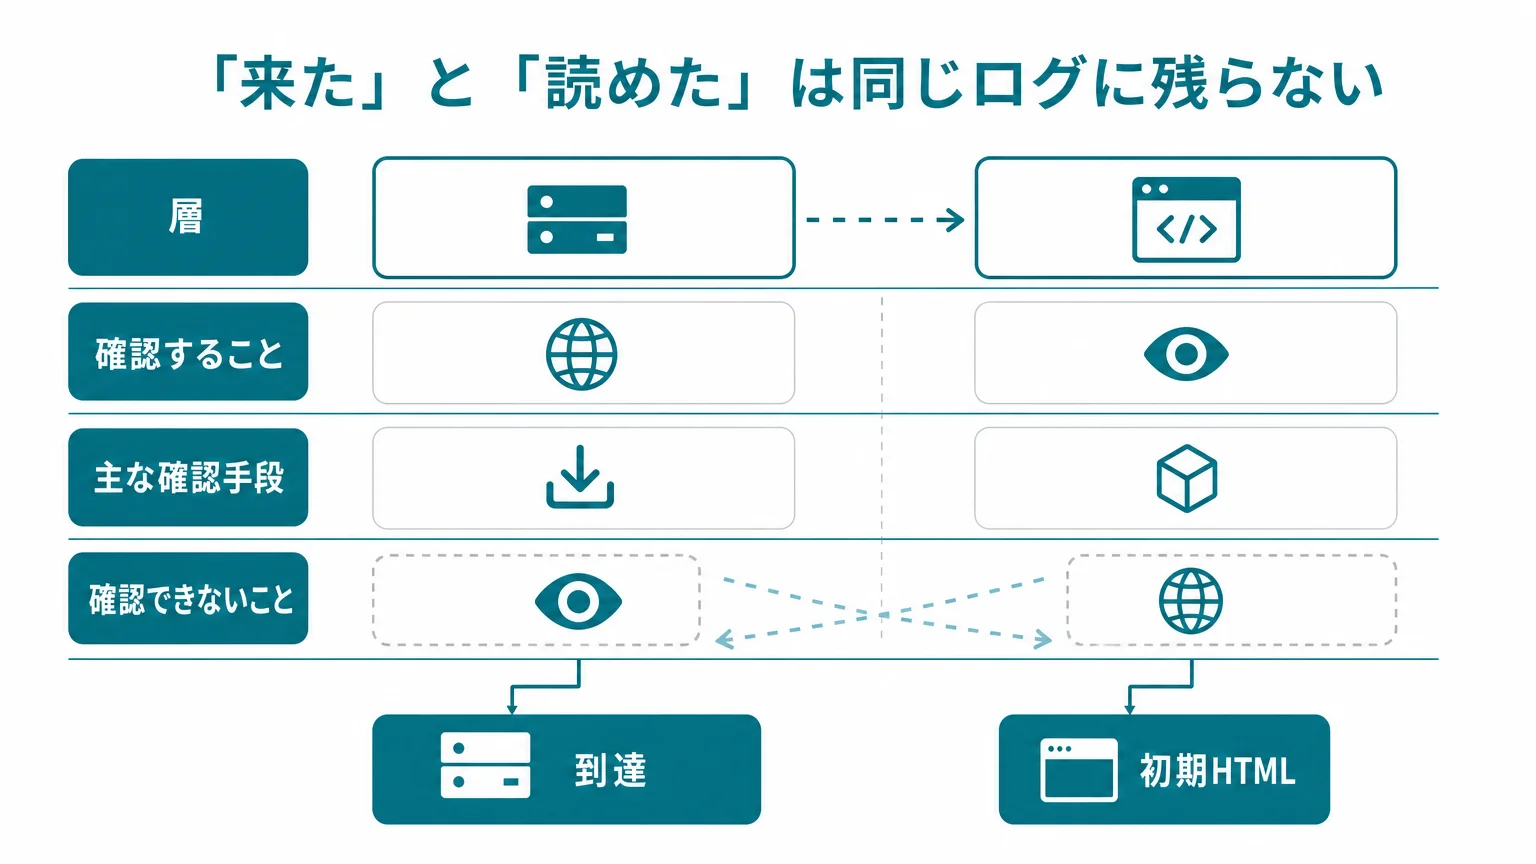
アクセスログにOAI-SearchBotやPerplexityBotのリクエストがあれば、そのURLへリクエストが到達したことは確認できます。しかし、ログだけでは、レスポンス本文のどこまでを解析したか、JavaScriptを実行したか、抽出した情報を回答に使ったかまでは分かりません。
点検対象を4層に分けると、調査の混線を防げます。
| 層 | 確認すること | 主な確認手段 | 確認できないこと |
|---|---|---|---|
| 1. 到達 | robots.txt、WAF、認証、HTTPステータスで拒否されていないか | レスポンスヘッダー、robots.txt、WAF設定、アクセスログ | 本文を解析したか |
| 2. 初期HTML | 重要本文が最初のHTTPレスポンスに入っているか | curl、ページソース、固有文言の照合 | 各AIが実際に採用したか |
| 3. 描画後DOM | JavaScript実行後に何が追加・削除・変更されるか | DevTools、JavaScript無効表示、Google向けレンダリングテスト | Google以外のAIクローラーも同じ描画をするか |
| 4. AI回答 | 回答内容、出典、誤り、日付、再現条件 | 定義した質問群での手動観測 | 採用アルゴリズムや引用の因果関係 |
すでに「クローラーを通すか」を調べたい場合はrobots.txtでAIクローラーを許可すべきか、Cloudflareで止まる可能性を調べたい場合はCloudflareのAIクローラーブロックが与える影響、実際の来訪を調べたい場合はAIクローラーのアクセスログ分析が先です。この記事では、その次の「返した本文に必要情報が入っているか」を扱います。
公式文書が示すのはクローラーの用途であり、描画保証ではない
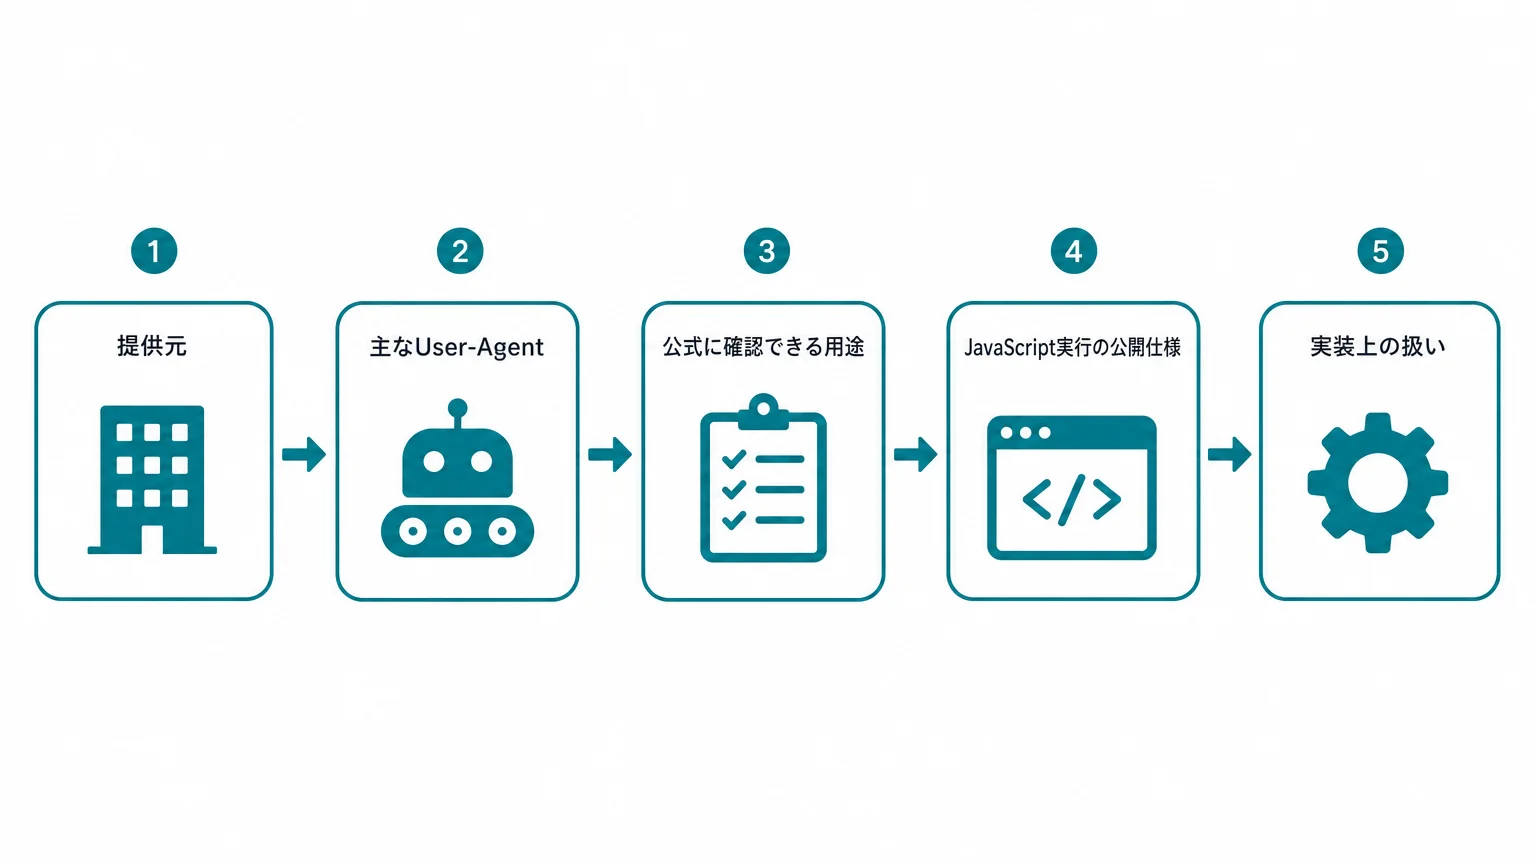
2026年8月27日時点で、OpenAI、Anthropic、Perplexityの公式文書はクローラーの用途と制御方法を説明していますが、JavaScript実行、外部APIの待機、クリックやスクロールの仕様は示していません。これは「実行しない」と確認できたのではなく、「実行する保証を確認できない」という意味です。
| 提供元 | 主なUser-Agent | 公式に確認できる用途 | JavaScript実行の公開仕様 | 実装上の扱い |
|---|---|---|---|---|
| OpenAI | OAI-SearchBot | ChatGPTの検索機能でウェブサイトを表示するための自動検索クロール | 公式クローラー文書に保証記載なし | 検索露出を考える場合の主対象。初期HTMLを基準にする |
| OpenAI | GPTBot | 基盤モデルの学習に利用され得るコンテンツのクロール | 公式クローラー文書に保証記載なし | 検索用Botと混同しない |
| Anthropic | Claude-SearchBot | Claudeの検索結果の品質向上に向けたウェブ巡回・分析 | 公式ヘルプに保証記載なし | 初期HTMLを基準にする |
| Anthropic | ClaudeBot | モデル改善や学習に寄与し得る公開ウェブコンテンツの収集 | 公式ヘルプに保証記載なし | 検索用Botと混同しない |
| Perplexity | PerplexityBot | Perplexity検索結果でサイトを表示・リンクするための収集と索引 | 公式クローラー文書に保証記載なし | 初期HTMLを基準にする |
| Googlebot | Google検索のクロール、レンダリング、インデックス登録 | ChromiumでJavaScriptを実行すると公式説明あり | レンダリングの遅延・失敗・機能差も含めて専用ツールで確認する |
OpenAIの公式クローラー一覧は、OAI-SearchBot、GPTBot、ChatGPT-Userを目的別に分けています。Anthropic公式ヘルプもClaude-SearchBot、ClaudeBot、Claude-Userを分け、Perplexity公式のクローラー文書はPerplexityBotとPerplexity-Userを分けています。検索用、自動学習用、ユーザー操作起点の取得を一括して「AIクローラー」と扱うと、robots.txtの判断も検証対象もずれます。
対照的に、GoogleのJavaScript SEO公式ガイドは、Googlebotがクロール後にページをレンダリングキューへ入れ、ChromiumでJavaScriptを実行すると説明しています。同じ文書は、サーバーサイドレンダリングや事前レンダリングがユーザーとクローラーの双方に有用であり、すべてのBotがJavaScriptを実行できるわけではないとも説明しています。
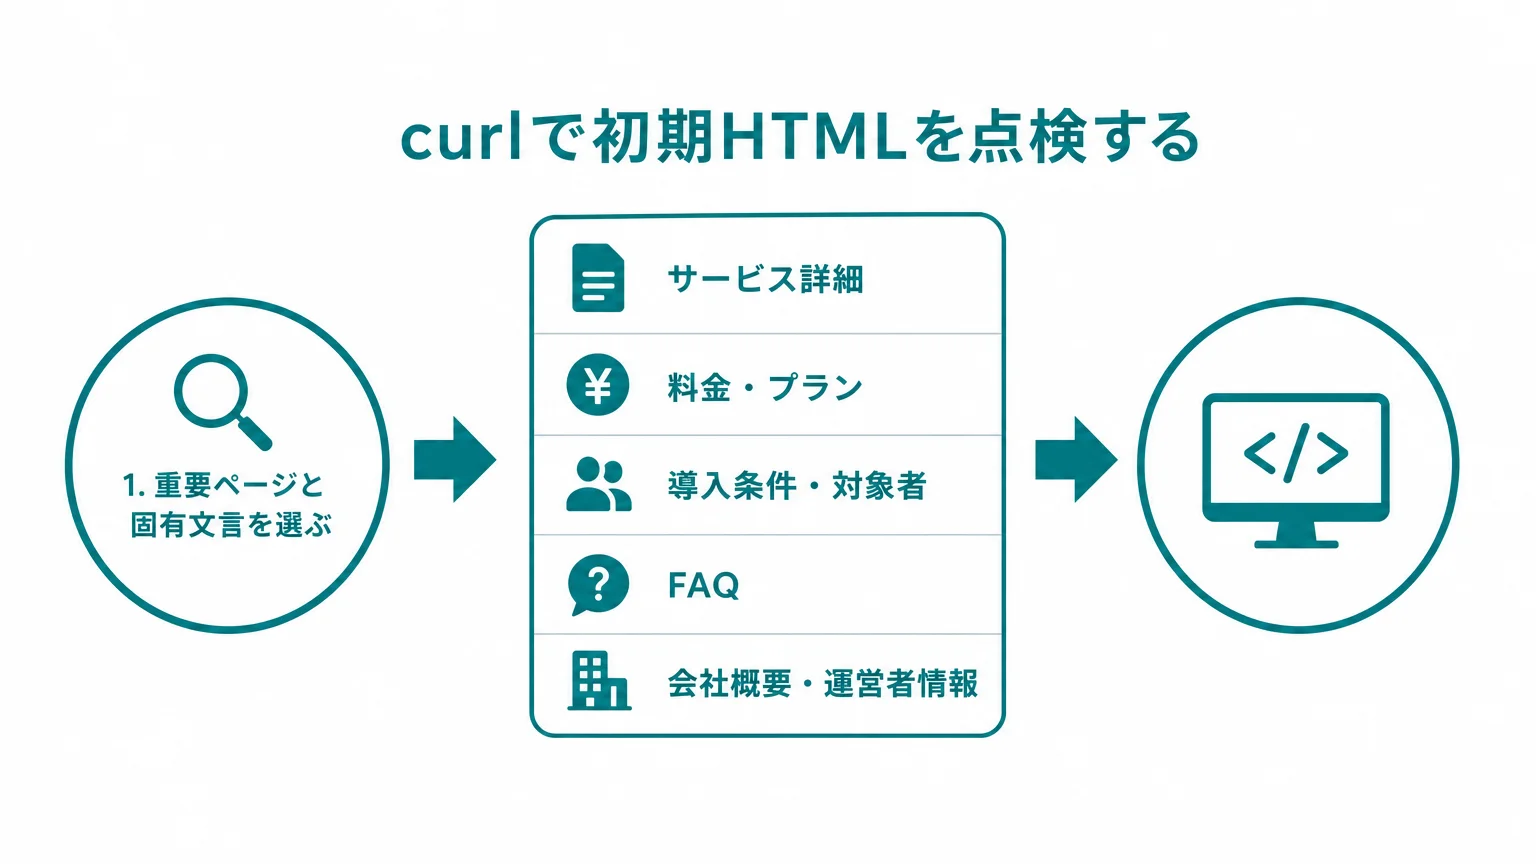
curlで初期HTMLを点検する
curlはブラウザではなく、URLからデータを転送するツールです。curl公式FAQは、curlとlibcurlにはJavaScriptの組み込み実行機能がないと明記しています。そのため、curlは「JavaScriptを実行しない取得」の基準を作るのに向いています。
ただし、curlはOAI-SearchBotやClaude-SearchBotの動作を再現するエミュレーターではありません。取得元IP、キャッシュ、Cookie、対応圧縮、追加リクエスト、解析方法まで同じにはならないため、結果は初期HTMLの検査として使います。
1. 重要ページと固有文言を選ぶ
トップページだけで合否を決めず、次の役割から代表URLを選びます。
- サービス詳細
- 料金・プラン
- 導入条件・対象者
- FAQ
- 会社概要・運営者情報
- 導入事例・実績の根拠ページ
- SPAの深い階層の直接アクセス用URL
各URLでは、画面上に表示される重要文言を1つ選びます。「料金」や「FAQ」のような短い語ではなく、「法人プランには初期設定支援が含まれます」のように、そのページに固有の一文を使うと誤判定を減らせます。
2. ステータス、Content-Type、最終URLを確認する
次のコマンドはリダイレクトを追い、本文を保存しながら基本情報を表示します。
<pre><code>target_url='https://example.com/pricing/' curl -sS -L --compressed \ -o initial.html \ -w 'status=%{http_code} type=%{content_type} final=%{url_effective}\n' \ "$target_url"</code></pre>
200だけでなく、最終URLとContent-Type、ログイン・Cookie同意・チャレンジ画面への置換、存在しないSPAルートへの共通200応答を確認します。
3. 保存した初期HTMLに固有文言があるか調べる
<pre><code>rg -n -F '法人プランには初期設定支援が含まれます' initial.html</code></pre>
該当行が出れば、その文字列は初期HTMLに含まれています。出なければ、表記ゆれを確認したうえで、ブラウザが後から取得している可能性を調べます。総バイト数の多寡ではなく、重要情報ごとの固有文言で確認するのがポイントです。巨大なJavaScriptバンドルが埋め込まれていれば、本文が空でもファイルサイズは大きくなります。
コマンドを1本で済ませるなら、次の形でも確認できます。
<pre><code>curl -sS -L --compressed 'https://example.com/pricing/' \ | rg -n -F '法人プランには初期設定支援が含まれます'</code></pre>
4. JavaScriptを無効にしたブラウザと比較する
Chrome DevToolsでは、コマンドメニューからJavaScriptを無効にし、そのタブを再読み込みできます。手順はChrome公式のDisable JavaScriptで確認できます。
curlの初期HTML、JavaScript無効画面、通常画面の3つを比べます。前二者に重要本文がなく通常画面にだけあるなら、クライアント側JavaScript依存です。curlには本文があるのに実行後に消えるなら、ハイドレーションの不一致やAPI上書きも疑います。
5. User-Agent差分は補助検査として使う
WAF、CDN、キャッシュ、古いダイナミックレンダリング設定がUser-Agentで本文を変えていないかは、補助的に確認できます。
<pre><code>target_url='https://example.com/pricing/' curl -sS -L -A 'OAI-SearchBot' "$target_url" \ | rg -n -F '法人プランには初期設定支援が含まれます'</code></pre>
これは文字列を名乗るだけで、正規のOpenAIクローラーを再現しません。公式IPからのアクセスでもありません。合否判定には使わず、通常取得との差が出た場合に配信設定を調べます。
6. Googleだけはレンダリング結果を別に確認する
Googlebotについては、Search ConsoleのURL検査やリッチリザルトテストで、読み込んだリソース、JavaScriptエラー、レンダリング後HTMLを確認できます。これはGoogle検索向けの確認であり、OpenAI、Anthropic、Perplexityのレンダリング能力を証明するものではありません。
検査結果を5パターンで判断する
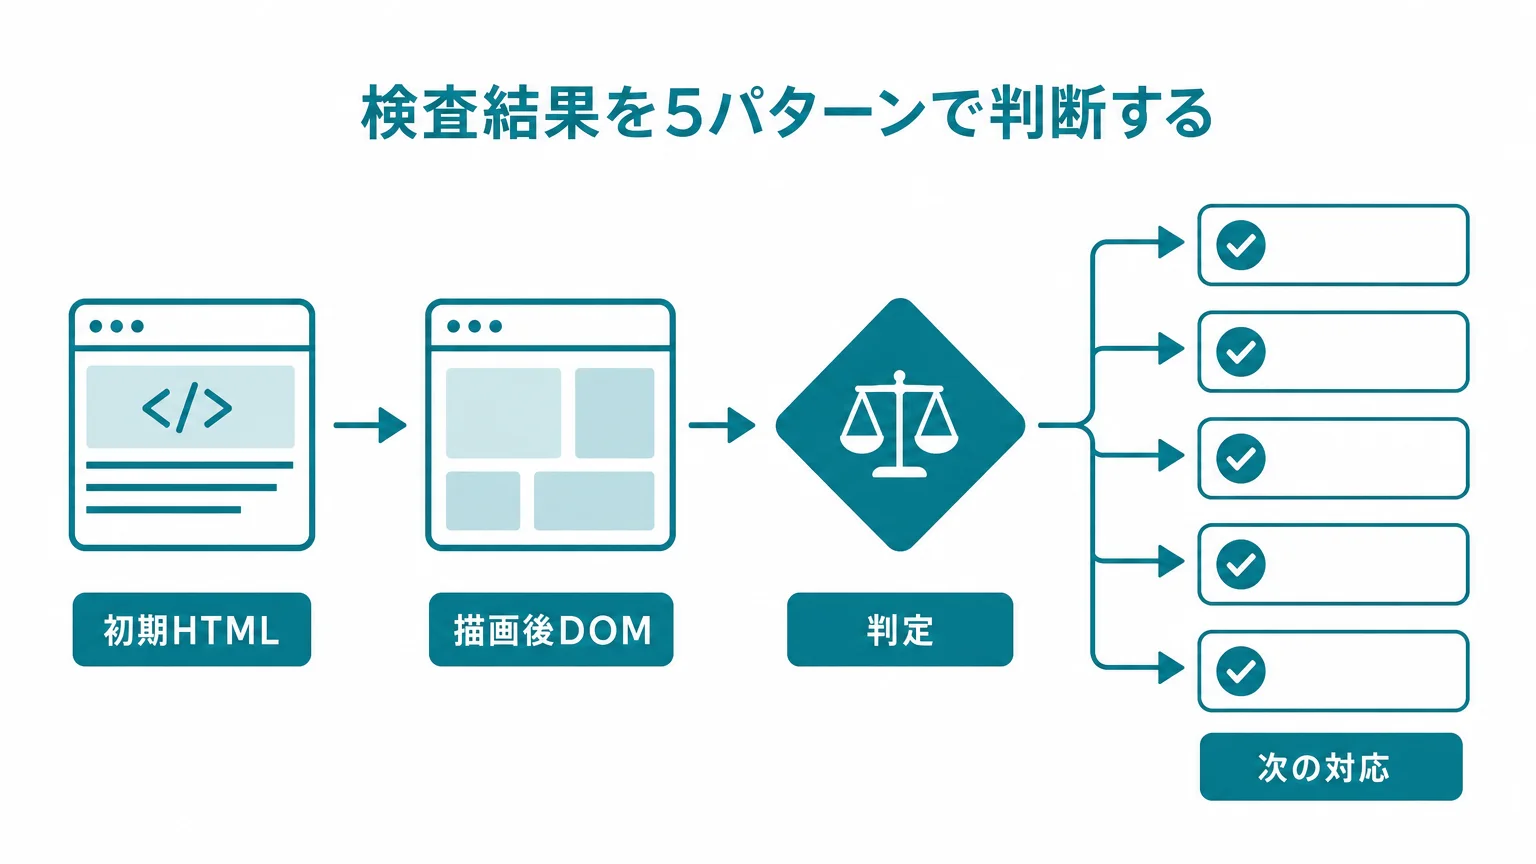
見た目だけで「読める」「読めない」と決めず、初期HTMLと描画後DOMの組み合わせで修正対象を決めます。
| 初期HTML | 描画後DOM | 判定 | 次の対応 |
|---|---|---|---|
| 重要本文あり | 同じ本文あり | JavaScriptなしでも本文を取得できる基礎状態 | 見出し、リンク、更新日、構造化データとの整合を確認する |
| 重要本文なし | 重要本文あり | クライアント描画依存 | SSG、SSR、サーバー出力、初期データ埋め込みを検討する |
| 重要本文なし | 重要本文なし | 公開条件、URL、API、権限、実装自体の問題 | NetworkとConsoleで失敗箇所を特定する |
| 重要本文あり | 本文が消える・古くなる | ハイドレーションまたはAPI上書きの問題 | サーバーとクライアントのデータ源、キャッシュ、時刻条件を揃える |
| User-Agentで本文が変わる | Bot向けと通常向けで不一致 | WAF、CDN、キャッシュ、Bot判定の問題 | 同等内容を共通配信し、Bot専用分岐を減らす |
SPAはSSR・SSG・ハイドレーションで重要本文を先に返す
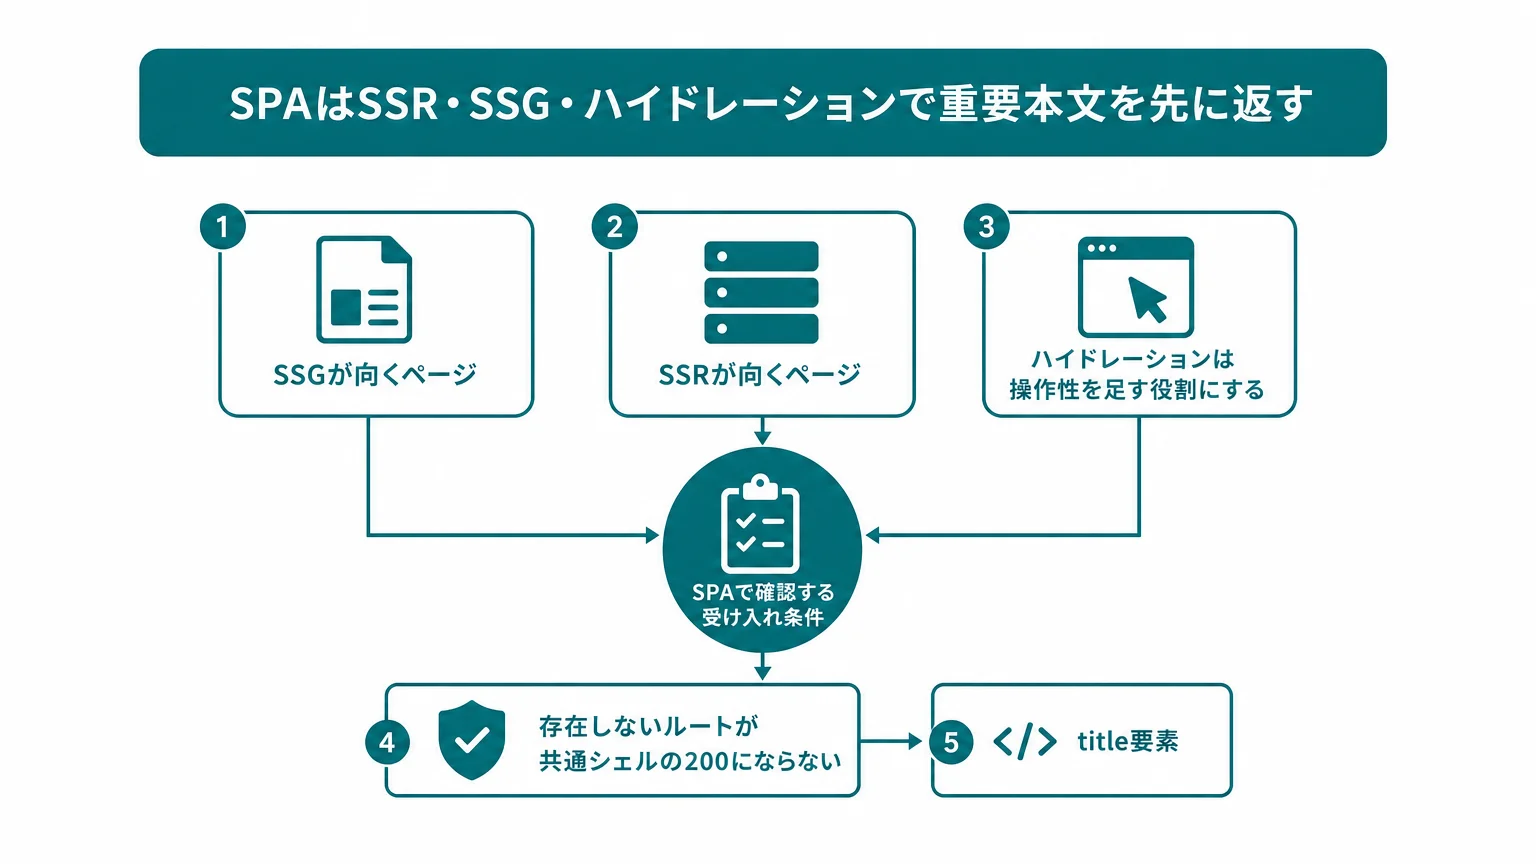
SPAの問題は、画面遷移が滑らかなことではありません。直接URLへアクセスしたときに、公開すべき重要本文を含むHTMLが返らないことです。JavaScriptによる操作性を残しながら、本文だけはサーバーまたはビルド時に出力できます。
SSGが向くページ
会社概要、サービス説明、固定FAQ、用語集など、事前に内容を生成できるページは静的生成が向きます。ビルド時にURLごとのHTMLを作り、JavaScriptを待たずに本文を返せます。
SSRが向くページ
公開価格や更新頻度の高い募集情報など、リクエスト時点の共有データが必要なページはSSRを検討します。公開説明とログイン後の個別情報は分けます。
ハイドレーションは操作性を足す役割にする
初期HTMLに見出し、要約、本文、通常リンクを出し、JavaScriptはタブ切替や絞り込みなどの操作性に寄せます。失敗しても主題と判断材料が残る設計です。
Next.jsのSPAガイドは、厳密なSPAを単一HTMLからクライアント側でルーティングとデータ取得を行う構成とし、静的出力ではルートごとのHTMLを生成できると説明しています。確認すべきは方式名ではなく、実際のレスポンス本文です。
Googleはダイナミックレンダリングを長期解決策として推奨していません。BotをUser-Agentで見分けて別HTMLを返す構成は、キャッシュ分岐、内容差、保守漏れを増やします。基本は、ユーザーにもクローラーにも同等の重要本文をSSR、静的レンダリング、ハイドレーションで返すことです。
SPAで確認する受け入れ条件
- 各公開ルートへ直接アクセスして200または適切な4xxが返る
- 存在しないルートが共通シェルの200にならない
- title要素、H1、要約、本文、canonicalがルートごとに一致する
- 重要な内部遷移は、JavaScriptイベントだけでなくURLを持つ通常リンクとして存在する
- 初回表示に必要な公開データが、Cookie、localStorage、クリック、スクロールに依存しない
- API失敗時に古い価格や空欄を確定情報として見せず、ハイドレーション後も本文の意味を保つ
WordPressは「折りたたみ」より「後から取得」を警戒する
WordPressだから自動的に安全、ページビルダーだから必ず危険、とは言えません。同じアコーディオン表示でも、本文が最初からHTMLに入りCSSやJavaScriptで開閉する実装と、クリック後にAJAXで本文を取得する実装があります。見た目では区別できないため、curlで固有文言を探します。
タブとアコーディオン
閉じたパネルの本文が初期HTMLに入っていれば、少なくともテキストのバイト列は返されています。逆に、タブを押した瞬間にAPIへ取りに行く方式では、クリックしないクローラーが内容を得られる保証はありません。
WordPressコアのDetailsブロック公式仕様では、折りたたみ内の内容を静的マークアップとして保存し、サーバー側で拡張できるハイブリッドブロックと説明されています。コアブロックと同じ見た目でも、テーマやプラグインが独自方式へ置き換えている場合があるため、実サイトのレスポンスを確認してください。
AJAXで読む料金表
料金表が「読み込み中」だけで、別APIから価格を取る場合、認証、WAF、タイムアウト、地域判定のどこかで本文が欠けます。全組み合わせを展開する必要はありませんが、料金体系、含まれる範囲、追加費用の条件、更新日、詳細への通常リンクは初期HTMLに置きます。
JavaScriptで挿入するFAQ
質問だけを初期HTMLに置き、回答はクリック後に取得する構成では、回答本文が空になる可能性があります。質問と回答を初期HTMLへ置き、開閉だけをJavaScriptに任せる方が堅牢です。
構造化データだけに回答を入れ、読者向け本文を空にするのも避けます。Googleの構造化データ一般ガイドラインは、構造化データと読者に見える内容の対応を求めています。FAQ本文の設計はAI検索時代のFAQ設計でも確認できます。
| WordPressの表示要素 | 低リスクの状態 | 注意する状態 | 修正の方向 |
|---|---|---|---|
| タブ・アコーディオン | 全パネルの本文が初期HTMLにあり、開閉だけを行う | クリック後に本文をAJAX取得する | 本文をサーバー出力し、開閉を段階的機能追加にする |
| 料金表 | 料金体系、条件、更新日、詳細リンクが初期HTMLにある | 空の枠とローディング表示しかない | 判断に必要な共通情報をサーバー出力する |
| FAQ | 質問と回答が初期HTMLにある | 回答がAPIまたは構造化データにしかない | 読者向けQ&A本文を先に出す |
| 記事一覧・事例一覧 | 主要項目と詳細URLが初期HTMLにある | 無限スクロール後にしかURLが現れない | ページ送りと通常リンクを用意する |
| 会員向け情報 | 公開説明と非公開データが分離されている | 公開ページもログイン状態やCookieに依存する | 公開範囲だけを独立した本文として返す |
ありがちな失敗は「画面で見えたから合格」にすること
失敗1:200だから読めると判断する
200でも必要本文があるとは限りません。SPAでは存在しないURLにも同じ空のシェルを200で返すことがあります。ステータスと固有文言をセットで確認します。
失敗2:Googleのレンダリング成功を全AIへ一般化する
Googlebotのレンダリング成功は、OAI-SearchBot、Claude-SearchBot、PerplexityBotが同じ処理をする根拠になりません。Googleのテストと初期HTMLの共通基準を分けます。
失敗3:User-Agentを変えたcurlを本物のBot試験と呼ぶ
User-Agentは偽装でき、公式IP、Cookie、キャッシュ条件までは再現しません。設定差の調査には使えますが、Botの真正性や取得能力の証明には使えません。
失敗4:Bot専用の本文を作る
Bot向けとユーザー向けを分けると、価格改定漏れやCDNの誤配信が起きます。公開情報の正本を1つにし、同等内容を返します。
失敗5:構造化データに本文の穴埋めをさせる
FAQや価格の構造化データがあっても、読者向け本文が空では不十分です。見える本文と一致させ、テーマなど適切な実装層で管理します。
修正後に通す実装チェックリスト
HTTPレスポンス
- 代表URLが意図した最終URLとステータスを返す
- 存在しないSPAルートは適切な404を返す
- Content-Typeが正しく、チャレンジページやログイン画面へ置き換わらない
- title要素、H1、要約、canonicalが同じページを示し、重要本文が操作なしで初期HTMLに入る
重要情報
- サービスの対象、提供内容、対象外が初期HTMLにある
- 料金体系、追加費用の条件、更新日が初期HTMLにある
- FAQは質問と回答の両方が初期HTMLにある
- 会社・著者情報、事例の集計条件、構造化データが見える本文と矛盾しない
SPA・WordPress実装
- 公開ルートごとに直接アクセス可能なURLがある
- 重要な内部リンクはJavaScript操作だけに依存しない
- タブやアコーディオンは本文を後取得せず、開閉だけを担う
- API失敗時に古い値を確定情報として表示せず、ハイドレーション後も固有文言が一致する
- Bot専用HTMLではなく、ユーザーと同等の公開本文を返す
検証
- curlでページ固有の重要文言を検索できる
- JavaScript無効画面でも主題と判断材料が分かる
- 通常ブラウザとGoogle向けレンダリングテストも確認した
- User-Agent差分はWAF・CDNまで調べ、アクセスログの来訪と本文取得を混同していない
このチェックリストは引用や順位を保証せず、JavaScript実行能力の分からない取得主体にも公開情報が届く基礎状態を確認するものです。
JavaScript描画とAIクローラーのよくある質問
JavaScriptを使うとAI検索に不利ですか?
JavaScript自体が問題なのではありません。重要本文がJavaScript実行後にしか現れず、その実行能力が確認できない取得主体へ依存することが問題です。初期HTMLに本文を出し、JavaScriptを操作性の追加に使えば両立できます。
curlで本文が見えれば、AIに必ず読まれますか?
いいえ。curlで確認できるのは、JavaScriptなしのHTTP取得でその文字列が返ることです。AI側のクロール対象選定、解析、索引、回答生成、出典採用は別工程で、表示や引用は保証できません。
閉じたアコーディオンの回答も読まれますか?
初期HTMLに回答本文があれば、少なくともレスポンスには含まれています。ただし、各AIが折りたたみ内の情報をどう重み付け・抽出するかは公開されていません。初期HTMLにない場合より取得経路は堅牢ですが、採用は保証できません。
GPTBotで確認すればChatGPT検索も確認したことになりますか?
なりません。OpenAI公式では、GPTBotは基盤モデル学習に使われ得るコンテンツのクロール、OAI-SearchBotはChatGPT検索機能でサイトを表示するためのクロールと役割が分かれています。ChatGPT-Userもユーザー操作起点であり、自動検索クロールとは別です。
WordPressなら本文は最初からHTMLに入りますか?
テーマ、ページビルダー、タブ、会員機能、料金APIによって変わります。製品名だけで判断せず、公開URLごとにcurlで固有文言を確認してください。
JavaScriptで生成した構造化データは無効ですか?
Googleは、JavaScriptで挿入したJSON-LDを処理できると説明しています。ただし、それはGoogleの仕様です。AIクローラー各社のJavaScript実行保証にはなりません。また、構造化データが見える本文の代わりになるわけでもありません。重要な意味情報は本文に置き、構造化データを一致させます。
最後に確認すべきこと
最終判断は「ブラウザで見えたか」ではなく、「重要本文が最初のHTTPレスポンスに含まれるか」です。
確認順は次の通りです。
- robots.txt、WAF、認証、ステータスでURLへ到達できるか
- curlで料金、条件、FAQなどの固有文言を取得できるか
- JavaScript無効時と有効時で、本文の意味が変わらないか
- SPAはSSG・SSR・ハイドレーション、WordPressはサーバー出力と開閉分離で直せるか
- 修正後も、アクセスログとAI回答を別の証拠として観測できるか
OpenAI・Anthropic・Perplexityの公式文書にJavaScript実行保証がない以上、重要な公開情報をクライアント描画だけに預けないことが現実的な受け入れ基準です。一方で、初期HTMLへ出しただけで引用や表示が決まるわけではありません。到達、本文取得、情報の正確性、回答観測を順に分けてください。
複数のテーマ、ページビルダー、SPA、CDNが混在し、どの層で本文が消えているか自社だけでは切り分けにくい場合は、LLMO診断で確認する項目を使って、クロール制御、初期HTML、情報源の整合、AI回答をまとめて点検できます。
公式情報で確認するポイント
AI検索まわりは仕様変更が多いため、記事公開前後に公式情報を確認し、本文の言い切りや実装方針を更新します。
- Google Search Central「Optimizing your website for generative AI features」 生成AI検索に対して、通常のSEO・技術要件・独自性の扱いを確認する公式ガイド。
- Google Search Central「Creating helpful, reliable, people-first content」 人間に役立つ信頼性の高いコンテンツを評価するための公式観点。
本体メディアであわせて確認する記事
この記事のテーマを、Uravation本体メディアで検索流入のあるAIツール・モデル解説にもつなげて確認できます。
AI活用書籍シリーズ累計59,900部の著者チームが監修。自社7メディアの実運用でAI検索からの引用・流入を継続計測しており、その一次データと公式情報に基づいて、企業サイトで実務的に使える形へ整理しています。仕様変更が多い領域のため、公開前後に公式情報と本文の整合性を確認します。
AI検索診断・情報源設計支援に進める
この記事のテーマを自社サイトに当てはめ、公開情報、根拠ページ、FAQ、内部リンク、構造化データ、llms.txtのどこを確認すべきかを整理します。
AI検索攻略の前後の記事
同じ連載の前後の記事へ進み、LLMO、AIO、GEO、AI検索の論点を順番に確認できます。
関連するUravationの導線
AI検索攻略は、Uravation本体のAI活用メディアとサービス導線につながる専門テーマとして運用します。