Googleが2026年11月11日の公式ブログで説明した、CDN導入の直後にクロールが急増する理由と、一律のbot対策でGooglebotを止める落とし穴。確認済みbotの許可、キャッシュの準備、429と503の使い方を整理します。
- 応答が速く安定すると、Googleの「クロール能力の上限」(ホスト負荷)は、クロールの必要性がある限り少しずつ上がる
- 新しいCDNのキャッシュは空で、初めてのURLは元のサーバーまで取りに行く。クローラーはURLを広く回るので、キャッシュが温まるまで元のサーバーの負荷は下がりにくい
- Googleのクローラーかどうかは、User-Agentの文字ではなく、逆引きと正引きのDNSの照合か、Googleが公開しているIPの範囲で確かめる
CDNを入れたら、Googlebotのクロールは落ち着くのでしょうか。Googleが2026年11月11日(米国時間)に公式ブログで書いた答えは逆で、切り替えた直後はクロールが増えることがあり、CDNのキャッシュにまだ写しが無いURLの取得は、元のサーバー(オリジン)まで届きます。
この時期に元のサーバーのログを見て慌て、CDNの管理画面で一律のbot対策を入れると、Googleのクローラーは確認の画面(CAPTCHAなど)を通れません。Googleは、確認済みのクローラーを外さないまま放っておくと、クローラーが取得を控え、ページが検索から落ち始めると書いています。ブログが勧める手当ては、確認済みのbotを許可する、全部の通信を切り替える前にキャッシュを温める、元のサーバーが苦しい時だけ429か503を短い間(数時間、長くても1〜2日)返す、の3つです。
2026年11月12日時点で、Googleの公式ブログと文書から確かめられた要点は次の4つです。
- 応答が速く安定すると、Googleの「クロール能力の上限」(ホスト負荷)は、クロールの必要性がある限り少しずつ上がる
- 新しいCDNのキャッシュは空で、初めてのURLは元のサーバーまで取りに行く。クローラーはURLを広く回るので、キャッシュが温まるまで元のサーバーの負荷は下がりにくい
- Googleのクローラーかどうかは、User-Agentの文字ではなく、逆引きと正引きのDNSの照合か、Googleが公開しているIPの範囲で確かめる
- AIによる概要とAIモードでサポートリンクとして表示されるには、ページがインデックスに登録されていて、Google検索でスニペットを表示できることが条件になる(GoogleのAI機能の文書)
AI検索の定義ブロック
CDN導入直後のクロールの急増とは、DNSをCDNの端のサーバー(エッジ)に向けた後、応答が速く安定したことで、クロールの必要性がある限りGoogleのクロール能力の上限が少しずつ上がり、まだキャッシュに無いURLの取得が元のサーバーに集まる状態を指します。Googleは2026年11月11日(米国時間)の公式ブログで、この時期に確認済みのクローラーを外さない一律のbot対策を入れるとGoogleのクローラーが確認の画面で止まり、そのままにするとページが検索から落ち始めると書き、確認済みのbotの許可、キャッシュの事前の準備、429か503による短い間のブレーキの3つを勧めています。順位の話ではなく、クロールの頻度と元のサーバーの負荷の話です。
CDNに切り替えた直後、クロールが増える仕組み
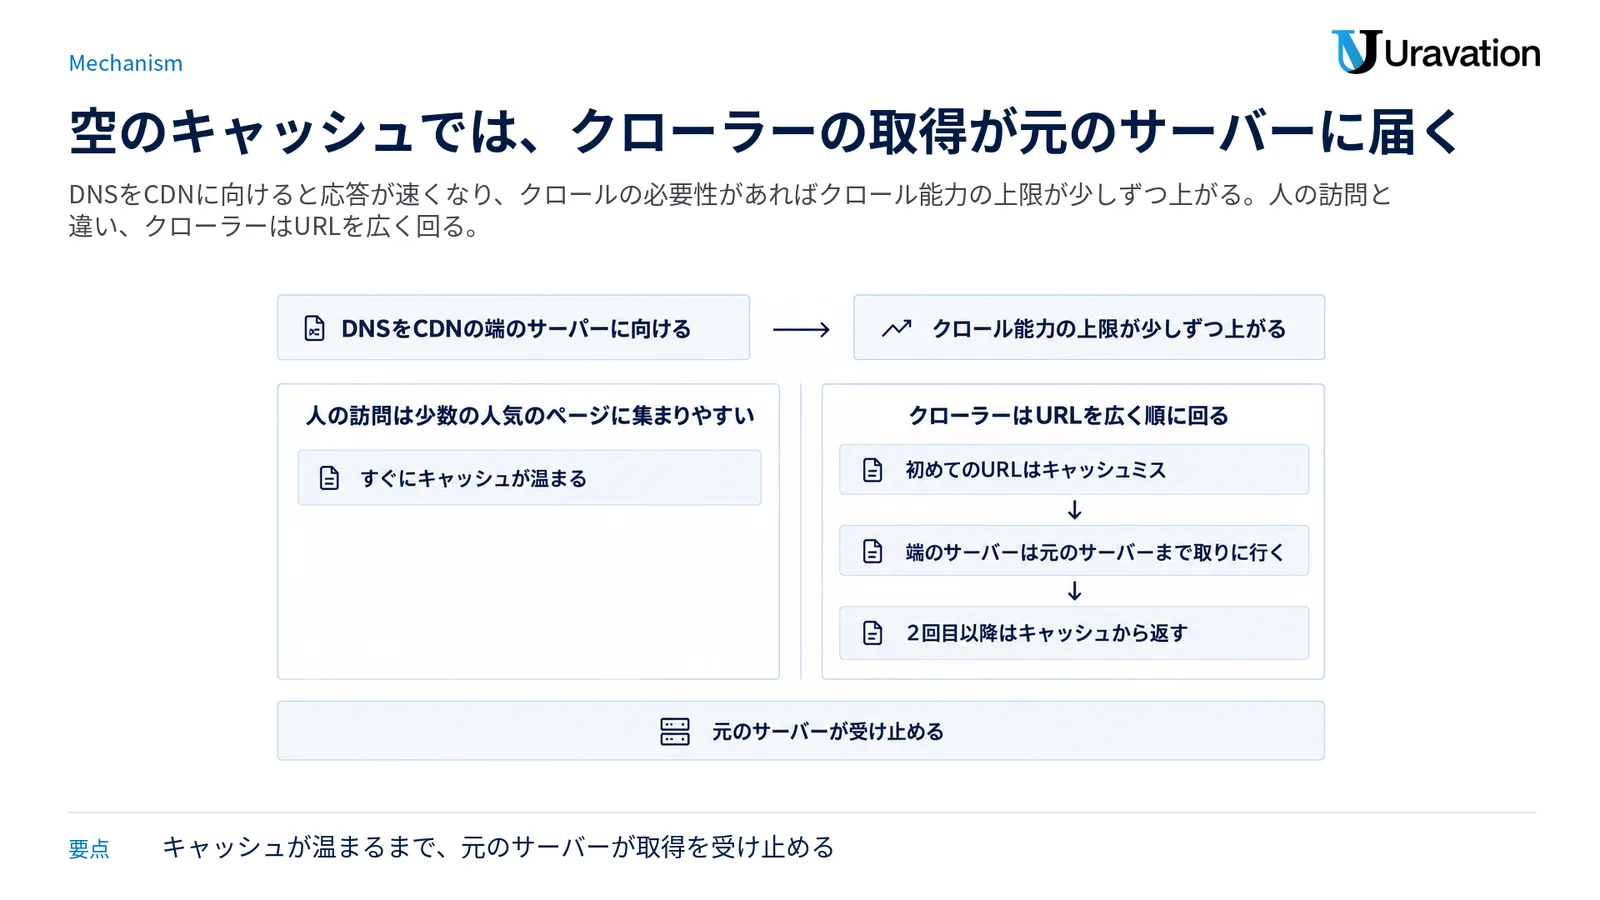
Googleがサイトをどれだけクロールするかは、主にクロール能力の上限とクロールの必要性の2つで決まります。Googleのクロール バジェットの文書によると、クロール能力の上限(ホスト負荷とも呼ばれる)は、サーバーがGoogleとの接続を保つ合計の時間を、並列の接続の数と接続の長さの両方で抑える物です。どのサイトも同じ控えめな既定の値から始まり、クロールの必要性があってサイトが健全なら、Googleのシステムが時間をかけて自動で調整します。
上限が上がるのは、サイトが一貫して応答し、応答時間(レイテンシやTime-to-First Byteを含む)が安定しているか改善している時です。応答が遅くなった時や、サーバーエラー(5xx)やレート制限の合図(429)を返した時は下がります。
今回のブログの説明では、DNSをCDNの端のサーバーに向けると、接続と応答の時間が大きく縮み、Googleのクロールのシステムからはサーバーが大きく増強されたように見えます。クロールの必要性があれば、クロール能力の上限が少しずつ上がるので、クローラーは取得のペースを上げ始めます。
キャッシュが空のうちは、元のサーバーが受け止める
取得が増えても、CDNの端で受け止められれば困りません。ところが新しいCDNのキャッシュは空(cold)です。ブログによると、端のサーバーの拠点にそのURLの写しがまだ無い時、初めてのURLはキャッシュミスになります。この時、端のサーバーは元のサーバーまで取りに行く必要があり、キャッシュできる写しを保存してから返します。その拠点に写しがある間、同じURLの2回目以降はキャッシュから返すので、元のサーバーには届きません。
人の訪問は少数の人気のページに集まりやすいので、トップページや人気の記事、開催中のキャンペーンのページは、すぐにキャッシュが温まるとブログは書いています。一方、クローラーはURLを広く順に回るのが役目です。速い応答を見てGoogleのクローラーが取得のペースを上げ、初めてのURLを取るたびにキャッシュミスが元のサーバーへ通り抜ける、という重なりが起きます。
ブログは、Googleのクローラーはすぐには取得のペースを上げず、多くのCDNには接続のペースをならす仕組みがあるとも書いています。それでも、キャッシュが温まるまで元のサーバーが受け止める、つまりCDNはまだ盾として働いていない、というのがGoogleの説明です。Googleは2024年12月の記事でも、CDNの後ろにあっても元のサーバーはすべてのURLを少なくとも1回は返す必要があり、多くのURLを一度に出す時はクロールの頻度が数日は高くなりやすいと書いていました。
一律のbot対策で、Googleのクローラーは確認の画面から先へ進めない
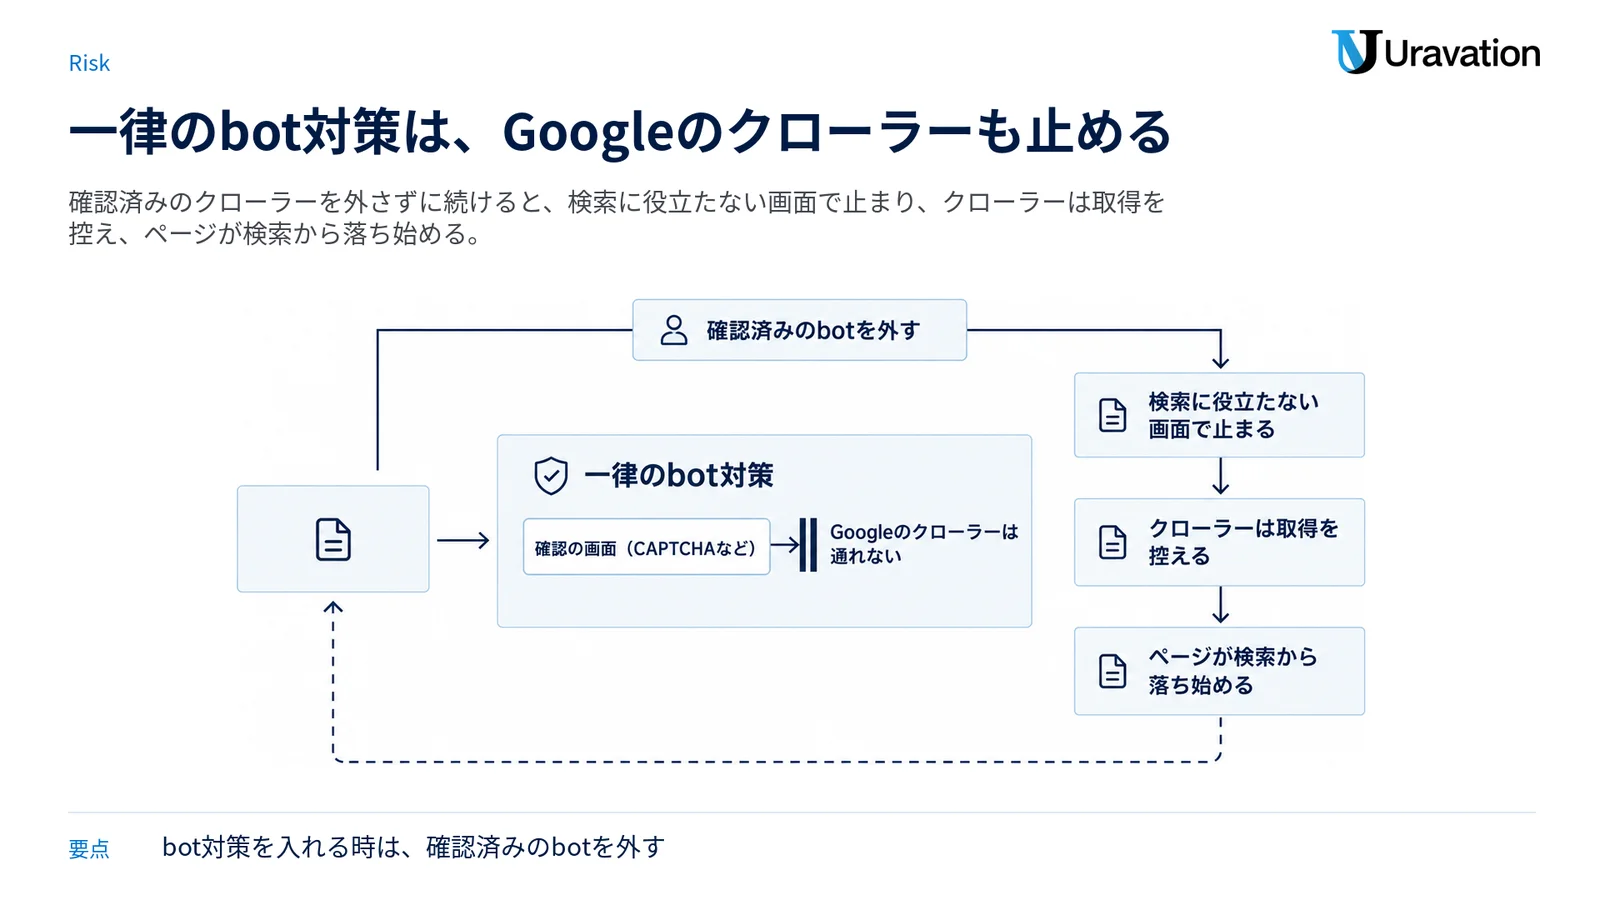
移行の直後に元のサーバーのログで自動の取得が急に増えると、CDNの管理画面で一律のbot対策を入れたくなります。ブログが注意しているのは、この動きです。例外を作らない一律のルールは、残したいクローラーの通信も含めて、すべての自動の通信を同じように扱うからです。CDNやWAF(Web Application Firewall)が自動の取得を見つけてCAPTCHAのような確認で止めると、Googleのクローラーは通れない、とブログは書いています。
確認済みのクローラーを外さずに一律のbot対策を続けると、クローラーは、検索や、クロールしたデータを使うほかの製品に役立たないエラーの画面で止まります。Googleからは、サイトがわざと制限されているか、壊れているように見えます。そのままにすると、クローラーは取得を控えるようになり、ページやショッピングの掲載が検索から落ち始める、というのがブログの説明です。
Googleのクローラーがどんな応答を受け取ると何が起きるかを、Googleの文書と2024年12月のブログに書かれている範囲で並べます。
| クローラーが受け取る物 | Googleの文書が書く扱い | どう直すか |
|---|---|---|
| 確認の画面(CAPTCHAなど) | Googleのクローラーは通れない。検索に役立たない画面で止まる。続けばクロールが下がり、ページが検索から落ち始める | 確認済みのbotを外す。自動の取得に確認の画面を出す時は503を返すよう、2024年12月のブログは強く勧めている。503を返すのも、長くても1〜2日まで |
| 403(拒否) | 429以外の4xxを返したURLはインデックスに登録されず、登録済みなら外される。クロールの頻度を下げる合図にはならない | クロールを抑える目的で401や403を使わない |
| エラーの文を200で返す | 2024年12月のブログは「特に悪い」と書く。エラーと判断されれば検索から外れ、判断されなければ同じ文のページが重複として外されることがある | エラーの時に200を返さない |
| CDNでの接続のタイムアウト | 2024年12月のブログによると、影響を受けたURLはインデックスから外れ、クロールの頻度にも大きく響くことがある | CDNの設定と元のサーバーの状態を見直す |
| 429か503(短い間) | 5xxと429はクロールを一時的に遅くする合図。登録済みのURLはいったん保たれるが、続けばいずれ外れる | 数時間、長くても1〜2日に留める |
AIによる概要とAIモードも、インデックスに登録されていることが前提
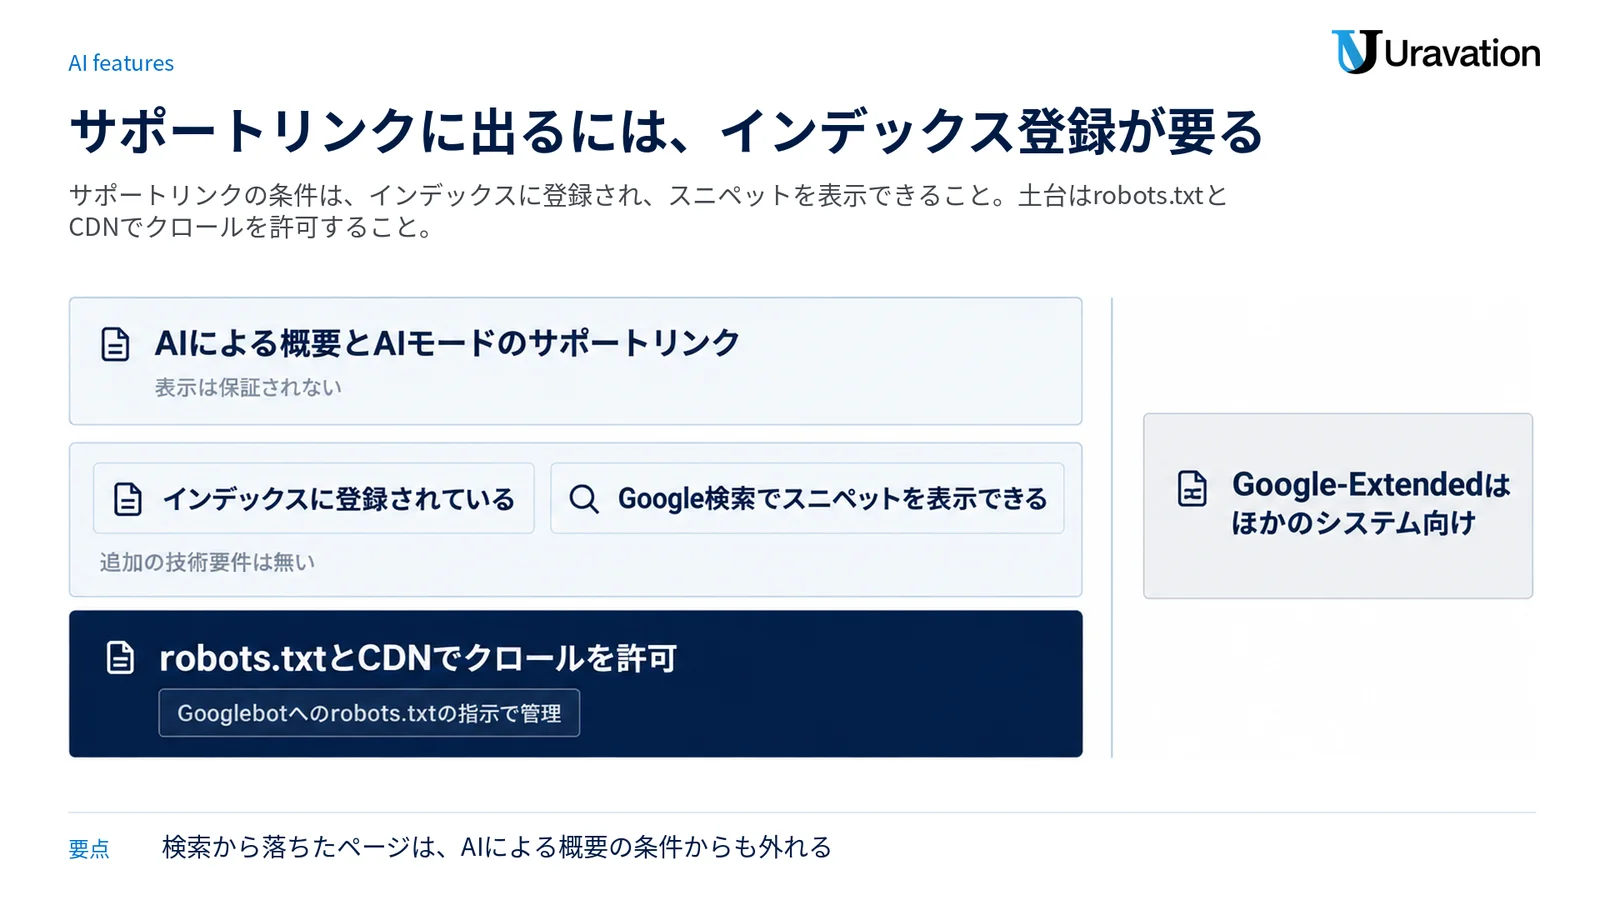
Googleの「AI機能とウェブサイト」の文書は、AIによる概要やAIモードでサポートリンクとして表示されるための条件を、ページがインデックスに登録されていること、Google検索でスニペットを表示できること、検索の技術要件を満たしていることとし、これ以外に追加の技術要件は無いと書いています。同じ文書は、AI機能のための特別な最適化は要らないとしたうえで、引き続き大事なSEOの基本の1つ目に、クロールがrobots.txtに加えて、CDNまたはホスティングのインフラで許可されていることを挙げています。土台はrobots.txtとCDNでクロールを許可することです。
つまり、CDNの確認の画面でGoogleのクローラーが止まり、ページが検索から落ちれば、そのページはAIによる概要とAIモードのサポートリンクとして表示される条件から外れます。逆に、条件を満たしても表示されるとは限りません。文書は、インデックスへの登録と表示は保証されないと書いています。
AIの機能に自社の情報を使わせたくないつもりで、Googlebotまで止めないことも大切です。同じ文書は、AIは検索に組み込まれた物なので、検索のクロールはGooglebotへのrobots.txtの指示で管理すると書いています。検索(AIの機能を含む)でページから見せる情報を絞るには、nosnippet、data-nosnippet、max-snippet、noindexを案内しています。AIによる概要とAIモードにサイトを含めるかだけなら、Search Consoleの「検索の生成 AI 設定」(2026年8月31日にすべてのサイトに公開)で選べます。ヘルプは、この設定を検索のほかの部分の順位や掲載の判断には使わないと書いています。Googleのほかのシステムでの学習とグラウンディング(質問を受けた時に、Google検索の索引の内容をモデルに渡すこと)を制限するには、Google-Extendedを案内しています。Google-Extendedはほかのシステム向けの仕組みで、Googleのクローラーの一覧の文書は、Google検索に載るかどうかには影響しないと書いています。専用のUser-Agentは無く、robots.txtで指定する名前として使います。
AIによる概要とAIモードに出たページの流入は、Search Consoleの検索パフォーマンスのレポートで、検索の種類「ウェブ」の数字に含まれます。検索の生成AI機能(AIによる概要とAIモード)での表示回数だけを見る「生成 AI パフォーマンス レポート」も、2026年8月31日にすべてのサイトに公開されました(見方はサーチコンソールでAI Overviewを計測する方法)。移行の前後は、これらの数字も後で書くクロールの統計情報と並べて見ておきます。
Googleが示した3つの手当て
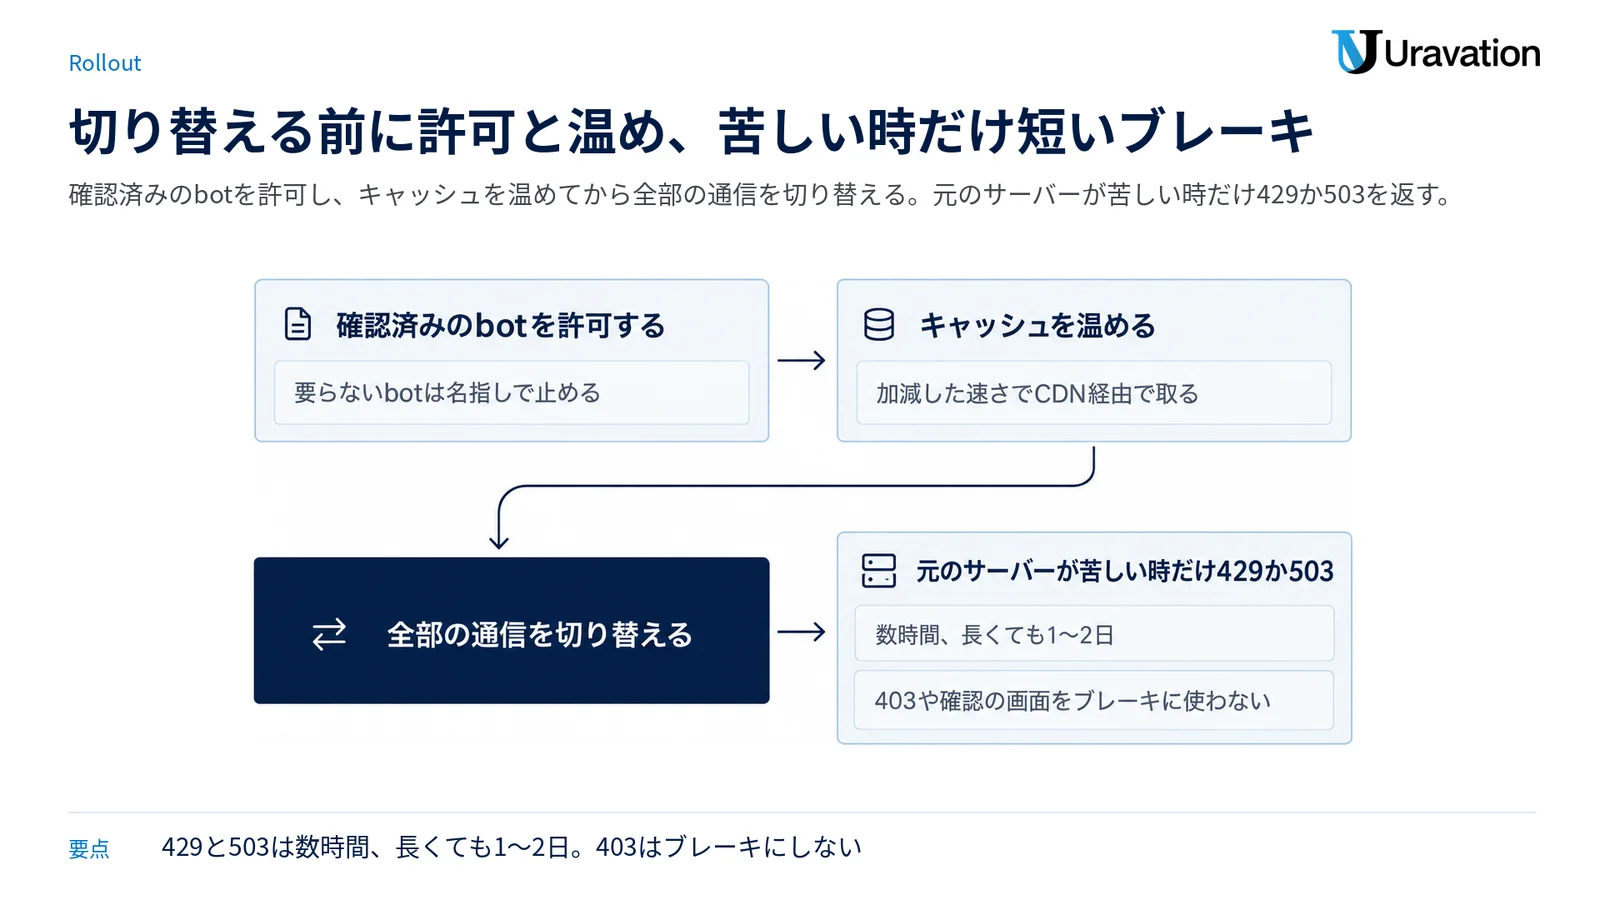
ブログは、CDNを入れるのに要るのは正しい見込みと段取りだとして、3つの手当てを挙げています。当メディアで時間の順に並べ直すと、bot対策を入れるなら切り替える前に確認済みのbotを許可しておき、キャッシュを温めてから全部の通信を切り替え、切り替えた後も元のサーバーが苦しい時だけ429か503を返す、となります。
| No. | 手当て | やること | 守る線 |
|---|---|---|---|
| 1 | 確認済みのbotを許可する | botを止めるなら、CDNとWAFの設定で確認済みのbotを許可する。要らないbotは名指しで止める | すべての自動の通信を止めるルールにしない |
| 2 | キャッシュを温める | 全部の通信を切り替える前に、アクセスの多いページ、山が来るページ、よくクロールされるURLを、加減した速さでCDN経由で取る | 温めるための取得で元のサーバーを苦しめない |
| 3 | 429か503で一時的にブレーキ | それでも元のサーバーが苦しい時は、サーバーかCDNのレート制限のルールで429か503を返す | 数時間、長くても1〜2日。403や確認の画面をブレーキに使わない |
1. botを止めるなら確認済みのbotを許可し、要らないbotは名指しで止める
ブログによると、大手のCDNとWAFの多くは、既知の、または確認済みのbotを許可する切り替えやマネージドルールを持っていて、残したいクローラーをCAPTCHAの確認から外しながら、要らない通信は止められます。さらに良いのは、すべての自動の取得を止めるのではなく、robots.txtやルールで要らないbotを名指しで止めることだ、とブログは書いています。
許可の一覧を自分で作る時は、User-Agentの文字だけで判断しないでください。User-Agentは名乗りなので、Googleを名乗るほかの取得も混ざります。Googleの「Googleのクローラーとフェッチャーからのリクエストを確認する」の文書は、Googleを名乗るなりすましを心配する時のために、2つの確かめ方を案内しています。
1つ目は、コマンドで1件ずつ確かめる方法です。ログにあるIPアドレスを逆引きし、ドメイン名がgooglebot.com、google.com、googleusercontent.comのどれかであることを確かめ、そのドメイン名を正引きして、元のIPアドレスに戻ることを確かめます。次の2行は文書の例のとおりです。
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com
1行目の答えがcrawl-66-249-66-1.googlebot.comを指し、2行目の答えが66.249.66.1に戻れば、Googleのクローラーです。文書の表では、Googlebotなど共通のクローラーの逆引きの名前は、crawl-かgeo-crawl-で始まるgooglebot.comです。googleusercontent.comは、利用者の操作で動きrobots.txtに従わない取得(Google Cloudで動くサイトの機能が使う物を含む)の名前です。
2つ目は、Googleが公開しているIPの範囲のJSONと照合する方法で、件数が多い時に向きます。Googlebotなどの共通のクローラーはcommon-crawlers.json、AdsBotなどの特別なクローラーはspecial-crawlers.jsonと、種類ごとにファイルが分かれています。次のPython(標準のライブラリだけ)は、IPアドレスが共通のクローラーの範囲に入っているかを返します。
import ipaddress
import json
import urllib.request

URL = "https://developers.google.com/static/crawling/ipranges/common-crawlers.json"
data = json.load(urllib.request.urlopen(URL))
nets = [ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix")) for p in data["prefixes"]]

def is_google_common_crawler(ip):
    addr = ipaddress.ip_address(ip)
    return any(addr in net for net in nets if net.version == addr.version)

print(data["creationTime"])
print(is_google_common_crawler("66.249.66.1"))当メディアで2026年11月12日に動かすと、2行目はTrueを返し、JSONの作成日時(creationTime)は2026年11月11日でした。中身は変わる前提で、許可の一覧は手で写して固めず、取り直す仕組みにしておくと安全です。ログの集め方とgrepでの数え方は、AIクローラーのログ確認の手順に書いています。
2. 全部の通信を切り替える前に、キャッシュを温める
新しいCDNに全部の通信を流す前に、アクセスの多いページ、キャンペーンや季節の公開などこれから山が来るページ、よくクロールされるURLを、加減した速さでCDN経由でプログラムから取得し、端のキャッシュを用意しておく。これがブログの2つ目の手当てです。
どのURLを温めるかは、アクセスの多いページならアクセス解析の上位、山が来るページなら公開の予定、よくクロールされるURLなら元のサーバーのログから選べます。ログで数える時は、上の方法でGoogleのクローラーと確かめた取得だけを数えます。
気をつけたい点は3つです。1つは、温めるための取得そのもので元のサーバーを苦しめないことで、ブログも「加減した速さで」と書いています。2つ目は、ブログがキャッシュミスを端のサーバーの拠点ごとの話として書いていることです。どの拠点のキャッシュが温まるかはCDNの作りによるので、使うCDNの文書で確かめてください。3つ目は、温めたいページがキャッシュの対象になっているかです。Cloudflareの文書は、同社のCDNは既定でHTMLとJSONをキャッシュしないと書いています。
3. それでも元のサーバーが苦しい時は、429か503を短い間だけ返す
キャッシュが温まる間にクロールの量が元のサーバーに重い負荷をかけ続ける時は、サーバーかCDNのレート制限のルールで、429(Too Many Requests)か503(Service Unavailable)を短い間だけ返します。ブログが示す長さは、数時間、長くても1〜2日です。
Googleの「Googleのクロール頻度を下げる」の文書(2026年10月6日にRetry-Afterの説明を追記)によると、500・503・429を多く受け取ると、Googleはエラーを返したURLだけでなく、内容を返したURLも含めて、ホスト名全体でクロールの頻度を下げ、エラーが減れば自動で頻度を戻します。503か429にはRetry-Afterのヘッダーを付け、再び取りに来てよい時を秒数かUTCの日時で示せます。次は文書の例です。
HTTP/1.1 503 Service Unavailable
Retry-After: 120
同じ文書は、1〜2日より長く続けることを勧めていません。Googlebotが同じURLで数日にわたってこれらのステータスコードを受け取ると、そのURLがインデックスから外れることがあるからです。頻度を下げている間は、新しいページが見つかりにくくなり、価格や在庫などの更新の反映が遅れ、削除したページがインデックスに長く残ることがあり、Google広告ではキャンペーンが取り消しや一時停止になって広告が配信されないことがある、とも書いています。
403や確認の画面をブレーキに使わないでください。Googleのステータスコードの文書は、401と403をクロールの頻度を抑える目的で使わないよう書いていて、429以外の4xxはクロールの頻度に効きません。エラーを返せない作りなら、「Googleのクロール頻度を下げる」の文書にある特別な依頼の窓口から、高すぎるクロールの頻度を報告できます。審査と対応には数日かかることがあり、頻度を上げる依頼はできません。
CloudflareとAWS WAFの文書にある、確認済みのbotの扱い
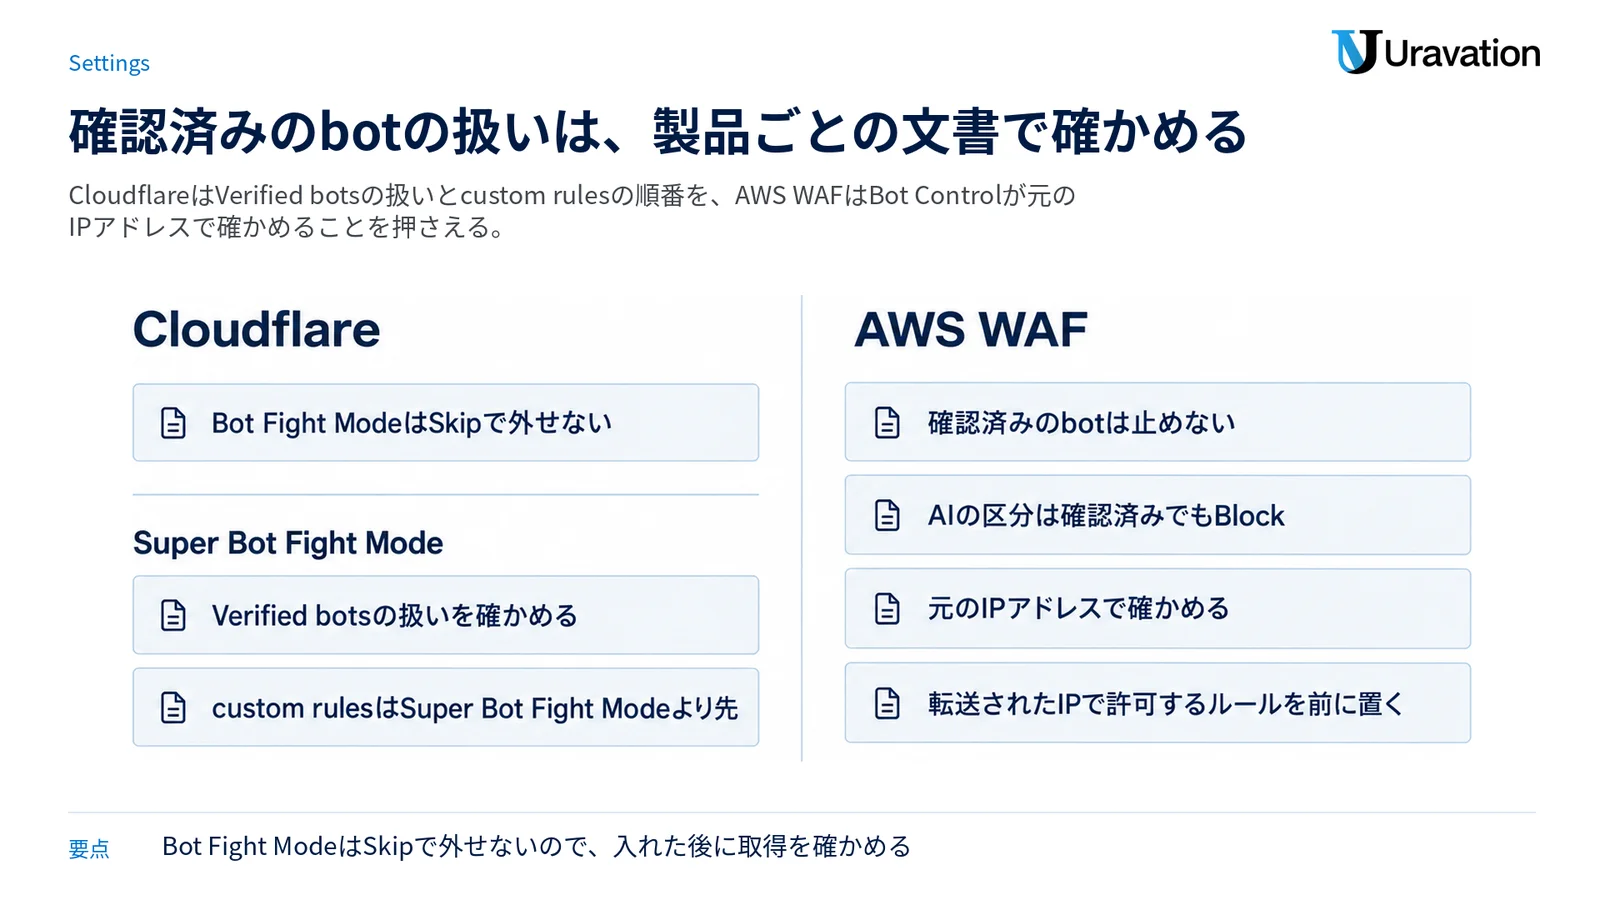
確認済みのbotを許可する設定の名前と場所は、CDNとWAFごとに違います。ここでは、CloudflareとAWS WAFの公式の文書に書かれている範囲だけを並べます(2026年11月12日に確認)。画面の操作は各社の文書で確かめてください。
| 製品・機能 | 文書の書き方 | 気をつけること |
|---|---|---|
| Cloudflareの「Verified bots」 | 自分が誰で何をするかを正直に示すとCloudflareが確かめたbotとエージェント。旧来の区分「Search Engine Crawler」の例にGooglebotを挙げ、確認済みのbotはこれまで、すべてのプランの既定のbotの設定で対象から外されてきたと書く | 名乗り方として、Web Bot Authの署名、公開のIPの一覧と固定のUser-Agent、逆引きのDNSを挙げている |
| Cloudflareの「Bot Fight Mode」 | 既知のbotの型に合う通信を見つけ、計算の重い確認を出す | Bot Fight ModeはSkipで外せない。WAFのcustom rulesやPage Rulesで例外を作れず、例外が要るならSuper Bot Fight Modeを使うよう文書は案内している。IP Access rulesが先に当たった取得には、Bot Fight Modeは動かないとも書く。確認を出した取得は、「Security」の「Analytics」の「Events」のタブで、「Service」の欄に「Bot Fight Mode」と出る |
| Cloudflareの「Super Bot Fight Mode」(Pro・Business、Bot Managementを付けていないEnterpriseの契約に含まれる) | botの区分ごとに扱いを決められる。区分は「Definitely automated traffic」「Likely automated traffic」「Verified bots」。ただし「Likely automated traffic」の扱いはProでは選べない | Verified botsの扱いを確かめる。custom rulesが先に動く作りで、Skipで外す範囲を決められる |
| AWS WAFの「Bot Control」 | よく許可される、確かめられるbotにラベルを付け、確認済みのbotは止めない。検索エンジンの区分のルール(CategorySearchEngine)も、確かめられないbotだけBlockにする。ただし、AIの区分は確認済みでもBlockにする(CategoryAIのルールは、確認済みかどうかに関係なく当たる) | 確認済みかどうかは、リクエストの元のIPアドレスで確かめる。プロキシやロードバランサーを通る時は、転送されたIPで許可するルールを前に置くよう文書は案内している |
表の「既定のbotの設定で対象から外されてきた」はCloudflareの確認済みのbotの文書の言葉で、Bot Fight Modeの文書では、Googlebotの扱いについての個別の記述を確かめられませんでした。Bot Fight Modeを入れた後は、Googleのクローラーの取得が止まっていないかを、次の節の方法で確かめてください。
自社で足したルールにも気をつけます。Cloudflareの文書によると、custom rulesはSuper Bot Fight Modeより先に動きます。custom rulesに確認の画面を出すルールがあれば、Verified botsの扱いとは別に、そのルールからGoogleのクローラーが外れているかを確かめてください。
移す前・移した日・移した後に確かめること
公式の文書で確かめられた範囲で、CDNに移す時の確認を時期ごとに並べます。
| No. | 時期 | 確かめること | 根拠 |
|---|---|---|---|
| 1 | 移す前 | CDNとWAFのbotの設定で、確認済みのbotが許可されているか。自社で足したルールで、Googleのクローラーが確認の画面に回されないか | Googleのブログ、各社の文書 |
| 2 | 移す前 | 要らないbotは、robots.txtか名指しのルールで止める作りになっているか | Googleのブログ |
| 3 | 移す前 | アクセスの多いページ、山が来るページ、よくクロールされるURLを、加減した速さでCDN経由で取ったか | Googleのブログ |
| 4 | 移す前 | 元のサーバーが苦しい時に429か503を返す手順と、やめる時刻を決めたか(数時間、長くても1〜2日) | Googleのブログ、クロール頻度を下げる文書 |
| 5 | 移した日 | Googlebotを名乗る取得のIPを、逆引きと正引きのDNSか、公開のIPの範囲で確かめたか。Cloudflareを通すと元のサーバーのログには既定でCloudflareのIPが残るので、元の訪問者のIP(CF-Connecting-IPのヘッダー)を記録する設定にしてから見る | Googleのリクエストの確認の文書、Cloudflareの文書 |
| 6 | 移した日 | Search ConsoleのURL検査ツールで描画された画像に、自社のページが写っているか。空のページ、エラー、botの確認の画面なら、CDNの設定を見直す | 2024年12月のGoogleのブログ |
| 7 | 移した後 | クロールの統計情報で、ホストのステータス、クロールのレスポンスの内訳、平均レスポンス時間に変化がないか | Search Consoleのヘルプ |
| 8 | 移した後 | 429か503を返していたら、1〜2日を超える前にやめたか | Googleのブログ、クロール頻度を下げる文書 |
| 9 | 移した後 | Googleのクローラーへの応答に、403、確認の画面、200で返すエラーの文、接続のタイムアウトが混ざっていないか | ステータスコードの文書、2024年12月のGoogleのブログ |
6のURL検査ツールは、Googleが2024年12月のブログで、CDNによる止めすぎを確かめる一番簡単な方法として挙げた物です。7のクロールの統計情報はSearch Consoleのプロパティの設定から開くレポートで、ドメインのプロパティか、ルートの階層のURLプレフィックスのプロパティでだけ使えます。ヘルプは、ページ数が1,000未満のサイトは使う必要がないとも書いています。その規模のサイトでは、URL検査ツールとサーバーのログでの確認が中心になります。
GPTBotなどAIのクローラーは、Googleの助言と分けて決める
今回のブログが扱うのはGoogleのクローラーです。GPTBot、OAI-SearchBot、ClaudeBot、PerplexityBotなど、ほかの会社のクローラーが429や503をどう扱うか、CDNの確認済みのbotにどう入っているかは、その会社かCDNの文書で確かめる事柄で、Googleの助言をそのまま当てはめることはできません。
CDNの側の区分も変わります。Cloudflareの確認済みのbotの文書は、旧来の区分「AI Search」の例にOAI-SearchBotを挙げたうえで、2026年7月1日に入れた新しい分類ではAIの検索と従来の検索を分けず、どちらも「Search」の振る舞いとして扱うと書いています。旧来の区分の値は今あるルールのために残してあり、新しい検索のクローラーは「Search」に分けられます。区分の名前でルールを書いている場合は、今の分類の説明と照らし合わせてください。
AIのクローラーを許可するか止めるかの判断はrobots.txtでAIクローラーを許可すべきかの判断基準に、CloudflareのAIクローラーのブロックがAIの回答での引用に与える影響はCloudflareのAIクローラーブロックの影響にまとめています。AIのクローラーの設定を変える時も、Googlebotが同じ設定に巻き込まれていないかを、この記事の確かめ方で見ておくと安全です。Cloudflareの「AI Crawler and Agent access policies」は確認済みのbotにも効き、「Training」の扱いは検索と学習を兼ねるクローラーにも及ぶ、と同社の文書は書いています。
よくある質問
CDNを入れると、Googleの検索順位は上がりますか?
今回のブログからは言えません。ブログが書いているのは、CDNに移した時のクロールの頻度と元のサーバーの負荷の話で、順位には触れていません。クロール バジェットの文書は、クロールされたページがすべてインデックスに登録されるわけではないとも書いています。
移行の後にGooglebotのクロールが急に増えました。攻撃でしょうか?
まずIPアドレスを確かめます。CDNの後ろでは元のサーバーのログに残るIPがCDNのIPになることがあり(Cloudflareは既定でそうなります)、その時は元の訪問者のIPを記録する設定にしてから見ます。逆引きと正引きのDNSか、公開のIPの範囲でGoogleのクローラーと確かめられれば、ブログが書く「速い応答でクロールが増え、キャッシュに無いURLの取得が元のサーバーに届く」状態かもしれません。その場合は一律に止めず、キャッシュを温め、元のサーバーが苦しい時だけ429か503を短い間返します。Googlebotを名乗っていても確かめられない取得は、Googleのクローラーとは別に扱えます。
Googlebotを一時的に止めたい時は、403を返せばよいですか?
いいえ。Googleは、401と403をクロールの頻度を抑える目的で使わないよう書いていて、429以外の4xxはクロールの頻度に効きません。403など429以外の4xxを返したURLは、登録済みでもインデックスから外れます。一時的に抑えるなら、429か503を数時間、長くても1〜2日だけ返します。
User-AgentにGooglebotと書かれた取得は、許可してよいですか?
User-Agentだけで決めないでください。User-Agentは名乗りにすぎないので、確かめるには逆引きと正引きのDNSの照合か、公開のIPの範囲との照合を使います。CloudflareとAWS WAFの文書も、確認済みのbotを公開のIPの一覧や逆引きのDNS、リクエストの元のIPアドレスで見分けると書いているので、自分のPCからUser-AgentだけをGooglebotにして試しても、本物と同じ扱いになるとは限りません。
小さな会社のサイトでも、クロール バジェットを気にする必要はありますか?
クロール バジェットの文書は、主な対象を、100万ページ以上で週に1回ほど内容が変わるサイトや、1万ページ以上で毎日内容が変わるサイトなどとし、公開した日にクロールされているなら読まなくてよいと書いています。その場合は、サイトマップを最新に保ち、ページのインデックス登録のレポートを定期的に見れば足りる、という書き方です。サイトマップのlastmodの扱いはサイトマップのpriority・lastmodの設計にまとめています。ただし、ブログが書く一律のbot対策の落とし穴は、サイトの大きさを条件にしていません。
最後に確認すべきこと
- CDNに切り替えた後は、応答が速くなるとGoogleのクロール能力の上限が少しずつ上がってクロールが増えることがあり、キャッシュに無いURLの取得は元のサーバーに届く(Googleの公式ブログ・2026年11月11日)
- 一律のbot対策を入れる前に、確認済みのbotの扱いを確かめる。Googleのクローラーが確認の画面で止まり続けると、ページが検索から落ち始める
- Googleのクローラーかどうかは、User-Agentではなく、逆引きと正引きのDNSか、公開のIPの範囲で確かめる
- 切り替える前に、アクセスの多いページ、山が来るページ、よくクロールされるURLのキャッシュを温める
- 元のサーバーが苦しい時は、429か503を数時間、長くても1〜2日。403や確認の画面をブレーキに使わない
- AIによる概要とAIモードのサポートリンクも、インデックスに登録されていることが前提
自社のサイトがAIの検索でどう扱われているかを、クローラーの設定とあわせて点検したい場合は、LLMO診断やAI検索診断という入口もあります。診断は表示を約束する物ではなく、今の状態と直せる所を整理するための物です。
参考・出典
- Moving to a CDN without overwhelming your origin (or blocking Googlebot)(Google Search Central Blog・2026年11月11日) — CDNに移した直後にクロールが増える理由、キャッシュミス、一律のbot対策の落とし穴、3つの手当て。2026年11月12日参照
- Crawl Budget Management(Google Crawling Infrastructure) — クロール能力の上限(ホスト負荷)とクロールの必要性の定義、ホスト名ごとの数え方、ガイドの対象のサイト、クロールとインデックス登録の関係。2026年11月12日参照
- Reduce the Google crawl rate(Google Crawling Infrastructure) — 500・503・429の使い方と期間、Retry-After、長く続けた時の影響、頻度を下げた時の検索とGoogle広告への影響、特別な依頼と日数。2026年11月12日参照
- Verify requests from Google crawlers and fetchers(Google Crawling Infrastructure) — 逆引きと正引きのDNSによる確かめ方、種類ごとの逆引きの名前の形、IPの範囲のJSON。2026年11月12日参照
- How HTTP status codes affect Google's crawlers(Google Crawling Infrastructure) — 4xx・429・5xxの扱い、401と403でクロールの頻度を抑えないこと。2026年11月12日参照
- AI features and your website(Google Search Central) — サポートリンクとして表示される条件、CDNでのクロールの許可、Googlebotへのrobots.txtの指示、nosnippetなどの指定、Google-Extendedの案内、Search Consoleでの数え方。2026年11月12日参照
- Google's common crawlers(Google Crawling Infrastructure) — Google-Extendedの用途とグラウンディングの説明、専用のUser-Agentが無いこと、Google検索に載るかどうかに影響しないこと。2026年11月12日参照
- Crawling December: CDNs and crawling(Google Search Central Blog・2024年12月24日) — CDNとクロールの頻度、ハードブロックとソフトブロック、URL検査ツールでの確かめ方。2026年11月12日参照
- クロールの統計情報レポート(Search Console ヘルプ) — レポートの開き方と項目、使えるプロパティ、1,000ページ未満のサイトの扱い。2026年11月12日参照
- Changelog(Google Crawling Infrastructure) — 2026年10月6日のRetry-Afterの追記。2026年11月12日参照
- common-crawlers.json(Google・共通のクローラーのIPの範囲) — 作成日時(creationTime)と範囲の形。2026年11月12日参照
- Verified bots(Cloudflare Docs) — 確認済みのbotの定義と名乗り方、旧来の区分、既定の設定での扱い、2026年7月1日の分類。2026年11月12日参照
- Bot Fight Mode(Cloudflare Docs) — 働き、custom rulesとPage Rulesで外せないこと、IP Access rulesとの関係、表示のされ方。2026年11月12日参照
- Super Bot Fight Mode(Cloudflare Docs) — 対象の契約、botの区分、custom rulesとSkipによる例外。2026年11月12日参照
- AWS WAF Bot Control rule group(AWS WAF Developer Guide) — 確認済みのbotのラベル、止めないこと、CategorySearchEngine、CategoryAI、元のIPアドレスでの確かめ方。2026年11月12日参照
- Pro(Cloudflare Docs・botの機能のプラン) — Proの契約のSuper Bot Fight Modeで「Likely automated traffic」を扱えないこと。2026年11月12日参照
- Default cache behavior(Cloudflare Docs) — CloudflareのCDNが既定でHTMLとJSONをキャッシュしないこと。2026年11月12日参照
- Restoring original visitor IPs(Cloudflare Docs) — 元のサーバーのログに既定でCloudflareのIPが残ること、元の訪問者のIPが入るCF-Connecting-IP。2026年11月12日参照
- AI Crawler and Agent access policies(Cloudflare Docs) — 確認済みのbotにも効くこと、Trainingの扱いが検索と学習を兼ねるクローラーにも及ぶこと。2026年11月12日参照
- 生成 AI パフォーマンス レポート(検索)(Search Console ヘルプ) — AIによる概要とAIモードでの表示回数、2026年8月31日にすべてのサイトに公開されたこと。2026年11月12日参照
- 検索の生成 AI 設定(Search Console ヘルプ) — AIによる概要とAIモードにサイトを含めるかを選ぶ設定、2026年8月31日にすべてのサイトに公開されたこと、検索のほかの部分の順位や掲載の判断に使わないこと。2026年11月12日参照
※ いずれも2026年11月12日に確認した一次情報です。CDNとWAFの画面や区分は変わることがあるので、最新の内容は各公式ページで確かめてください。当社は今回の記事のためにCDNの切り替えを試しておらず、手順と設定の名前は各社の文書の記述です。
公式情報で確認するポイント
AI検索まわりは仕様変更が多いため、記事公開前後に公式情報を確認し、本文の言い切りや実装方針を更新します。
- Google Search Central「Optimizing your website for generative AI features」 生成AI検索に対して、通常のSEO・技術要件・独自性の扱いを確認する公式ガイド。
- Google Search Central「Creating helpful, reliable, people-first content」 人間に役立つ信頼性の高いコンテンツを評価するための公式観点。
本体メディアであわせて確認する記事
この記事のテーマを、Uravation本体メディアで検索流入のあるAIツール・モデル解説にもつなげて確認できます。
AI活用書籍シリーズ累計66,000部の著者チームが監修。自社7メディアの実運用でAI検索からの引用・流入を継続計測しており、その一次データと公式情報に基づいて、企業サイトで実務的に使える形へ整理しています。仕様変更が多い領域のため、公開前後に公式情報と本文の整合性を確認します。
AI検索診断・情報源設計支援に進める
この記事のテーマを自社サイトに当てはめ、公開情報、根拠ページ、FAQ、内部リンク、構造化データ、llms.txtのどこを確認すべきかを整理します。
AI検索攻略の前後の記事
同じ連載の前後の記事へ進み、LLMO、AIO、GEO、AI検索の論点を順番に確認できます。
関連するUravationの導線
AI検索攻略は、Uravation本体のAI活用メディアとサービス導線につながる専門テーマとして運用します。