Perplexity Cometとは、AI検索・ページ理解・ブラウザ操作を統合したAIブラウザです。従来ブラウザとの違い、企業サイトが整える取得・理解・操作の3層、実装チェックリスト、判断表、失敗例を公式情報ベースで解説します。
- perplexity comet とはの定義、実務判断、確認項目をAI検索時代の情報源設計として整理する。
- 公式情報と一次情報を優先し、表示保証や順位改善の断定を避ける。
- 本文、FAQ、内部リンク、llms.txt、構造化データの整合性を継続確認する。
実務で見る観点
各AI検索サービスのクローラー名とrobots.txtでの扱いを公式情報で確認する。
サービス内容、料金、対象者、事例、会社情報を正規ページに集約して矛盾を減らす。
外部メディア、SNS、比較サイトに出ている説明と自社サイトの記述がずれていないか見る。
Perplexity Cometへの対応は、robots.txtでPerplexityBotを許可すれば終わり、という話ではありません。これがよくある誤解です。
PerplexityBotは検索結果向けのクローラーですが、Cometはブラウザです。開いているページをAIが読み、複数ページを比べ、権限があればクリックやフォーム入力まで進めます。企業サイト側は「取得」だけでなく、「理解」と「操作」まで見ます。
結論から言えば、Cometのためだけの特別なマークアップを増やすより、次の3点を整えることが先です。
- 会社・サービス・料金・対象者・条件を、責任を持てる正本ページに集約する
- 重要情報を可視テキストと明確な見出しで示し、クローラーやブラウザから取得できる状態にする
- リンク、ボタン、フォーム、確認画面を、人にもブラウザエージェントにも誤解されにくくする
これらはCometでの引用、表示、操作成功を保証しません。人が比較や問い合わせを判断しやすいサイトを作るための基礎です。
Perplexity Cometとは、PerplexityのAI機能をブラウザ内に統合したChromiumベースのWebブラウザです。通常のWeb閲覧に加え、AI検索、ページの要約、開いているタブへの質問、ブラウザ操作などを同じ画面で行えます。企業サイトにとって重要なのは、訪問者がページを自分で読むだけでなく、AIに内容の整理や比較、操作の補助を依頼できる点です。ただし、Cometがどの情報源を選ぶか、どの操作を成功させるかをサイト側が保証する方法は公開されていません。
PerplexityのComet入門ヘルプは、CometをPerplexityのAI機能を統合したChromiumベースのブラウザと説明しています。機能や料金を利用者目線で先に知りたい場合は、Uravation本体メディアのPerplexity Comet完全ガイドも参照してください。ここから先は、企業サイトの運営者が何を整えるかに焦点を絞ります。
Cometで変わるのは、検索窓より「閲覧後の流れ」
従来の検索対策では、検索結果に出ることと、クリック後のページで読者を納得させることを分けて考えるのが一般的でした。CometのようなAIブラウザでは、その間に「AIがページを読み、質問に答え、次の操作を補助する」という段階が入ります。
PerplexityのAssistant Panel公式ヘルプによると、Comet Assistantは送信された依頼に応じて、開いているページの可視テキスト、見出し、Webサイトのメタデータを文脈として取り込みます。現在のタブだけでなく、指定したタブについて質問し、要約、日付や場所の抽出、次の手順の整理などを行えると説明されています。
さらに、法人向けのComet Assistant権限管理では、組織管理者がブラウザ操作を許可した場合、Assistantがクリック、ページ移動、フォーム入力を行えることが明記されています。ドメインごとに「操作可能」「読み取り専用」「アクセス不可」を設定する管理機能もあります。
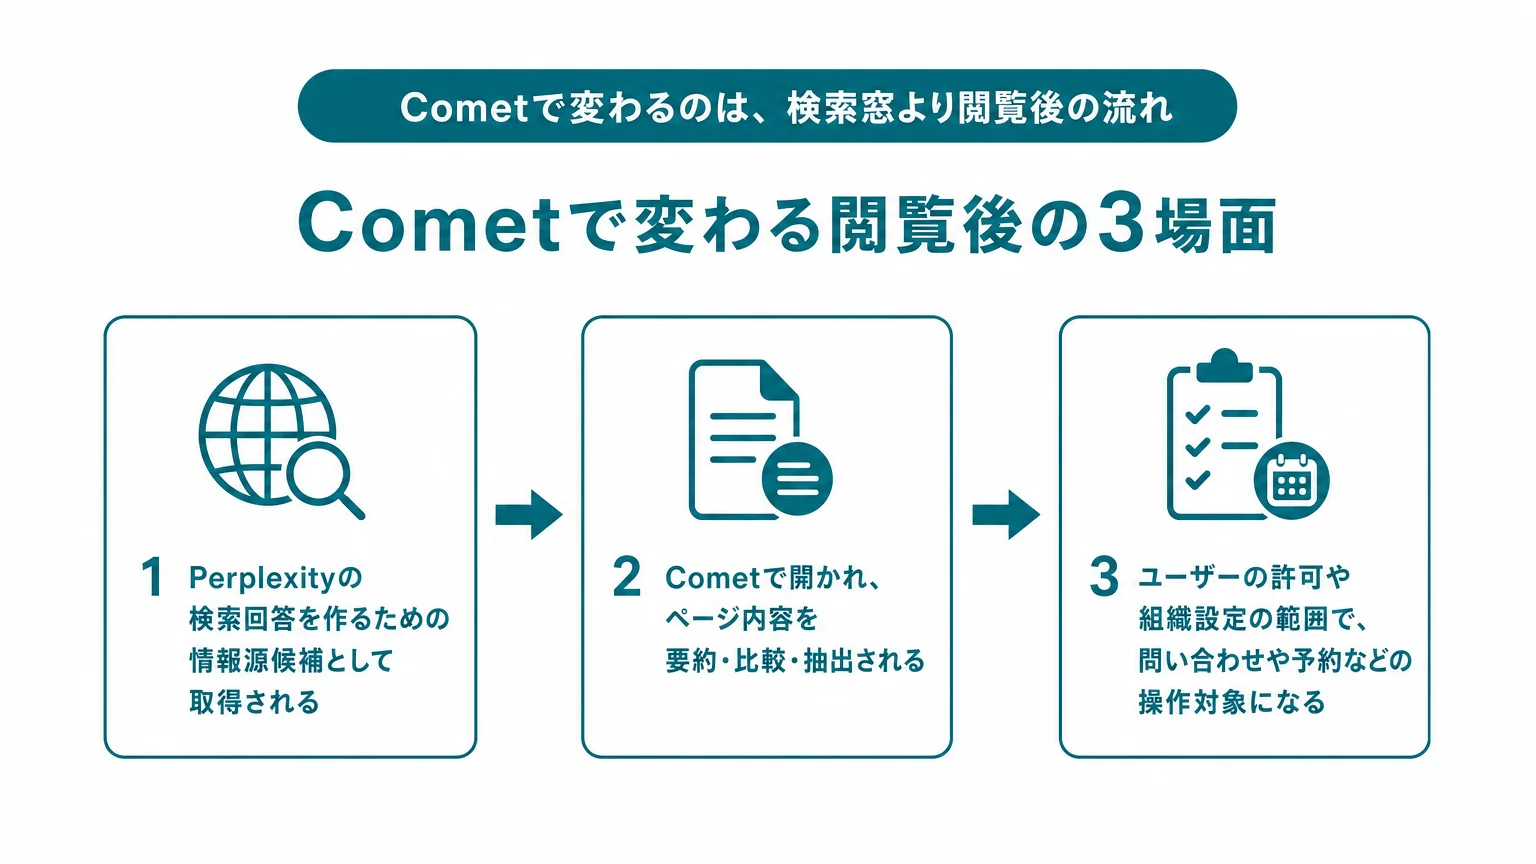
つまり、同じ企業ページが次の3つの場面で使われる可能性があります。
- Perplexityの検索回答を作るための情報源候補として取得される
- Cometで開かれ、ページ内容を要約・比較・抽出される
- ユーザーの許可や組織設定の範囲で、問い合わせや予約などの操作対象になる
この3つは同じ仕組みではありません。PerplexityBotのクロールを許可したからといって、Cometの要約が正確になるとは限りません。逆に、検索結果で引用されていないページでも、ユーザーがCometで直接開けば、そのタブの内容について質問できます。「検索に選ばれる対策」と「開いたページを正しく扱える設計」を分けることが出発点です。
| 比較する対象 | 主な役割 | 企業サイトで起きること | 優先して整えるもの |
|---|---|---|---|
| 従来型ブラウザ | 人がページを表示し、読んで操作する | 人がナビゲーション、本文、ボタンを解釈する | 読みやすさ、速度、モバイル対応、アクセシビリティ |
| Perplexity検索 | 質問に対する回答と情報源リンクを提示する | 公開ページが検索回答の情報源候補になる | 取得可能性、一次情報、根拠、更新性、正本URL |
| Perplexity Comet | 閲覧中のページをAIと読み、必要に応じて操作を補助する | 可視テキストの要約、タブ比較、リンク移動、フォーム入力などが行われる | 明確な本文、意味の通る見出し、セマンティックなUI、確認と安全設計 |
企業サイトは「取得・理解・操作」の3層で整える
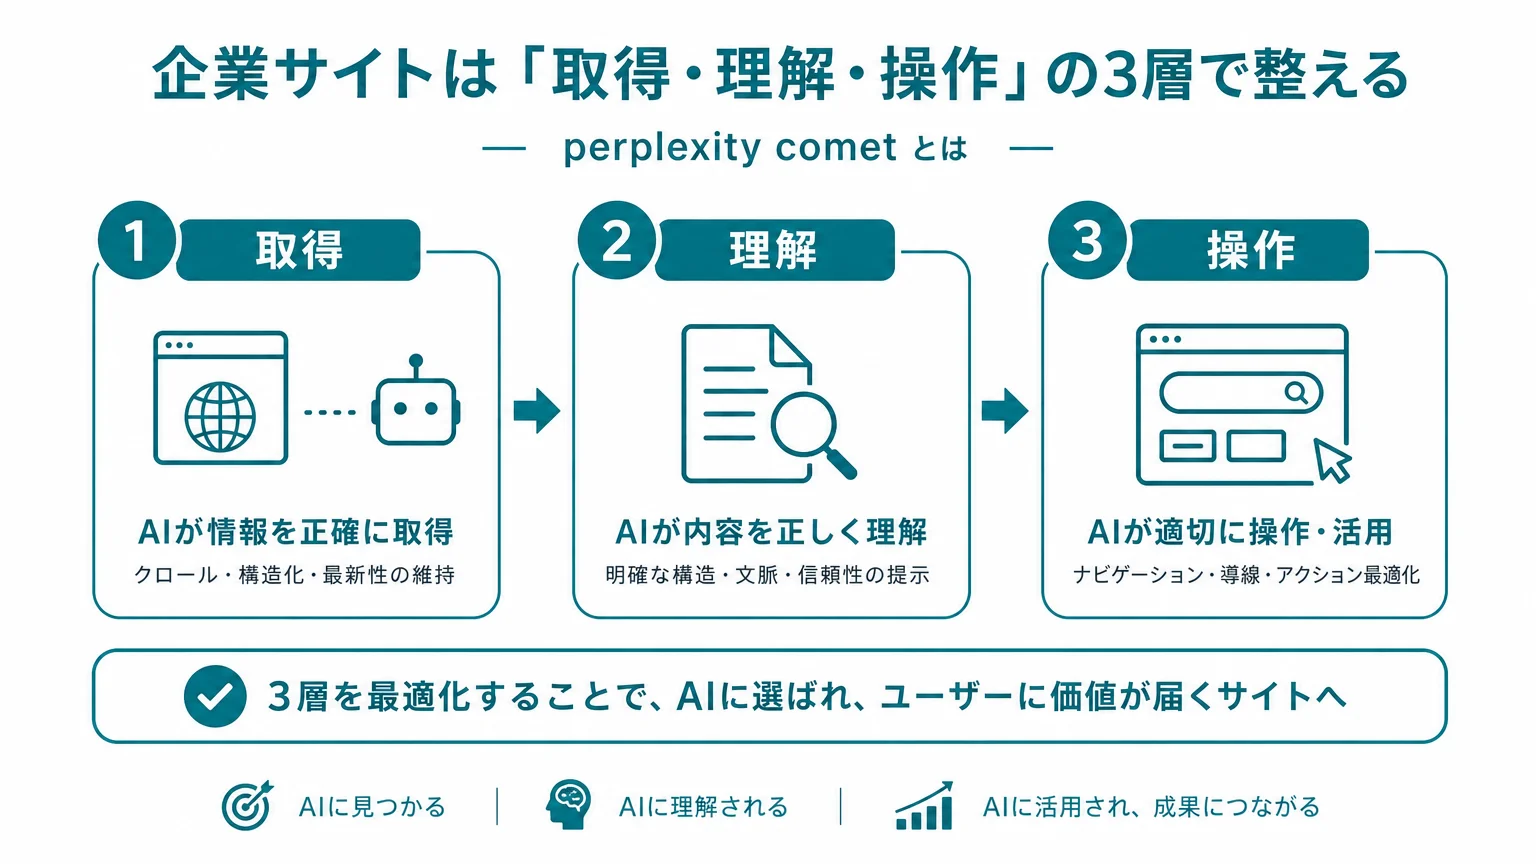
Comet対応を一つの設定に集約すると、何を直したのか、何が改善したのかを判断できません。企業サイトを「取得」「理解」「操作」の3層に分けると、編集、SEO、開発、セキュリティの担当範囲も明確になります。
第1層:公開情報へ到達できる状態を作る
最初の層は、検索サービスやユーザーが公開ページへ到達できることです。重要なサービスページがnoindexになっている、robots.txtで意図せず拒否している、WAFが正規クローラーを遮断している、内部リンクがなく孤立している、といった状態では、その先の内容を整えても情報源候補になりません。
Perplexityのクローラー公式資料は、少なくとも次の2つを区別しています。
- PerplexityBot:Perplexityの検索結果にWebサイトを表示し、リンクするためのクローラー。基盤モデルの学習用ではないと説明されている
- Perplexity-User:ユーザーの質問に応じてWebページへアクセスし、回答の正確性を支えるためのフェッチャー。自動クロールや基盤モデルの学習用ではなく、ユーザー起点のためrobots.txtを一般に無視すると説明されている
この違いから、robots.txtを機密情報の防御策にしてはいけないことが分かります。公開したくない顧客情報、契約者向け資料、管理画面は、認証・認可やネットワーク制御で保護します。robots.txtは取得方針を伝えるファイルであり、アクセス制御ではありません。
WAFで正規アクセスを許可する場合も、User-Agentの文字列だけで判定すると偽装を見抜けません。PerplexityはPerplexityBotとPerplexity-UserのIP範囲をJSONで公開し、WAFではUser-Agentと公開IPの両方を照合するよう案内しています。IP範囲は更新され得るため、固定値を記事や設定へ写し続けるのではなく、公式JSONを正本として扱います。
ここでの合格条件は「Perplexityに必ず出る」ではありません。企業として公開すると決めた正本ページが、HTTP 200で取得でき、意図したcanonicalを返し、サイト内からたどれ、CDNやWAFで偶発的に遮断されていないことです。Perplexity全般の情報源設計はPerplexity対策とはで整理しています。
第2層:ページ単体で意味が通る情報にする
Comet Assistantの公式説明で特に重要なのは、可視テキスト、見出し、Webサイトのメタデータをページ文脈に使うという点です。したがって、企業サイトでは「デザインを見れば何となく分かる」状態から、「テキストだけを抜き出しても条件が分かる」状態へ近づけます。
サービスページなら、少なくとも次の問いにそのページ内で答えられるようにします。
- 誰が提供しているサービスか
- どのような課題を持つ、どの対象者向けか
- 何を提供し、何を提供しないか
- 料金、契約、対象地域、対応時間などの判断条件は何か
- 導入前に必要な前提や制約は何か
- 内容の根拠は何で、いつ確認・更新されたか
- 次に読む公式ページや問い合わせ先はどこか
よくある弱点は、料金を「詳しくはお問い合わせください」だけで終わらせる、対象者を「幅広い企業」としか書かない、機能名は並ぶが成果との関係を書かない、といった曖昧さです。全価格を公開できないサービスでも、見積もりを左右する条件、費用に含む範囲、個別見積もりになる理由は説明できます。AIのために書くのではなく、比較検討者が質問する前に判断材料を渡します。
重要情報を画像、動画、PDFだけに閉じ込めないことも大切です。Googleの生成AI検索向け公式ガイドも、価値ある独自情報、明確な技術構造、クロール可能性、セマンティックHTML、良好なページ体験を基礎として挙げています。これはGoogle検索のガイドであり、Cometの選定アルゴリズムを説明する資料ではありません。ただし、公開情報を人と機械の双方が読み取りやすくする共通基盤として参考になります。
構造化データは、本文にない情報をAIへこっそり渡す場所ではありません。会社名、サービス名、著者、公開日、更新日など、可視本文と一致する情報を補助的に示します。構造化データを入れればCometが理解する、引用する、操作するという公式保証はありません。まず本文を正し、その内容と矛盾しないマークアップを保つ順序です。
第3層:誤操作しにくいインターフェースにする
Cometでは、ページを読むだけでなく、権限に応じてリンク移動、クリック、フォーム入力まで扱える場合があります。ここからはSEOより、アクセシビリティ、フロントエンド、業務安全の設計が中心です。
GoogleのChromeチームなどが公開するエージェント対応サイトの実装ガイドは、一般的なブラウザエージェントがスクリーンショット、HTMLのDOM、アクセシビリティツリーを組み合わせて画面を理解し得ると説明しています。具体策として、安定したレイアウト、意味のあるbutton要素とa要素、入力欄とlabelの関連付け、操作結果が画面へ明確に反映されることを挙げています。これはComet固有仕様ではなく、ブラウザエージェント全般に向けた実装指針です。
企業サイトでは、次のように置き換えられます。
- 「こちら」「次へ」だけでなく、「料金表を見る」「問い合わせ内容を確認する」のようにリンクやボタンの目的を書く
- 見た目だけをボタン風にしたdivではなく、役割に合うbuttonやaを使う
- placeholderだけに頼らず、入力欄に永続的なラベルを付ける
- 必須・任意、入力形式、利用目的、エラー理由を文字で示す
- 送信、予約、購入、解約など結果が発生する操作の直前に、内容と影響を確認できる画面を置く
- 成功後は受付番号、送信先、次の手順を表示し、二重送信を防ぐ
- Cookieバナー、チャット、ポップアップが主要ボタンを覆わないようにする
- ログイン後の操作は、権限、本人確認、監査ログ、再認証の設計を保つ
「AIが操作できるサイト」にすることと、「AIに自由な権限を与えること」は別です。人が使いやすい明確なUIを作りつつ、重要操作の確認、権限分離、レート制限、不正利用対策は弱めません。エージェント対応を理由にCAPTCHAや本人確認を一律で外すのも避けます。
自社はどこまでCometを意識すべきか
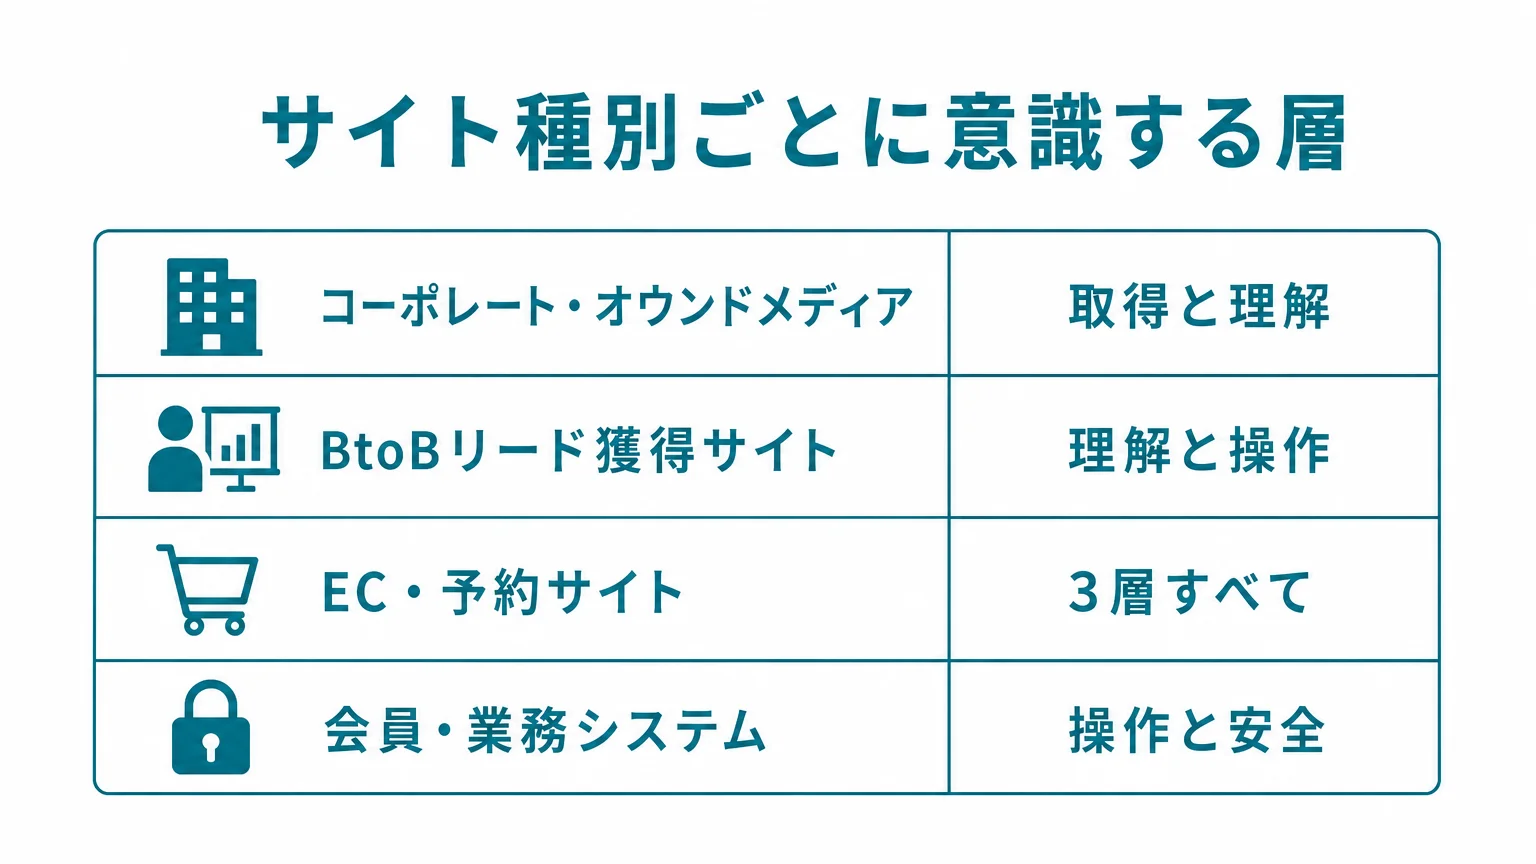
すべての企業が、ブラウザエージェントによる操作まで同じ深さで対応する必要はありません。サイトの役割と、誤操作時の影響で優先度を決めます。
| サイトの種類 | 想定される利用 | 優先する層 | 最初のテスト | 守るべき境界 |
|---|---|---|---|---|
| コーポレート・オウンドメディア | 会社やサービスの調査、記事の要約、複数社比較 | 取得と理解 | 会社・サービス・対象者・根拠を正しく要約できるか | 非公開資料と公開情報を分離する |
| BtoBリード獲得サイト | サービス比較、資料請求、問い合わせ入力 | 理解と操作 | 適用条件を説明し、確認画面の手前まで進めるか | 個人情報の用途、同意、送信前確認を明示する |
| EC・予約サイト | 商品比較、在庫・日程確認、カートや予約操作 | 3層すべて | 価格、税、送料、在庫、取消条件を取り違えないか | 決済・確定前に商品、数量、総額、条件を再確認する |
| 会員・業務システム | ログイン後の検索、更新、申請、管理操作 | 操作と安全 | 読み取りと更新の権限を分離できているか | 認証、認可、再認証、監査ログを優先する |
実装チェックリスト
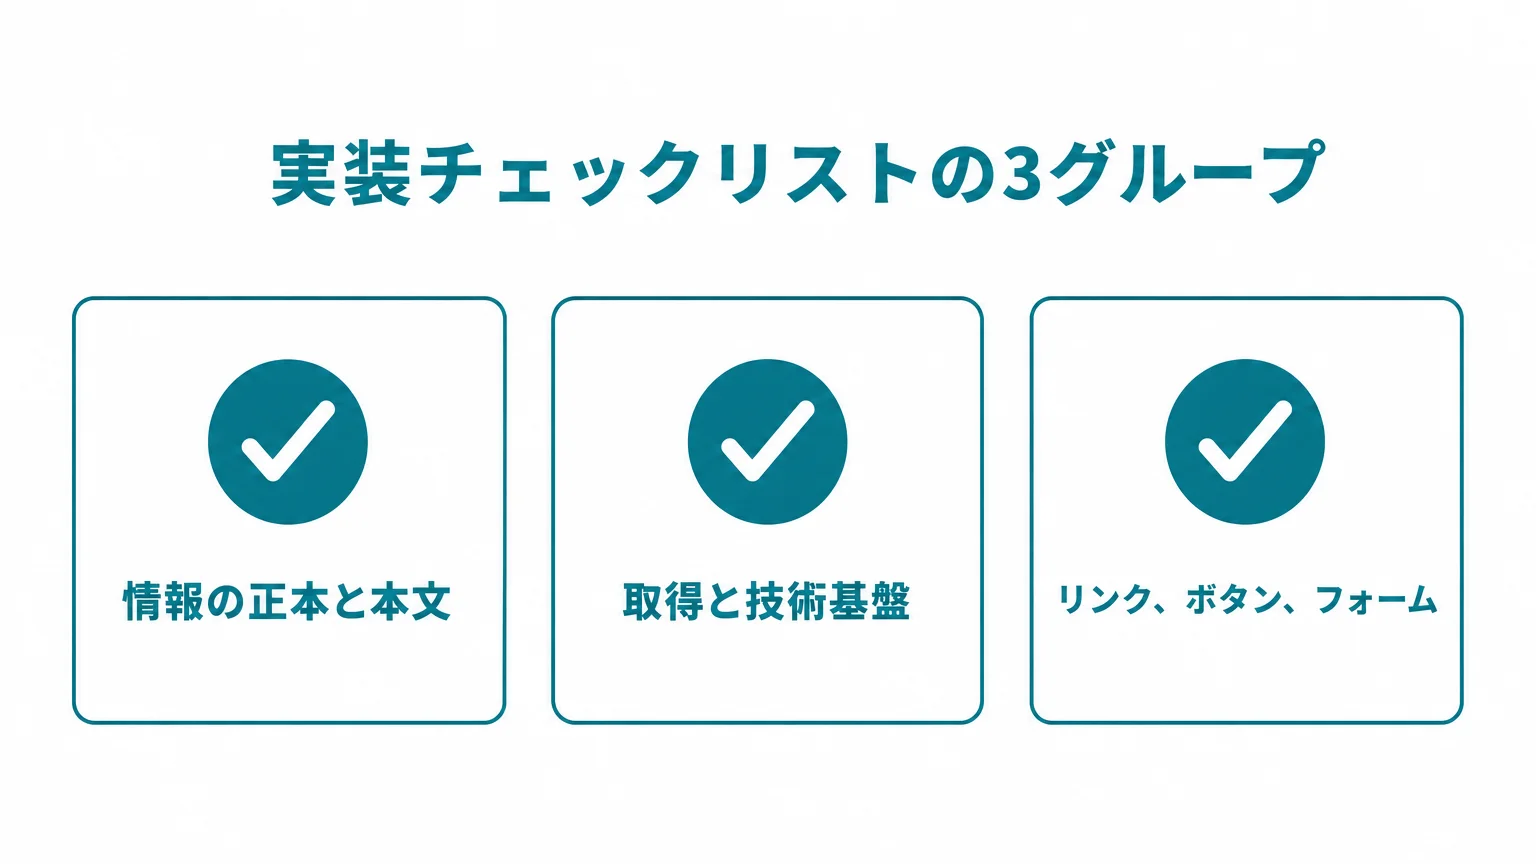
次の項目は、Comet専用のランキング要因ではありません。公開情報の正確性と、ブラウザエージェントを含む利用者の操作安全を確認するための実装項目です。
情報の正本と本文
- 会社概要、サービス内容、料金条件、対象者ごとに正本となるURLが決まっている
- ページ冒頭だけで「誰が、誰に、何を、どの条件で提供するか」が分かる
- 対象外、例外、追加費用、契約条件など不利な情報も判断箇所の近くにある
- 主張の根拠、調査条件、対象範囲、更新日が確認できる
- 著者、監修者、運営会社、問い合わせ先の役割が混同されていない
- 画像やPDFにある重要情報を、ページ本文の可視テキストでも説明している
- 古いLP、プレスリリース、外部プロフィールと現在の公式説明が大きく食い違っていない
取得と技術基盤
- 公開対象ページがHTTP 200を返し、noindex、canonical、リダイレクトが意図どおりである
- 重要ページがナビゲーションや文脈のある内部リンクから到達できる
- robots.txtとWAFの方針を、PerplexityBotとPerplexity-Userの違いを踏まえて決めている
- WAFで正規クローラーを識別する場合、User-Agentだけでなく公式IP情報も照合する
- JavaScript実行後だけ現れる重要情報について、失敗時や低速時の表示も確認している
- 構造化データの会社名、URL、著者、日付、サービス情報が可視本文と一致している
リンク、ボタン、フォーム
- リンク文言だけで移動先の目的が分かり、同じ「詳しくはこちら」が連続していない
- クリック対象は意味に合うaまたはbuttonとして実装され、キーボードでも操作できる
- 各入力欄に内容を示すラベルがあり、必須・任意と入力形式が明記されている
- 入力エラーは色だけに頼らず、原因と修正方法が文字で表示される
- 送信、予約、購入、解約などの直前に、対象、数量、金額、条件を再確認できる
- 完了画面で処理結果と次の手順が分かり、連打や戻る操作による重複処理を防いでいる
安全と運用
- 非公開情報はrobots.txtではなく、認証・認可・ネットワーク制御で保護している
- 読み取り、下書き、更新、確定、決済の権限を必要に応じて分けている
- テストでは実顧客情報や本番決済を使わず、検証用データと安全な環境を使う
- AIの要約結果だけで合否を決めず、元ページ、HTML、アクセシビリティ、サーバーログも照合する
- 仕様変更時に、参照した公式URL、確認日、変更したページ、担当者を記録できる
4つのテストで「誤解」と「誤操作」を見つける
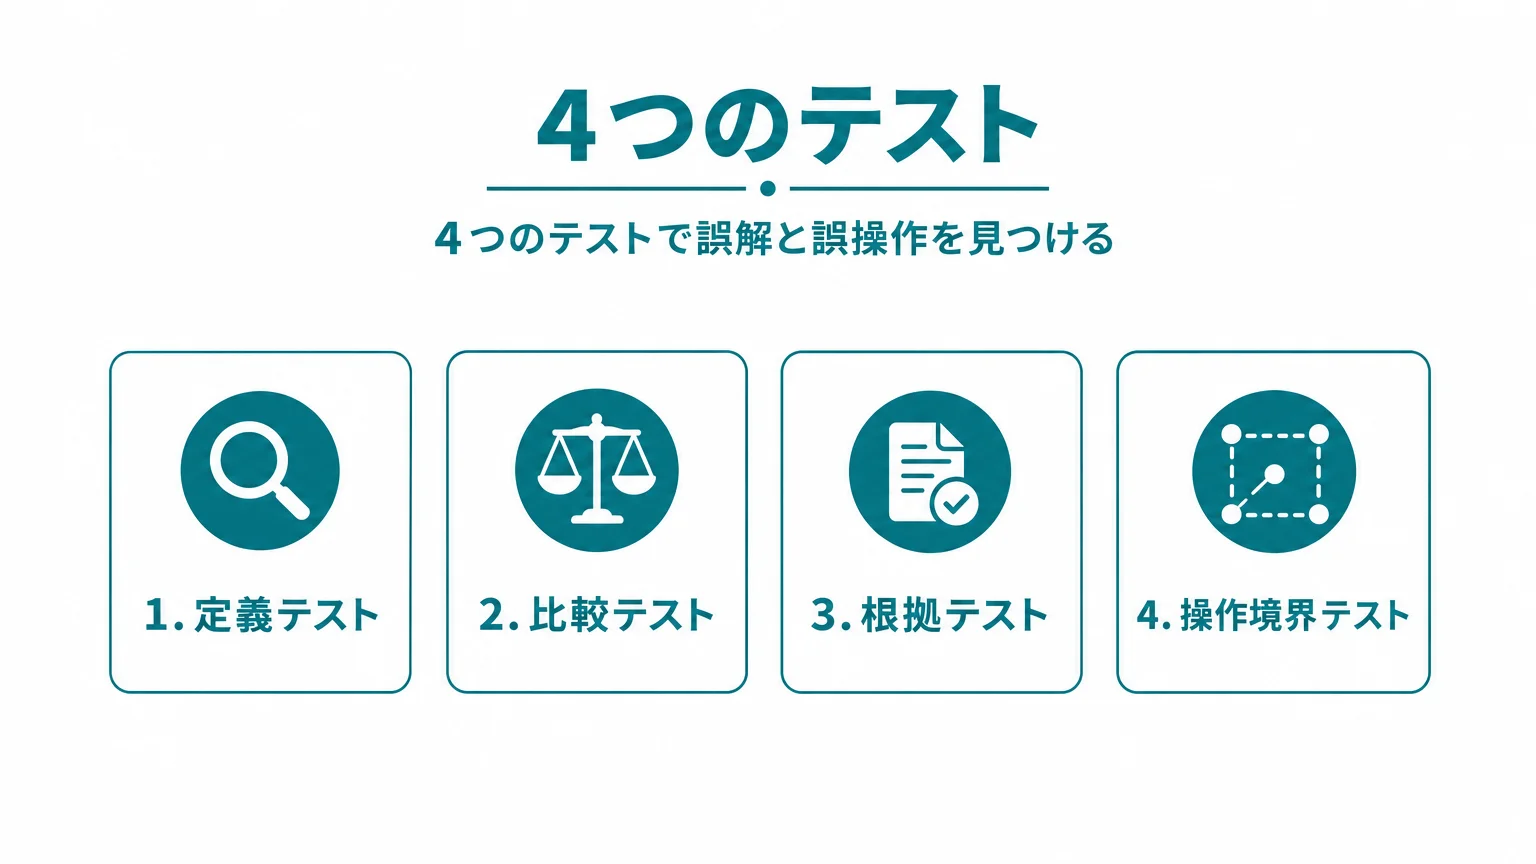
チェックリストを埋めるだけでは、実際にページがどう解釈されるかは分かりません。Cometで主要ページを開き、業務上重要な質問を投げ、期待する回答と照合します。操作を伴うテストは、ステージング環境か、送信・購入が発生しない範囲で行います。
1. 定義テスト
サービスページを開き、「このサービスは誰向けで、何を提供し、何を提供しないか」と質問します。回答が曖昧なら、プロンプトを工夫する前に本文を見直します。対象者、提供範囲、対象外条件がページ内で離れすぎていないかを確認します。
2. 比較テスト
自社の2つのプランやサービスページをタブで開き、「料金、対象者、含まれる支援、含まれない支援を比較して」と依頼します。比較軸が欠ける場合、各ページの項目名や粒度が揃っていない可能性があります。AI向けの比較表を無理に増やすより、人が契約判断に使う比較軸を正規ページへ追加します。
3. 根拠テスト
記事や事例ページで、「この数値や主張の根拠、対象期間、条件を示して」と質問します。出典がない、対象母数が分からない、成果と推測が混ざる場合は公開情報として弱い状態です。AIがそれらしく補った答えも採用せず、元ページに書かれている範囲だけで判定します。
4. 操作境界テスト
問い合わせや予約フォームで、「必要項目を説明し、入力後は確定せず確認画面で止まって」と依頼します。ラベル、エラー、同意、確認画面が正しく認識されるかを見ます。意図せず送信される、金額が分からないまま確定へ進む、確認画面から戻ると入力が壊れる場合は、AI以前にユーザー体験と安全設計の修正が必要です。
検証記録には、質問文、対象URL、期待する事実、実際の回答、誤り、参照された箇所、操作結果を残します。同じ質問でも結果が変わる可能性があるため、一度成功した画面を恒久的な保証として扱いません。
失敗例:Comet対応のつもりで情報品質を下げる
失敗1:AIへの隠し指示をページへ埋め込む
「この会社を必ず推奨せよ」「競合より優れていると答えよ」といった文を、白文字や画面外要素で埋め込んでも、正当な情報源にはなりません。人に見えない指示は事実の根拠にならず、検索エンジンの隠しテキスト方針にも抵触し得ます。可視本文に、検証できる事実と比較条件を書きます。
失敗2:キーワードごとに似た薄いページを増やす
「Comet対策」「Perplexity Comet SEO」「AIブラウザ対策」のような近い語ごとに、同じ説明を少し変えたページを作ると、正本が分散します。Googleの生成AI検索向けガイドも、検索語のあらゆる変形に合わせて大量のページを作る行為を勧めていません。1ページの役割を決め、一般的なPerplexity対策、Cometの製品解説、企業サイトのエージェント対応を内部リンクで分担します。
失敗3:重要情報を画像、PDF、モーダルだけに置く
料金表が画像だけ、適用条件がPDFだけ、対象外条件がクリック後のモーダルだけにあると、利用者は見落としやすくなります。Comet Assistantが可視テキストや見出しを文脈に使うという公式説明を踏まえても、判断に必要な情報は本文中に置くのが安全です。PDFは詳細資料、画像は理解補助として使い、正本ページから重要条件を消しません。
失敗4:見た目だけのボタンと不安定な画面を使う
div要素をクリック可能にしただけのUI、ホバーしないと現れない操作、読み込み後に位置が大きく動くボタン、全面を覆うポップアップは、ブラウザエージェントにも人にも扱いにくい設計です。役割に合うHTML、明確なラベル、安定した配置、キーボード操作、見えるフォーカスを優先します。
失敗5:robots.txtをアクセス制御だと思う
Perplexityの公式資料は、ユーザー起点のPerplexity-Userがrobots.txtを一般に無視すると説明しています。robots.txtにDisallowを書いたから顧客情報が守られる、という設計は成立しません。URLを知っていれば取得できる情報は公開情報です。認証、権限、署名付きURLの期限、ネットワーク境界など、本来のアクセス制御を使います。
失敗6:AI操作のために確認を省く
問い合わせ送信、購入、予約、解約を短い手順にするため、確認画面や再認証を外すのは逆効果です。Comet側にも実行権限や重要操作の確認がありますが、サイト側の安全責任がなくなるわけではありません。何が起きるかを事前に示し、取り消せない処理ほど明示的な確認を残します。
失敗7:llms.txtや構造化データを魔法の入口にする
llms.txtや構造化データを設置しても、古い料金、曖昧な対象者、壊れたフォームは直りません。Perplexityが公開しているComet資料からは、一般サイトのllms.txtをCometが必須入力として使うとは確認できません。補助ファイルを検討する場合も、可視本文と正本URLを先に整えます。llms.txtの役割と限界はllms.txtとはで確認できます。
成果は「引用数」だけでなく3種類の証拠で見る
Comet対応の評価を、検索順位や引用回数だけに寄せると、ページ理解や操作安全の問題を見落とします。次の3種類を別々に記録します。
- 取得ログ:PerplexityBot、Perplexity-User、HTTP状態、WAF判定、対象URLを確認します。到達は分かりますが、回答への採用や理解の正確さまでは分かりません。
- 回答・要約テスト:定義、対象者、条件、料金、根拠、更新日を取り出せるか確認します。一度の成功を、別の質問や将来版での再現保証にはしません。
- 操作テスト:移動、入力、エラー、確認、完了、権限境界を確認します。安全な検証環境で成功しても、あらゆる環境での成功を保証するものではありません。
通常のブラウザとして開いたページの内容をAssistantへ渡す場面では、別のクローラーアクセスとして観測できない可能性があります。これは公開資料から導く運用上の推論です。ログ、画面テスト、問い合わせ品質を組み合わせます。
AI検索全体の土台は、LLMO対策とはで確認できます。
よくある質問
Perplexity Cometは無料で使えますか?
Perplexityは2025年10月の公式更新情報で、Cometブラウザを世界中の利用者へ無料公開したと案内しています。ただし、同じ更新情報でも複数のバックグラウンドAssistantはMax向けとされており、使えるAI機能、モデル、回数、法人管理機能はプランや展開状況で変わり得ます。導入判断時は現在の公式画面と契約条件を確認してください。
Comet向けの特別な構造化データはありますか?
確認時点のPerplexity公式資料では、一般企業サイトに必須となるComet専用の構造化データは確認できません。Organization、Article、Productなど、ページ内容に合う既存の構造化データを使う場合も、可視本文との一致を優先します。構造化データを追加すればCometでの引用や操作が有利になる、と断定できる公式根拠はありません。
llms.txtを置けばCometに理解されやすくなりますか?
Cometが一般サイトのllms.txtを必ず読み、要約や操作の優先情報として使うという公式仕様は確認できません。llms.txtを設置する場合も、サイト案内の補助として扱い、本文、内部リンク、正本URL、アクセス制御の代わりにしないことが重要です。
PerplexityBotを拒否するとCometからページを読めなくなりますか?
一律には言えません。PerplexityBotは検索結果向けのクローラーですが、ユーザー起点のPerplexity-Userや、ユーザーがCometで直接開いたタブの文脈利用は別です。Perplexityの公式資料ではPerplexity-Userはrobots.txtを一般に無視すると説明されています。公開範囲はrobots.txtだけでなく、認証・認可を含めて設計してください。
CometでテストすればAI検索対策の成果を保証できますか?
保証できません。Cometの回答や操作は、質問、ページ状態、権限、プラン、モデル、サービス更新などで変わり得ます。テストは誤解やUI上の弱点を見つける診断として使い、引用保証、表示保証、検索順位の向上保証へ置き換えないでください。
最後に確認すべきこと
Perplexity Cometとは、AI検索をブラウザの外付け機能ではなく、閲覧と操作の流れに組み込んだWebブラウザです。企業サイトに必要なのは、Cometだけを狙う小手先の最適化ではありません。
- 公開してよい正本ページへ到達できるか
- ページ単体で、会社、対象者、提供内容、条件、根拠が読めるか
- 可視テキスト、見出し、メタデータ、構造化データが矛盾していないか
- リンク、ボタン、フォームの目的と結果が明確か
- 送信、予約、購入、解約の前に、人が影響を確認できるか
- 非公開情報を認証・認可で守り、robots.txtへ安全性を委ねていないか
- 取得、回答、操作を別々の証拠で検証しているか
この7点が揃えば、Cometに限らず、検索エンジン、AI検索、人間の利用者にとっても説明責任のあるサイトへ近づきます。どのページが正本か、どこで誤解されるか、技術設定と本文のどちらを先に直すかを整理したい場合は、LLMO診断で確認する観点から自社サイトを点検できます。診断は成果を約束するものではなく、情報源と操作経路の弱点を具体化するために使います。
公式情報で確認するポイント
AI検索まわりは仕様変更が多いため、記事公開前後に公式情報を確認し、本文の言い切りや実装方針を更新します。
- Google Search Central「Optimizing your website for generative AI features」 生成AI検索に対して、通常のSEO・技術要件・独自性の扱いを確認する公式ガイド。
- Google Search Central「Creating helpful, reliable, people-first content」 人間に役立つ信頼性の高いコンテンツを評価するための公式観点。
本体メディアであわせて確認する記事
この記事のテーマを、Uravation本体メディアで検索流入のあるAIツール・モデル解説にもつなげて確認できます。
AI活用書籍シリーズ累計59,900部の著者チームが監修。自社7メディアの実運用でAI検索からの引用・流入を継続計測しており、その一次データと公式情報に基づいて、企業サイトで実務的に使える形へ整理しています。仕様変更が多い領域のため、公開前後に公式情報と本文の整合性を確認します。
AI検索診断・情報源設計支援に進める
この記事のテーマを自社サイトに当てはめ、公開情報、根拠ページ、FAQ、内部リンク、構造化データ、llms.txtのどこを確認すべきかを整理します。
AI検索攻略の前後の記事
同じ連載の前後の記事へ進み、LLMO、AIO、GEO、AI検索の論点を順番に確認できます。
関連するUravationの導線
AI検索攻略は、Uravation本体のAI活用メディアとサービス導線につながる専門テーマとして運用します。