サブドメインとサブディレクトリの選択をAI検索・LLMO観点で再検討。robots.txtとllms.txtはホスト単位で独立し、ブランド情報の集約にも差が出ます。判断表と実装チェックリスト付きで新規構築・既存運用の正解を整理します。
- サブドメイン サブディレクトリ ai検索 llmoの定義、実務判断、確認項目をAI検索時代の情報源設計として整理する。
- 公式情報と一次情報を優先し、表示保証や順位改善の断定を避ける。
- 本文、FAQ、内部リンク、llms.txt、構造化データの整合性を継続確認する。
実務で見る観点
各AI検索サービスのクローラー名とrobots.txtでの扱いを公式情報で確認する。
サービス内容、料金、対象者、事例、会社情報を正規ページに集約して矛盾を減らす。
外部メディア、SNS、比較サイトに出ている説明と自社サイトの記述がずれていないか見る。
判断の分かれ目は「ホスト(ドメイン名の部分)を分けるかどうか」に尽きます。サブドメインは技術的に別ホストであり、robots.txtもllms.txtもホスト単位で独立します。サブディレクトリは同一ホストの中の区画であり、ルートに置いた制御ファイルの傘の下に入ります。2026年9月現在、AIクローラーの制御・llms.txtの適用範囲・ブランド情報の集約という3つの層すべてで、この「ホストが分かれるか否か」が実務上の分岐点です。だから結論はシンプルで、AI検索での引用・ブランド認識を1つに束ねたいなら、迷った場合はサブディレクトリを選ぶ。サブドメインを選ぶのは、運用主体・システム・対象読者が明確に別で、「別サイトとして扱われても構わない」と言い切れるときだけです。
従来のSEOでは「サブドメインとサブディレクトリに優劣はない」という整理で決着がついていました。Googleのジョン・ミューラー氏も2017年公開のSEO Snippets動画で「Google検索ではどちらを使っても問題ない」と明言しています。しかしAI検索(ChatGPT検索・AI Overview・Perplexity・Gemini)の文脈では、順位の優劣とは別の判断材料が増えました。本記事はSEO一般論の焼き直しではなく、AI検索固有の判断材料だけに絞って、この定番論争を再検討します。
サブドメインとサブディレクトリの定義と、AI検索で効く違い
まず、AI検索の回答にそのまま切り出されても意味が通るように、定義を独立した形で置きます。
サブドメインとは、ドメイン名の前に区分を追加して作る別ホストのことです(例: blog.example.com、shop.example.com)。DNS上は独立したホスト名であり、robots.txtやllms.txtなどのホスト単位の制御ファイルは、example.com本体とは別に自分専用のものを持ちます。サブディレクトリとは、同一ホスト内のパス区分のことです(例: example.com/blog/、example.com/shop/)。ホストはexample.comのまま変わらないため、example.com/robots.txtの規則がそのまま適用されます。
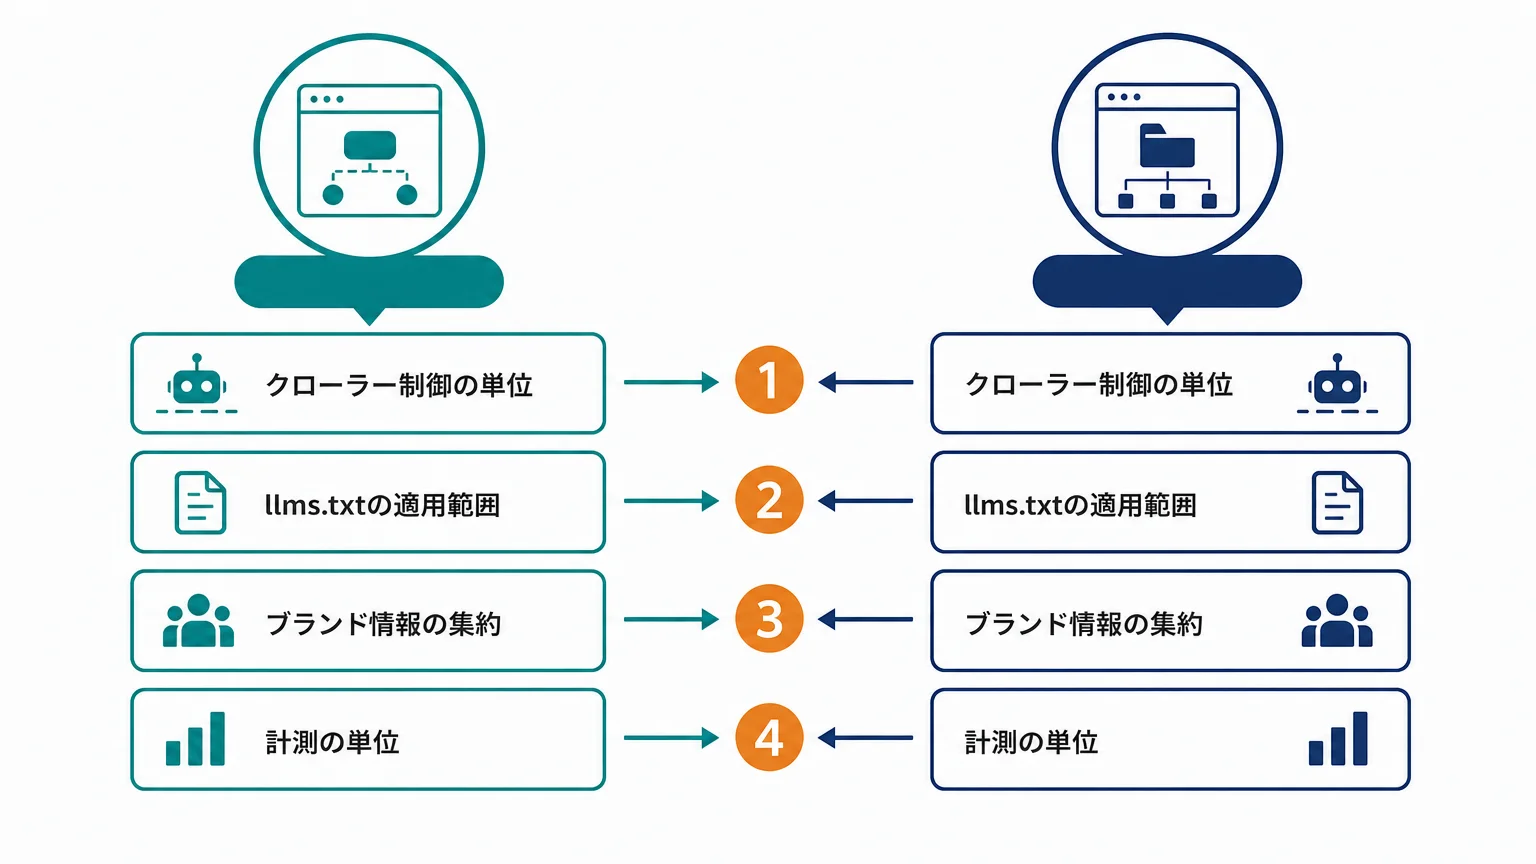
AI検索の観点でこの違いが効くのは、次の4点です。
- クローラー制御の単位: GPTBotなどのAIクローラーが従うrobots.txtは、プロトコル・ホスト・ポートの組み合わせごとに独立する
- llms.txtの適用範囲: llms.txtは設置したホスト(またはパス)配下だけをカバーし、別ホストには波及しない
- ブランド情報の集約: AIが「この会社は何者か」を組み立てる材料が、1ホストにまとまるか複数ホストに散るか
- 計測の単位: Search Consoleのプロパティ設計もサーバーログの確認も、ホストが分かれれば分かれる
順に、一次情報で確認できる事実と、まだ仮説の域を出ない部分を分けて見ていきます。
robots.txtはホスト単位。サブドメインはAIクローラー制御も別管理になる
ここは公式仕様で確認できる、確定した事実です。
Google Search Centralのrobots.txtガイド(2026年9月時点の版)は、適用範囲を次のように定めています。「robots.txtファイルは、設置されたプロトコル・ホスト・ポート内のパスにのみ適用される。https://example.com/robots.txt の規則は https://example.com/ 内のファイルにのみ適用され、https://m.example.com/ のようなサブドメインや、http://example.com/ のような別プロトコルには適用されない」。つまりblog.example.comをサブドメインで作った瞬間、blog.example.com/robots.txtという別ファイルの管理義務が発生します。
そしてAIクローラーは、このrobots.txtの仕組みに乗って制御されます。OpenAIの公式クローラー文書(developers.openai.com/api/docs/bots、2026年9月閲覧)では、学習用のGPTBot、ChatGPT検索用のOAI-SearchBot、ユーザー操作時に取得するChatGPT-User、広告審査用のOAI-AdsBotという4つのユーザーエージェントが定義され、学習用と検索用はそれぞれrobots.txtで個別に許可・拒否を設定する方式が示されています(ChatGPT-Userはユーザー起点の取得のためrobots.txtが適用されない場合があると明記されています)。AnthropicやPerplexityも同様にrobots.txt準拠のクローラー運用を公表しています。どのAIクローラーをどう許可するかの判断基準はrobots.txtでAIクローラーを許可すべきかで詳しく整理しています。
実務への影響を具体的に言うと、こうなります。
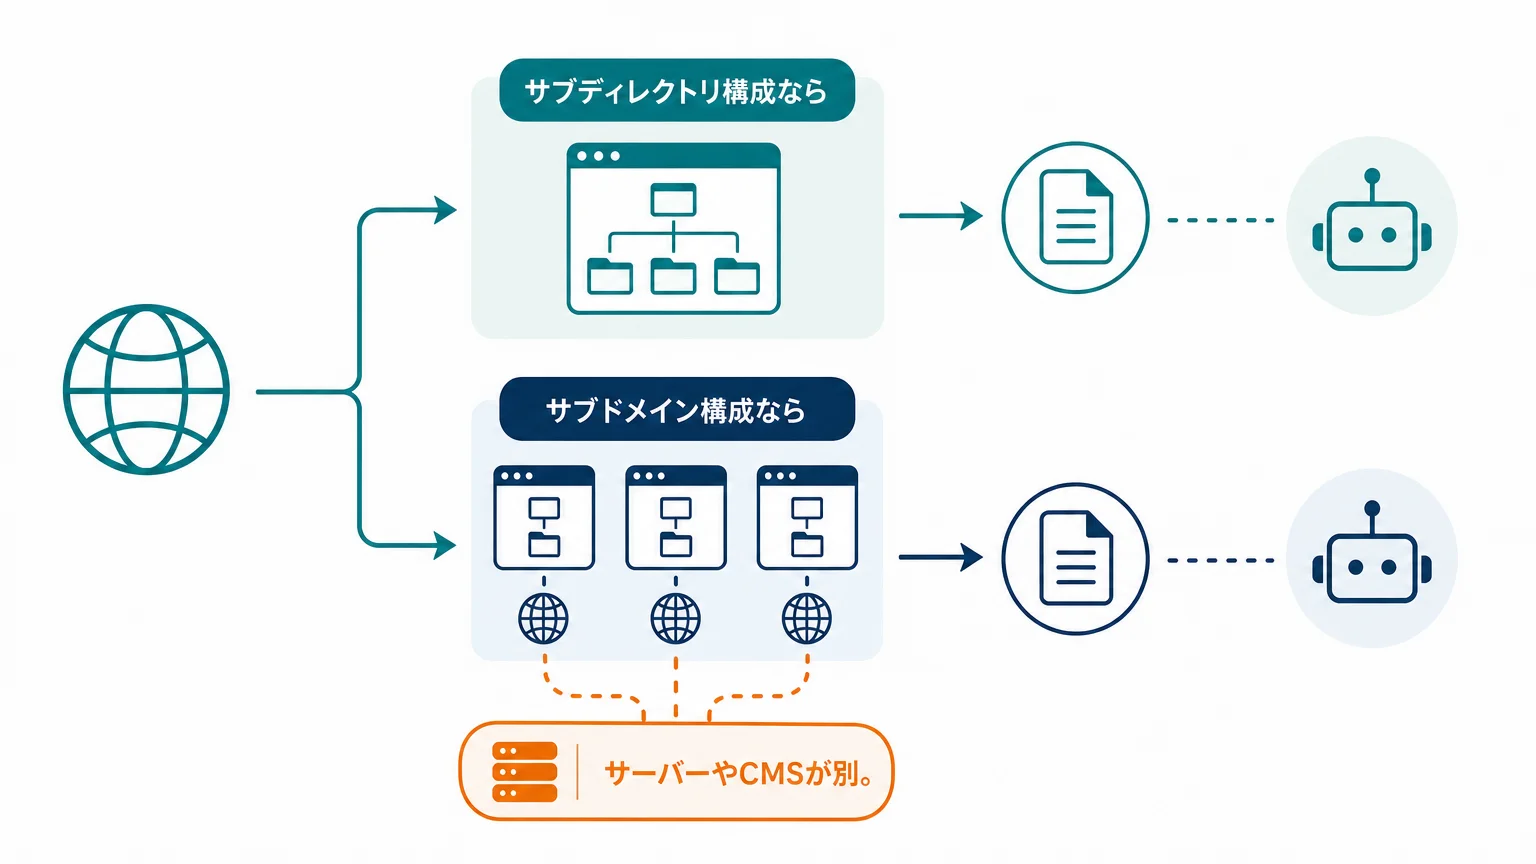
- サブディレクトリ構成なら、example.com/robots.txtの1ファイルでコーポレートサイトもオウンドメディアもまとめてAIクローラー制御ができる
- サブドメイン構成なら、本体で「OAI-SearchBotを許可」していても、blog.example.com側のrobots.txtが未設置・設定漏れなら、メディア側は本体の方針を引き継がない
- サーバーやCMSが別(本体は自社サーバー、メディアは外部SaaSなど)の場合、サブドメイン側のrobots.txtを自分で編集できないケースすらある
「本体はAI検索対応済みなのに、集客の主力であるメディア側が管理外だった」という事態は、サブドメイン構成の見落としがちな穴です。自社のAIクローラー来訪状況を確かめたい場合は、AIクローラーのログ確認方法の手順でホストごとにログを見るのが確実です。
llms.txtはホストを越えない。サブドメインごとに別ファイルが必要
llms.txtの仕様(llmstxt.org)は、Jeremy Howard氏が2024年9月3日に提案し、2026年8月10日にv2へ改訂されています。v2で押さえるべきポイントは2つあります。
1つ目は、ホストをまたいだ継承はないこと。仕様が定めるのはあくまで「設置したパス配下」のカバーであり、example.com/llms.txtに書いた内容がblog.example.comに適用されるという規定はありません。サブドメインでメディアを運営するなら、メディア側にも独立したllms.txtを用意し、内容も個別にメンテナンスする必要があります。
2つ目は、v2からパス配下への設置が正式化されたこと。仕様は「ファイルはサイトルートにも、サイト内の任意のパスにも設置でき、そのパス配下のページをカバーする」と定めています。つまりexample.com/blog/llms.txtのように、サブディレクトリ単位でメディア専用のllms.txtを持つ構成が仕様上可能になりました。複数のllms.txtが該当する場合は、より具体的なパスのものが優先されます。
これはサブドメインvsサブディレクトリ論争にとって小さくない変化です。v2以前は「メディア専用のllms.txtを持ちたいならサブドメイン」という消極的理由がありえましたが、現在はサブディレクトリでも区画専用のllms.txtを持てるため、この理由は薄れました。
ただし、llms.txtの効果は冷静に見る必要があります。Google Search Centralの「AI機能とウェブサイト」ドキュメント(2026年9月閲覧)は、AI Overview・AIモードへの表示について「新しい機械可読ファイル、AI用テキストファイル、マークアップを作成する必要はない」と明言しています。またllms.txtを読むかどうかは各AI事業者の実装次第であり、2026年9月時点で主要AI検索がllms.txtをどの程度利用しているかについて、OpenAI・Google・Anthropicからの網羅的な公式発表は確認できていません。llms.txtは「置けば引用に効く」ものではなく、コストの低い補助施策と位置づけるのが妥当です。WordPressサイトでの設置判断はWordPressでllms.txtを設置する前に確認すべきことにまとめています。
ブランド認識の分散リスク。AIは「会社」を1つの実体として組み立てる
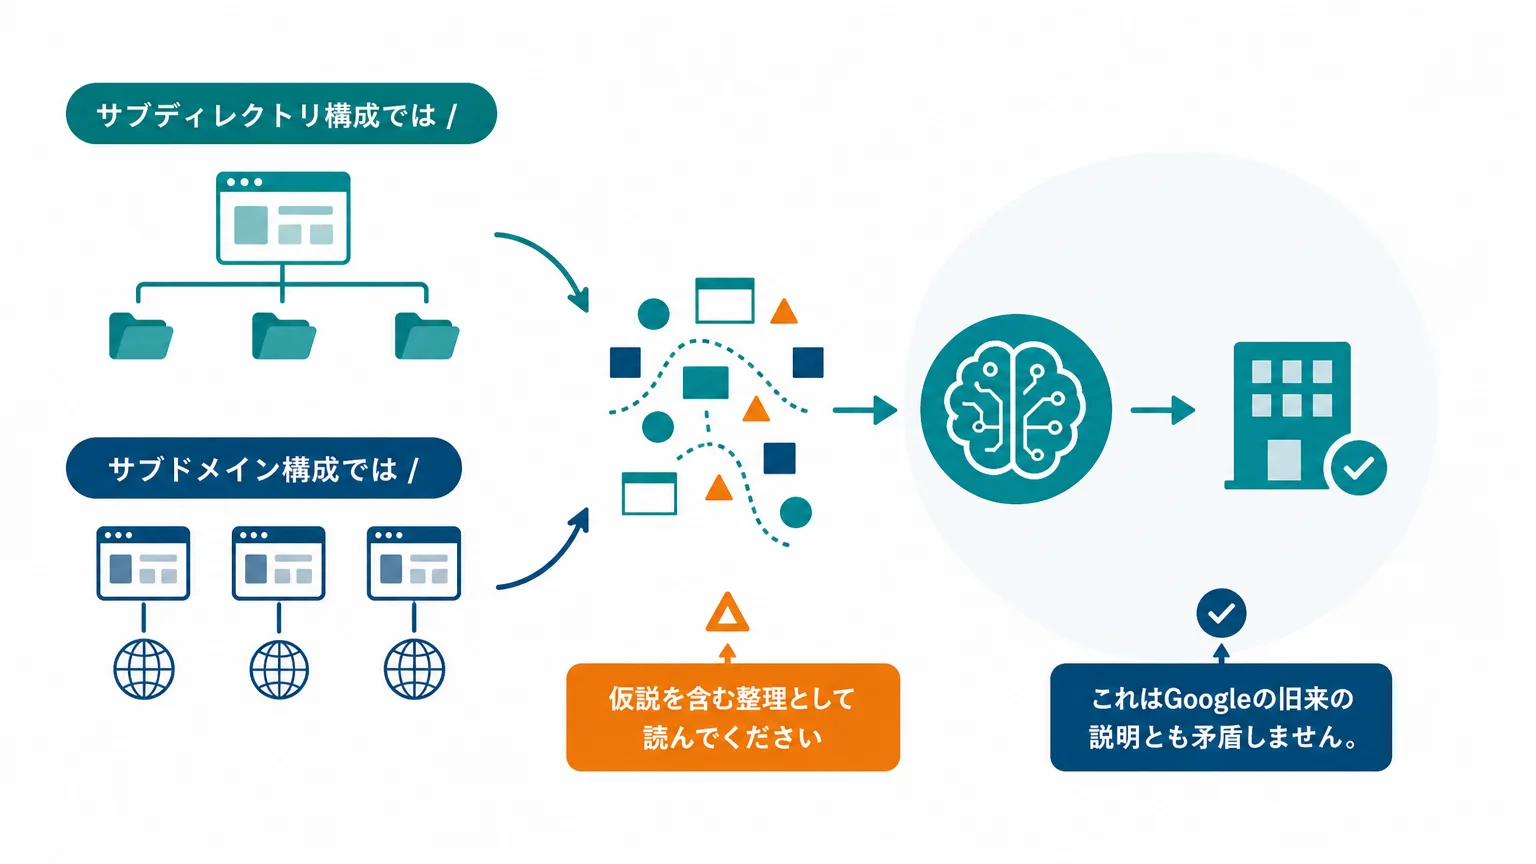
ここからは、公式仕様として明文化されてはいないが、AI検索の動作原理から導かれる実務上の論点です。仮説を含む整理として読んでください。
AI検索は、キーワードとページを突き合わせる従来型検索と違い、「この会社は何をしている、どんな実績のある会社か」という実体(エンティティ)の理解を回答の土台にします。その理解の材料になるのは、会社概要・サービス説明・実績・記事群といったサイト上の情報の総体です。
このとき、情報が1ホストに集約されているか、複数ホストに散っているかで、次の差が生まれうると考えられます。
- サブディレクトリ構成では、会社の一次情報(/company/)と専門性を示す記事群(/blog/)が同一ホストにあり、AIが「同じ発信主体の情報」として結び付けやすい
- サブドメイン構成では、ホスト名が異なるため、本体とメディアの紐付けは構造上の同一性ではなく、相互リンク・運営者表記・構造化データなどの明示的なシグナルに依存する
これはGoogleの旧来の説明とも矛盾しません。ミューラー氏は前述の動画で優劣を否定しつつ、サブドメインは「新しいサイト」としてGoogleが個別に学習する場合があることにも触れています。従来SEOでは短期間で解消する程度の話でしたが、AI検索では「どのホストの情報を同一ブランドとして束ねるか」の問題として、より長く効いてくる可能性があります。ブランドと実体情報の設計全般はLLMOのエンティティ対策で扱っています。また、事業部やブランドが複数あり、ホストも複数に分かれている場合の整理はグループ会社・複数ブランドのAI検索対策が参考になります。
念のため明確にしておくと、「サブドメインだからAIに引用されない」という単純な話ではありません。サブドメインで運営されている著名メディアがAI回答に引用される例は普通にあります。問題は引用の可否ではなく、「引用された情報が、あなたの会社のブランド理解に合算されるか」です。分散リスクとは、努力が消えるリスクではなく、努力が本体ブランドに紐付かないリスクです。
計測もホスト単位で分かれる。Search Consoleとログの設計
見落とされがちな4つ目の層が計測です。構成の選択は、AI検索の効果をどう測れるかにも直結します。
Search Consoleのプロパティは、URLプレフィックスで登録した場合はホスト(とパス)単位で分かれます。サブドメイン構成では、本体とメディアのプロパティを別々に登録・確認することになり、ドメインプロパティで束ねない限り、横断で見るには手間が増えます。サーバーログも同様で、GPTBotやOAI-SearchBotの来訪をgrepで確認する運用は、ホストごとにログファイルが分かれていれば、その数だけ確認対象が増えます。
一方で、これは「分かれること」を逆に活かせる場面でもあります。メディアだけのAIクローラー来訪傾向・AI経由流入を切り出して見たい場合、ホストが分かれていれば集計は単純になります。サブディレクトリ構成でも、GA4ならページパスでのフィルタ、ログならパスでのgrepで同じことはできるので、決定打ではありませんが、「計測を分けたいから」という理由でサブドメインを選ぶ選択肢は理解できるものです。ChatGPTやPerplexity経由の流入をGA4でどう捕捉するかはAI検索の流入をGA4で計測する設定手順で解説しています。
要するに計測の層では、サブディレクトリは「束ねて見るのが楽で、分けて見るには一手間」、サブドメインは「分けて見るのが楽で、束ねて見るには一手間」です。どちらの一手間を払うかは、レポートを誰に出すか(経営層に会社全体で見せるのか、メディア単体のKPIを追うのか)で決めてください。
判断表: あなたのケースはどちらを選ぶべきか
以上を踏まえた判断表です。AI検索観点の判断軸は「ブランドを束ねたいか、切り離したいか」と「制御ファイルを一元管理できるか」の2つです。
| 状況 | 推奨 | AI検索観点の理由 |
|---|---|---|
| コーポレートサイトにオウンドメディアを追加する | サブディレクトリ | 記事の専門性が本体のブランド理解に合算される。robots.txt・llms.txtも1ホストで一元管理できる |
| 本体と同一ブランドのサービス紹介・採用情報を増やす | サブディレクトリ | AIが会社を説明する材料を1ホストに集約でき、情報の矛盾も検知しやすい |
| 本体とはターゲットもブランド名も別の新規事業を立ち上げる | サブドメインまたは別ドメイン | ブランドを意図的に切り離す場合はホスト分割が合理的。AIに別実体として認識させたいケース |
| 外部SaaS(採用管理・ECモール型カートなど)でしか構築できない | サブドメイン(技術制約として受容) | 技術的にサブディレクトリ化できない場合は、相互リンクと運営者表記で本体との紐付けを補強する |
| ヘルプセンター・開発者向けドキュメント | どちらでも可。迷えばサブディレクトリ | 製品理解の材料になるためブランド合算の価値はあるが、外部ツール利用が多い領域でもある |
| 既にサブドメインで運営中のメディアがある | 原則現状維持 | 移転はリダイレクト設計を伴う大工事。分散リスク解消の期待値より移行事故のリスクが上回りやすい |
最後の行は強調しておきます。この記事は「サブドメイン運用は今すぐ引っ越すべき」という主張ではありません。URL構造の変更は、蓄積された被リンク・AI側の既存の認識・リダイレクトの網羅性など、失うものが大きい判断です。既存サイトの構造を動かす場合の注意点はサイトリニューアルのLLMO対策を先に読んでください。
実装チェックリスト: 選んだ構成でやるべきこと
どちらを選んだ場合でも、AI検索観点で押さえるべき実装項目をチェックリスト化しました。
| No. | チェック項目 | サブディレクトリ構成 | サブドメイン構成 |
|---|---|---|---|
| 1 | robots.txtのAIクローラー設定 | ルートの1ファイルで方針を統一 | 本体・サブドメインの両方に設置し、方針を揃える |
| 2 | llms.txtの設置 | ルートに1つ。必要なら区画パス配下に専用ファイルを追加 | ホストごとに個別設置・個別更新 |
| 3 | XMLサイトマップ | ルートのサイトマップに統合、またはインデックスで束ねる | ホストごとに用意し、Search Consoleもホストごとに確認 |
| 4 | 運営者情報の明示 | フッター・会社概要への内部リンクで自然に接続 | 「運営: 株式会社◯◯」の明記と本体への相互リンクを全ページに置く |
| 5 | 構造化データのOrganization | 本体の記述に準拠 | 本体と同一のOrganization情報(名称・URL・ロゴ)を記述し、別会社と誤認されない状態にする |
| 6 | 社名・ブランド名の表記統一 | 本体と同一の正式表記を使う | ホストが違う分、表記ゆれの影響が大きい。正式表記を厳密に統一する |
| 7 | AIクローラーのログ確認 | 1ホスト分のログで完結 | ホストごとにログを分けて確認する |
| 8 | Search Console・GA4の計測設計 | 1プロパティで横断把握。区画別はパスで絞る | プロパティをホストごとに登録し、レポートで合算する運用を決める |
| 9 | AI回答での自社の説明のされ方の定点確認 | ブランド名で確認 | ブランド名に加えて、メディア名単体でも確認し、本体と紐付いて説明されるかを見る |
表を見れば分かるとおり、サブドメイン構成は「できない」のではなく「やることが2倍になり、漏れた分だけ本体と切り離される」構成です。この管理コストを払い続けられる体制があるかどうかも、選定時に織り込んでください。
失敗例: ホスト分割で起きがちな3つの事故
実務で起きやすい失敗パターンを挙げます。いずれも構成選択そのものではなく、「ホストが分かれていることを忘れた運用」が原因です。
失敗例1: メディア側のrobots.txtが放置され、AIクローラーの方針が本体と食い違う。 本体では「検索用クローラーは許可、学習用は拒否」と設計したのに、サブドメインのメディアはCMSの初期設定のまま。数カ月後にログを見たら、拒否したはずのクローラーがメディア側だけを巡回していた、あるいは許可したいクローラーがメディア側でブロックされていた、というパターンです。robots.txtがホスト単位である以上、方針変更のたびに全ホストへ反映する運用ルールが要ります。
失敗例2: サブドメインのメディアに運営者表記がなく、AIが本体と結び付けない。 記事の品質は高いのに、AIにブランド名で質問すると本体サイトの情報しか参照されず、メディアで蓄積した専門性が会社の説明に反映されない。メディア名で聞くと今度は運営会社が曖昧に説明される。相互リンクと運営者の明記という基本の欠落が、ホスト分割で顕在化した形です。
失敗例3: 分散リスクを恐れて安易にサブディレクトリへ移転し、リダイレクト漏れで評価を落とす。 逆方向の失敗です。既存のサブドメインメディアをサブディレクトリへ統合する移転は、全URLの301リダイレクト・内部リンク書き換え・サイトマップ更新・AI側の再クロール待ちが揃って初めて成立します。移転の目的(ブランド合算)に対して、失敗時の損失(既存の引用・流入の毀損)が大きいため、「新規はサブディレクトリ、既存は原則維持」が安全側の判断です。
FAQ: サブドメインとサブディレクトリのよくある質問
サブドメインとサブディレクトリの違いは何ですか?
サブドメインはドメイン名の前に区分を付けた別ホスト(blog.example.com)、サブディレクトリは同一ホスト内のパス区分(example.com/blog/)です。AI検索観点での本質的な違いは、robots.txt・llms.txtといったホスト単位の制御ファイルが独立するかどうかと、ブランド情報が1ホストに集約されるかどうかです。
SEOではどちらが有利ですか?
Googleは公式に優劣を否定しています。ジョン・ミューラー氏は2017年公開のSEO Snippets動画で「どちらを使っても問題ない」と述べており、この見解は現在も覆されていません。順位の有利不利で選ぶ問題ではなく、運用体制とブランド設計で選ぶ問題です。
AI検索・LLMOの観点ではどちらが良いですか?
新規に作るなら、迷った場合はサブディレクトリを推奨します。理由は、AIクローラー制御とllms.txtを1ホストで一元管理でき、記事で蓄積した専門性が本体ブランドの理解に合算されやすいためです。ただし、別ブランドの事業や外部SaaS利用など、ホストを分ける合理的理由がある場合はサブドメインで問題なく、その場合は運営者表記と相互リンクで本体との紐付けを補強します。
既にサブドメインで運用中のメディアは移転すべきですか?
原則、移転は推奨しません。301リダイレクトの設計・実施を伴う移転は失敗時の損失が大きく、分散リスクの解消という期待値に見合わないケースが多いためです。移転せずにできる対策(両ホストのrobots.txt・llms.txt整備、運営者明記、Organization構造化データの統一)を先に実施してください。
WordPressでサブディレクトリにメディアを作る場合の注意点はありますか?
本体と別のWordPressをサブディレクトリ配下に置く構成(例: example.com/blog/に別インスタンス)は技術的に可能ですが、robots.txtとllms.txtはホストのルート(本体側)にあるファイルが正となる点に注意してください。メディア側のプラグインが生成する制御ファイルがルートのファイルと矛盾しないか、導入時に必ず確認します。
ここまでの要点
サブドメインvsサブディレクトリは、AI検索時代には「順位の優劣」ではなく「ホスト分割の是非」の問題です。確定事実として、robots.txtはプロトコル・ホスト・ポート単位で独立し(Google公式仕様)、llms.txtもホストを越えて適用されません(llmstxt.org v2仕様)。AIクローラーの制御漏れは、サブドメイン構成でこそ起きます。その上で、AIが会社を1つの実体として理解する以上、情報を1ホストに束ねるサブディレクトリの方が、新規構築では安全側の選択です。既存のサブドメイン運用は無理に動かさず、両ホストの制御ファイル整備と運営者の明示で紐付けを補強してください。
自社の構成でAIクローラー制御や情報設計に漏れがないかを確かめたい場合は、まずLLMO診断チェックリストで自己点検するのが早道です。サイト構造をまたぐ判断(移転の是非、複数ブランドの整理など)で専門家の目が必要な場合は、UravationのLLMO診断・AI検索対策の相談窓口もご利用いただけます。
公式情報で確認するポイント
AI検索まわりは仕様変更が多いため、記事公開前後に公式情報を確認し、本文の言い切りや実装方針を更新します。
- Google Search Central「Optimizing your website for generative AI features」 生成AI検索に対して、通常のSEO・技術要件・独自性の扱いを確認する公式ガイド。
- Google Search Central「Creating helpful, reliable, people-first content」 人間に役立つ信頼性の高いコンテンツを評価するための公式観点。
本体メディアであわせて確認する記事
この記事のテーマを、Uravation本体メディアで検索流入のあるAIツール・モデル解説にもつなげて確認できます。
AI活用書籍シリーズ累計59,900部の著者チームが監修。自社7メディアの実運用でAI検索からの引用・流入を継続計測しており、その一次データと公式情報に基づいて、企業サイトで実務的に使える形へ整理しています。仕様変更が多い領域のため、公開前後に公式情報と本文の整合性を確認します。
AI検索診断・情報源設計支援に進める
この記事のテーマを自社サイトに当てはめ、公開情報、根拠ページ、FAQ、内部リンク、構造化データ、llms.txtのどこを確認すべきかを整理します。
AI検索攻略の前後の記事
同じ連載の前後の記事へ進み、LLMO、AIO、GEO、AI検索の論点を順番に確認できます。
関連するUravationの導線
AI検索攻略は、Uravation本体のAI活用メディアとサービス導線につながる専門テーマとして運用します。