meta-externalagentは学習用、Meta AIの引用はMeta-WebIndexerの許可で「可能になる」とMetaは書く。5つのクローラーの役割、学習を断り引用を残すrobots.txtの例、3サイトのログの来訪回数。
- Metaの文書は、5つのクローラー(FacebookExternalHit・Meta-WebIndexer・Meta-ExternalAds・Meta-ExternalAgent…
- Meta-WebIndexerについて文書は「robots.txtファイルでMeta-WebIndexerを許可すると、Meta AIの回答でのコンテンツの引用やリンクが可能にな…
- Meta-ExternalFetcherは「ユーザーのリクエストに応じて個々のリンクを取得」するため「robots.txtのルールを無視する可能性があります」と書かれ、Faceb…
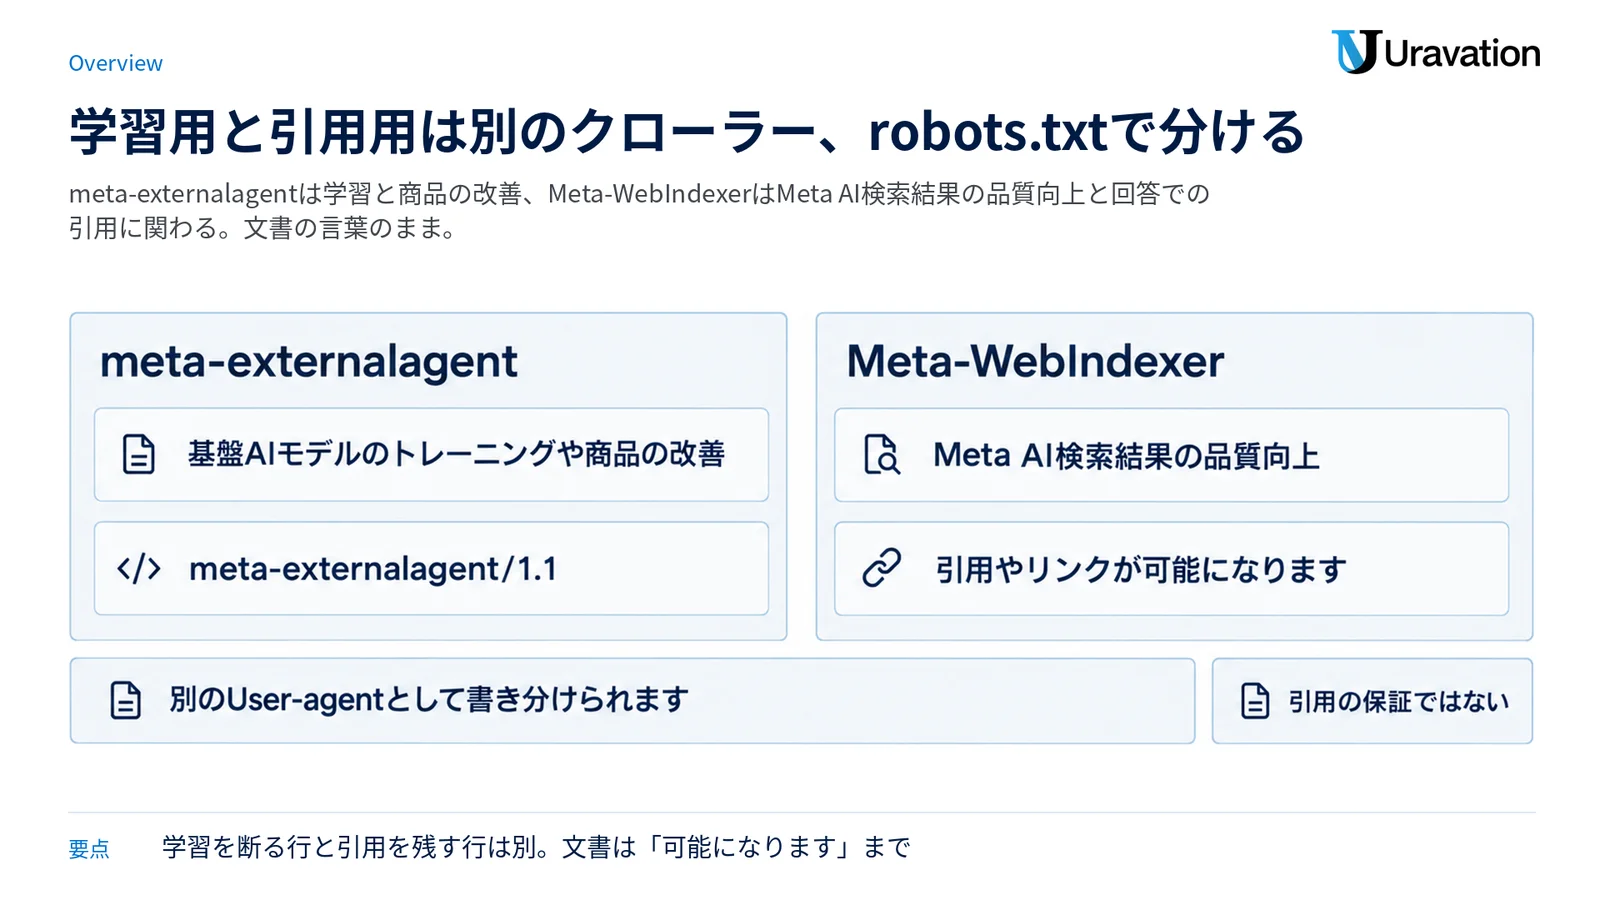
アクセスログに出てきたmeta-externalagentやMeta-WebIndexerは何者で、robots.txtで止めてよいのでしょうか。答えは、2026年11月5日時点のMetaの文書「Meta Webクローラー」では、meta-externalagentは「基盤AIモデルのトレーニングや商品の改善などのユースケース」でウェブをクロールするクローラー、Meta-WebIndexerは「ユーザーのMeta AI検索結果の品質向上」のためにウェブを回るクローラーで、robots.txtでは別々のUser-agentとして書き分けられます。学習を断りたいならmeta-externalagentにDisallowを書き、Meta AIの回答での引用やリンクの可能性を残したいならMeta-WebIndexerを止めない、という分け方ができます。
2026年11月5日時点で、Metaの文書とヘルプ、robots.txtの仕様(RFC 9309)から確かめられた事実は次の5つです。
- Metaの文書は、5つのクローラー(FacebookExternalHit・Meta-WebIndexer・Meta-ExternalAds・Meta-ExternalAgent・Meta-ExternalFetcher)について、ログに出るUA(User-Agent)文字列と用途を載せている。文書の更新日は2026年5月21日
- Meta-WebIndexerについて文書は「robots.txtファイルでMeta-WebIndexerを許可すると、Meta AIの回答でのコンテンツの引用やリンクが可能になります」と書いている。「可能になる」までで、引用の保証ではない
- Meta-ExternalFetcherは「ユーザーのリクエストに応じて個々のリンクを取得」するため「robots.txtのルールを無視する可能性があります」と書かれ、FacebookExternalHitも「セキュリティまたは整合性のチェックを実行するときにrobots.txtをバイパスする可能性」があるとされている
- robots.txtの変更が効くまで最大24時間かかる。クローラーがrobots.txtの内容を最大24時間キャッシュするためで、RFC 9309もキャッシュを24時間より長く使うべきでないとしている
- Uravationが運用する3サイトの直近7日間のアクセスログで、User-Agentの文字列で数えた来訪の回数は、Meta-WebIndexerが16,249回、meta-externalagentが9,828回だった。来訪の回数で、引用の回数ではない
AI検索の定義ブロック
meta-externalagent(文書の見出しではMeta-ExternalAgent)は、Metaのクローラーの1つです。Metaの文書「Meta Webクローラー」によれば「コンテンツを直接インデックス化することにより、基盤AIモデルのトレーニングや商品の改善などのユースケースでウェブをクロール」します。Meta-WebIndexerは同じ文書で「ユーザーのMeta AI検索結果の品質向上を目的としてウェブをナビゲーション」するクローラーとされ、robots.txtで許可すると「Meta AIの回答でのコンテンツの引用やリンクが可能になります」と書かれています。2つは別のUser-agentなので、学習の可否と引用の可否はrobots.txtで別々に書けます。
meta-externalagentとMeta-WebIndexerは、学習用と検索用の別のクローラー
Metaは、Meta for Developersの文書「Meta Webクローラー」(更新日 2026年5月21日)で、自社の代表的なWebクローラーのUA文字列と用途を一覧にしています。文書の冒頭には、MetaはNoAIタグのような非標準的な形式ではなく、robots.txtのような業界標準の慣行を使って、サイト管理者やコンテンツ所有者が希望を示せるようにしている、とあります。Metaのクローラーに意思を伝える場所として文書が示しているのはrobots.txtです。
この文書で、AIに関わるクローラーとして読むべきなのは次の2つです。役割の説明は文書の言葉のまま引きます。
- Meta-ExternalAgent: 「コンテンツを直接インデックス化することにより、基盤AIモデルのトレーニングや商品の改善などのユースケースでウェブをクロールします」
- Meta-WebIndexer: 「ユーザーのMeta AI検索結果の品質向上を目的としてウェブをナビゲーションします。その際、Metaはオンラインコンテンツを分析し、Meta AIの関連性と正確性を高めます。robots.txtファイルでMeta-WebIndexerを許可すると、Meta AIの回答でのコンテンツの引用やリンクが可能になります」
meta-externalagentは基盤AIモデルのトレーニングや商品の改善、Meta-WebIndexerはMeta AI検索結果の品質向上と回答での引用やリンクに関わる、という分かれ方です。どちらも名前が「meta-」で始まり、AIに関わるため混同されやすいのですが、文書の上では用途が違う別のクローラーで、robots.txtでも別のUser-agentとして書き分けられます。学習は断りたいが引用の可能性は残したい、という希望は、この2つを別々に書くことで表せます。ただし文書が書いているのは「引用やリンクが可能になります」までで、引用の保証ではないことは押さえておきます。文書は「Meta AI」とだけ書いていて、Meta AIのどの画面(アプリ・ウェブ版・WhatsAppなど)の回答を指すかは特定していません。
ログに出るUA文字列と、名前の大文字小文字
文書は、各クローラーについてログに出る文字列を2通りずつ挙げています。meta-externalagentなら「meta-externalagent/1.1 (+/documentation/sharing/webmasters/web-crawlers)」と「meta-externalagent/1.1」、Meta-WebIndexerなら「meta-webindexer/1.1 (+/documentation/sharing/webmasters/web-crawlers)」と「meta-webindexer/1.1」です。かっこの中は文書のページのパスで、ホスト名は付いていません。
文書の見出しはMeta-ExternalAgent・Meta-WebIndexerのように大文字を交えた書き方、UA文字列と文書のrobots.txtの例は小文字です。robots.txtの仕様であるRFC 9309は、クローラーが自分の名前(product token)に一致するグループを探す時に、大文字小文字を区別しない照合をしなければならないと定めているので、robots.txtにはどちらの書き方でも書けます。この記事では、文書のrobots.txtの例に合わせて小文字で書きます。
Meta AIの回答の下の[ソース]で情報源を確かめられる
Metaのヘルプセンターの「Meta AIの回答に使用された情報源やリンクを報告する」には、「Meta AIは回答の参考としてインターネット上の情報源やリンクを使用することがあります。Meta AIの回答の下にある[ソース]を選択すると、Meta AIの情報源を確認できます」とあります。文書が言う「Meta AIの回答でのコンテンツの引用やリンク」は、この[ソース]に自社のページが出る形だと読めます。
一方で、同じヘルプセンターの「Meta AIとのシークレットチャットでウェブ検索のオンとオフを切り替える」には、シークレットチャットでウェブ検索をオンにした場合「Meta AIは、検索時に検索クエリを一部の検索エンジンに送信しますが、その検索クエリが利用者のアカウントにリンクされることはありません」とあります。Meta AIの回答の情報源が、Meta-WebIndexerが集めた内容だけから作られるのか、外部の検索エンジンの結果も使うのかの切り分けは、2026年11月5日時点の公式の文書からは確かめられませんでした。robots.txtで決められるのは、Meta-WebIndexerに自社のページを読ませるかどうかまでです。
Metaの5つのクローラーの役割と、robots.txtを守るかの記述
文書に載っている5つのクローラーを、文書の言葉で並べます。「robots.txtについての文書の記述」の列は文書に書かれていることだけで、「止めた時に文書から言えること」の列は、文書の記述から言える範囲に限りました。
| No. | クローラー(文書の見出し) | ログに出るUA文字列 | 文書が書く用途 | robots.txtについての文書の記述 | 止めた時に文書から言えること |
|---|---|---|---|---|---|
| 1 | FacebookExternalHit | facebookexternalhit/1.1 (+http://www.facebook.com/externalhit_uatext.php)、facebookexternalhit/1.1 | Facebook、Instagram、MessengerなどのMetaのアプリで共有されたアプリやウェブサイトのコンテンツをクロールし、タイトル・説明・サムネイル画像などの情報を収集し、キャッシュに保存し、表示する | マルウェアや悪意のあるコンテンツのチェックなど、セキュリティまたは整合性のチェックを実行するときにrobots.txtをバイパスする可能性がある | 共有時に表示するタイトル・説明・サムネイルの収集に関わる。止めた時の影響は文書に直接の記述がない |
| 2 | Meta-WebIndexer | meta-webindexer/1.1 (+/documentation/sharing/webmasters/web-crawlers)、meta-webindexer/1.1 | ユーザーのMeta AI検索結果の品質向上を目的としてウェブをナビゲーションする。Metaはオンラインコンテンツを分析し、Meta AIの関連性と正確性を高める | robots.txtファイルで許可すると、Meta AIの回答でのコンテンツの引用やリンクが可能になる | 「可能になる」とされる引用やリンクの条件を自分で外すことになる。止めた時の影響は文書に直接の記述がない |
| 3 | Meta-ExternalAds | meta-externalads/1.1 (+/documentation/sharing/webmasters/web-crawlers)、meta-externalads/1.1 | 広告やその他のビジネス関連の商品/サービスの改善などのユースケースのために、ウェブ上の情報を収集する | 文書のrobots.txtの例に登場する(該当するクローラーの禁止を追加して止める) | 広告などの改善のための収集の対象から外す意思表示になる |
| 4 | Meta-ExternalAgent | meta-externalagent/1.1 (+/documentation/sharing/webmasters/web-crawlers)、meta-externalagent/1.1 | コンテンツを直接インデックス化することにより、基盤AIモデルのトレーニングや商品の改善などのユースケースでウェブをクロールする | 文書のrobots.txtの例に登場する(該当するクローラーの禁止を追加して止める) | 基盤AIモデルのトレーニングや商品の改善のためのクロールの対象から外す意思表示になる |
| 5 | Meta-ExternalFetcher | meta-externalfetcher/1.1 (+/documentation/sharing/webmasters/web-crawlers)、meta-externalfetcher/1.1 | ユーザーのリクエストに応じて個々のリンクを取得し、エージェントAI機能の評価や改善など、製品機能をサポートする。AIがウェブサイトを探してユーザーのタスクを完了するのを支援することを含む | ユーザーのリクエストでフェッチを実行するため、robots.txtのルールを無視する可能性がある | robots.txtで止めても取得されることがある |
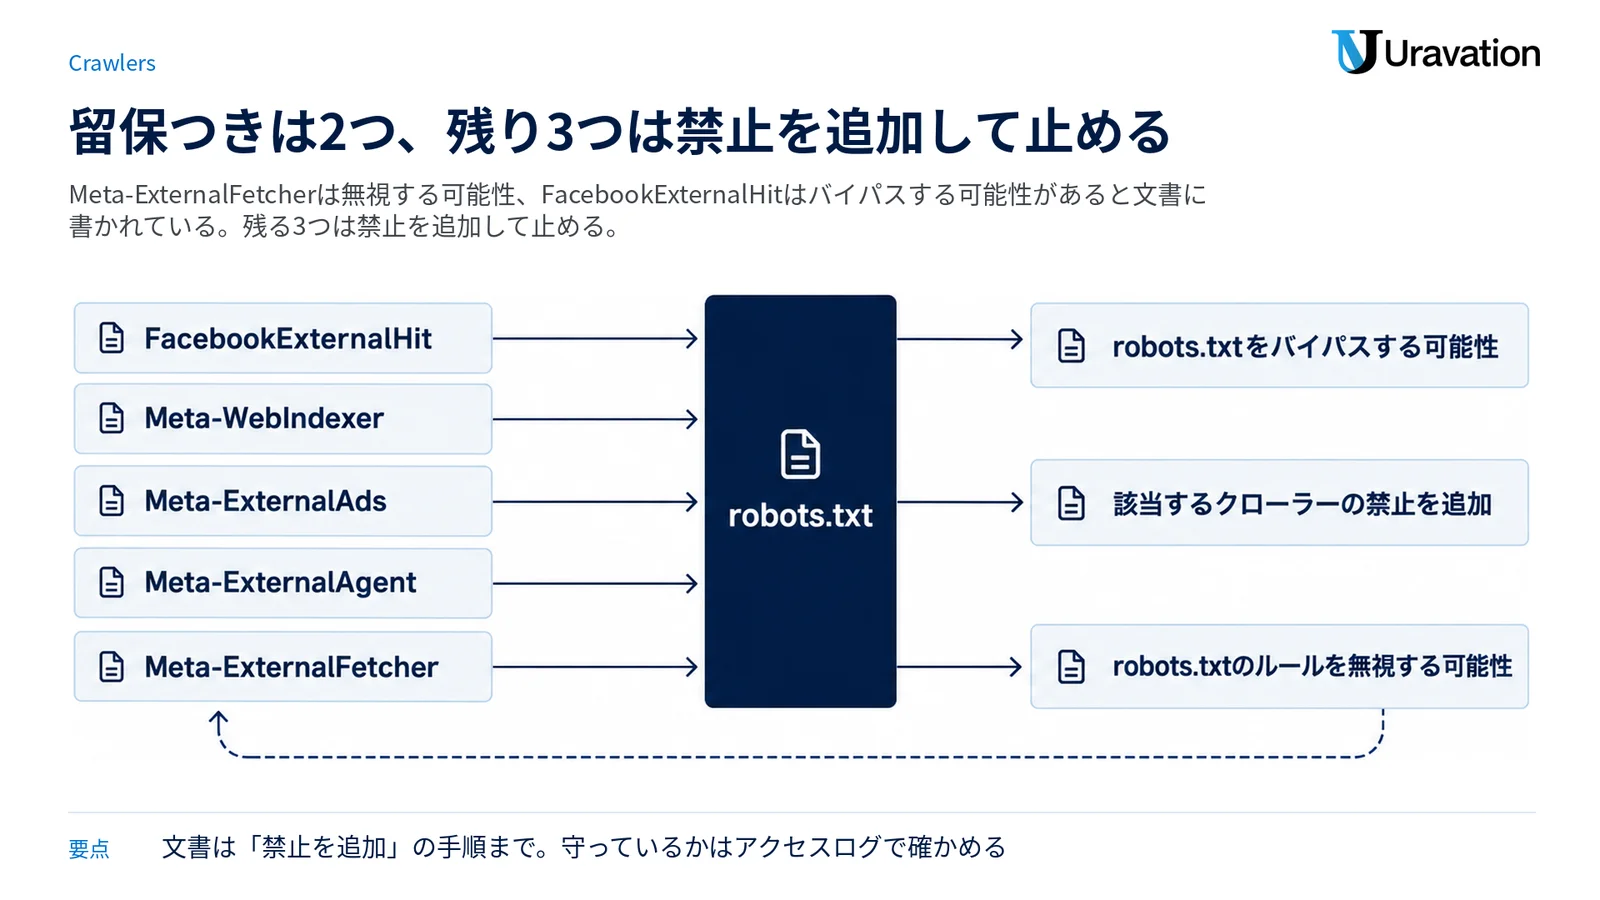
文書は「これらのクローラーをブロックするには、robots.txtに該当するクローラーの禁止を追加します」と書き、例としてmeta-externalagentとmeta-externaladsの2つのグループを載せています。Meta-WebIndexerのグループは例に出てきませんが、「robots.txtファイルでMeta-WebIndexerを許可すると」という文があるので、同じ形で書けると読めます。
5つのうち、robots.txtを守らないことがあると文書自身が書いているのは、Meta-ExternalFetcher(robots.txtのルールを無視する可能性がある)とFacebookExternalHit(セキュリティまたは整合性のチェックの時にrobots.txtをバイパスする可能性がある)の2つです。残りの3つについて、文書は「robots.txtファイルを構成することで、Meta Webクローラーが自分のサイトとどのようにやり取りするかを指定できます」と書き、「禁止を追加」して止める手順を示しています。クローラーごとに守ると書いた文はありません。実際に守っているかは、後述のアクセスログで確かめます。
文書の中に、クローラーのIPアドレスの一覧や、来訪がMetaの物かをIPで確かめる手順は見当たりませんでした。FacebookExternalHitの節に「クローラーが使用するユーザーエージェント文字列またはIPアドレス(IPアドレスのほうが安全です)のいずれかを許可リストに追加してください」とあるだけで、そのIPアドレスを載せた別の公式の文書は、2026年11月5日時点で確かめられませんでした。
他社のクローラーの分け方との比較
OpenAI・Anthropic・Perplexityも、公式の文書で用途ごとにクローラーを分けています。OpenAIはOAI-SearchBot(検索)・ChatGPT-User(利用者の操作に応じた訪問)・GPTBot(基盤モデルの学習)、AnthropicはClaudeBot(学習に使う可能性のあるウェブの収集)・Claude-User(利用者の質問に応じた取得)・Claude-SearchBot(検索結果の品質向上)、PerplexityはPerplexityBot(検索結果への表示とリンク)・Perplexity-User(利用者の質問に応じた訪問)です。OpenAIはChatGPT-Userについて利用者が始めた操作なのでrobots.txtのルールが適用されないことがあると書き、PerplexityはPerplexity-Userについて利用者が取得を求めたので一般にrobots.txtのルールを無視すると書いていて、Meta-ExternalFetcherの位置づけと同じ考え方です。
違いは「止めた時の影響」の書き方です。OpenAIはOAI-SearchBotを拒否したサイトはChatGPTの検索の回答には表示されない(ナビゲーション用のリンクとしては出ることがある)と書き、AnthropicはClaude-SearchBotを無効にすると検索結果での見え方と正確さが下がることがあると書いています。Metaの文書は、Meta-WebIndexerを許可すると引用やリンクが「可能になります」とだけ書いていて、止めた時の影響は書いていません。各社の設定例と判断の基準はrobots.txtでAIクローラーを許可すべきかに、Anthropicの3つのクローラーの扱いはClaudeに情報ソースとして引用されるにはにまとめています。
3サイトのアクセスログで数えたMetaのクローラーの来訪回数
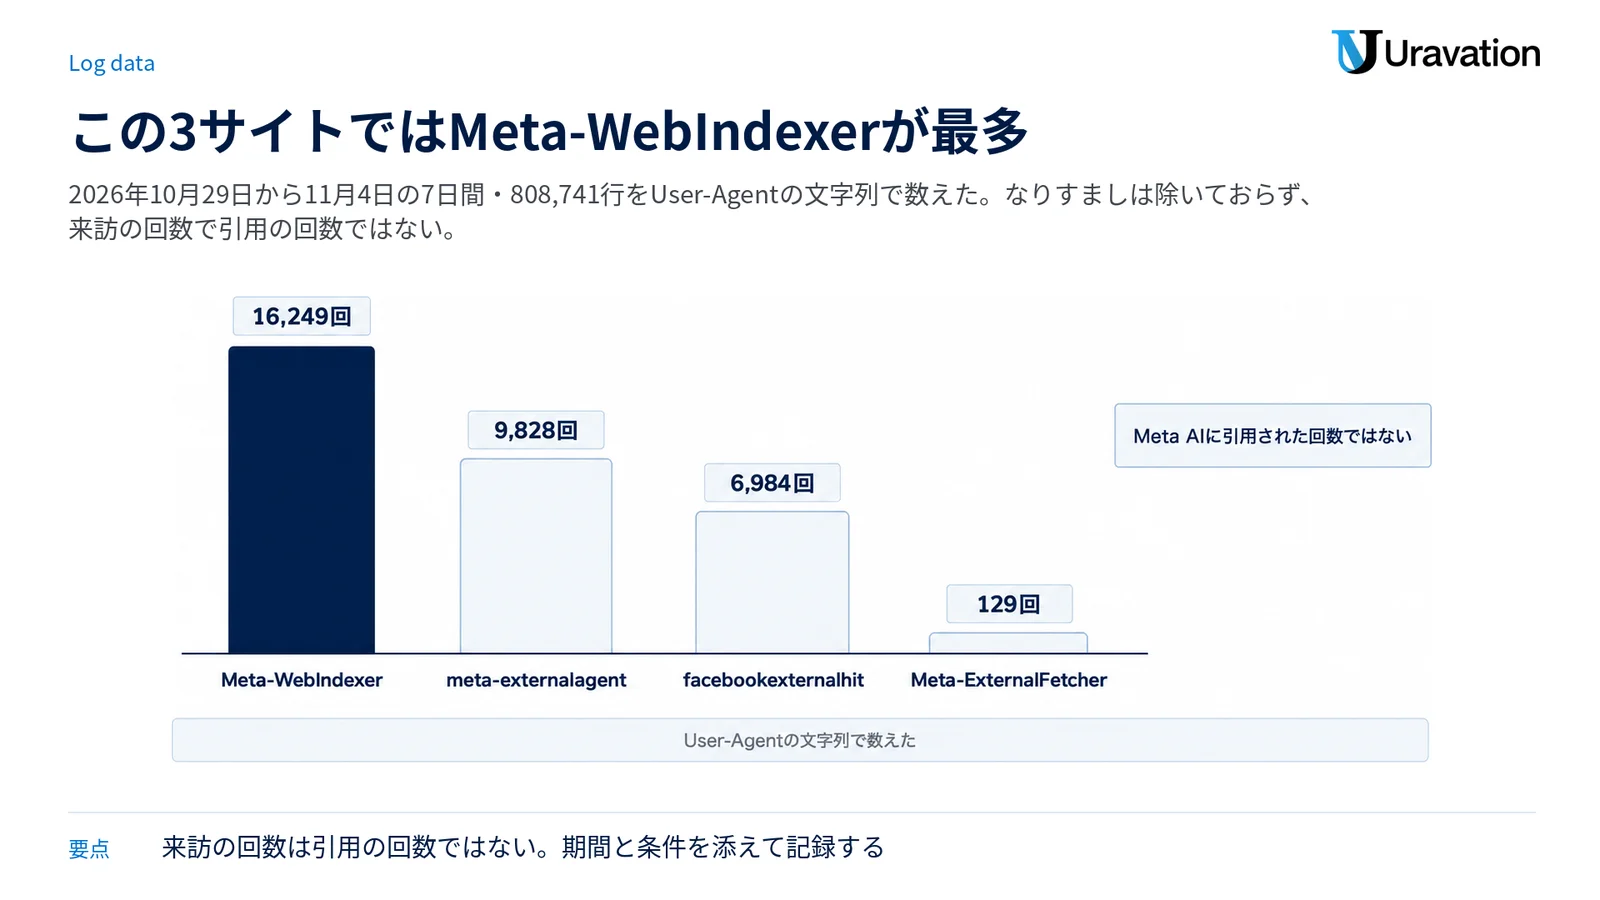
Uravationが運用する3サイトのアクセスログを、2026年10月29日0時から11月5日0時までの7日間(日本時間)について数えました。対象は計808,741行で、User-Agentの文字列に各クローラーの名前が含まれる行を数えています。サイトの名前・サーバーの名前・IPアドレスは書きません。数え方の条件は次の3つです。
- User-Agentの文字列で数えただけで、なりすましは除いていない。Metaの文書にIPアドレスの一覧が見当たらないため、Metaの公式のIPで確かめたわけではない
- 回数は来訪(リクエスト)の回数で、Meta AIに引用された回数ではない
- この3サイト・この7日間の数字で、ほかのサイトや期間に当てはめる物ではない
| No. | クローラー(User-Agentの文字列) | 提供元 | 7日間の回数 |
|---|---|---|---|
| 1 | Meta-WebIndexer | Meta | 16,249 |
| 2 | meta-externalagent | Meta | 9,828 |
| 3 | facebookexternalhit | Meta | 6,984 |
| 4 | Meta-ExternalFetcher | Meta | 129 |
| 5 | Meta-ExternalAds | Meta | 0 |
| 6 | OAI-SearchBot | OpenAI | 7,064 |
| 7 | ChatGPT-User | OpenAI | 2,373 |
| 8 | GPTBot | OpenAI | 510 |
| 9 | Claude-User | Anthropic | 8,028 |
| 10 | ClaudeBot | Anthropic | 2,695 |
| 11 | PerplexityBot | Perplexity | 6,704 |
この表の範囲では、11行の中で最も多かったのはMeta-WebIndexerの16,249回でした。Metaの5つを足すと33,190回で、808,741行の約4.1%にあたります。meta-externalagentは9,828回で、同じ7日間のGPTBot(510回)やClaudeBot(2,695回)より多く、学習用途を含むクローラーの中では最も多い行でした。Meta-ExternalFetcherは129回、Meta-ExternalAdsは0回です。facebookexternalhitの6,984回は、Metaのアプリでページが共有された時のタイトルや画像の取得に関わる来訪で、AIの回答とは別の用途です。
Meta-WebIndexerを名乗る来訪が多いことは、そのUA文字列が本物なら、Meta AIの検索結果の品質向上のためにこの3サイトのページが読まれていることまでは示します。回答で引用されたことは示しません。引用の確認は、ヘルプが示すMeta AIの回答の下の[ソース]で見るので、来訪の回数と引用の回数は分けて記録します。
学習は断り、引用は残す時のrobots.txtの書き方
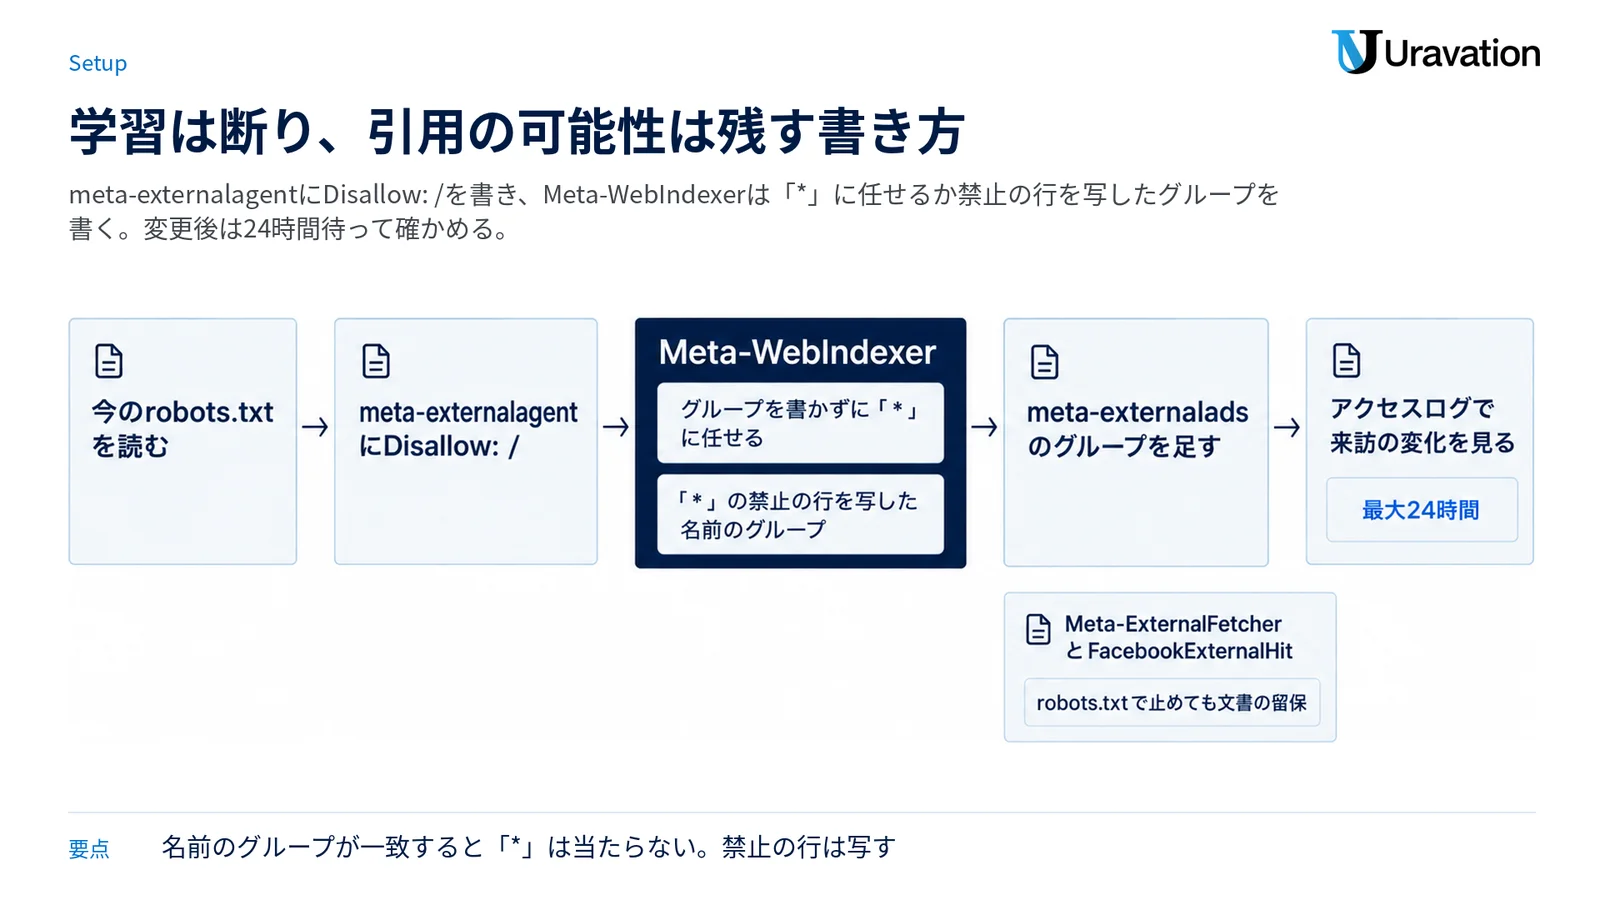
「基盤AIモデルのトレーニングには使わせたくないが、Meta AIの回答で引用やリンクが出る可能性は残したい」という希望は、Metaの文書の「robots.txtに該当するクローラーの禁止を追加します」に沿って書くと次の形になります。文書のrobots.txtの例に合わせて、User-agentの名前は小文字で書いています(文書の例は「Allow: /」と「Disallow: /private/」の組で、サイト全体の「Disallow: /」の例は載っていません)。
User-agent: meta-externalagent
Disallow: /
これだけで、meta-externalagentに対する「サイト全体の禁止」を表し、Meta-WebIndexerにはこのグループが当たりません。RFC 9309では、クローラーは自分の名前に一致するグループの規則に従い、一致するグループが無ければ「*」のグループに従います。Meta-WebIndexerの名前のグループを書かなければ、Meta-WebIndexerは「*」のグループの規則で動くので、「*」のグループに「Disallow: /」が無いことを確かめれば、引用やリンクが「可能になる」条件は保てます。
広告などの改善のための収集も断る場合は、文書の例にあるmeta-externaladsのグループを足します。
User-agent: meta-externalagent
Disallow: /

User-agent: meta-externalads
Disallow: /
Meta-WebIndexerを明示したい場合は、名前のグループを書きます。ここで注意が要るのは、RFC 9309の決まりでは、名前のグループが一致したクローラーには「*」のグループが適用されないことです。「*」のグループに管理画面などの禁止(文書の例では「/private/」)があるなら、同じ行をMeta-WebIndexerのグループにも写します。写し忘れると、Meta-WebIndexerだけがその場所を読めることになります。
User-agent: meta-webindexer
Disallow: /private/

User-agent: meta-externalagent
Disallow: /
書き換えた後の確認は2つです。1つ目は反映の時間で、文書は「robots.txtを変更して有効になるまで最大24時間かかります。クローラーがrobots.txtの内容を最大で24時間キャッシュする可能性があるからです」と書いています。RFC 9309も、クローラーはキャッシュしたrobots.txtを24時間より長く使うべきでないとしているので、変更の翌日にログを見ます。2つ目はrobots.txt自体の応答です。RFC 9309では、robots.txtがサーバーの障害などで取得できない(HTTPの500番台)時、クローラーはサイト全体が禁止されていると見なさなければならず(その状態が長く続く場合は、存在しない扱いにするか保存した写しを使い続けてよいとされています)、逆に存在しない(400番台)時は何でも読んでよいことになっています。robots.txtを置き換えた直後にブラウザで開き、200で中身が返ることを確かめます。
手順のまとめ
- 今のrobots.txtを読む。「*」のグループに「Disallow: /」が無いことと、管理画面などの禁止の行を確かめる
- meta-externalagentにDisallow: /を足す(基盤AIモデルのトレーニングや商品の改善のためのクロールへの意思表示)
- Meta-WebIndexerは、グループを書かずに「*」に任せるか、「*」の禁止の行を写した名前のグループを書く
- 広告の収集も断るなら、meta-externaladsのグループを足す
- Meta-ExternalFetcherとFacebookExternalHitは、robots.txtで止めても文書の留保(無視する可能性・バイパスする可能性)が残ると知っておく
- 変更後にrobots.txtが200で返ることを確かめ、最大24時間たってからアクセスログで来訪の変化を見る
AI学習の共通の信号とMeta
2026年10月30日に、OpenAIはrobots.txtの中の共通のシグナルを尊重する方針を、GoogleはAIトレーニングの設定を複数のAIプロバイダに1つのステップで伝える「共有AIトレーニングコントロール」をrobots.txtでサポートする計画を、それぞれ発表しました。どちらもIETFのAIPREFワーキンググループの取り組みに基づく物で、同じ日に公開されたIETFの個人草案は「__usage_ai-training」というポリシートークンをUser-agentの行に書く形を示しています。OpenAIは「今後数か月以内」の実装を目指すとし、Googleは「2027年に他のAIプロバイダとともに」サポートすることを目指すとしています。Anthropicも、Claudeのヘルプセンターで、同じ2026年10月30日からウェブサイトの所有者が学習の可否の希望を示す機械可読な信号の認識を始め、全サービスへ順次広げると書いています。
Metaがこの信号を自社のクローラーで尊重するかどうかは、2026年11月5日時点でMetaの公式の文書からは確かめられませんでした。IETFの草案の謝辞の一覧にはMetaに所属する人の名前が2人載っていますが、これは議論に加わった人の一覧で、Metaの対応の表明ではありません。Metaのクローラーに学習の意思を伝える方法として今の時点で文書に書かれているのは、meta-externalagentのグループにDisallowを書くことです。共通の信号の書き方と各社の対応時期は別の記事で整理しています。共通の信号を書く場合も、meta-externalagentのグループは残しておきます。草案自身も、「User-Agent: *」のグループをポリシートークンに一致する物として解釈してはならないと書いているので、「*」に「Disallow: /」を書いても、共通の信号としての学習の意思表示にはなりません。
Metaのクローラーを全部止めた時に何が起きるか
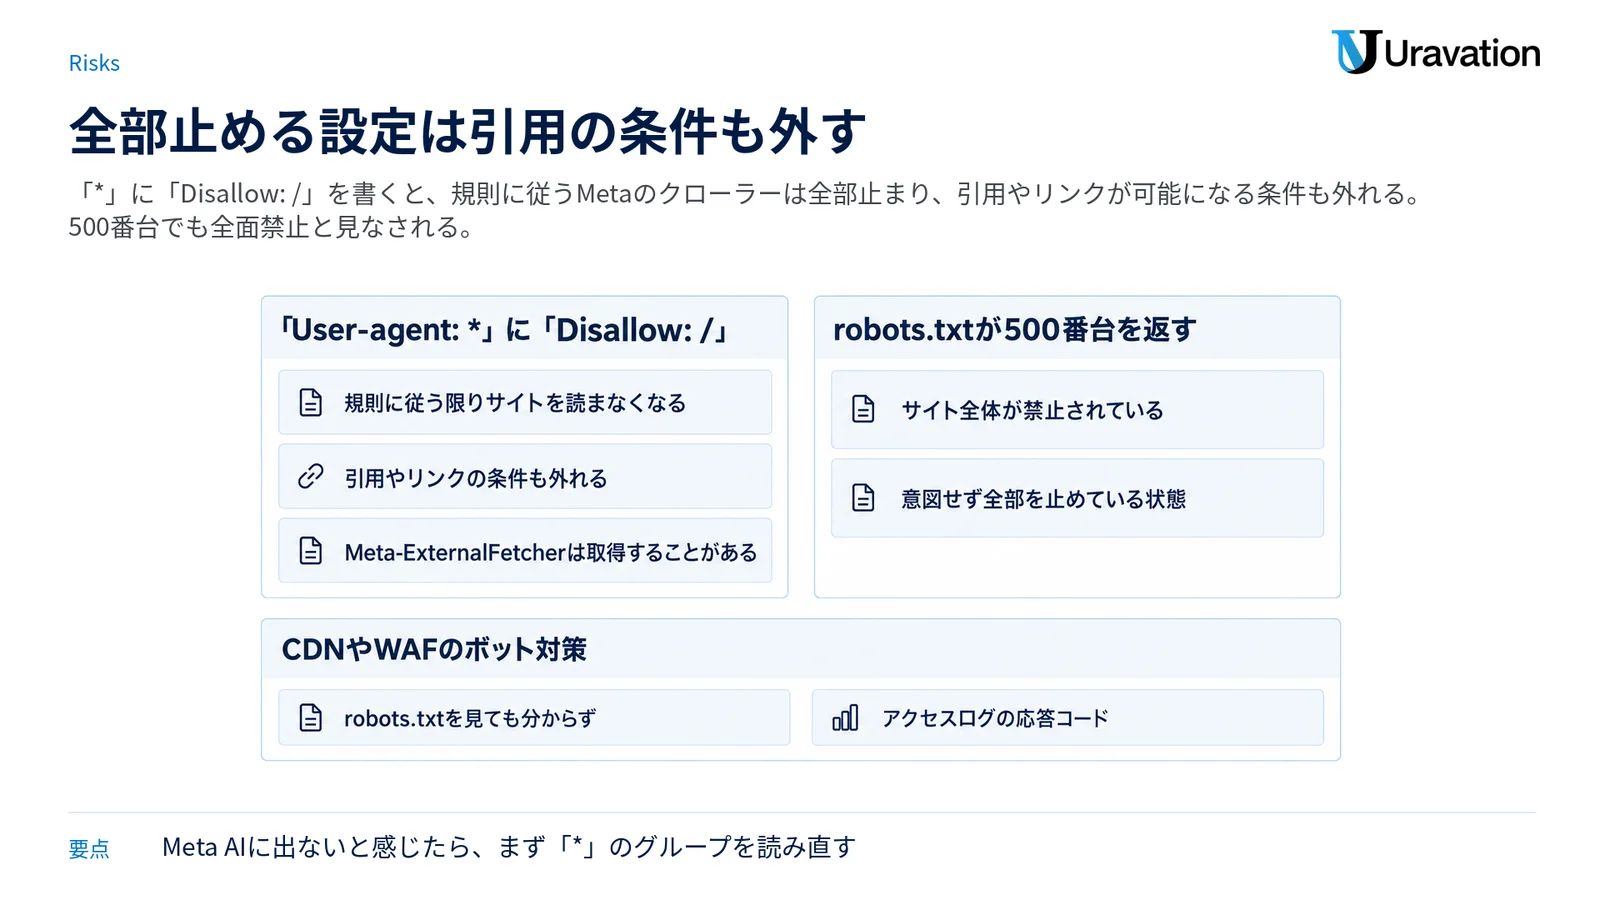
「AIのクローラーは全部止める」と決めた時に、Metaの文書とRFC 9309から言えることを並べます。
| No. | 止め方 | 文書とRFC 9309から言えること | 言えないこと |
|---|---|---|---|
| 1 | 「User-agent: *」に「Disallow: /」を書く | 名前のグループが無いクローラーは「*」に従うので、meta-externalagent・meta-externalads・Meta-WebIndexerの3つは、規則に従う限りサイトを読まなくなる。Meta-WebIndexerを許可した時に「可能になる」とされる引用やリンクの条件も外れる | Meta-ExternalFetcherとFacebookExternalHitは、文書の留保のとおり取得することがある |
| 2 | meta-externalagentだけを「Disallow: /」にする | 基盤AIモデルのトレーニングや商品の改善のためのクロールへの意思表示になる。Meta-WebIndexerには影響しない | 過去に収集された内容がどう扱われるかは文書に記述がなく、この記事では確かめられなかった |
| 3 | Meta-WebIndexerを「Disallow: /」にする | 許可した時に「可能になる」とされる引用やリンクの条件を自分で外すことになる | 止めた後にMeta AIの回答にどう出るか(出なくなるのか・古い内容が残るのか)は文書に記述がなく、確かめられなかった |
| 4 | Meta-ExternalFetcherを「Disallow: /」にする | 文書は「ユーザーのリクエストでフェッチを実行するため、robots.txtをバイパスする可能性があります」と書いている | robots.txtだけで確実に止まるとは言えない |
| 5 | FacebookExternalHitを「Disallow: /」にする | 文書は、セキュリティまたは整合性のチェックの時にrobots.txtをバイパスする可能性があると書いている。このクローラーはMetaのアプリで共有された時のタイトル・説明・サムネイル画像の収集と表示に関わる | 止めた時に共有のプレビューがどう表示されるかは文書に直接の記述がなく、確かめられなかった |
| 6 | robots.txtが500番台を返す | RFC 9309では、クローラーはサイト全体が禁止されていると見なさなければならない(長く続く場合は、存在しない扱いにするか保存した写しを使い続けてよい)。意図せず全部を止めている状態 | どのクローラーがこの決まりどおりに動くかは、各社の文書と自社のログで確かめる |
全部止める判断で見落とされやすいのは1番目です。「*」に「Disallow: /」を書いたサイトは、検索エンジンだけでなく、規則に従うMetaのクローラーも全部止めています。Meta AIの回答に自社のページが出てこないと感じた時は、まずrobots.txtの「*」のグループを読み直します。全部止めた後も、Meta-ExternalFetcherは取得することがあるという文書の留保は残ります。
robots.txtとは別に、CDNやWAFのボット対策がクローラーを止めていることもあります。robots.txtで許可していてもサーバーが403などを返していれば、クローラーはページを読めません。この状態はrobots.txtを見ても分からず、アクセスログの応答コードとCDN・WAFの設定で確かめます。
アクセスログでMetaのクローラーの来訪を確かめる手順
Metaのクローラーの来訪は、アクセスログのUser-Agentの欄で数えます。手順の全体(ログの場所・grepの書き方・なりすましの見分け方・robots.txtの検証)はAIクローラーのログ確認方法にまとめているので、ここではMetaの5つに絞った例だけ書きます。ログの形式はサーバーごとに違うので、列の番号は自分のログに合わせて直します。
手順1: 5つの名前を1つずつ数えます。文書のUA文字列は小文字なので、大文字小文字を区別しない「-i」を付けます。
grep -ic "meta-webindexer" access.loggrep -ic "meta-externalagent" access.loggrep -ic "meta-externalfetcher" access.loggrep -ic "meta-externalads" access.loggrep -ic "facebookexternalhit" access.log
手順2: 応答コードごとに数えます。nginxやApacheの既定のcombined形式では、応答コードは9列目です。403や5xxが多ければ、robots.txtとは別の所で止めている可能性があります。
grep -iE "meta-webindexer|meta-externalagent|meta-externalfetcher|meta-externalads|facebookexternalhit" access.log | awk '{print $9}' | sort | uniq -c
手順3: robots.txtにDisallowを書いた後は、そのクローラーがrobots.txt以外のパスを取得していないかを見ます。規則に従っているなら、残るのはrobots.txtの取得だけになります。
grep -i "meta-externalagent" access.log | grep -v "/robots.txt"
手順4: 来訪の記録を月ごとに残します。この記事の表のように「期間・行数・クローラーごとの回数・数え方の条件」を一緒に書いておくと、robots.txtを変えた前後の比較ができます。
UA文字列はだれでも名乗れるので、ログの数字は「その名前を名乗る来訪の回数」です。Metaの文書にはIPアドレスの一覧が見当たらないため、OpenAIやPerplexityのように公開されたIPの範囲と突き合わせる確認は、2026年11月5日時点ではできませんでした。WAFなどでUA文字列を条件に止める場合は、本物となりすましの両方が止まります。
引用されるためにページ側でできること(他のAIと共通・保証はない)
Metaの文書には、Meta-WebIndexer向けにページをどう整えるかの案内はありません。文書に書かれているページ側の要件はFacebookExternalHit向けの物で、サーバーがgzipとdeflateのエンコーディングを使うこと、Open Graphのプロパティをページの最初の1MBより前に書くこと、クローラーが数秒以内にコンテンツをクロールできること、Rangeヘッダーに従った応答を返すか無視すること、クローラーのUA文字列かIPアドレスを許可リストに入れることの5つです。Meta-WebIndexerに同じ要件が当てはまるかは文書に書かれていませんが、速く返す・主要な情報をHTMLの前の方に置く、という2点は、どのクローラーにも共通して損のない整え方です。
Meta AIに引用されるための固有の条件は、文書では「robots.txtファイルでMeta-WebIndexerを許可する」こと以外に示されていません。ほかのAI検索で引用されるための整え方(一次情報を自分のページに置く、質問にそのまま答える定義文を置く、更新日と著者を明示する)は、Perplexityに引用されるにはとClaudeに情報ソースとして引用されるにはで整理した内容と共通で、Meta AIでも同じ整え方をした上で、結果はMeta AIの回答で確かめます。これらの整え方は引用を保証する物ではありません。
確かめ方は、Meta AIに自社に関わる質問をして、回答の下の[ソース]に自社のページが出るかを見ることです。Metaのヘルプは、Meta AIアプリ・バイブスアプリ・ウェブサイトは「地域によってはまだご利用いただけない場合があります」と注記しているので、日本で使える画面と機能の範囲は、確かめる時点のヘルプで見ます。定点観測の組み方(質問の集合・記録の形・頻度)はAI回答に引用されているかをモニタリングする方法と同じで、Meta AIを観測先に1つ足す形で運用できます。
Metaが2026年10月23日に日本で提供を始めたパーソナルAIエージェント「Muse」については、Metaの日本語のニュースルームの発表に、ウェブ検索や回答の情報源についての記述はありませんでした。Metaのクローラーの文書は「Meta AI」と書いています。Museのアプリの答えに同じ仕組みが使われるかは、この記事の時点で確かめられなかったので、Museでの見え方を目的にrobots.txtを書き換える判断はしないでおきます。
よくある質問
meta-externalagentを拒否すると、Meta AIの回答に出なくなりますか?
Metaの文書の上では、別の話です。meta-externalagentは「基盤AIモデルのトレーニングや商品の改善などのユースケース」でクロールするクローラーで、Meta AIの回答での引用やリンクについて文書が「可能になります」と書いているのはMeta-WebIndexerを許可した時です。meta-externalagentにDisallowを書いても、Meta-WebIndexerのグループを別に禁止していなければ、「可能になる」条件は保てます。ただし文書は引用を保証していないので、「出なくならない」とも「出る」とも言い切れません。
Meta-WebIndexerを許可すれば、Meta AIに引用されますか?
文書が書いているのは「robots.txtファイルでMeta-WebIndexerを許可すると、Meta AIの回答でのコンテンツの引用やリンクが可能になります」までです。許可は引用の条件の1つで、引用そのものを約束する物ではありません。許可した上で、Meta AIの回答の下の[ソース]に自社のページが出るかを、自分の質問で確かめます。
Meta-ExternalFetcherはrobots.txtで止められますか?
文書は「このクローラーはrobots.txtのルールを無視する可能性があります」と書いています。ユーザーのリクエストに応じて個々のリンクを取得するクローラーなので、robots.txtのDisallowは効かないことがあると考えて扱います。それでも止めたい場合はサーバーやWAFでUA文字列を条件に止めることになりますが、その場合は本物となりすましの両方が止まり、利用者の求めに応じた取得も止まります。
Museの回答にも、Meta-WebIndexerで集めた内容が使われますか?
確かめられませんでした。Metaのクローラーの文書は「Meta AI」と書いていて、2026年10月23日のMuseの日本での提供開始の発表には、ウェブ検索や回答の情報源についての記述がありません。Museのアプリの答えに同じ仕組みが使われるかは、この記事の時点で確かめられなかったので、本文では「Meta AI」の範囲でだけ書いています。
AI学習の共通の信号を書けば、Metaのクローラーにも効きますか?
2026年11月5日時点で、Metaが共通の信号を尊重すると公式に表明したかは確かめられませんでした。共通の信号への対応を表明している例は、OpenAI(2026年10月30日・今後数か月以内の実装を目指す)・Google(同日・2027年のサポートを目指す)・Anthropic(同日から信号の認識を始め、全サービスへ順次広げるとヘルプに記載)です。Metaのクローラーに学習の意思を伝える方法として文書に書かれているのは、meta-externalagentのグループにDisallowを書くことなので、共通の信号を書く場合も、このグループは残しておきます。
最後に確認すべきこと
Metaのクローラーについて、robots.txtを触る前と後に確かめる項目を並べます。
| No. | 確認する項目 | 見る場所 |
|---|---|---|
| 1 | アクセスログにmeta-externalagent・meta-webindexer・meta-externalfetcher・meta-externalads・facebookexternalhitが来ているか、それぞれ何回か | アクセスログ(grep) |
| 2 | 「*」のグループに「Disallow: /」が無いか。あるなら、Meta-WebIndexerを含む規則に従うクローラーを全部止めている | robots.txt |
| 3 | 学習を断るなら、meta-externalagentのグループに「Disallow: /」があるか | robots.txt |
| 4 | Meta-WebIndexerの名前のグループを書いた場合、「*」の禁止の行を写しているか | robots.txt |
| 5 | robots.txtが200で返り、中身が最新か(500番台なら全面禁止と見なされる) | ブラウザ・curl |
| 6 | 変更から24時間以上たった後のログで、Disallowしたクローラーの取得がrobots.txtだけになっているか | アクセスログ |
| 7 | CDNやWAFがMetaのクローラーに403などを返していないか | アクセスログの応答コード・CDNの設定 |
| 8 | Meta AIの回答の下の[ソース]に自社のページが出るか(来訪の回数とは別に記録する) | Meta AIの画面 |
| 9 | Metaの文書の更新日が2026年5月21日から変わっていないか | Meta Webクローラーの文書 |
robots.txt・CDN・WAFの設定が複数の担当者にまたがっていて、どのクローラーをどこで止めているか分からなくなっている場合は、LLMO診断やAI検索診断で、クローラーの到達とAIの回答での見え方を切り分けて点検する方法もあります。診断はMeta AIの回答への掲載を保証する物ではなく、設定と見え方の食い違いを整理する入口です。
参考・出典
- Meta Webクローラー(Meta for Developers・更新日 2026年5月21日) — 5つのクローラーのUA文字列と用途、robots.txtの例、24時間の反映、Meta-ExternalFetcherとFacebookExternalHitの留保。2026年11月5日参照
- RFC 9309: Robots Exclusion Protocol(IETF) — product tokenの大文字小文字を区別しない照合、「*」のグループの扱い、キャッシュの24時間、robots.txtが取得できない時の扱い。2026年11月5日参照
- Meta AIの回答に使用された情報源やリンクを報告する(Metaヘルプセンター) — 回答の下の[ソース]。2026年11月5日参照
- Meta AIとのシークレットチャットでウェブ検索のオンとオフを切り替える(Metaヘルプセンター) — 検索クエリを一部の検索エンジンに送信する旨、地域による提供の注記。2026年11月5日参照
- About Meta AI(WhatsAppヘルプセンター) — Meta AIがインターネット上の情報源やリンクを回答の参考に使うことがある旨。2026年11月5日参照
- Meta、パーソナルAIエージェント「Muse」を日本で提供開始(Metaニュースルーム・2026年10月23日) — 日本での提供開始。ウェブ検索や情報源の記述は無い。2026年11月5日参照
- Meta AIは思考するだけでなく、行動するAI(Metaニュースルーム・2026年7月29日) — Meta AIアプリとmeta.aiの基盤モデル、日本で未提供の機能がある旨。2026年11月5日参照
- AI 学習への利用意向をウェブサイトが伝えやすくする仕組み(OpenAI・2026年10月30日) — robots.txtの共通のシグナルを尊重する方針。2026年11月5日参照
- ウェブサイト向けの共有 AI トレーニング コントロールのサポート(Google Search Central Blog・2026年10月30日) — 共有のポリシートークン、2027年のサポートの目標。2026年11月5日参照
- Machine-Readable Training Preference Signal(IETF Internet-Draft draft-kelley-aipref-training-preference-signal-00・2026年10月30日) — 「__usage_ai-training」のポリシートークン、「*」を一致と解釈しない旨、謝辞の一覧。2026年11月5日参照
- Overview of OpenAI Crawlers(OpenAI) — OAI-SearchBot・ChatGPT-User・GPTBotの用途と、拒否した時の扱い。2026年11月5日参照
- Does Anthropic crawl data from the web, and how can site owners block the crawler?(Claude Help Center) — ClaudeBot・Claude-User・Claude-SearchBotの用途と、無効にした時の扱い、2026年10月30日からの共通の信号の認識。2026年11月5日参照
- Perplexity Crawlers(Perplexity) — PerplexityBot・Perplexity-Userの用途、公開されたIPアドレス。2026年11月5日参照
※ いずれも2026年11月5日に確認した一次情報です。クローラーの仕様とrobots.txtの扱いは変わるため、最新の内容は各公式ページで確認してください。アクセスログの数字はUravationが運用する3サイトの2026年10月29日から11月4日までの7日間の物で、User-Agentの文字列で数えた来訪の回数です。
公式情報で確認するポイント
AI検索まわりは仕様変更が多いため、記事公開前後に公式情報を確認し、本文の言い切りや実装方針を更新します。
- Google Search Central「Optimizing your website for generative AI features」 生成AI検索に対して、通常のSEO・技術要件・独自性の扱いを確認する公式ガイド。
- Google Search Central「Creating helpful, reliable, people-first content」 人間に役立つ信頼性の高いコンテンツを評価するための公式観点。
本体メディアであわせて確認する記事
この記事のテーマを、Uravation本体メディアで検索流入のあるAIツール・モデル解説にもつなげて確認できます。
AI活用書籍シリーズ累計66,000部の著者チームが監修。自社7メディアの実運用でAI検索からの引用・流入を継続計測しており、その一次データと公式情報に基づいて、企業サイトで実務的に使える形へ整理しています。仕様変更が多い領域のため、公開前後に公式情報と本文の整合性を確認します。
AI検索診断・情報源設計支援に進める
この記事のテーマを自社サイトに当てはめ、公開情報、根拠ページ、FAQ、内部リンク、構造化データ、llms.txtのどこを確認すべきかを整理します。
AI検索攻略の前後の記事
同じ連載の前後の記事へ進み、LLMO、AIO、GEO、AI検索の論点を順番に確認できます。
関連するUravationの導線
AI検索攻略は、Uravation本体のAI活用メディアとサービス導線につながる専門テーマとして運用します。