パンくずリストとURL階層をAI検索の観点で設計する手順。BreadcrumbListの実装、可視パンくずとの一致、階層が壊れる5パターン、点検7手順を公式情報ベースで整理します。
- パンくずリスト サイト構造 ai検索 llmoの定義、実務判断、確認項目をAI検索時代の情報源設計として整理する。
- 公式情報と一次情報を優先し、表示保証や順位改善の断定を避ける。
- 本文、FAQ、内部リンク、llms.txt、構造化データの整合性を継続確認する。
実務で見る観点
各AI検索サービスのクローラー名とrobots.txtでの扱いを公式情報で確認する。
サービス内容、料金、対象者、事例、会社情報を正規ページに集約して矛盾を減らす。
外部メディア、SNS、比較サイトに出ている説明と自社サイトの記述がずれていないか見る。
パンくずリストを整えるとAI検索に引用されやすくなるのか。2026年9月時点の答えは「AI検索向けの専用シグナルとしては効かない。ただしAIが参照する土台であるクロール・インデックス・カテゴリ判定には公式に効くと明記されている」です。
根拠は2つあります。ひとつは、Googleがパンくずの構造化データについて「Google Search uses breadcrumb markup in the body of a web page to categorize the information from the page in search results(Googleはページ本文中のパンくずマークアップを、検索結果でそのページの情報を分類するために使う)」と明記していること。もうひとつは、生成AI機能について「Structured data isn't required for generative AI search, and there's no special schema.org markup you need to add(生成AI検索に構造化データは必須ではなく、追加すべき専用のschema.orgマークアップも存在しない)」と、2026年7月10日更新のドキュメントで明言していることです。
つまりパンくずリストは、AI検索の裏口ではありません。ページの座標(サイト内のどこにあるか)を、読者・Google・AIクローラーの3者に対して同じ形で言い切るための実装です。座標が定まっていないページは、AIに要約されたときに「何のカテゴリの、誰向けの情報か」が落ちます。
定義:AI検索文脈におけるパンくずリストとサイト構造 パンくずリストとは、あるページがサイト階層のどこに位置するかを、上位から順に並べたリンクの列である。schema.orgでは「A BreadcrumbList is an ItemList consisting of a chain of linked Web pages, typically described using at least their URL and their name, and typically ending with the current page(BreadcrumbListとは、URLと名称で記述され、通常は現在のページで終わる、リンクされたWebページの連鎖からなるItemListである)」と定義される。AI検索対策としてのサイト構造設計とは、この位置情報を「可視パンくず」「URL階層」「内部リンク」の3層で矛盾なく表現し、クローラーが巡回経路とカテゴリを一意に再構成できる状態を保つ作業を指す。引用枠の購入や、AI専用ファイルの設置ではない。
このページは実装側の話に絞ります。構造化データ全般の考え方はAI検索時代の構造化データとは?実装の考え方、リンクの張り方そのものはLLMOで内部リンクはどう効くのかで扱っています。ここでは階層・URL・パンくずの3点に限定します。
パンくずリストが担う仕事は3つある。混ぜて評価しない
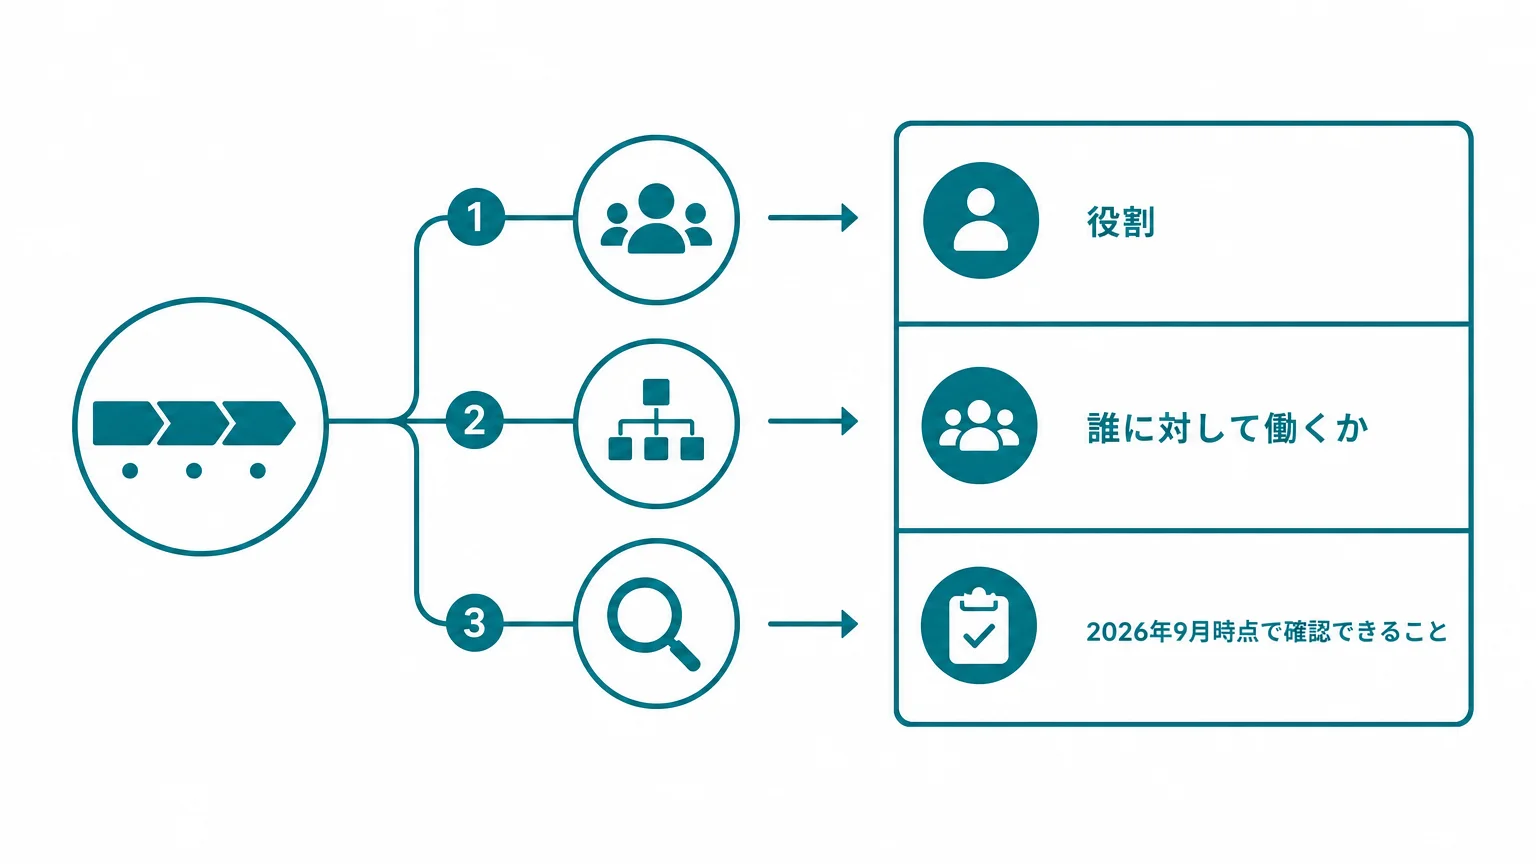
「パンくずはSEOに効くか」という問いが噛み合わないのは、3つの別々の仕事がひとまとめに語られるからです。効果を検証したいなら、まず分解します。
| 役割 | 誰に対して働くか | 2026年9月時点で確認できること |
|---|---|---|
| 現在地の提示 | サイト訪問者 | Googleは「a page's position in the site hierarchy(サイト階層内での位置)」を示し、サイトの理解と回遊を助けうると説明している |
| 情報の分類 | Google検索 | パンくずマークアップを検索結果でのページ情報の分類に使うと公式ドキュメントに明記されている |
| 巡回経路の提供 | Googlebot・AIクローラー | Googleは「新しく見つかるページの大多数はリンク経由」と説明しており、パンくずは上位階層への恒常的なリンクとして働く |
3番目が、AI検索の実務でいちばん軽視されています。パンくずは全ページに置かれる数少ない「上向きリンク」です。深い記事ページからカテゴリページ・トップへ戻る導線が全ページに存在するかどうかで、クローラーがサイトの骨格を再構成できるかが変わります。逆に言えば、パンくずを外したサイトでは、カテゴリページに向かうリンクがサイドバーやフッターにしか残らないことが多く、階層の輪郭がぼやけます。
一方で、装飾としての期待は捨ててください。Googleは2025年1月22日のドキュメント更新で、パンくずのリッチリザルト表示について「デスクトップの検索結果にのみ表示され、モバイルには表示されない」旨の feature availability セクションを追加しています。現在のドキュメントにも「This feature is available on desktop in all regions and languages where Google Search is available」と記載があります。検索結果の見た目で得をする施策としては、期待値を下げて設計するのが正確です。
「効く」と「効くかもしれない」を、一次情報で切り分ける
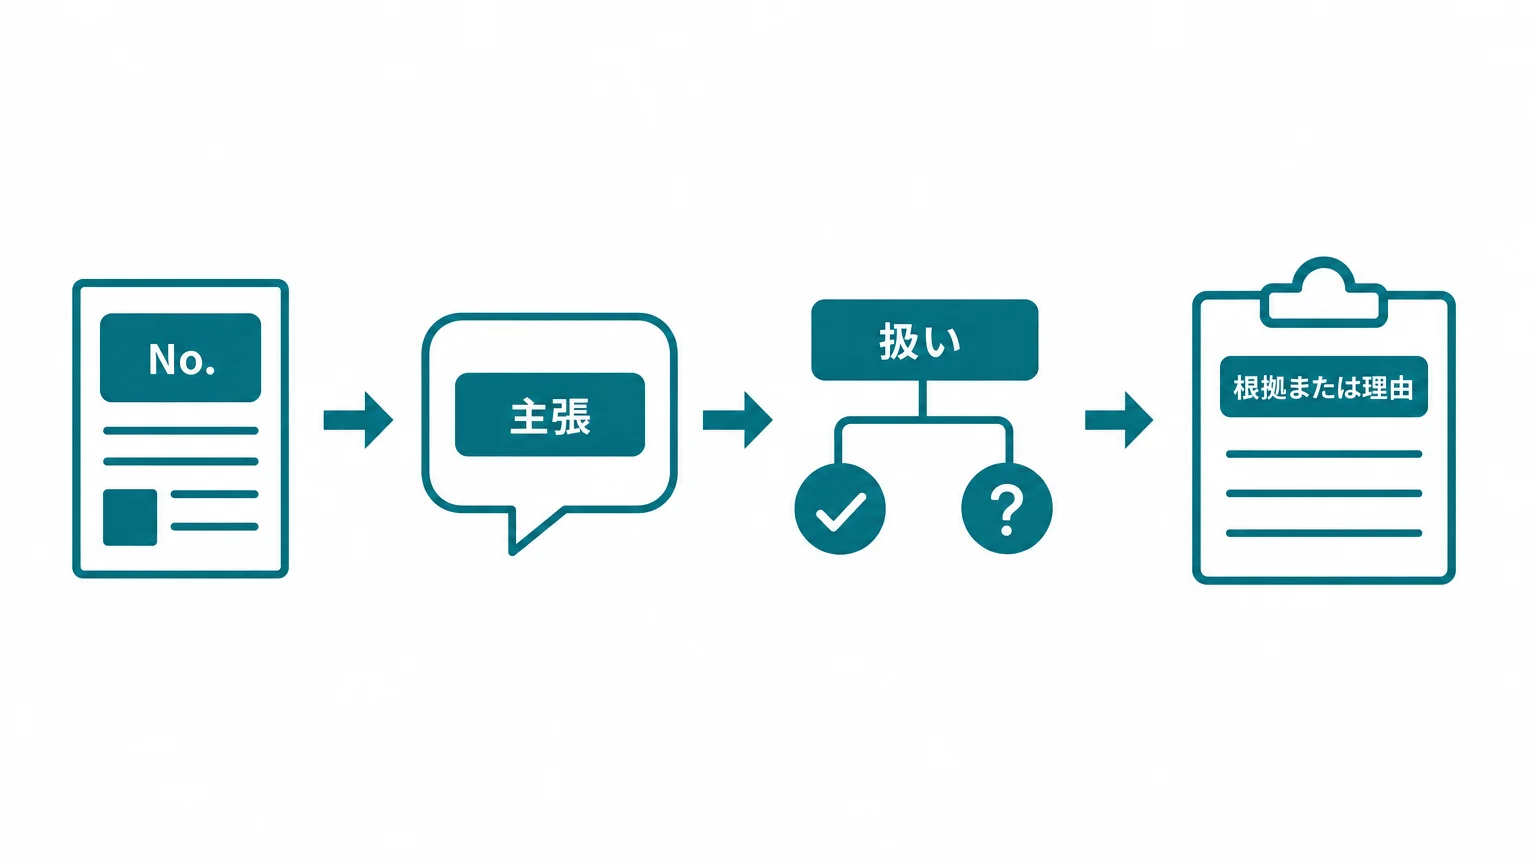
AI検索まわりの記事では「構造化データを入れればAIが階層を100%正確に理解する」といった書き方を見かけます。2026年9月時点で、その断定を裏づける公式資料は確認できていません。本稿では次のように切り分けます。
| No. | 主張 | 扱い | 根拠または理由 |
|---|---|---|---|
| 1 | パンくずマークアップは検索結果でのページ情報の分類に使われる | 確認済みの事実 | Googleのパンくず構造化データ公式ドキュメントの記載 |
| 2 | ディレクトリの分け方はクロール頻度の学習に影響しうる | 確認済みの事実 | SEOスターターガイドが「Google can learn this information and crawl the different directories at different frequencies」と説明 |
| 3 | 生成AI機能に出るためにAI専用マークアップは要らない | 確認済みの事実 | 「AI features and your website」および生成AI最適化ガイドの明記 |
| 4 | BreadcrumbListを入れるとAIの引用率が上がる | 未確認 | 2026年9月時点で、そう読める公式発表は確認できていない |
| 5 | 階層が整理されたサイトは、AIが文脈を取り違えにくい | 仮説 | Googleは生成AI機能が検索の基盤ランキングとクロール可能な公開情報に依存すると説明している。そこから導ける推測であり、直接の測定結果ではない |
Googleは2026年7月10日更新の生成AI最適化ガイドで「optimizing for generative AI search is optimizing for the search experience, and thus still SEO(生成AI検索への最適化は検索体験への最適化であり、つまり依然としてSEOである)」と書いています。AEO・GEOという新しい名前が付いても、やることは検索の技術要件を満たすことだ、という立場です。パンくずと階層設計は、その技術要件側の作業に入ります。
URL・パンくず・内部リンクの3層を一致させる
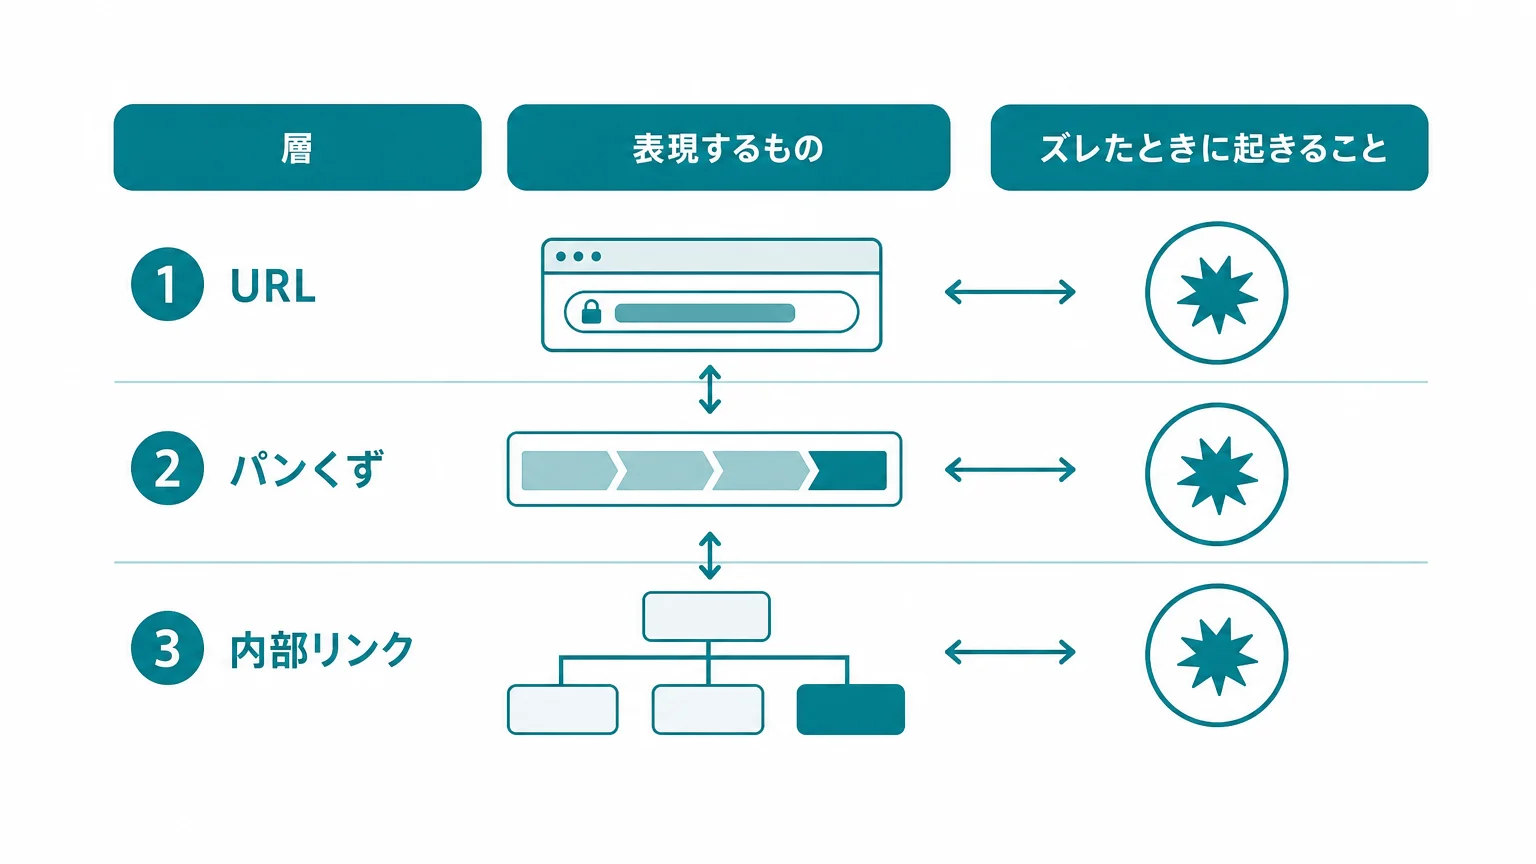
サイト構造は、実務では3つの層で表現されます。この3層がズレているサイトは、人が見ても機械が読んでも現在地が定まりません。
| 層 | 表現するもの | ズレたときに起きること |
|---|---|---|
| URL階層 | ファイルとしての所属先。1ページ1か所 | 正規URLが揺れ、同一内容が複数URLで拾われる |
| 可視パンくず | 読者がたどる典型的な経路。複数あってよい | 読者が現在地を誤認する。上位カテゴリへの導線が消える |
| 内部リンク | 意味的な関連。階層とは独立に張る | クロール経路が偏り、深い階層が発見されにくくなる |
ここで注意したいのが、「パンくず=URLの機械的コピー」にしないことです。Googleはパンくずのドキュメントで、URL構造をそのまま写すのではなく「breadcrumbs that represent a typical user path to a page(ページに至る典型的なユーザー経路を表すパンくず)」を提供することを推奨しています。
たとえばURLが /llmo/pankuzu-site-kouzou-ai-search/ のようにフラットでも、読者の典型経路が「ホーム > AI検索攻略 > 技術実装 > パンくずとサイト構造」であるなら、パンくずはその経路で組んで構いません。URLは一意性と安定性のため、パンくずは意味の伝達のため、と役割を分けます。
一方で、URL階層を「フラットにするか、ディレクトリで分けるか」は、クロールの観点で判断材料があります。SEOスターターガイドは、数千URLを超える規模ではコンテンツの整理の仕方がクロールとインデックスに影響しうるとし、/policies/ のように更新頻度の低いディレクトリと /promotions/ のように更新頻度の高いディレクトリを分ければ、Googleがその違いを学習して別々の頻度でクロールできると説明しています。更新サイクルが違うコンテンツ群は、ディレクトリで分けたほうが素直です。
URL階層の実装ルール7項目
ここからはコピペで使える判断基準にします。Googleの「URL structure best practices」に沿った項目と、階層設計上の実務項目を混ぜています。
| No. | ルール | 良い例 | 避ける例 |
|---|---|---|---|
| 1 | IDではなく読める語を使う | /llmo/pankuzu-site-kouzou-ai-search/ | /index.php?topic=42&area=3a5ebc |
| 2 | 語の区切りはハイフン。アンダースコアを使わない | /service/ai-search-audit/ | /service/ai_search_audit/ |
| 3 | 日本語URLを使うならUTF-8とパーセントエンコードを徹底する | href属性で必要な箇所を percent encoding する | 環境ごとに異なるエンコードが混在する |
| 4 | セッションIDや並び替えパラメータを階層に混ぜない | 正規URLは静的、絞り込みはパラメータで表現し正規化する | /category/?sort=new&sid=xxxx をそのままインデックス対象にする |
| 5 | 1ページの所属先ディレクトリは1つに固定する | /blog/llmo/xxx/ のみ | /blog/llmo/xxx/ と /tag/ai/xxx/ の両方で本文が出る |
| 6 | 末尾スラッシュ・www有無・httpsを1形式に統一する | 301で1形式へ寄せ、内部リンクも正規URLで書く | 内部リンクだけ旧形式が残り、リダイレクトを1回挟む |
| 7 | カテゴリ名を変えるときはURLを変えず、表示名だけ変える | スラッグは維持し、パンくず表示名を更新する | 年に数回URLごと変えて301を積み増す |
5番と6番は、正規化(canonical)の問題に直結します。Googleは正規URLの決定に使う信号を強さ順に説明しており、リダイレクトと rel="canonical" が強い信号、サイトマップは弱い信号、そして内部リンクについては「link to the canonical URL rather than a duplicate URL(重複URLではなく正規URLへリンクする)」と案内しています。パンくずは全ページに出る内部リンクなので、ここが旧URLのまま放置されると、サイト全体で弱い信号を打ち続けることになります。サイト移行時の注意点はサイトリニューアルでAI検索の評価を失わない移行チェックリストにまとめています。
可視パンくずとBreadcrumbListを一致させる
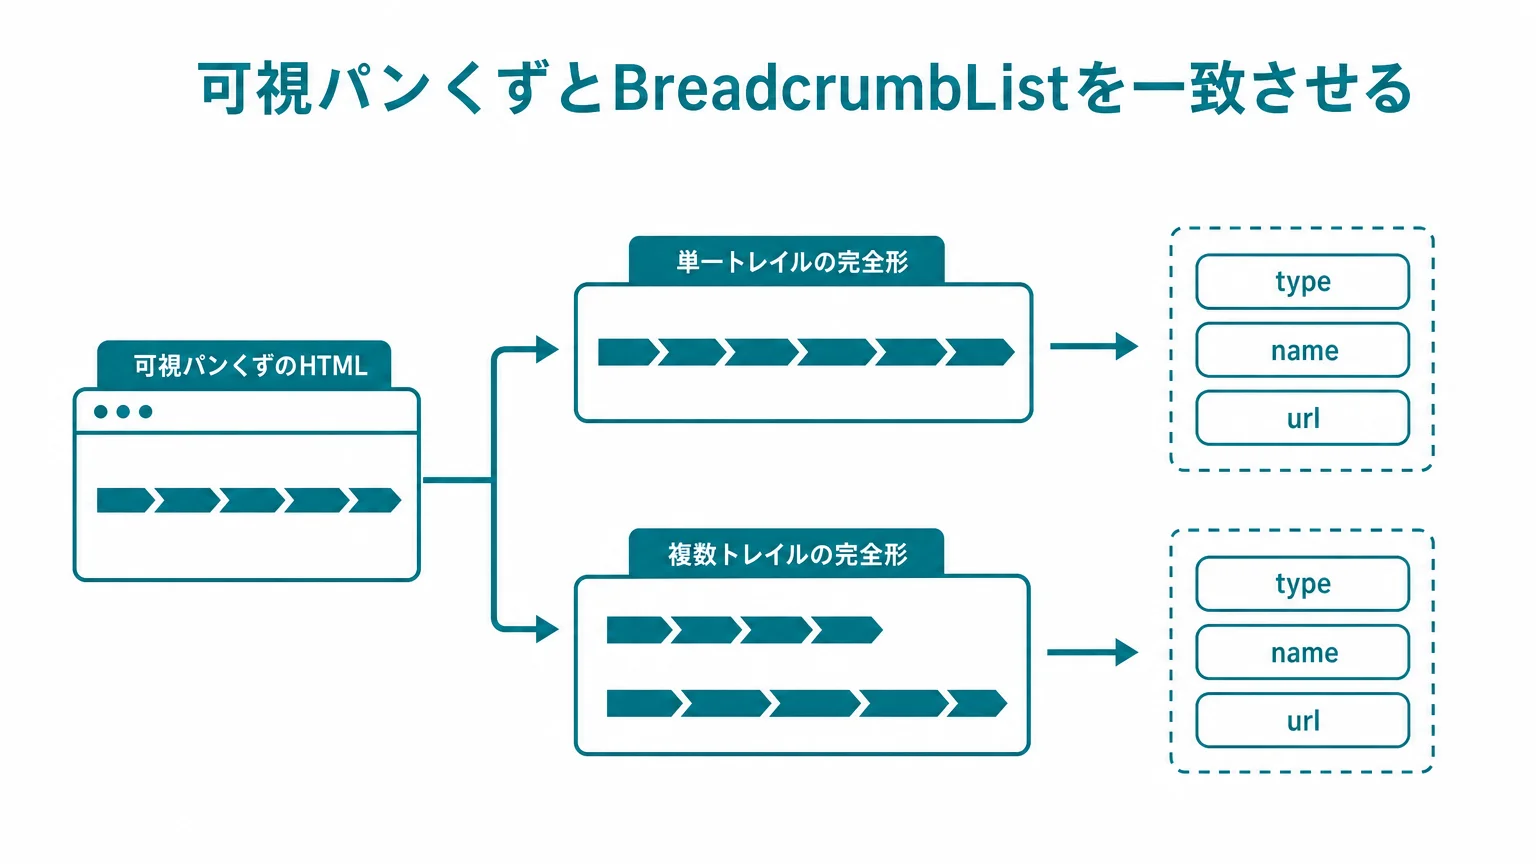
構造化データは、表示されている内容を正しく表すものである必要があります。パンくずも例外ではなく、画面に出ている経路と、JSON-LDに書いた経路が食い違っている状態は避けます。
必須プロパティは3つです。itemListElement(順序を持つ配列)、position(1から始まる位置)、name(表示される名称)。加えて各項目の item にURLを入れます。最後の項目については「If the breadcrumb is the last item in the breadcrumb trail, item is not required. If item isn't included for the last item, Google uses the URL of the containing page(最後の項目では item は必須ではなく、省略した場合はそのページのURLが使われる)」と明記されています。
単一トレイルの完全形
<pre><code>構造化データの実装例は、本文へscriptタグを直接貼らず、WordPressテーマまたはSEOプラグインから出力します。実装時は次の項目を確認します。
- type: Organization
- name: 会社の正式名称
- url: 公式サイトURL
- sameAs: 公式SNSや関連プロフィール
- contactPoint: 問い合わせ先
- logo: 公式ロゴ画像URL</code></pre>
最後の要素で item を省略しています。省略しない場合は、そのページの正規URLと完全に一致させてください。表示されているURLと構造化データ内のURLがズレると、正規化の判断材料としてノイズになります。
複数トレイルの完全形
1つのページに複数の到達経路がある場合、Googleは複数のBreadcrumbListを配列で並べる書き方を示しています。ECのカテゴリ横断商品や、複数サービスから参照される事例ページで使えます。
<pre><code>構造化データの実装例は、本文へscriptタグを直接貼らず、WordPressテーマまたはSEOプラグインから出力します。実装時は次の項目を確認します。
- type: Organization
- name: 会社の正式名称
- url: 公式サイトURL
- sameAs: 公式SNSや関連プロフィール
- contactPoint: 問い合わせ先
- logo: 公式ロゴ画像URL</code></pre>
可視パンくずのHTML
構造化データだけ入れて、画面にパンくずが無い状態は避けます。読者にとっての現在地表示と、クローラーにとっての上向きリンクが、どちらも失われるためです。
<pre><code><nav aria-label="パンくずリスト"> <ol> <li><a href="https://example.com/">ホーム</a></li> <li><a href="https://example.com/ai-search/">AI検索対策</a></li> <li><a href="https://example.com/ai-search/technical/">技術実装</a></li> <li aria-current="page">パンくずとサイト構造</li> </ol> </nav></code></pre>
WordPressで実装する場合、テーマ側とSEOプラグイン側の両方がBreadcrumbListを出力し、経路の異なる2つのJSON-LDが同一ページに存在する状態が起きます。どちらか一方に寄せてください。判断は「実際に画面に出ている経路と一致するほうを残す」で足ります。
階層が壊れるときの典型5パターン
| No. | 失敗例 | 何が起きるか | 直し方 |
|---|---|---|---|
| 1 | パンくずをURLの文字列から機械生成している | スラッグが英語のまま出る、中間ディレクトリに実在ページが無くリンク切れになる | 階層マスタ(親カテゴリとURLの対応表)を持ち、そこから生成する |
| 2 | タグページを階層の一部として扱っている | 同一記事が複数の親を持ち、正規URLの判断が揺れる | 階層に使うのはカテゴリのみ。タグは横断リンクとして扱い、必要ならnoindexにする |
| 3 | パンくずがJavaScriptでのみ描画される | レンダリング前のHTMLに上向きリンクが存在せず、経路が読まれない可能性がある | サーバー側HTMLに出力する。判断手順はJavaScript描画・SPAの点検手順を参照 |
| 4 | カテゴリ改称後、JSON-LDだけ更新して表示が古い | 表示内容と構造化データが不一致になる | 表示側を単一の正本にし、JSON-LDはそこから生成する |
| 5 | 記事が1本しかないカテゴリを量産している | カテゴリページが中身のない中継ページになり、階層の意味が薄れる | 一定本数に満たないカテゴリは統合する。用語単位の情報は用語集ページの設計側で受ける |
3番は、AI検索の文脈でとくに影響が出やすい箇所です。OpenAIは自社クローラーについて、ChatGPTの検索機能でサイトを表示するために使う OAI-SearchBot、基盤モデルの改善に使う GPTBot、ユーザー操作を起点とする ChatGPT-User を役割ごとに分けて説明しています。役割が違えば挙動も違うため、「どのボットが、どの経路で、どこまで読めるか」を前提に、サーバー側HTMLで完結する構造にしておくほうが安全です。
カテゴリ設計は「読者の質問」から決める。ページ数から決めない
階層は、社内の組織図やサービス一覧ではなく、読者が実際に投げる質問のかたまりで切ります。AI検索では、ひとつの質問に対して複数ページが横断的に参照されるため、「同じ質問に答えるページが同じ場所にまとまっているか」が効いてきます。
| 状況 | 新カテゴリを作る | 既存カテゴリに入れる |
|---|---|---|
| 想定記事本数 | 継続的に5本以上見込める | 単発、または2〜3本で止まる |
| 読者の質問 | 既存カテゴリと質問の型が違う | 既存カテゴリの質問の派生にすぎない |
| 更新頻度 | 既存カテゴリと明確に違う | 既存カテゴリと同程度 |
| 担当 | 更新責任者を置ける | 置けない(放置カテゴリになる) |
深さの目安は、トップから3〜4クリックで全ページに到達できることです。これは公式に定められた閾値ではなく、内部リンクの経路設計上の実務基準として置いています。到達に5クリック以上かかる領域が出たら、カテゴリの粒度か、ハブページの配置を見直します。店舗ページのように同型ページが大量に並ぶケースの構造問題は、多店舗チェーンの店舗ページ設計で個別に扱っています。
いま自社サイトで確認できること
順に実行すれば、公開情報だけで現状把握ができます。数値の改善を約束するものではなく、状態の確認手順です。
- レンダリング前HTMLにパンくずが存在するか。
curl -s "https://example.com/対象URL/" | grep -i breadcrumbを実行し、navと JSON-LD の両方が返るか見ます。JSON-LDだけが返る場合は可視パンくずがJS依存の可能性があります。 - 構造化データが仕様どおりか。Googleのリッチリザルトテスト、またはスキーマ検証ツールで
positionの連番、nameの表示名一致、最後の要素の扱いを確認します。 - 表示との一致。ブラウザで見えている経路と、JSON-LDの
name列が同じ順序・同じ文言かを目視で突き合わせます。ここが最も事故率の高い箇所です。 - Search Consoleのパンくずレポート。エラーと警告の件数、対象URLのパターンを確認します。テンプレート単位の不具合はここで面として出ます。
- 重複した親の有無。
site:検索やサイトマップの突き合わせで、同一本文が別階層のURLでも到達できていないかを確認します。検出したら正規URLへ寄せます。 - クローラーの巡回経路。サーバーログでカテゴリページとトップページへのアクセス比率を見ます。記事ページばかりが読まれ、カテゴリページがほぼ読まれていない場合、上向きリンクが機能していない可能性があります。
- 生成AIに自社カテゴリを説明させる。「この会社のサイトはどんなカテゴリで情報を整理していますか」と各AI検索に尋ね、実際の階層とズレた説明が返らないかを記録します。回答は変動するため、単発の結果ではなく、公開情報側の不足を探す用途で使います。
サイトマップとの関係も合わせて点検してください。階層とサイトマップの整合についてはサイトマップのpriority・lastmodは効くのか、点検全体の流れはLLMO診断チェックリストにまとめています。
よくある質問
パンくずリストはいらない、という意見をどう考えればよいですか
「リッチリザルトの見た目のため」という目的だけなら、期待値は下げるべきです。Googleのパンくずリッチリザルトはデスクトップのみの提供とされており、モバイル検索結果では表示されません。ただし、読者への現在地提示、Google側でのページ情報の分類、全ページからの上向きリンクという3つの仕事は残ります。表示されないことと機能しないことは別です。
パンくずはURL構造と一致させるべきですか
一致していなくても構いません。Googleは、URL構造を写すのではなく、ページに至る典型的なユーザー経路を表すパンくずを提供することを推奨しています。URLは一意性と安定性のため、パンくずは意味の伝達のためと役割を分けて設計します。ただし、パンくず内のリンク先URLは正規URLに揃えてください。
BreadcrumbListを実装すればAI検索に引用されやすくなりますか
2026年9月時点で、そう言い切れる公式発表は確認できていません。Googleは生成AI機能について、構造化データは必須ではなく専用のschema.orgマークアップも不要だと明記しています。実装の価値は、インデックスとカテゴリ判定という土台側にあります。引用の確約を前提にした設計はおすすめしません。
階層は何階層までが目安ですか
公式な上限はありません。実務では、トップから3〜4クリックで全ページに到達できることを基準に置き、それを超える領域が出たらカテゴリ粒度かハブページを見直します。加えて、更新頻度が明確に違うコンテンツ群はディレクトリを分けます。Googleは、更新頻度の異なるディレクトリを分ければ、その違いを学習して別々の頻度でクロールできると説明しています。
既存の階層を変更したいのですが、URLも変えるべきですか
表示名の変更だけで済むなら、URLは変えないでください。パンくずの表示名とJSON-LDの name を更新すれば、読者にも検索側にも新しい分類は伝わります。URLを変える場合は301リダイレクト、rel="canonical"、サイトマップ、内部リンクの4点を同時に更新します。内部リンクが旧URLのまま残ると、全ページから重複URLへリンクし続けることになります。
結論
パンくずリストとサイト構造は、AI検索のための特別な施策ではありません。2026年9月時点でGoogleが明言しているとおり、生成AI機能に出るための追加要件や専用マークアップは存在せず、やるべきことは検索の技術要件を満たすことに戻ります。
そのうえで、パンくずと階層設計には確認できる仕事が3つあります。読者に現在地を示すこと、Googleがページ情報を分類する材料になること、そして全ページからカテゴリとトップへ向かう恒常的なリンク経路を維持することです。この3つを、URL階層・可視パンくず・内部リンクの3層で矛盾なく表現できていれば、AIが自社サイトを説明するときの土台は整っています。
着手の順序はこうです。まず階層マスタ(親カテゴリとURLの対応表)を1枚作る。次に、代表URLでレンダリング前HTMLにパンくずが存在するかを確認する。最後に、表示されている経路とJSON-LDの経路が一致しているかを突き合わせる。ここまでで、テンプレート単位の不具合はおおむね表に出ます。
自社サイトの階層とパンくずが、AI検索の文脈で読み取れる状態になっているかを外部の目で確認したい場合は、LLMO診断で現状の整理からご相談ください。診断では、公開情報だけで確認できる範囲と、社内で正本を決め直す必要がある範囲を切り分けてお伝えします。
公式情報で確認するポイント
AI検索まわりは仕様変更が多いため、記事公開前後に公式情報を確認し、本文の言い切りや実装方針を更新します。
- Google Search Central「Optimizing your website for generative AI features」 生成AI検索に対して、通常のSEO・技術要件・独自性の扱いを確認する公式ガイド。
- Google Search Central「Creating helpful, reliable, people-first content」 人間に役立つ信頼性の高いコンテンツを評価するための公式観点。
本体メディアであわせて確認する記事
この記事のテーマを、Uravation本体メディアで検索流入のあるAIツール・モデル解説にもつなげて確認できます。
AI活用書籍シリーズ累計59,900部の著者チームが監修。自社7メディアの実運用でAI検索からの引用・流入を継続計測しており、その一次データと公式情報に基づいて、企業サイトで実務的に使える形へ整理しています。仕様変更が多い領域のため、公開前後に公式情報と本文の整合性を確認します。
AI検索診断・情報源設計支援に進める
この記事のテーマを自社サイトに当てはめ、公開情報、根拠ページ、FAQ、内部リンク、構造化データ、llms.txtのどこを確認すべきかを整理します。
AI検索攻略の前後の記事
同じ連載の前後の記事へ進み、LLMO、AIO、GEO、AI検索の論点を順番に確認できます。
関連するUravationの導線
AI検索攻略は、Uravation本体のAI活用メディアとサービス導線につながる専門テーマとして運用します。