Google・OpenAI・Microsoftが対応を表明したAI学習の共通拒否を、robots.txtの書き方、開始時期、AI検索への影響、今やる確認事項まで一次情報で整理します。
- 共通の記述は、生成AIモデルの学習に対する意思表示です。通常のクロール可否を指示する行ではありません。
- Google、OpenAI、Microsoftで対応時期と扱いが異なります。各社の既存設定は、現時点で削除せず残すのが安全です。
- AI学習の拒否は、GoogleとBingの通常の検索結果への掲載には影響しないと両社は説明しています。一方、AI回答の根拠として使う「グラウンディング」は会社ごとに扱いが異なりま…
判断の分かれ目は、AI学習とAI回答の根拠利用を分けて決めることに尽きます。
2026年10月30日(米国時間)、Google、OpenAI、Microsoftは、Webサイト運営者がrobots.txtでAI学習への意向を共通形式で示せる仕組みへの対応を発表しました。共通の記述は User-Agent: __usage_ai-training です。ただし、発表されたのは「1行追加すれば、すべてのAI利用を一括で止められる」という仕組みではありません。2026年10月31日時点で一次情報を確認しています。
まず押さえるべき結論は次の4点です。
- 共通の記述は、生成AIモデルの学習に対する意思表示です。通常のクロール可否を指示する行ではありません。
- Google、OpenAI、Microsoftで対応時期と扱いが異なります。各社の既存設定は、現時点で削除せず残すのが安全です。
- AI学習の拒否は、GoogleとBingの通常の検索結果への掲載には影響しないと両社は説明しています。一方、AI回答の根拠として使う「グラウンディング」は会社ごとに扱いが異なります。
- これはIETFの個人によるInternet-Draftで、まだ標準ではありません。実装前に、拒否したい利用目的と残したいAI検索での露出を社内で分けて決める必要があります。
AI学習の共通拒否とは
robots.txtに
User-Agent: __usage_ai-trainingのグループを置き、DisallowまたはAllowでパスごとの意向を示す仕組みです。Disallowは生成AIモデルの学習に使わないでほしいという意向、Allowは使ってよいという意向を表します。これはクロールを止める命令ではなく、対応する事業者がコンテンツの利用目的を判断するための意思表示です。
何が決まったのか
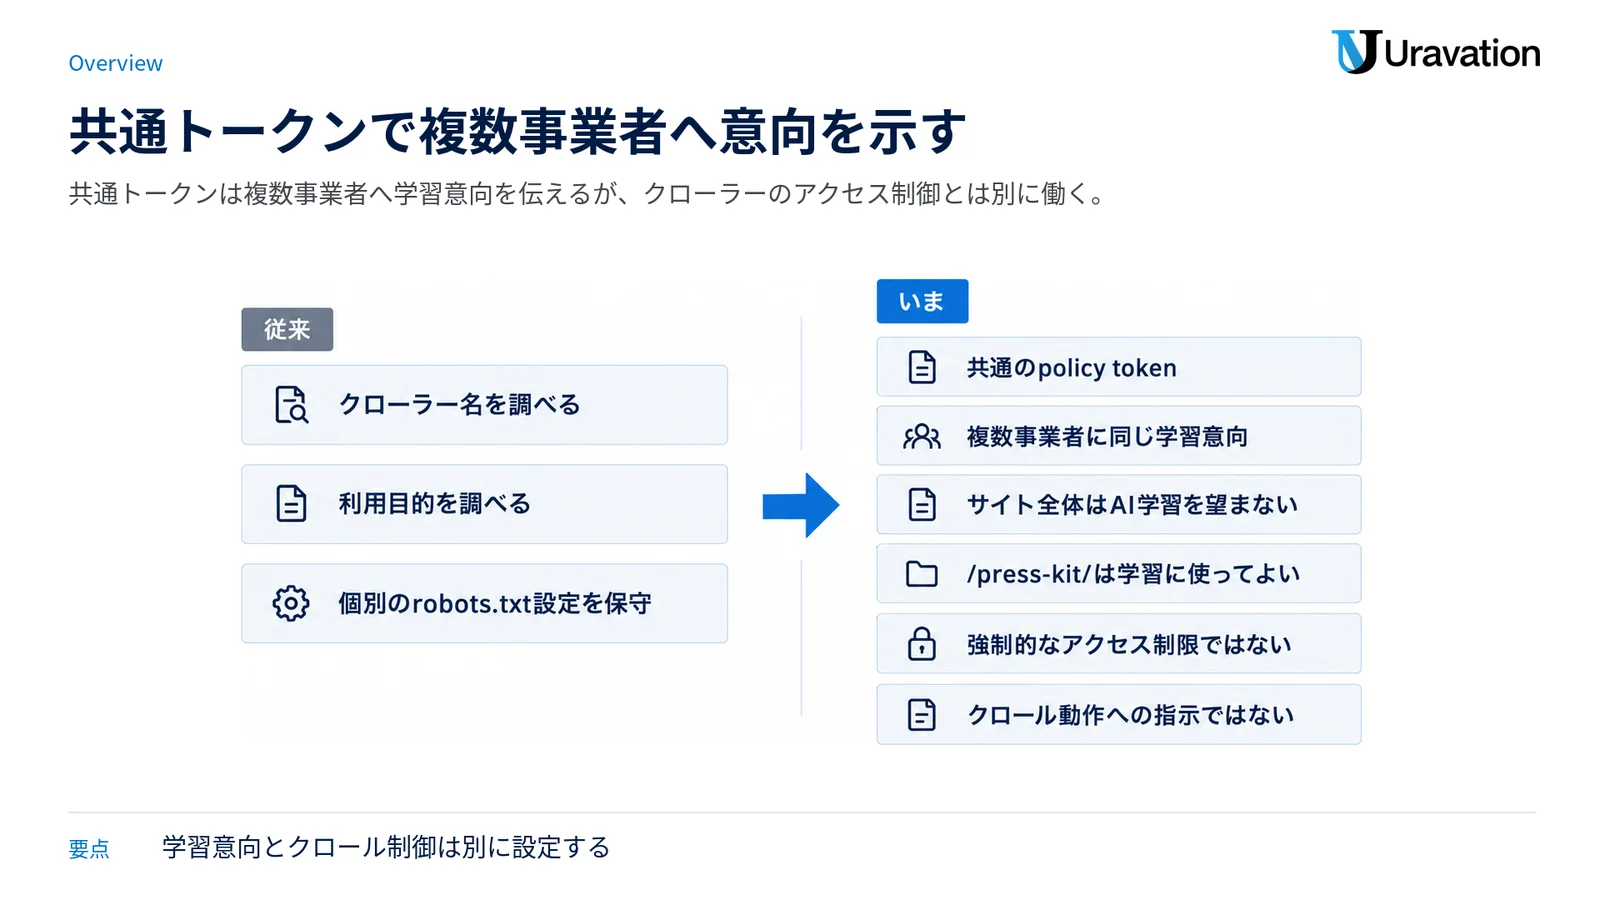
これまでWeb担当者は、AI事業者ごとのクローラー名や利用目的を調べ、個別のrobots.txt設定を保守する必要がありました。今回3社が対応を表明した共通方式は、複数の対応事業者に同じ学習意向を伝えるための「policy token」をrobots.txtのUser-Agent欄に置く考え方です。
IETFの下書きで提案された共通トークンは、次のとおりです。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/この例では、サイト全体についてAI学習への利用を望まない一方、/press-kit/ 配下は学習に使ってよいという意向を表します。robots.txtの既存のパス照合や、より具体的な一致を優先する考え方を利用するため、新しいディレクティブ名や新しい文法は導入していません。
ここで重要なのは、これは強制的なアクセス制限ではないという点です。IETFの下書きは、このpolicy tokenをクロール動作への指示ではないと明記しています。コンテンツの利用意向と、ボットのアクセスを管理するクロール指示は、同じrobots.txt内にあっても別々に働きます。
たとえば、特定クローラーのアクセス自体を制限したい場合は、そのクローラーのproduct tokenを使う既存のグループが必要です。共通の学習拒否グループだけを書いても、すべてのクローラーへのアクセス拒否にはなりません。AIクローラー別の設定を見直す場合は、robots.txtでAIクローラーを許可すべきかもあわせて確認してください。
共通の書き方を誤解しないための定義
対象は生成AIモデルの学習
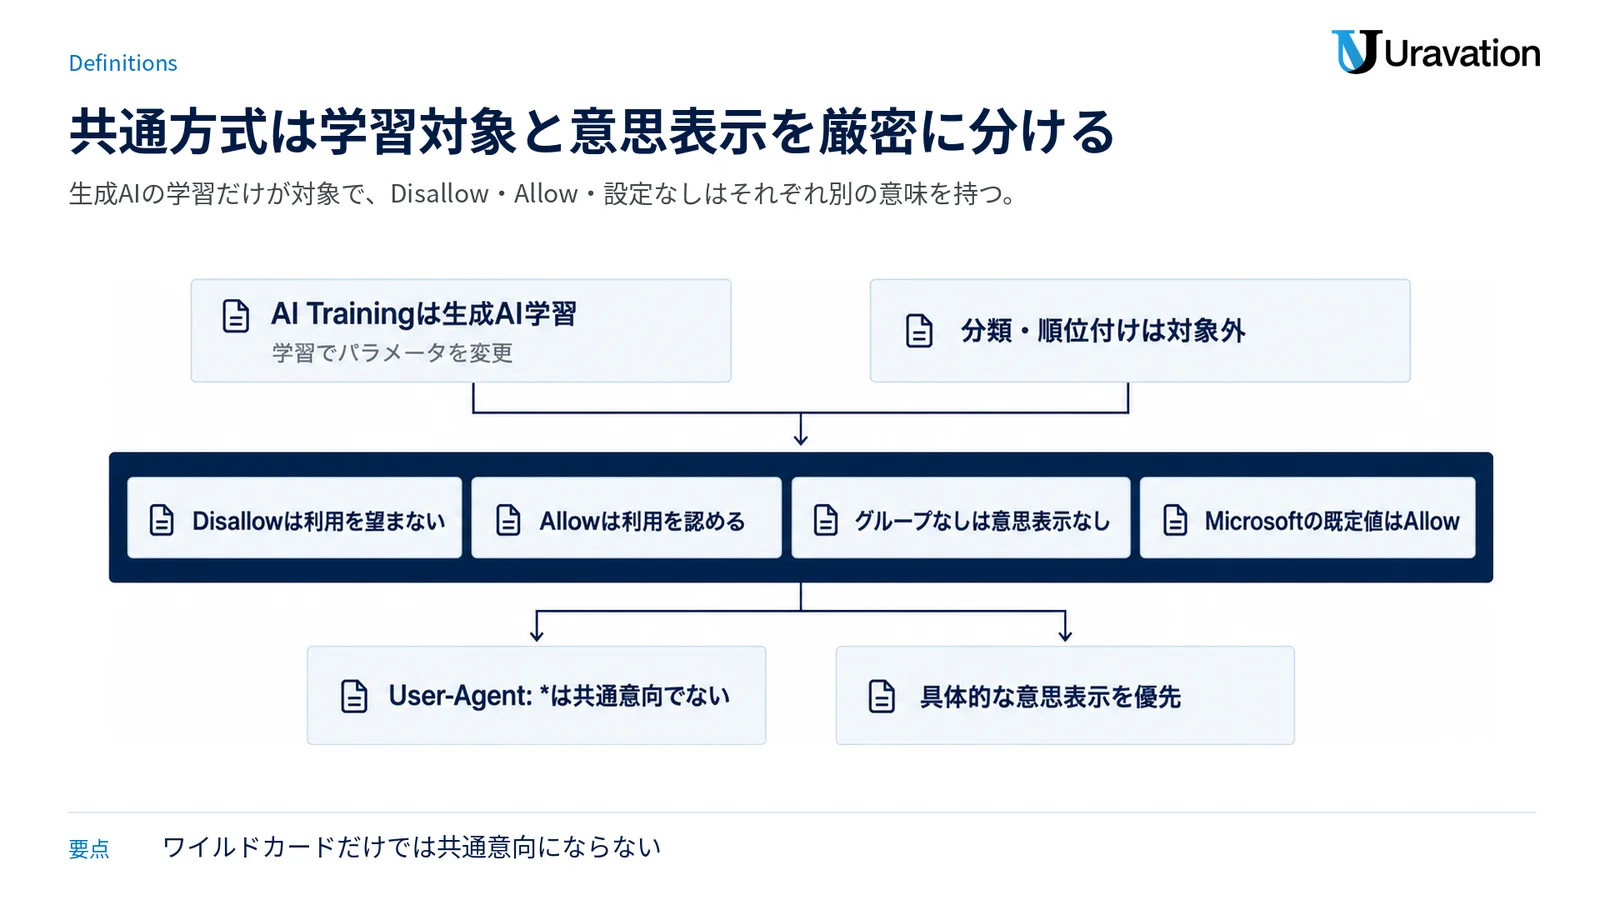
IETFの下書きは、AI Trainingを「資産を使って、生成AIモデルが学習したパラメータを変更すること」と定義しています。ここでいう資産は、対象パスから取得したコンテンツです。
一方、分類、順位付け、スコアリングに使うモデルは、この生成AIモデルの定義に含まれません。生成能力を持つモデルであっても、分類や順位付けなど非生成タスクだけに使う学習はAI Trainingの対象外です。したがって、「この記述で検索順位を決めるモデルの学習まで一律に拒否できる」と読むのは正確ではありません。
DisallowとAllowが表すこと
User-Agent: __usage_ai-training のグループ内で、対象パスが Disallow に一致すれば、AI学習への利用を望まないという意向です。Allow に一致すれば、その利用を認める意向です。
グループ自体がなければ「許可を明示した」でも「拒否を明示した」でもなく、この共通方式では意思表示なしとなります。Microsoftは自社実装について、該当する学習設定がない場合の既定値をAllowと説明していますが、共通下書きそのものは「グループがなければ意思表示なし」と定めています。文書の層を混同しないことが大切です。
User-Agent: * は共通の意思表示にならない
既存のrobots.txtに次のようなワイルドカードのグループがあっても、それだけでは共通のAI学習意向として扱われません。
User-Agent: *IETFの下書きは、ワイルドカードグループを __usage_ai-training に一致するものとして解釈してはならないとしています。サイト全体に User-Agent: * と Disallow がある場合、一般的なクロール制御としては別の意味を持ちますが、共通の学習意向を示したことにはなりません。
個別設定を優先できる
IETFの下書きは、具体的な意思表示を一般的な意思表示より優先すべきだとしています。各事業者は、Google-Extendedのような自社専用のpolicy tokenを、共通トークンより具体的な設定として解釈できます。
この仕組みにより、全体方針は共通グループで示しながら、特定事業者だけ異なる判断を示せます。たとえばGoogleは、共通グループで学習を拒否し、Google-Extendedを明示していない場合、Google-Extendedを拒否したのと同じ扱いにする予定です。一方、Google-Extendedを個別に明示すれば、その設定を組み合わせて事業者別に意向を調整できます。
Google・OpenAI・Microsoftはいつから従うのか
| 会社 | 共通方式への対応時期 | 既存設定との関係 | 検索・AI回答との関係 |
|---|---|---|---|
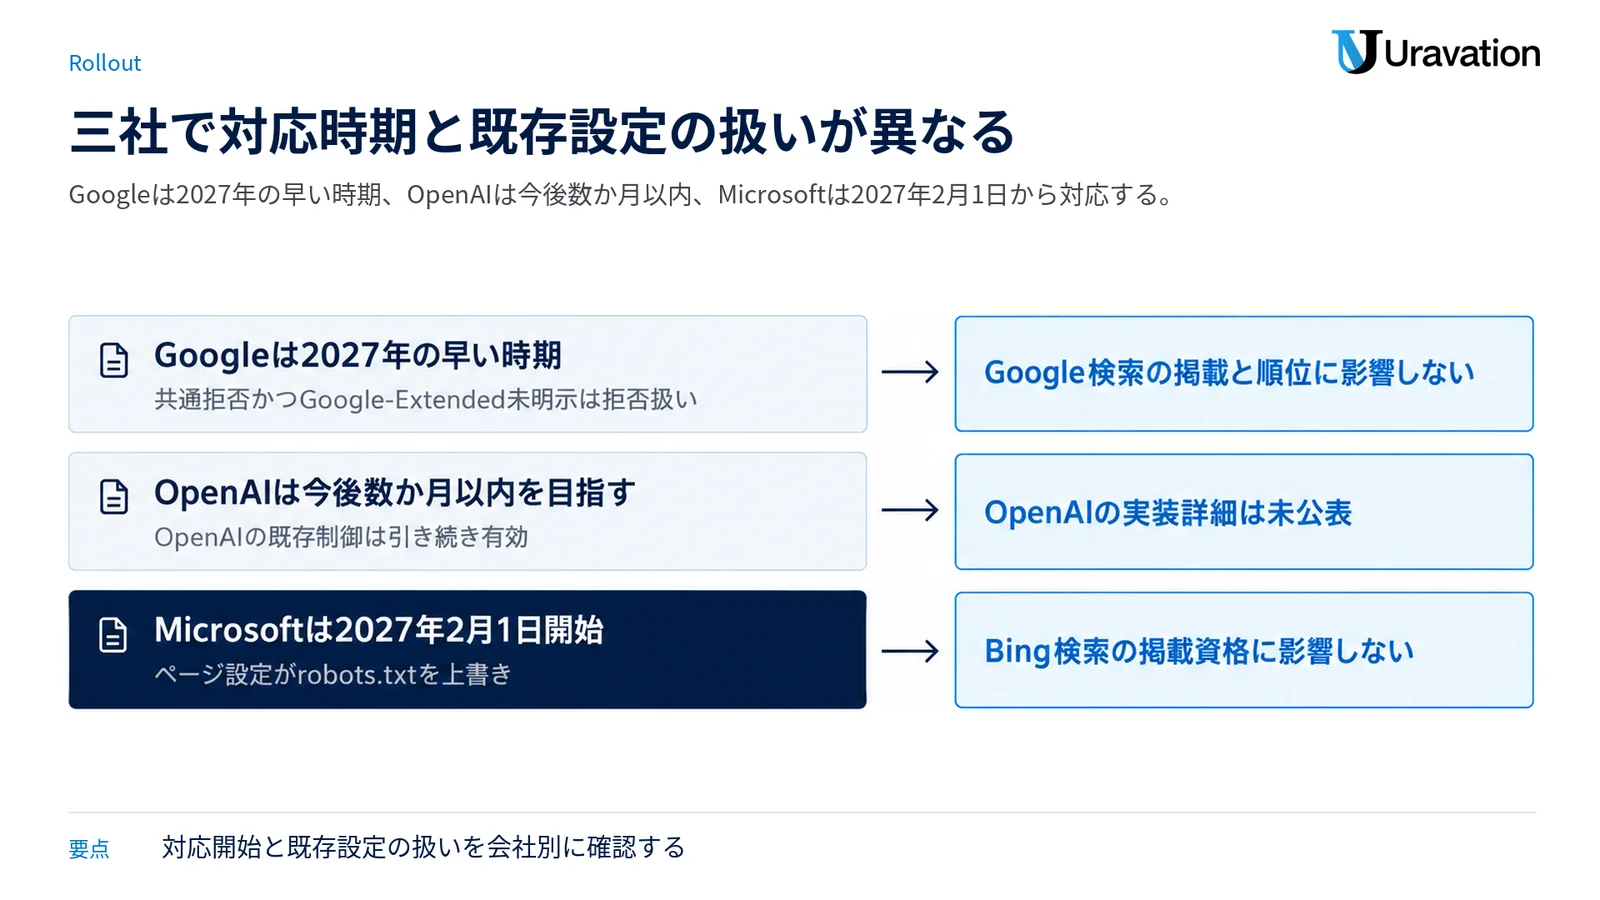
| 2027年の早い時期に対応する予定 | 共通グループで拒否し、Google-Extendedを明示していなければ、Google-Extendedを拒否したのと同じ扱いにする予定 | Google-ExtendedはGoogle検索への掲載と順位に影響しない。GeminiアプリとVertex AIのGeminiにおける学習とグラウンディングを管理する | |
| OpenAI | 今後数か月以内の実装を目指す | 既存のrobots.txtによるクローラー制御は引き続き有効 | 実装の詳細は対応時に改めて知らせるとしており、現時点で追加の詳細は公表されていない |
| Microsoft | 2027年2月1日から、クロール時に新設定へ対応 | robots.txtに加えてページ単位のAI Training設定を用意。ページ単位の設定がrobots.txtを上書きする | 通常のBing検索結果への掲載資格には影響しない。AI Groundingは別のページ単位設定として管理する |
GoogleはGoogle-Extendedとの関係を明示
Googleのクローラー文書によると、Google-Extendedは、Googleがサイトからクロールしたコンテンツを、GeminiアプリとVertex AI API for Geminiを支える将来のGeminiモデルの学習に使うかどうかを管理します。さらに、GeminiアプリとVertex AIのGoogle検索によるグラウンディングも管理します。ここでいうグラウンディングとは、回答時にGoogle検索インデックスのコンテンツをモデルへ渡し、事実性と関連性の向上に使うことです。
Google-ExtendedはGoogle検索への掲載に影響せず、Google検索のランキングシグナルにも使われません。また、Googleは、Google-Extendedを明示的に許可したサイトについて、Geminiアプリでグラウンディングを通じて回答に出て、クリックを受ける対象になり得ると説明しています。これは対象資格の説明であり、回答への掲載やクリックを保証するものではありません。
共通グループの拒否をGoogle-Extendedの拒否と同じ扱いにする予定であるため、Googleでは「学習だけ拒否し、Geminiアプリのグラウンディングは許可する」という意図が、共通グループだけでは表現できません。少なくとも今回公表された方針では、Google-Extendedが学習とグラウンディングの両方を管理するためです。
なお、今回のGoogle発表とGoogle-Extended文書には、Google検索のAI OverviewsやAIモードへの具体的な影響は記載されていません。「通常のGoogle検索への掲載と順位には影響しない」という説明を、記載のない検索機能まで推測で広げないようにします。
OpenAIは今後数か月以内を目標
OpenAIは、共通方式を今後数か月以内に実装することを目指し、実装の詳細は対応時に改めて知らせるとしています。現時点で開始日を特定の日付に置き換えることはできません。
また、新しい共通方式は、OpenAIがすでにrobots.txtで提供しているクローラー制御を置き換えません。既存の制御は引き続き適用され、尊重されると説明されています。したがって、共通グループを先に追加するとしても、OpenAI向けの既存設定を直ちに削除する根拠にはなりません。
Microsoftは学習とグラウンディングを分離
Microsoftは2027年2月1日から、ページをクロールする際に新しいAI TrainingとAI Groundingの設定へ対応します。AI Trainingは共通のrobots.txt設定に加え、ページ単位でも上書きできます。資料に示されたページ単位の学習拒否例は次の2つです。
<meta name="Bingbot" content="ai-training:disallow">X-Robots-Tag: Bingbot: ai-training:disallowAI Groundingはrobots.txtのサイト全体設定ではなく、ページ単位で管理します。選択肢はAllow、DisallowExtended、Disallowです。
- Allow:生成された回答の根拠として使うことを認めます。
- DisallowExtended:Microsoftが運営する体験でのグラウンディングに限定し、第三者へ提供するグラウンディングサービスでは使わない意向です。
- Disallow:生成された回答の根拠として使わない意向です。
Microsoftは、DisallowExtendedまたはDisallowを選ぶと、Bingの通常検索結果への掲載資格には影響しない一方、AIが生成する体験でのコンテンツ露出は大きく減ると注意しています。さらに、どの設定も掲載、トラフィック、支払いを保証しないと明記しています。
NoArchive・NoCache利用サイトの切り替え期限
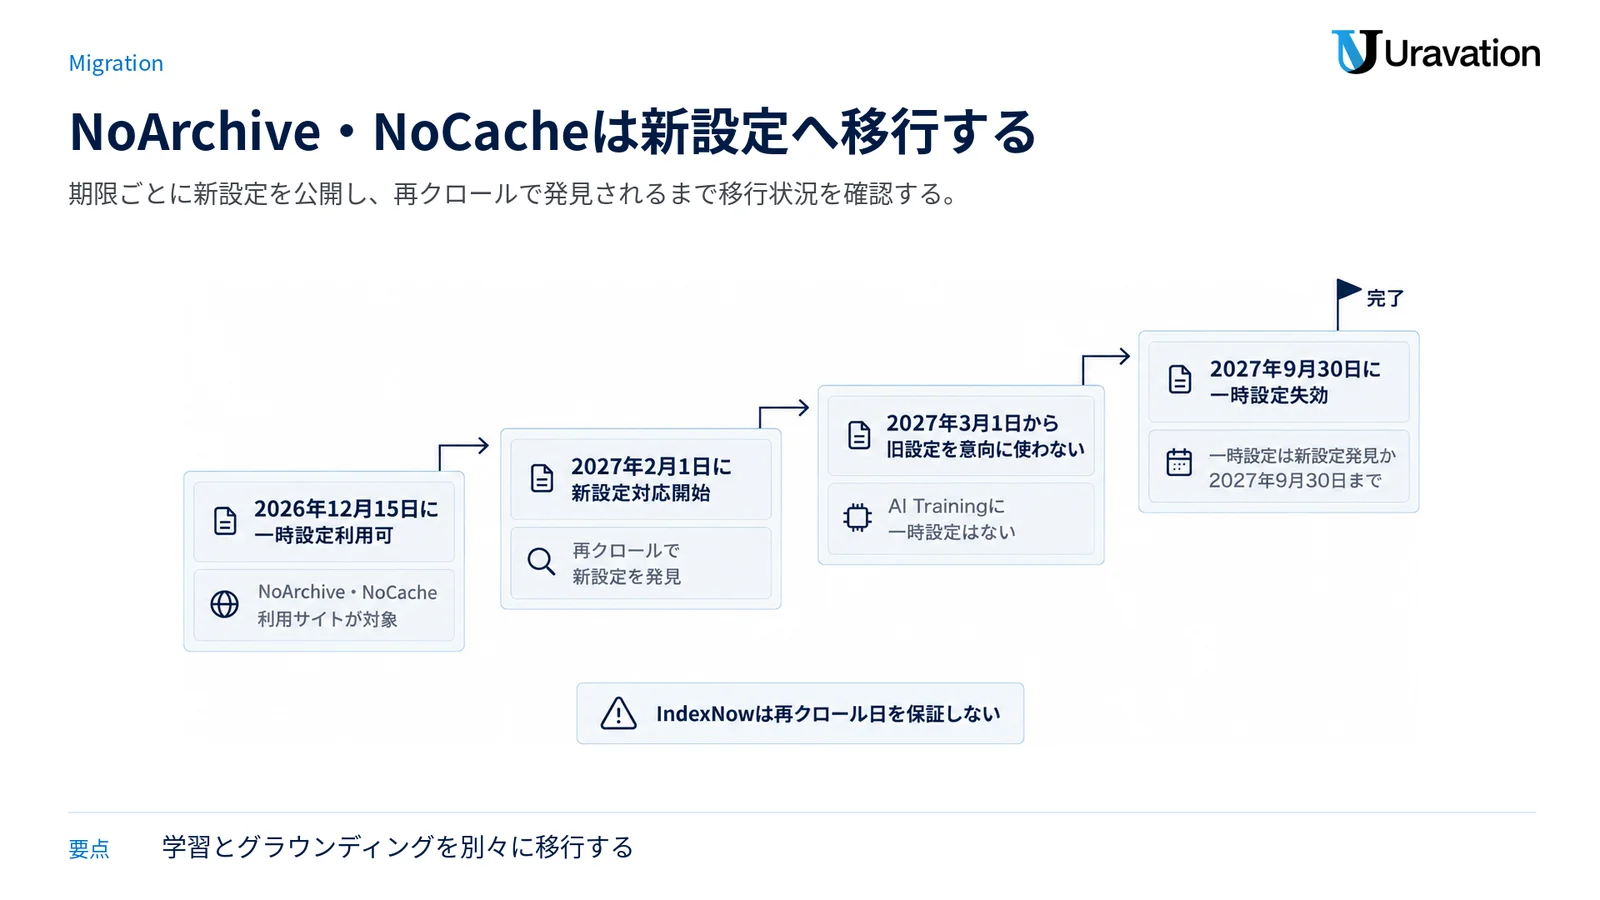
Microsoftは、従来AI TrainingとAI Groundingの意向として扱ってきた NoArchive と NoCache を、新設定へ置き換えます。移行日を混同すると、拒否のつもりだったページが既定のAllowとして扱われる可能性があります。
| 日付 | 変わること | 対象サイトが行うこと |
|---|---|---|
| 2026年12月15日 | Bing Webmaster Toolsで、一時的なグラウンディング移行設定を利用可能 | 2026年12月15日にNoArchiveまたはNoCacheを使っているサイトだけが対象。必要な場合に一時設定を記録する |
| 2027年2月1日 | Microsoftがクロール時に新しいAI TrainingとAI Grounding設定へ対応開始 | robots.txtまたはページ単位に新設定を公開し、再クロールでの発見を待つ |
| 2027年3月1日 | NoArchiveとNoCacheを、学習・グラウンディングの意思表示として読まなくなる | グラウンディング制限を維持したい対象サイトは、ページ設定とBing Webmaster Toolsの一時設定を完了する |
| 2027年9月30日 | 残っている一時的なグラウンディング設定が失効 | それ以前でも、再クロールでページの新設定が見つかれば、その時点でページ設定へ切り替わる |
一時設定が有効なのは、再クロールで新しいページ設定が見つかった時点か、2027年9月30日のどちらか早い方までです。AI TrainingにはBing Webmaster Toolsの一時設定がありません。NoArchiveまたはNoCacheを使っているサイトは、学習とグラウンディングを別々に移行させる必要があります。
設定を公開しただけで即時に反映されるわけではありません。Microsoftは、新しい設定を発見するためにクロールが必要だと説明しています。IndexNowは変更を知らせ、再クロールの可能性を高めますが、再クロール日を保証しません。
AI検索に出たいサイトは学習と回答の根拠を分ける
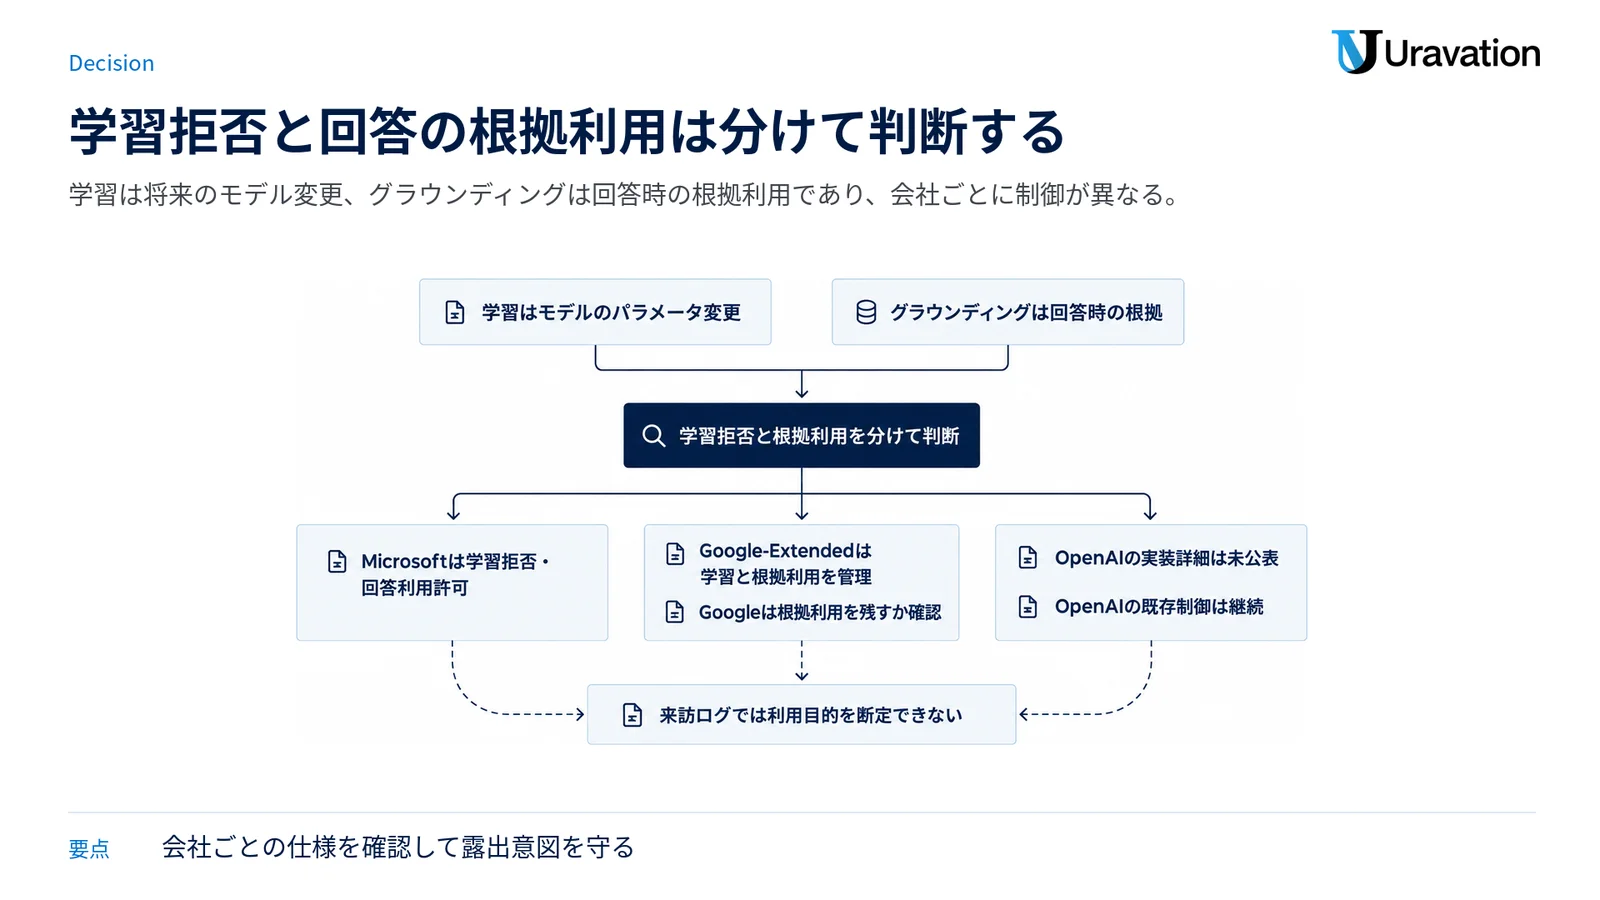
「学習を拒否すると、AI検索に出なくなるのか」という問いに、3社共通の一語では答えられません。学習は将来の生成AIモデルのパラメータ変更、グラウンディングは回答時の根拠利用です。同一視すると、意図しない露出減につながります。
Microsoftは、AI TrainingをDisallow、AI GroundingをAllowに分けられます。つまり、将来の生成AIモデルの学習には使わないでほしいが、回答時の根拠としては使ってよい、という意思をページ単位も含めて示せます。
Googleでは事情が異なります。共通グループで学習を拒否し、Google-Extendedを明示していなければ、Google-Extendedを拒否したのと同じ扱いにする予定です。Google-ExtendedはGeminiモデルの学習だけでなく、Geminiアプリなどのグラウンディングも管理します。Google向けには、共通拒否を追加する前に、Geminiアプリで回答の根拠となる可能性を残したいかを確認する必要があります。
OpenAIは今後数か月以内の実装を目指すと発表した段階で、共通方式の実装詳細はまだ公表していません。既存クローラー制御が継続することは確認できますが、未発表の挙動を推測して設定を置き換えるべきではありません。
クロール状況も設定意図と分けて確認します。robots.txtに書いた意向と、実際にどのクローラーが来ているかは別の観点です。AIクローラーのログ確認方法でアクセスログを確認すれば、設定前後の来訪状況を事実ベースで把握できます。ただし、来訪ログだけから学習利用やグラウンディング利用を断定することはできません。
自社サイトで今確認する5項目
各社の対応開始前でも、設定棚卸しと社内判断は進められます。変更は次の順番で確認すると安全です。
1. 現在のrobots.txtを保存して個別設定を洗い出す
まず現在のrobots.txtを取得し、Google-Extended や各社クローラー向けのグループがあるか確認します。CMS、CDN、セキュリティ製品がrobots.txtを自動生成している場合は、元ファイルだけでなく、公開URLから返る内容を確認します。
Cloudflareなどネットワーク側のAIクローラーブロックを使っている場合、robots.txtとは別の層でアクセスが止まることがあります。CloudflareのAIクローラーブロックがAI引用に与える影響を参照し、CDN側とサイト側の設定を別々に記録してください。
2. 学習を拒否する範囲をパス単位で決める
サイト全体を拒否するのか、会員向け情報、製品資料、プレスキットなどで扱いを分けるのかを決めます。IETFの下書きはパス単位の意思表示を想定しています。既存のrobots.txtと同様にパス照合を使うため、公開前に対象パスが意図どおりか確認します。
学習を共通で拒否したい会社は、User-Agent: __usage_ai-training のグループを追加できます。ただし、Googleは2027年の早い時期、OpenAIは今後数か月以内、Microsoftは2027年2月1日からの対応予定です。対応前の会社や既存制御との空白を作らないため、個別の会社向け設定は残します。
3. User-Agent: * を共通拒否として数えない
既存の User-Agent: * グループを見て「すでにAI学習を拒否している」と判断しないでください。共通の意思表示には、User-Agent: __usage_ai-training を含むグループが必要です。
同時に、ワイルドカード側のクロール制御を不用意に変更しないことも重要です。共通トークンは利用目的の意思表示であり、一般クローラーのアクセス制御を置き換えません。
4. Bingでは学習とグラウンディングを別々に決める
AI Trainingを拒否するか、AI Groundingを許可するか、Microsoft運営の体験だけに限定するかを別々に決めます。AI回答からの発見機会を残したい場合、学習拒否とグラウンディング拒否を同時に設定する必要はありません。
ページ単位でrobots.txtを上書きする場合は、対象ページとHTTPヘッダーまたはmetaタグの管理責任者を決めます。CMSのテンプレート変更が全ページへ波及しないか、公開前に確認します。
5. NoArchiveとNoCacheの利用状況を確認する
Bing向けにNoArchiveまたはNoCacheを使っている場合は、2027年3月1日までに新しい設定へ切り替える準備が必要です。2026年12月15日にNoArchiveまたはNoCacheを利用しているサイトだけがBing Webmaster Toolsの一時的なグラウンディング設定の対象になるため、対象の有無を早めに記録します。
実装で起きやすい失敗
失敗1:共通グループを書けばクロールも止まると思う
共通トークンはクロール指示ではありません。アクセス自体を制限したい場合は、各クローラーのproduct tokenに対する設定が別途必要です。学習意向とクロール制御を同じチケットで変更する場合も、目的を2列に分けてレビューします。
失敗2:User-Agent: * の既存設定で対応済みと判断する
ワイルドカードグループは __usage_ai-training の代わりになりません。共通グループがなければ、この方式では意思表示なしです。robots.txtを文字列検索するだけでなく、グループ単位で確認します。
失敗3:共通設定を追加した日に個別設定を消す
3社の対応開始は同日ではありません。OpenAIは開始日の詳細をまだ公表しておらず、GoogleとMicrosoftも将来の対応です。各社が実際に対応するまでの間は、既存の個別設定を残すのが妥当です。
失敗4:学習拒否とAI回答への露出拒否を一括で決める
Microsoftでは両者を分けられます。GoogleではGoogle-Extendedが学習とGeminiアプリのグラウンディングの両方を管理します。会社ごとの差を確認せず同じ意図で設定すると、期待した露出を失う可能性があります。
失敗5:下書きを確定済みの国際標準として説明する
draft-kelley-aipref-training-preference-signal-00 は、2026年10月30日付の個人によるInternet-Draftです。IETFの承認を受けた標準ではなく、正式な標準化プロセス上の地位もありません。有効期限は2027年5月3日です。著者欄の所属はAnthropicと記載されています。
Web担当者向けの判断表
| 自社の方針 | 確認する設定 | 注意点 |
|---|---|---|
| 生成AIモデルの学習を広く拒否したい | 共通のrobots.txtグループと既存の会社別設定 | 各社の対応開始前は、個別設定を残す。クロール制御とは別に扱う |
| 学習は拒否し、AI回答の根拠利用は認めたい | MicrosoftではAI TrainingとAI Groundingを別々に設定 | Googleの共通拒否は、Google-Extended未指定ならGoogle-Extended拒否と同じ扱いになる予定 |
| 特定パスだけ学習利用を認めたい | 共通グループ内のDisallowとAllowのパス | 資料にある文法だけを使い、公開後のrobots.txtを確認する |
| BingのNoArchiveまたはNoCacheを使っている | 新しいAI Training、AI Grounding、Bing Webmaster Toolsの一時設定 | 2027年3月1日までの移行と、再クロールまたは2027年9月30日までの一時設定を管理する |
| 通常検索への掲載を維持したい | GooglebotやBingbotのクロール・インデックス設定を別に確認 | 今回の利用意向設定だけで通常検索への掲載を保証するものではない |
よくある質問
共通の学習拒否を書けば、Google検索やBing検索から消えますか?
GoogleはGoogle-Extendedについて、Google検索への掲載と順位には影響しないと説明しています。Microsoftも、新しいAI TrainingとAI Groundingの意向は通常のBing検索結果への掲載資格を変えないとしています。ただし、通常のクロールやインデックス要件は別に満たす必要があります。
User-Agent: * のDisallowでAI学習も拒否できますか?
この共通方式の意思表示にはなりません。IETFの下書きは、ワイルドカードグループを __usage_ai-training と一致するものとして扱ってはならないとしています。共通の学習意向を示すには専用グループが必要です。
設定がなければ、拒否したことになりますか?
いいえ。IETFの共通方式では、専用グループがなければ意思表示なしです。Microsoftの実装では、該当する設定がない場合、AI TrainingとAI GroundingはいずれもAllowが既定です。
Googleでは学習だけを拒否し、Geminiの回答根拠には使えますか?
今回公表された共通方式だけでは単純に分けられません。Googleは、共通グループで学習を拒否しGoogle-Extendedを明示していない場合、Google-Extendedを拒否したのと同じ扱いにする予定です。Google-ExtendedはGeminiの学習とグラウンディングの両方を管理します。実際の設定は、Google-Extendedを明示するかを含めて判断します。
結論と次の一歩
robots.txtのAI学習共通拒否は、複数事業者へ同じ学習意向を伝えるための前進です。ただし、クロール制御、生成AIモデルの学習、AI回答のグラウンディングは同じ設定ではありません。Google、OpenAI、Microsoftで開始時期と既存設定との関係も異なります。
最初に行うのは、共通グループを機械的に追加することではなく、現在のrobots.txtとページ単位設定を一覧にし、次の3点を決めることです。
- どのパスを生成AIモデルの学習に使ってほしくないか
- AI回答の根拠として使われる可能性をどこまで残すか
- 各社の個別設定をいつまで維持するか
自社のrobots.txt、CDN、metaタグ、HTTPヘッダーが複数の担当者にまたがっている場合は、変更前にLLMO診断・AI検索診断で設定の衝突を点検する方法があります。診断はAI回答への掲載を保証するものではありませんが、学習拒否とAI検索での露出方針が食い違っていないかを整理する入口になります。
参考・出典
- Google Search Central Blog, “Supporting a shared AI training control for website
- Google Crawling Infrastructure, “Google's common crawlers” のGoogle-Extended節
- OpenAI, “Making it easier for websites to express AI training preferences” (2026
- Microsoft Bing Blog, “Your content, your choice: clearer preferences for trainin
- IETF Datatracker, “Machine-Readable Training Preference Signal”, draft-kelley-ai
※ 上記は執筆時にアクセスして確認した一次情報です。制度・仕様は変わるため、最新の内容は各公式ページで確認してください。
公式情報で確認するポイント
AI検索まわりは仕様変更が多いため、記事公開前後に公式情報を確認し、本文の言い切りや実装方針を更新します。
- Google Search Central「Optimizing your website for generative AI features」 生成AI検索に対して、通常のSEO・技術要件・独自性の扱いを確認する公式ガイド。
- Google Search Central「Creating helpful, reliable, people-first content」 人間に役立つ信頼性の高いコンテンツを評価するための公式観点。
本体メディアであわせて確認する記事
この記事のテーマを、Uravation本体メディアで検索流入のあるAIツール・モデル解説にもつなげて確認できます。
AI活用書籍シリーズ累計66,000部の著者チームが監修。自社7メディアの実運用でAI検索からの引用・流入を継続計測しており、その一次データと公式情報に基づいて、企業サイトで実務的に使える形へ整理しています。仕様変更が多い領域のため、公開前後に公式情報と本文の整合性を確認します。
AI検索診断・情報源設計支援に進める
この記事のテーマを自社サイトに当てはめ、公開情報、根拠ページ、FAQ、内部リンク、構造化データ、llms.txtのどこを確認すべきかを整理します。
AI検索攻略の前後の記事
同じ連載の前後の記事へ進み、LLMO、AIO、GEO、AI検索の論点を順番に確認できます。
関連するUravationの導線
AI検索攻略は、Uravation本体のAI活用メディアとサービス導線につながる専門テーマとして運用します。