セミナー・ウェビナー集客のLLMO対策を実務目線で解説。AIが「おすすめセミナー」に自社を挙げる条件、開催ページの整備、Event構造化データの2026年時点の実際、終了後アーカイブ運用、効果の確かめ方までまとめます。
- セミナー ウェビナー 集客 llmo ai検索の定義、実務判断、確認項目をAI検索時代の情報源設計として整理する。
- 公式情報と一次情報を優先し、表示保証や順位改善の断定を避ける。
- 本文、FAQ、内部リンク、llms.txt、構造化データの整合性を継続確認する。
実務で見る観点
各AI検索サービスのクローラー名とrobots.txtでの扱いを公式情報で確認する。
サービス内容、料金、対象者、事例、会社情報を正規ページに集約して矛盾を減らす。
外部メディア、SNS、比較サイトに出ている説明と自社サイトの記述がずれていないか見る。
「生成AI ウェビナー おすすめは?」とAIに聞いたとき、自社のセミナーは名前が挙がるでしょうか。挙がるかどうかは広告予算ではなく、開催ページ・過去の開催実績・主催者情報の3層が、AIに読めるテキストとして自社ドメインに揃っているかでほぼ決まります。
2026年9月現在、Googleは公式ドキュメント「AI features and your website」で、AI OverviewやAIモードに載るための追加要件や特別な最適化は存在せず、AI専用の機械可読ファイルやマークアップも不要だと明言しています(2026年9月8日確認)。一方でイベントリッチリザルトの提供地域に日本は含まれず、現実世界の会場を持たないオンライン限定イベントは対象外とも記載されています。つまりセミナー・ウェビナー集客のLLMO対策は、特別なタグ探しではなく「AIが引用できる開催情報と実績を、消えない形で残す」運用の問題です。
セミナー・ウェビナー集客のLLMO対策とは
まず、切り出されても意味が通る形で定義します。
セミナー・ウェビナー集客のLLMO対策とは、ChatGPT・Gemini・PerplexityなどのAIアシスタントが「◯◯ セミナー おすすめ」「◯◯が学べるウェビナー」型の質問に答えるとき、自社の開催ページと主催者情報を根拠として参照・言及できる状態を作る施策のこと。構成要素は、(1)開催ページに機械可読なテキストで開催情報を揃えること、(2)終了後もページを削除せず開催実績として蓄積すること、(3)登壇者・主催者をWeb上で照合可能なエンティティとして整備すること、の3つ。
従来のセミナー集客SEOは「セミナー 集客方法」のようなキーワードでの検索順位を競いました。LLMOで競うのは順位ではなく、AIが候補を列挙する場面で「根拠を引ける主催者」として残ることです。AI検索対策全体の中でこのテーマがどこに位置するかは、AI検索対策の4領域を整理した全体地図を先に読むとつかみやすくなります。
なお、受講する側として「LLMOを学べるセミナーの選び方」を探している場合はLLMOセミナー・研修の選び方が該当します。この記事は主催して集客する側の設計です。
AIは「おすすめのセミナー」をどう組み立てているか
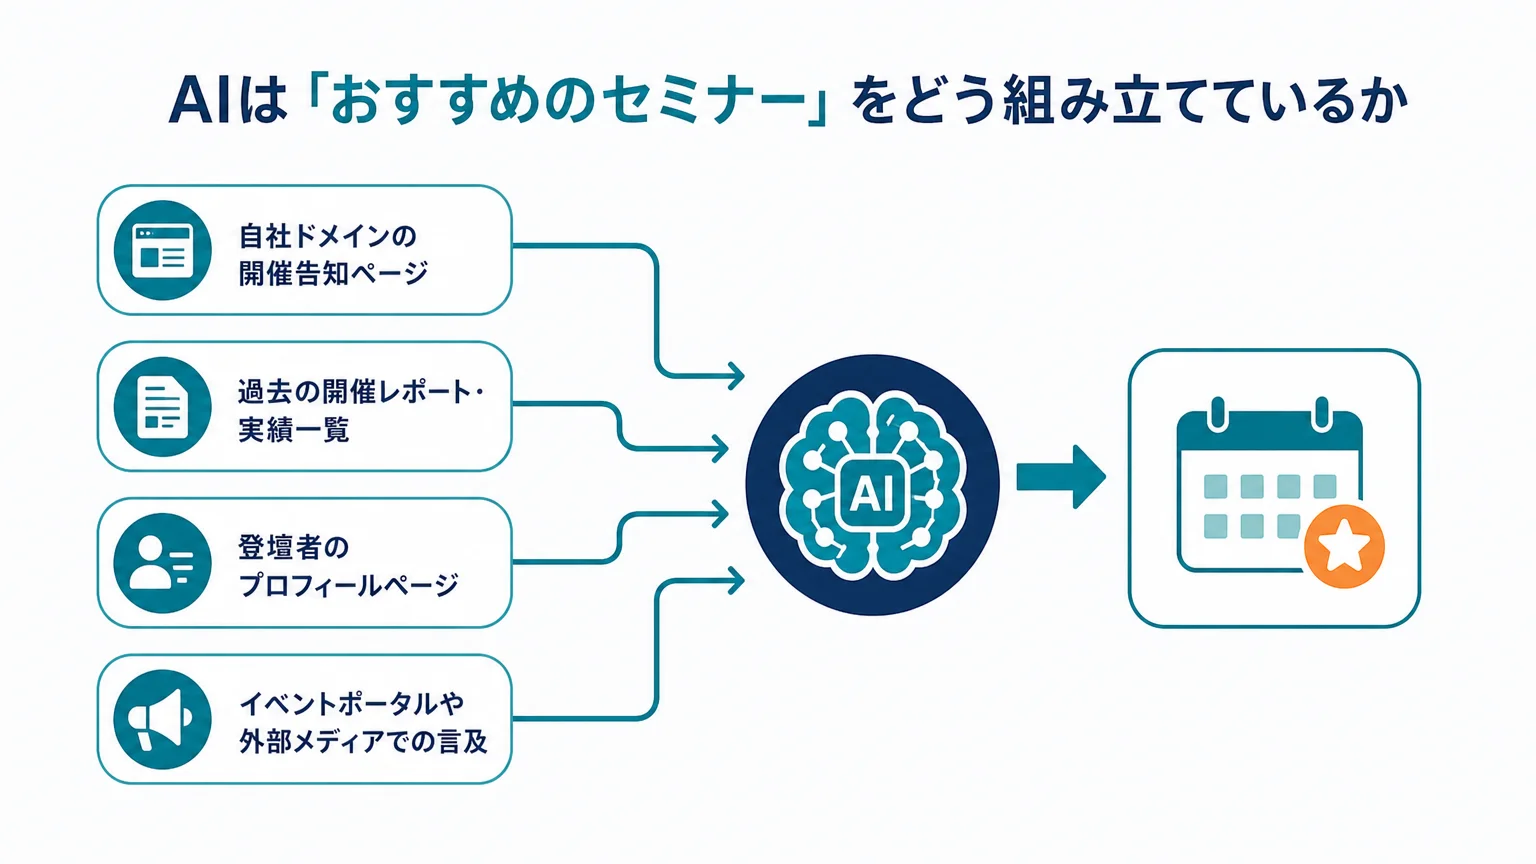
AIアシスタントがセミナーを推薦するとき、内部で起きているのは大きく2段階です。第一に、学習済みの知識とWeb検索の結果から「そのテーマで継続的に発信・開催している主催者」を拾い上げる。第二に、拾った候補について「いつ・誰向けに・何をやっているか」を説明できる根拠ページを探す。この2段階のどちらかで材料が欠けると、内容がどれだけ良いセミナーでも候補から落ちます。
材料になるのは、次のようなページ群です。
- 自社ドメインの開催告知ページ(日時・対象・内容がテキストで書かれているもの)
- 過去の開催レポート・実績一覧(「この主催者は何回やってきたか」の証拠)
- 登壇者のプロフィールページ(「この人はこの題材を語れるか」の照合先)
- イベントポータルや外部メディアでの言及(第三者からの裏取り)
逆に、材料にならないのは「バナー画像の中にしか日時がないページ」「申込フォームだけの外部ツールページ」「会期後に404になる告知ページ」です。AIは画像内の文字や消えたページを根拠にできません。
需要規模の面でも、この領域は従来型SEOよりLLMOが合理的です。ラッコキーワードの表示値では「セミナー集客」の月間検索数は390、「オンラインセミナー集客」は20程度で(2026年9月8日取得)、検索ボリューム自体が小さい。順位を争うより、AIに相談された瞬間に候補へ入れる状態を先に作る方が、投下時間に対する回収が見込みやすい構図です。
集客導線は3層で設計する
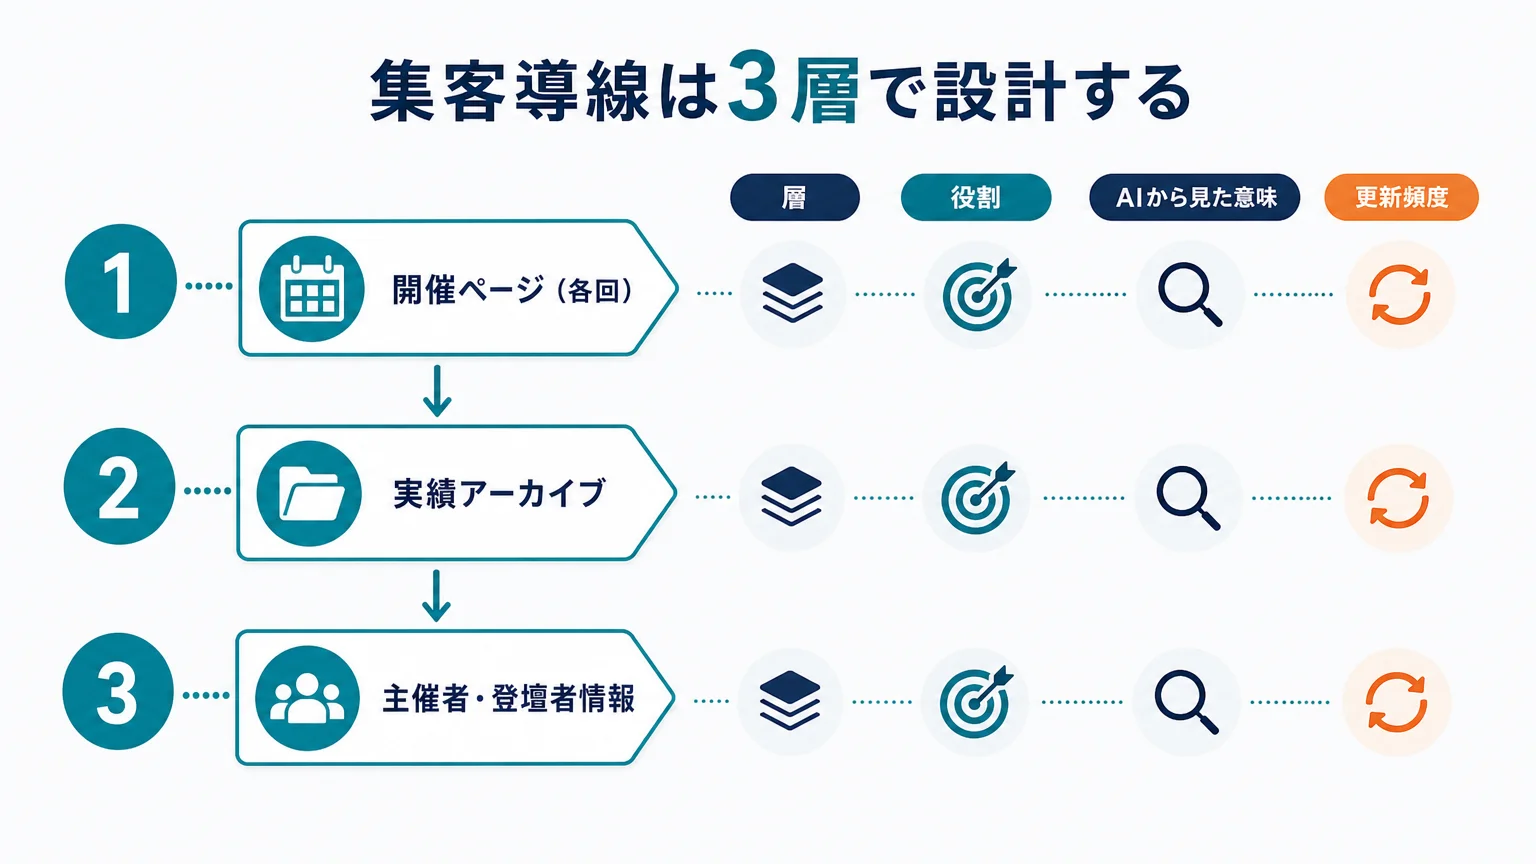
セミナー・ウェビナーのLLMOは、単発の告知ページ最適化ではなく、3層の役割分担として設計します。
| 層 | 役割 | AIから見た意味 | 更新頻度 |
|---|---|---|---|
| 開催ページ(各回) | 次回開催の告知と申込受付 | 「いま申し込めるイベント」の一次情報 | 開催ごとに新規作成 |
| 実績アーカイブ | 終了した回のレポートと開催一覧 | 「継続的に開催している主催者」の証拠 | 終了のたびに追加 |
| 主催者・登壇者情報 | 会社概要・登壇者プロフィール | 「誰がやっているか」の照合先 | 常設・随時更新 |
多くの企業は1層目だけを毎回作っては捨てています。AIが推薦の根拠にしやすいのはむしろ2層目と3層目で、ここは開催を重ねるほど自動的に厚くなる資産です。使い捨て運用をやめることが、施策として最も費用対効果の高い一手になります。
開催ページに揃えるべき情報の実装チェックリスト
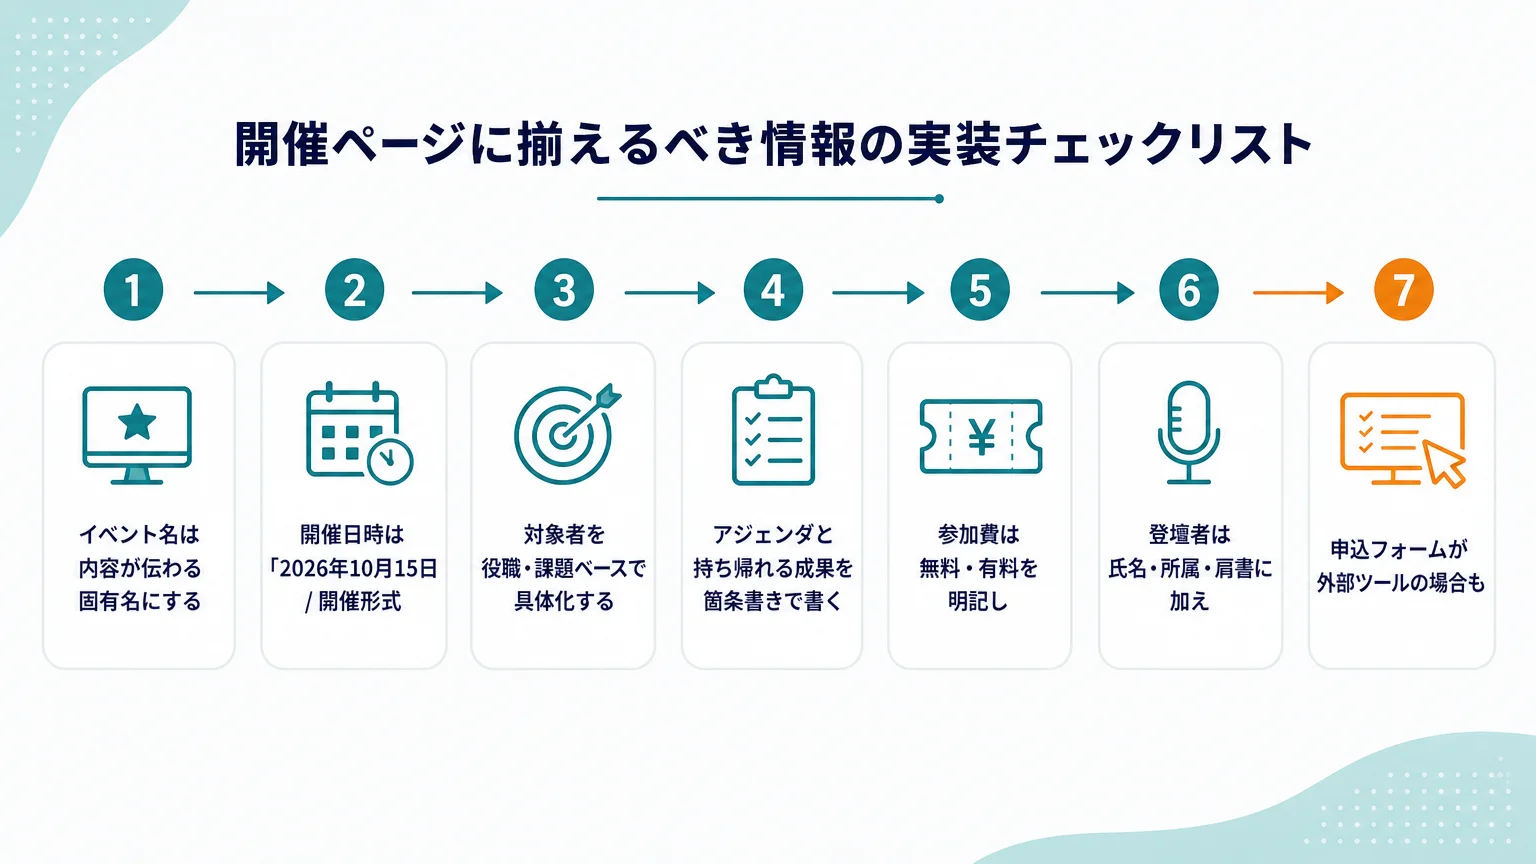
各回の開催ページは、1イベント1URLで作り、以下をすべて本文テキストで完結させます。Googleのイベント構造化データドキュメントも、イベントごとに固有URL(リーフページ)を持たせることを求めています。
- イベント名は内容が伝わる固有名にする(「特別ウェビナー開催!」のような中身の読めない名前を避ける)
- 開催日時は「2026年10月15日(木)14:00〜15:00」のように開始・終了をテキストで書く(バナー画像内だけにしない)
- 開催形式(オンライン/会場/ハイブリッド)と、オンラインの場合の参加方法を明記する
- 対象者を役職・課題ベースで具体化する(「どなたでも歓迎」ではAIも人も自分ごとにできない)
- アジェンダと持ち帰れる成果を箇条書きで書く
- 参加費は無料・有料を明記し、有料なら税込金額を数字で書く
- 登壇者は氏名・所属・肩書に加え、その題材を語れる根拠(経歴・著書・過去登壇)を書く
- 主催者情報として会社名・事業内容・開催実績一覧への内部リンクを置く
- 申込フォームが外部ツールの場合も、開催ページ自体は自社ドメインに置き、フォームへはそこからリンクする
このリストはAI向けの特殊な作業ではなく、参加を検討する人間が知りたい情報と一致しています。「セミナー集客 集まらない」という検索が一定数ある(ラッコキーワード表示値50・2026年9月8日取得)ことが示す通り、集客不振の多くは告知チャネル以前に「ページに判断材料がない」段階で起きています。
開催ページがJavaScriptで描画されるサービスを使っている場合は、AIクローラーが本文を取得できているかも確認が必要です。点検手順はJavaScript描画・SPAがAIに読まれるかの記事にまとまっています。
Event構造化データは2026年9月時点でどこまで効くか
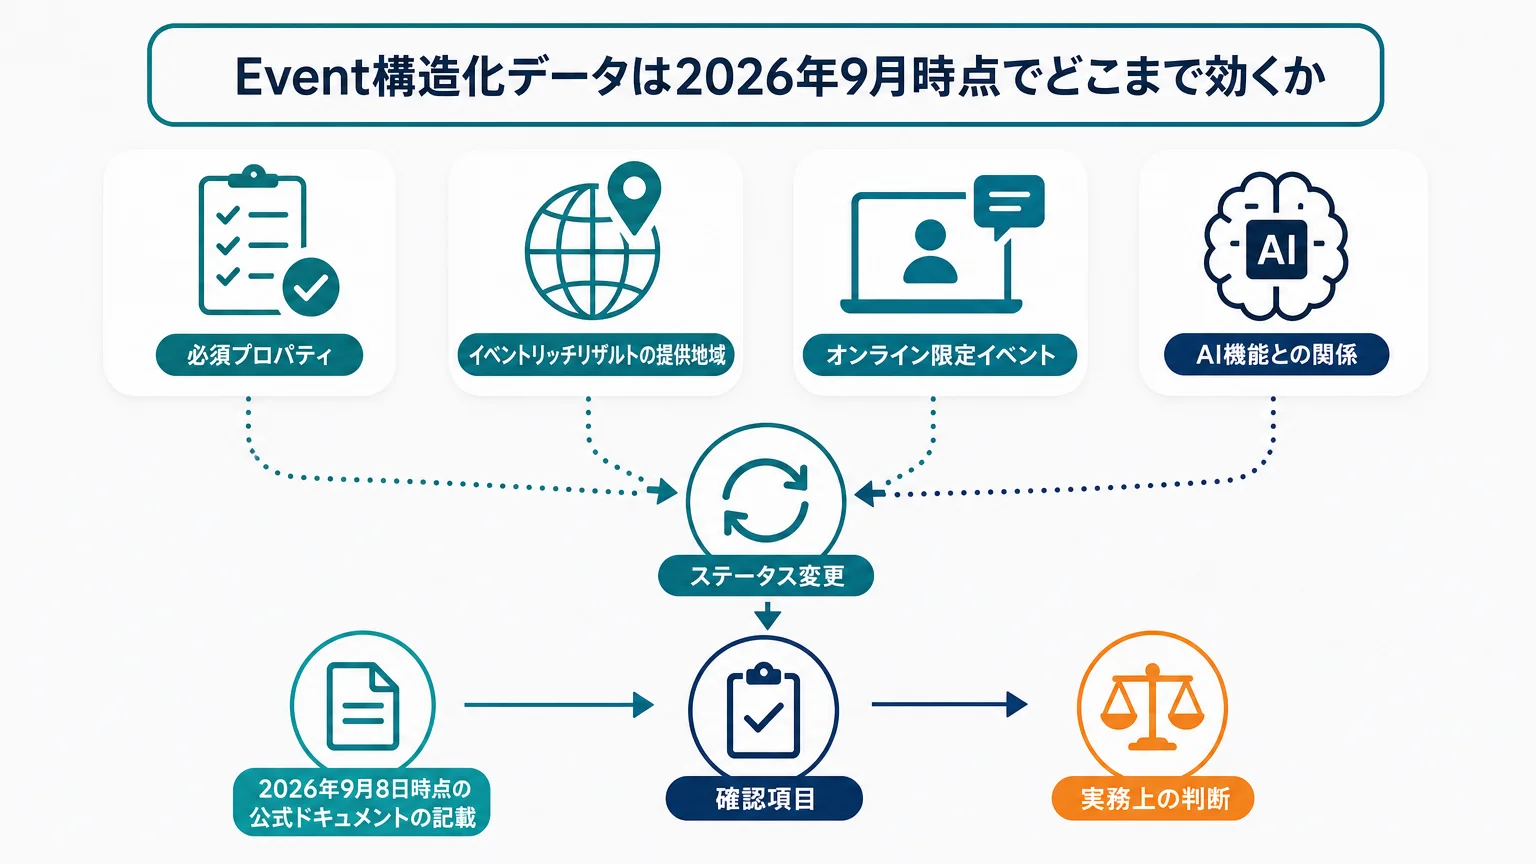
「イベントならEvent構造化データを入れるべき」とよく言われますが、期待値の設定を誤りやすい領域なので、公式ドキュメントで確認できる範囲を先に示します。
| 確認項目 | 2026年9月8日時点の公式ドキュメントの記載 | 実務上の判断 |
|---|---|---|
| 必須プロパティ | name・startDate・location(物理的な場所) | 実装するなら本文と完全一致させる |
| イベントリッチリザルトの提供地域 | 米国・英国・ドイツ・インド・ブラジル等。日本は一覧に含まれない | 日本向けサイトでリッチリザルト表示を主目的にしない |
| オンライン限定イベント | 現実世界の会場を持たない仮想体験はイベントリッチリザルトの対象外 | ウェビナー単体ではリッチリザルトを狙えない前提で設計する |
| AI機能との関係 | AI OverviewやAIモードに載るための特別な構造化データ・AI専用ファイルは不要 | 構造化データを「AIに載る飛び道具」と位置づけない |
| ステータス変更 | 中止・延期時はeventStatusを更新し、元のstartDateは保持する | 中止でもページを消さず状態だけ更新する |
補足すると、schema.orgの語彙としてはeventAttendanceMode(オンライン/オフライン/混合)やVirtualLocation(配信URL)が現在も定義されており、記述自体は可能です。Googleのリッチリザルト対象ではなくても、開催形式・日時・主催者の関係を曖昧さなく機械に渡す手段として意味は残ります。位置づけは「引用を取りにいく武器」ではなく「誤読を減らす保険」です。実装するなら、先に本文の情報を揃え、構造化データはその写しとして付ける順番を守ってください。本文にない情報をマークアップだけに書くのはガイドライン違反です。
終了したセミナーページが次回の集客資産になる
セミナー・ウェビナーのLLMOで最も差がつくのは、終了後の扱いです。推奨する運用は次の通りです。
- 終了した開催ページは削除せず、「開催レポート」に転換する。開催概要はそのまま残し、当日の質疑の抜粋・登壇資料の要点・次回案内を追記する
- 主催者サイトに「開催実績一覧」ページを常設し、年・テーマ別に全開催を並べる
- 反復開催のウェビナーは「シリーズ親ページ」を1枚立て、各回のページを子として束ねる。AIが「このテーマで継続開催している」文脈を1ページで読み取れるようになる
- URLを変更する場合は301リダイレクトで引き継ぐ
累計開催回数や参加者数を書く場合は、集計根拠を持っている実数だけを書いてください。「満足度98%」のような照合できない数値は、AIにとって裏取りできない主張であり、誤引用の火種にもなります。
この「終了後もページを残す」原則は、展示会・イベント集客のAI検索対策と共通の思想です。ただし展示会は主催者(展示会運営側)のドメインに情報が集中するのに対し、自社主催のセミナー・ウェビナーは開催情報も実績も自社ドメインに100%蓄積できます。月次・隔週の反復開催が多い分、シリーズ設計とアーカイブの複利が効きやすいのがセミナー側の特徴です。
登壇者と主催者をAIが照合できるようにする
「おすすめのセミナー」型の質問でAIが重視するもう1つの軸は、誰が話すのかです。AIは登壇者名を、所属企業サイト・著書・寄稿・過去の登壇情報などWeb上の他の情報と突き合わせて、その題材を語れる人物かを推定します。開催ページに名前と顔写真だけが載っている状態では、照合の材料がありません。
整備は3点です。
- 社内登壇者のプロフィールページを自社サイトに常設し、経歴・専門分野・登壇歴・寄稿歴をテキストで一覧できるようにする
- 各開催ページの登壇者欄から、そのプロフィールページへリンクする
- 肩書は「◯◯のプロフェッショナル」のような自称ではなく、社名・役職・著書名・資格など照合可能な事実で書く
これは著者情報のエンティティ実装と同じ問題系で、実装の詳細はE-E-A-Tのエンティティ実装の記事が参考になります。目標は「開催ページ→登壇者プロフィール→開催実績一覧」が相互リンクされ、1つの主催者エンティティとして閉じている状態です。
よくある失敗と立て直し方
実際のセミナー告知でよく見る失敗を、立て直し方とセットで挙げます。
| No. | 失敗パターン | 何が起きるか | 立て直し方 |
|---|---|---|---|
| 1 | 終了後にページを削除 | 実績がAIから見えなくなり、被リンクも404で失われる | 開催レポートへ転換。削除が必要なら実績一覧へ301 |
| 2 | 日時・対象がバナー画像内のみ | クローラーがテキストを取得できず引用材料にならない | 画像の内容を本文テキストでも必ず書く |
| 3 | 外部フォームツールのページだけで告知 | 自社ドメインに何も残らず、掲載終了で情報が消える | 自社に開催ページを立て、フォームへリンクする形に変更 |
| 4 | 毎回ほぼ同文の告知を量産 | 重複度の高いページ群になり、どの回も固有の価値を持たない | シリーズ親ページ+各回の差分(テーマ・登壇者・Q&A)を明確化 |
| 5 | 根拠のない実績数値を掲載 | 照合できない主張として信頼を下げ、誤引用の火種になる | 集計根拠のある実数のみ書く。なければ書かない |
| 6 | 構造化データだけ入れて本文が薄い | AI機能は本文の質を評価するため、マークアップ単体では材料にならない | 先に本文の情報を揃え、構造化データは写しにする |
共通するのは、告知の瞬間だけを最適化して、資産として残す設計がないことです。セミナー・ウェビナーは開催のたびに固有のコンテンツが生まれる、本来LLMOと相性の良い活動です。失敗の大半は書き方より残し方で起きています。
AI経由の集客が動いているかを確かめる方法
短期間で数値が動く施策ではないので、確認は状態ベースで行います。
- AIへの定点質問: 「◯◯(自社テーマ) セミナー おすすめ」「◯◯社のウェビナーはどんな内容か」を、ChatGPT・Gemini・Perplexityに毎月同じ文面で聞き、自社が挙がるか・説明は正確か・どのURLが参照されるかを記録する。観測の組み方はAI回答モニタリングの実務設計にまとまっています
- 参照URLの中身を見る: 引用されたのが開催ページか実績一覧か無関係なページかを確認する。無関係なページばかり引かれるなら、開催情報側の整備不足のシグナル
- 申込経路に選択肢を足す: 申込フォームの「何で知りましたか」にAI(ChatGPT等)の選択肢を追加する。GA4側の流入計測はAI検索流入のGA4計測手順を参照
- Search Consoleは合算仕様を前提に読む: AI Overview経由の表示・クリックはWeb検索タイプに合算されるため単独では切り出せません。読み方はサーチコンソールのAI Overview計測の記事で整理しています
「AI経由で申込が◯%増える」といった一般統計は、2026年9月時点で信頼できるものが確認できていません。自社の定点観測の記録だけが判断根拠になります。
セミナー・ウェビナー集客のLLMOに関するFAQ
Q1. ウェビナーの集客が集まらないとき、LLMOから着手すべきですか?
最初にやるべきは開催ページの情報整備です。これはLLMO対策であると同時に、メール・SNS・広告など既存チャネルから来た人の申込率にも直接効きます。判断材料が揃っていないページのまま告知チャネルを増やしても、取りこぼしが続きます。整備が済んでから、実績アーカイブと登壇者情報の常設に進む順番が実務的です。
Q2. Event構造化データを入れれば、AIに引用されやすくなりますか?
その保証はありません。Googleの公式ドキュメントは、AI OverviewやAIモードに載るための特別な構造化データやAI専用ファイルは不要と明言しています(2026年9月8日確認)。さらにイベントリッチリザルトは日本が提供地域外で、オンライン限定イベントは対象外です。位置づけは開催情報の誤読を減らす整備であり、本文の充実が先です。
Q3. Peatixなどのイベントポータルと自社ページはどちらを優先すべきですか?
併用しつつ、正本は自社ドメインの開催ページに置くべきです。ポータルは既存の集客力がある一方、掲載が終わると情報が消え、実績が自社に蓄積しません。ポータルの説明文には自社開催ページへのリンクを含め、開催レポートは必ず自社側に残す運用を推奨します。
Q4. 終了したウェビナーの録画はそのまま公開すればよいですか?
動画単体ではAIがテキストとして参照しにくいため、レポート記事+要点の書き起こしをHTMLで併載する形を推奨します。全編公開するかどうかは集客戦略の問題ですが、引用可能性の観点では書き起こし・要約の有無が効きます。動画とAI検索の関係はYouTube動画がAI検索に引用される条件で扱っています。
Q5. セミナー集客代行に外注する場合、何を確認すべきですか?
「開催ページをどのドメインに作るか」「終了後のページとデータの帰属」の2点が最重要です。代行会社のドメインやツール内にだけページが作られる契約では、開催を重ねても自社サイトに実績が蓄積しません。自社ドメイン上に開催ページとレポートが納品物として残る契約かを、発注前に確認してください。
ここまでの要点
- セミナー・ウェビナー集客のLLMO対策は、開催ページ・実績アーカイブ・主催者/登壇者情報の3層を自社ドメインに揃える設計の問題
- Googleの公式ドキュメント(2026年9月8日確認)の通り、AI機能向けの特別なマークアップやAI専用ファイルは不要。材料になるのはインデックス可能で独自性のある開催情報と実績
- イベントリッチリザルトは日本が提供地域外、オンライン限定イベントは対象外。Event構造化データは「誤読を減らす保険」として期待値を持つ
- 最大の分岐点は終了後の扱い。ページを消す運用をやめ、レポート転換・実績一覧・シリーズ親ページで蓄積を始める
- 効果確認はAIへの定点質問と参照URLの記録が基本。一般統計や保証値は存在しない
自社の開催ページと主催者情報がAIからどう見えているかは、LLMO診断チェックリストで自己点検できます。点検して、実績アーカイブの構造や登壇者エンティティの設計など自社だけでは判断しづらい箇所が残った場合は、UravationのLLMO診断で開催ページからエンティティまで含めた現状評価を受ける選択肢もあります。まずは直近1回分の開催ページを、この記事のチェックリストで見直すところから始めてください。
公式情報で確認するポイント
AI検索まわりは仕様変更が多いため、記事公開前後に公式情報を確認し、本文の言い切りや実装方針を更新します。
- Google Search Central「Optimizing your website for generative AI features」 生成AI検索に対して、通常のSEO・技術要件・独自性の扱いを確認する公式ガイド。
- Google Search Central「Creating helpful, reliable, people-first content」 人間に役立つ信頼性の高いコンテンツを評価するための公式観点。
本体メディアであわせて確認する記事
この記事のテーマを、Uravation本体メディアで検索流入のあるAIツール・モデル解説にもつなげて確認できます。
AI活用書籍シリーズ累計59,900部の著者チームが監修。自社7メディアの実運用でAI検索からの引用・流入を継続計測しており、その一次データと公式情報に基づいて、企業サイトで実務的に使える形へ整理しています。仕様変更が多い領域のため、公開前後に公式情報と本文の整合性を確認します。
AI検索診断・情報源設計支援に進める
この記事のテーマを自社サイトに当てはめ、公開情報、根拠ページ、FAQ、内部リンク、構造化データ、llms.txtのどこを確認すべきかを整理します。
AI検索攻略の前後の記事
同じ連載の前後の記事へ進み、LLMO、AIO、GEO、AI検索の論点を順番に確認できます。
関連するUravationの導線
AI検索攻略は、Uravation本体のAI活用メディアとサービス導線につながる専門テーマとして運用します。