2026年9月10日(米国時間)、OpenAIはChatGPT Workの新機能「Data agent」を発表しました。Amazon Redshift・Google BigQuery・Snowflake・Databricksなど7種類以上の社内データ基盤にChatGPTを直接つなぎ、SQLを1行も書かずに「なぜ売上が鈍化したのか」と質問するだけで、原因調査から対話型ダッシュボードの作成・共有までを1つの会話で完結させる機能です。日本のNTTデータがすでにAlphaプログラムで利用しており、日本企業にとっても「対岸の話」ではありません。
まず、2026年9月17日時点でわかっていることを3行でまとめます。
- 何が:ChatGPT Workに、社内データベース・BIツールへ接続して分析・ダッシュボード作成を行う「Data agent」が追加された(プラグインとして提供)
- いつから:2026年9月10日の発表時点でChatGPT WorkのPluginsディレクトリに「Data」として公開済み。管理者が有効化すれば使い始められる
- 誰に影響:ChatGPT WorkをBusiness/Enterprise等で契約中(または検討中)の企業。特に「BIツールのライセンス費用と専門人材の壁でダッシュボードが普及していない」会社に直撃する発表
対象読者:ChatGPT Workを社内展開している、または導入を検討している情報システム担当者・データ活用推進担当者・経営者。
最終更新:2026年9月(発表内容は2026年9月17日時点の公式発表に基づく)
正直、この発表は「ChatGPTが便利になった」という話にとどまりません。これまでTableauやPower BIの契約とデータアナリストの工数が前提だった「社内データを見る」という行為が、チャットの質問1つに置き換わる可能性がある。100社以上の企業でAI導入を支援してきた立場から見ても、データ活用の民主化という点で2026年後半の重要発表の1つだと感じています。以下、公式発表の一次情報だけを根拠に、事実と「まだわかっていないこと」を切り分けて整理します。
9月10日に発表された事実の整理
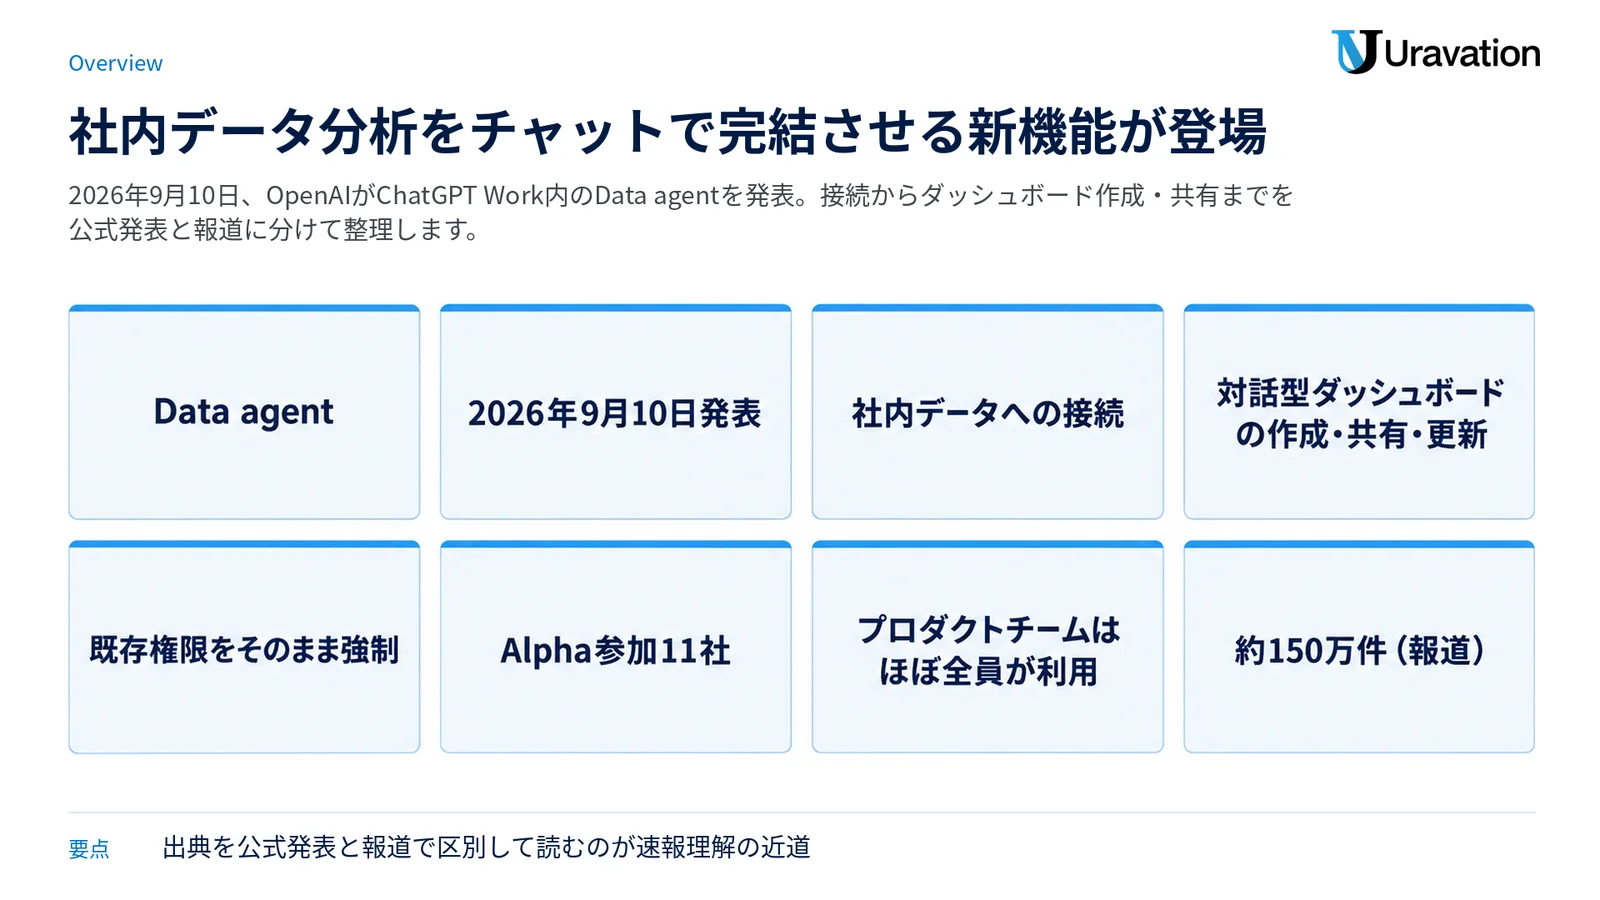
OpenAIの公式発表「Now everyone can put data to work」(2026年9月10日付)に書かれている内容を、項目別に整理したのが次の表です。出典はすべて公式発表本文で、報道由来の情報は本文中で「報道では」と区別しています。
| 項目 | 内容 | 出典 |
|---|---|---|
| 機能名 | Data agent(ChatGPT Work内のプラグイン「Data」として提供) | OpenAI公式発表 |
| 発表日 | 2026年9月10日(米国時間) | OpenAI公式発表 |
| できること | 社内データへの接続、変化要因の調査、対話型ダッシュボードの作成・共有・更新。クエリ記述や新しい分析ツールの習得は不要 | OpenAI公式発表 |
| 接続先データ基盤 | Amazon Redshift、Datadog、Google BigQuery、ClickHouse、Databricks、MongoDB、Snowflakeなど。Google Drive・SharePoint上のファイルも分析対象にできる | OpenAI公式発表 |
| 業務文脈の取り込み | Databricks Genie Ontology、dbt、GitHub、Snowflake Horizon、BIダッシュボードなどから、自社の業務用語・指標定義・独自計算・データ間の関係を取り込んで解釈する | OpenAI公式発表 |
| BIツール連携 | Omni、Oracle BI、Power BI、Sigma、Tableau、ThoughtSpotのダッシュボードを自然言語で構築・操作できる | OpenAI公式発表 |
| 権限管理 | 管理者がどのデータ接続を許可し、どのロールが使えるかを選択。クエリは接続アカウントの既存権限(テーブル・行・列単位の制限)をそのまま強制する | OpenAI公式発表 |
| アクション実行 | 分析結果からの次の一手を提案し、Slackやメールでの共有、ユーザーが承認した操作の実行まで行う | OpenAI公式発表 |
| Alpha参加企業 | NTTデータ、Thermo Fisher Scientific、ServiceTitan、Zipline、Turing、micro1、Unit8など11社が事例として掲載 | OpenAI公式発表 |
注目したいのは、OpenAI自身の社内利用実績が公式発表に明記されている点なんです。発表によれば、OpenAIのプロダクトチームはほぼ全員が、GTM(営業・マーケティング)組織は3分の2以上が、ChatGPT Work内のデータエージェントを使って自分でデータ分析をしているとのこと。「データチームに依頼して待つ」文化を自社でやめた上でのプロダクト化、という順番です。
また、技術評論社(gihyo.jp)の報道では、Data agentには分析準備・データ分析と検証・レポート作成・公開共有と定期更新の領域で約20のスキルが搭載され、プラグインのインストール数はすでに約150万件とされています(この2点は公式発表本文には記載がなく、報道由来の情報です)。
NTTデータの事例が示す「何が変わるか」
日本企業への影響を考える上で最も参考になるのが、Alphaプログラムに参加しているNTTデータのコメントです。公式発表に掲載されたNTTデータグループGlobal AI Officeの庄野裕二氏の発言を訳すと、こうなります。
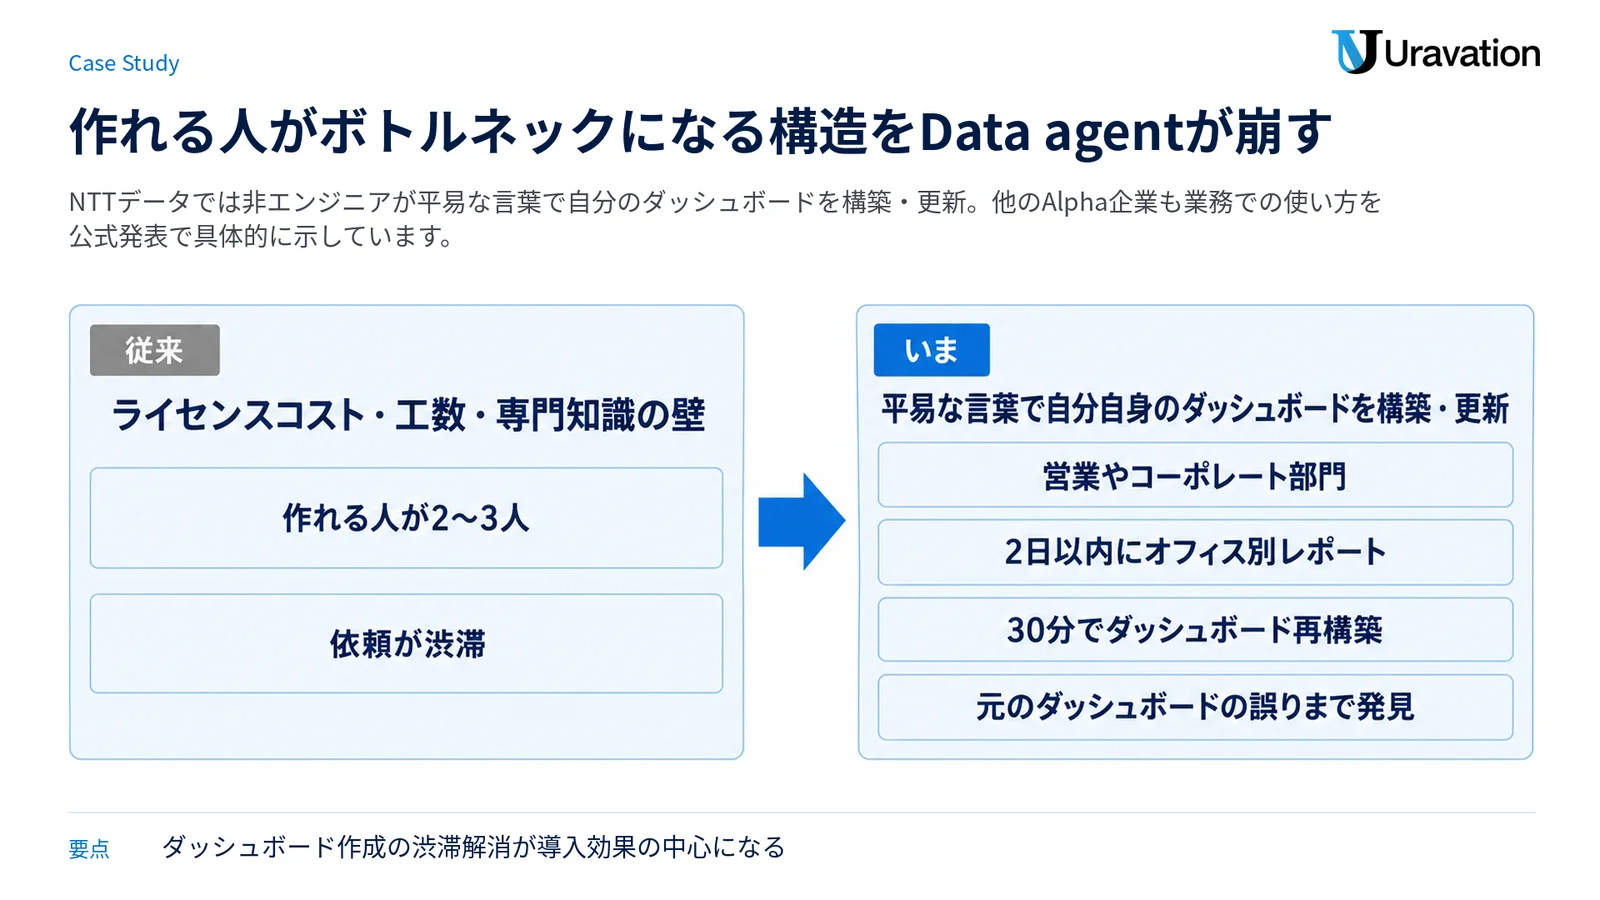
「NTTデータでは、ライセンスコスト・工数・技術的な専門知識の壁があり、ダッシュボードの利用を組織全体に広げることが難しかった。ChatGPT WorkのData agentによって、営業やコーポレート部門を中心に多くの非エンジニアが、平易な言葉で自分自身のダッシュボードを構築・更新できるようになった」(OpenAI公式発表より訳出)
これはBIツールを導入した企業の多くが抱える悩みそのものです。研修の現場でも「Tableauは入れたが、ダッシュボードを作れる人が2〜3人しかいなくて依頼が渋滞している」という相談は本当によく聞きます。Data agentが狙っているのは、まさにこの「作れる人がボトルネックになる」構造の解消です。
他のAlpha企業の使い方も具体的で、ServiceTitanは自社AI機能の利用者と非利用者のキャンペーン実施率の差を可視化するダッシュボードを構築、会計事務所のDoeren Mayhewはマーケティング・財務部門が2日以内にオフィス別のレポートを整備した、と公式発表に記載されています。評価パートナーのmicro1に至っては、オペレーションチームが30分でパフォーマンス追跡ダッシュボードを作り直し、その過程で元のダッシュボードの誤りまで発見したとのこと。「レポートの正しさを機械にダブルチェックさせる」という使い方は、日本の経理・経営企画部門にもそのまま持ち込める発想です。
精度の鍵は「自社の言葉」を読み込むセマンティックレイヤー
チャットでデータ分析と聞くと「うちの業務用語なんて理解できないでしょ」と思うかもしれません。実はここが今回の発表の技術的な肝で、Data agentは生のテーブルだけを見るのではなく、自社の業務用語・指標定義・独自の計算式・データ間の関係を読み込んだ上でデータを解釈する設計になっています。
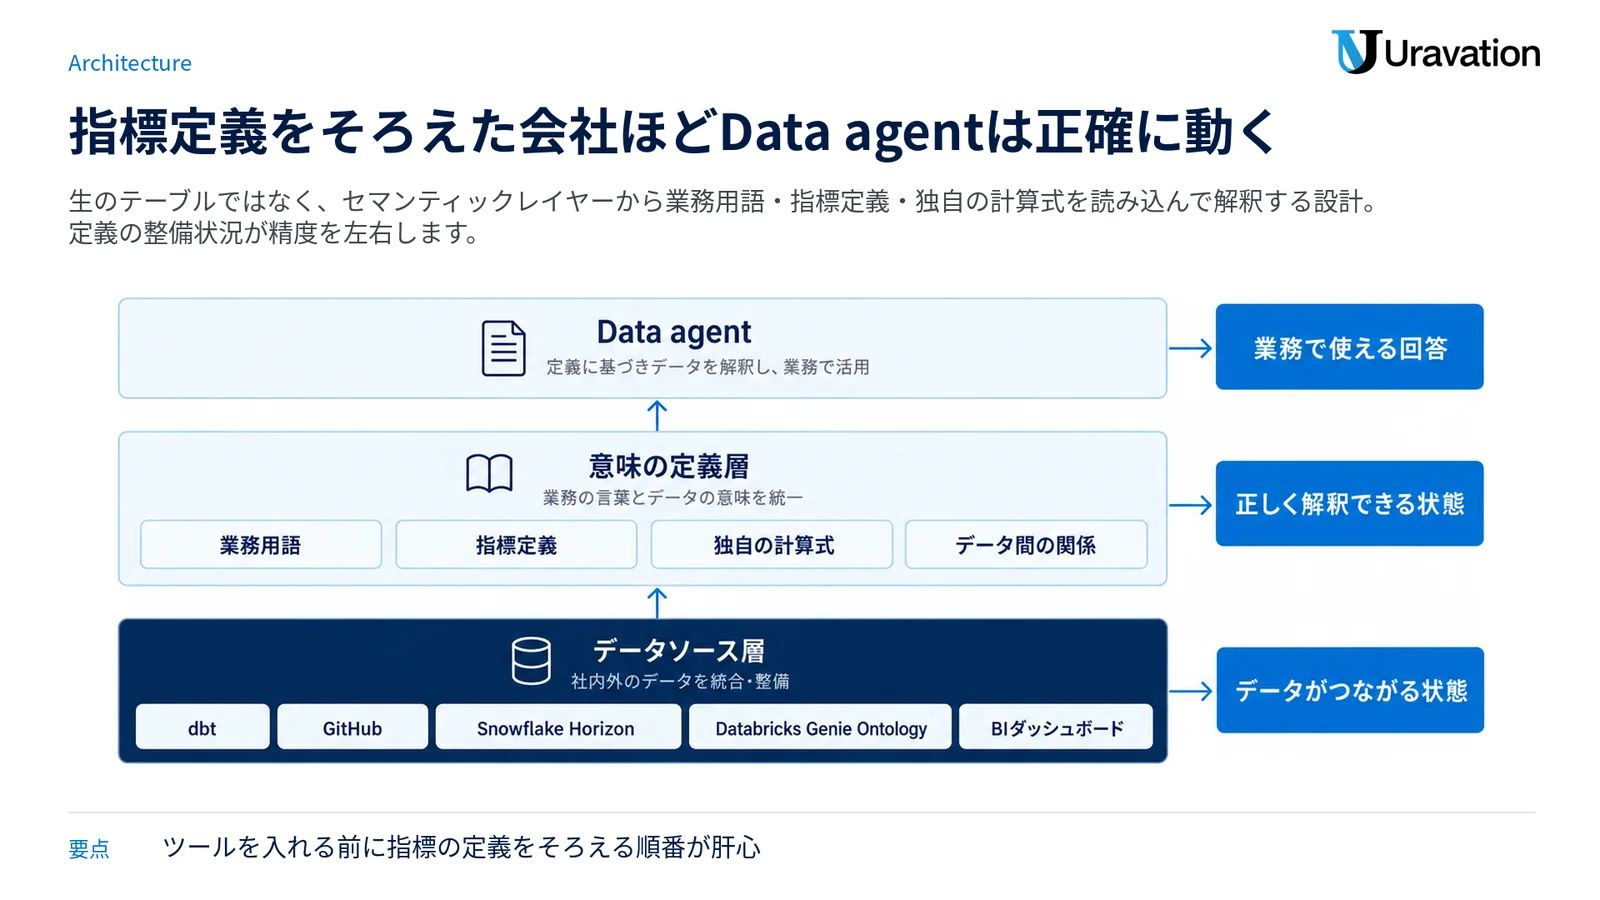
この「自社の文脈」の供給源として公式発表が挙げているのが、Databricks Genie Ontology、dbt、GitHub、Snowflake Horizonといったセマンティックレイヤー(データに業務上の意味づけを与える定義層)と、既存のBIダッシュボードです。たとえば「アクティブユーザー」という言葉ひとつでも、会社によって定義は違います。dbtなどで指標定義をコード管理している会社なら、その定義がそのままData agentの解釈に使われるわけです。
逆に言うと、指標の定義が部署ごとにバラバラで、Excelの中に暗黙知として埋まっている会社では、Data agentも「どの数字が正なのか」を判断できません。OpenAI自身も、社内展開にあたってデータチームが共有のビジネス定義を作り、アクセスルールを設定し、機微データへのセーフガードを整備したことを発表内で明かしています。ツールを入れる前に定義をそろえる——この順番は日本企業でも変わらないはずです。
料金・対象プラン・日本からの利用可否
速報段階で一番気になるお金と提供条件の話を、「公式に確認できたこと」と「まだ書かれていないこと」に分けて整理します。
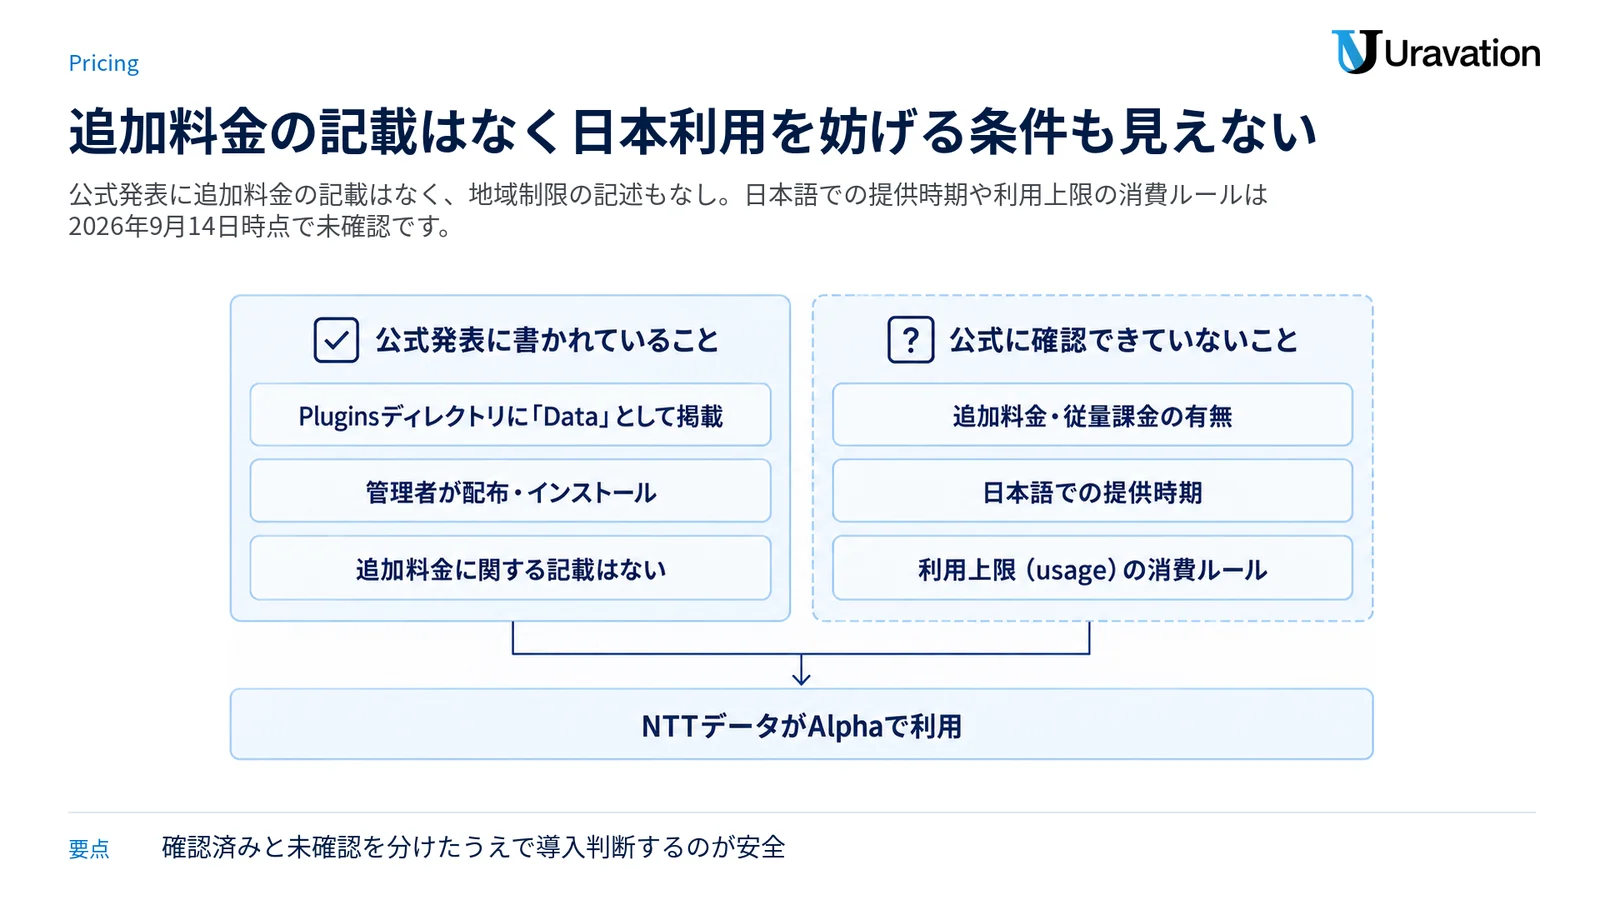
公式発表に書かれていること
- Data agentはChatGPT WorkのPluginsディレクトリに「Data」として掲載されており、管理者がWorkspace settings > Plugins から組織に配布・インストールできる
- DatabricksやSnowflakeなど接続先ごとのデータソースプラグインも管理者が有効化し、誰が使えるかを管理する
- 発表本文にData agentの追加料金に関する記載はない(追加課金の告知も、無料であるという明言もない)
2026年9月17日時点で公式に確認できていないこと
- Data agentの利用に伴う追加料金・従量課金の有無(発表本文に記載なし)
- 日本語での提供時期・日本リージョンでの提供条件(発表本文に提供地域を限定する記載はないが、日本向けの明示もない)
- 接続クエリの実行量に応じた利用上限(usage)の消費ルール
前提となるChatGPT Work自体は、既存のChatGPTプラン(Plus/Pro/Business/Enterprise/Edu の対応プラン)に含まれる機能で、単独の追加契約は不要です。プラン別の対応状況と料金の詳細は「ChatGPT Workとは|できること・料金・使い方」で整理しているので、そちらを参照してください。なお、Data agentの管理機能はワークスペース管理を前提としているため、実務上はBusiness/Enterpriseでの利用が中心になると考えられます。
日本からの利用については、公式発表に地域制限の記載がなく、日本企業のNTTデータがAlphaで利用している事実があります。つまり「日本の企業だから使えない」という状況ではありません。ただし社内データを接続する機能の性質上、自社の契約形態(データ処理の地域要件など)は導入前に契約窓口へ確認するのが安全です。
使い始める手順と公式プロンプト例
公式発表に記載されている開始手順は、管理者側とユーザー側で次の通りです。
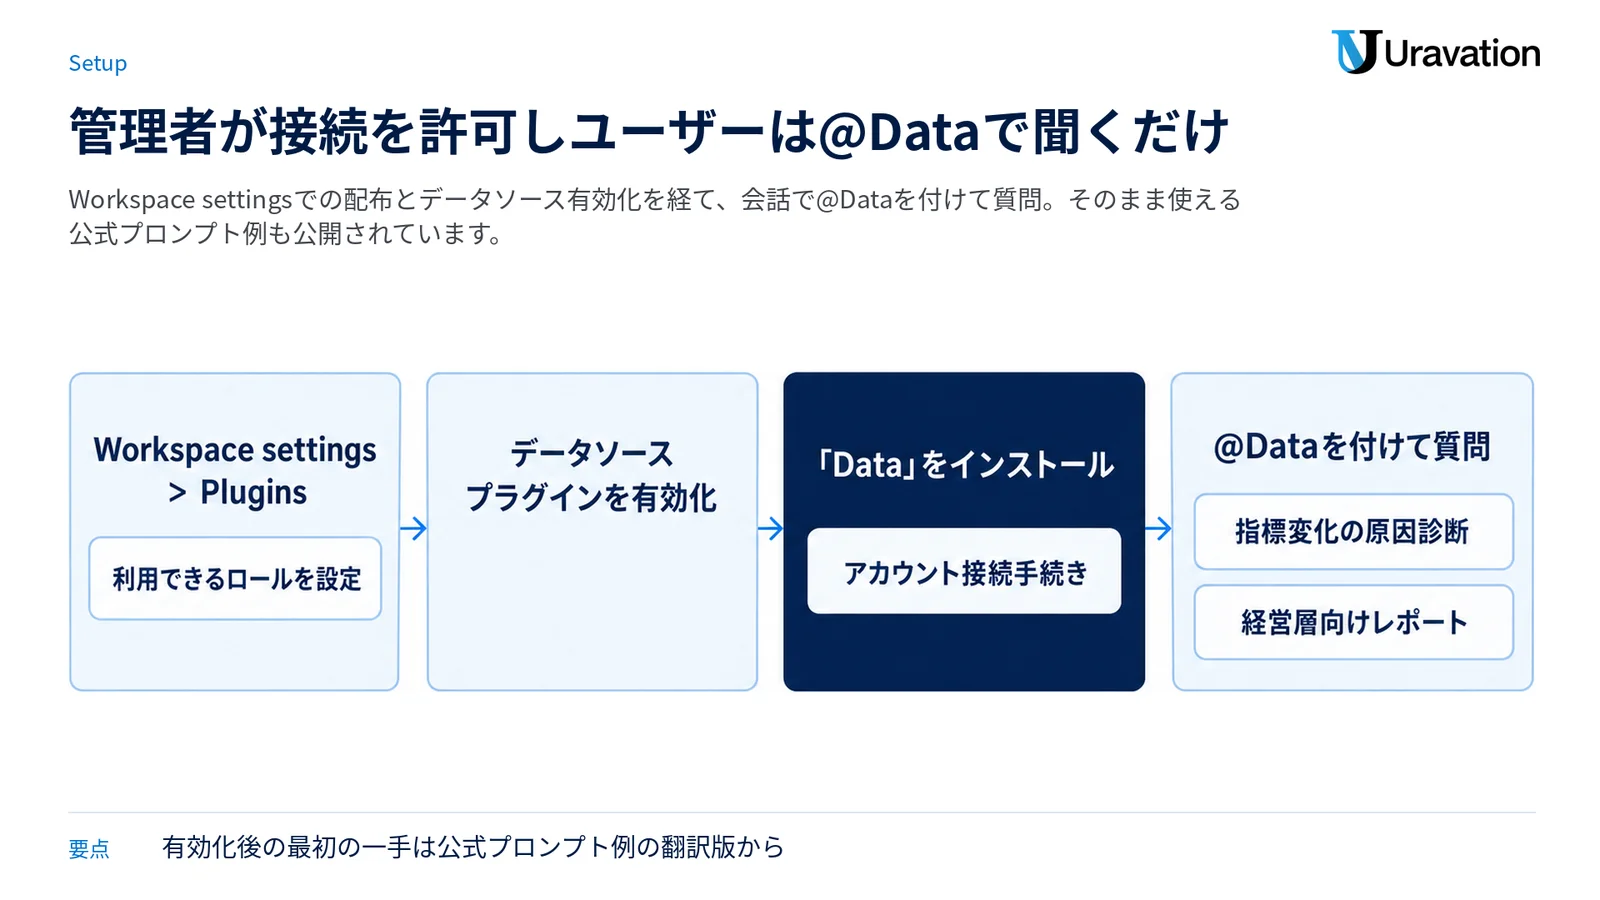
- 管理者:ChatGPT WorkのWorkspace settings > Plugins からData agentをチームに配布またはインストール可能にする
- 管理者:DatabricksやSnowflakeなど、接続を許可するデータソースプラグインを有効化し、利用できるロールを設定する
- ユーザー:Pluginsディレクトリで「Data」を探してインストール(済みの場合は不要)。必要なアカウント接続手続きを完了する
- ユーザー:会話で
@Dataを付けてビジネス上の質問を投げる
OpenAIは発表内で、そのまま使えるプロンプト例を公開しています。日本語に訳したものを載せておくので、有効化した際の最初の一手にどうぞ。
公式例1:指標変化の原因診断
@Data 先週、週次アクティブユーザー数が変化した理由を診断してください。
主な要因の候補を特定し、過去の期間と比較した上で、
次に確認すべきチェック項目を提案してください。
公式例2:KPIフレームワークの設計
@Data 新しいプロダクト領域のKPIフレームワークを設計してください。
主要指標、その先行指標(ドライバー)、ガードレール指標、目標値、
データ検証の要件を含めてください。
公式例3:経営層向けレポート作成
@Data 今月の指標を経営層向けのアップデートにまとめてください。
実績値、前期間との比較、変動要因、注意点、推奨アクションを
含めてください。
公式例4:プロダクト導入ダッシュボード
@Data 自社プロダクトの導入状況を追跡するダッシュボードを作成してください。
インストール・初回利用から継続利用・リテンションまでを対象に、
顧客がつまずいている箇所を見つけられるようにしてください。
応用の想定例として、日本企業の月次業務に当てはめるならこんな形になります(こちらは公式例ではなく、構成例です)。
@Data 部門別の月次経費データを分析し、前年同月比で増加率が大きい
費目の上位5つを特定してください。増加の背景として考えられる要因を
挙げた上で、経営会議で共有できるダッシュボードを作成してください。
この記事の内容、自社の業務でも回したい?
AI顧問(月次伴走)が、貴社の業務に合わせて導入から定着まで並走します。研修4,000名以上・支援100社以上の実績。まずは30分の壁打ちから。
日本企業は今、何をすべきか
速報を読んだ後の実務対応を「今すぐやること」「やらなくていいこと」「様子見でよいこと」の3つに仕分けします。
今すぐやること
- 自社のデータ基盤が対応リストにあるか確認する:Redshift・BigQuery・Snowflake・Databricks・MongoDB・ClickHouse・Datadogのいずれかを使っているなら、接続候補として検証の土台があります
- ChatGPT Work契約企業は、プラグインの管理ポリシーを決める:Data agentは管理者が配布可否とロールを制御する設計なので、「誰に・どのデータ接続を許可するか」の方針がないまま現場任せにしない
- データ側の権限設定を棚卸しする:クエリは接続アカウントの既存権限をそのまま使います。逆に言えば、今のデータベース権限がザルだと、ザルのままAIから見えるようになる。行・列レベルの権限が実態に合っているかの確認が先です
やらなくていいこと
- 既存BIツールの解約検討:Data agentはTableauやPower BIを置き換えるのではなく、それらのダッシュボードを自然言語で構築・操作する連携設計です。少なくとも現時点で「BI廃止」を判断する材料はありません
- この機能のためだけの新規データ基盤導入:対応データソースを使っていない企業が、Data agentを目的にSnowflake等を新規契約するのは本末転倒です。まず手元のGoogle Drive・SharePoint文書の分析から試せます
様子見でよいこと
- 全社展開の判断:追加料金の有無や利用量の消費ルールが公式に明確化されていない段階で、全社ロールアウトを決める必要はありません。まず情報システム部門と一部部門でのパイロットが現実的です
- 日本語での分析精度の評価:日本語の業務用語・指標定義をどこまで正確に扱えるかは、公式発表からは判断できません。自社データでの検証結果が出るまでは判断を保留してよい領域です
ちなみに同日の9月10日には、金融業界向けの「ChatGPT for Financial Services」も発表されています。OpenAIが業種・職種特化のエージェントを立て続けに出してきている流れの中の1つ、と捉えるのが正確です。競合との位置づけで言えば、AnthropicのClaude Coworkも同じ「業務エージェント」の領域にいます。両者の設計思想の違いは「ChatGPT WorkとClaude Coworkの違い|どっちを選ぶ」で比較しているので、ツール選定中の方はあわせてどうぞ。
よくある質問
Q. Data agentは追加料金がかかりますか?
A. 2026年9月17日時点で、公式発表に追加料金に関する記載はありません。無料と明言されているわけでもないため、正式な課金条件は今後の公式情報の確認が必要です。前提となるChatGPT Work自体は既存プラン内の機能として提供されています。
Q. どのプランで使えますか?
A. ChatGPT Workのプラグインとして提供され、ワークスペース管理者による配布・権限設定を前提とした設計です。管理機能の性質上、Business/Enterpriseでの利用が中心になると考えられます。プラン別のChatGPT Work対応状況は関連記事で整理しています。
Q. 日本から使えますか?日本語には対応していますか?
A. 公式発表に提供地域を限定する記載はなく、日本のNTTデータがAlphaプログラムで利用しています。一方、日本語での提供条件や分析精度に関する公式情報は2026年9月17日時点で確認できていません。
Q. セキュリティ面は大丈夫ですか?社内データを全部読まれませんか?
A. 公式発表によれば、管理者がどのデータ接続を許可し、どのロールが使えるかを選択でき、クエリは接続アカウントの既存権限(テーブル・行・列単位の制限)を強制します。つまり「ChatGPTだから全データが見える」のではなく、接続したアカウントに見える範囲しか見えない設計です。ただし、その前提となる自社側の権限設計が適切であることが条件になります。
Q. データベースがなくても使えますか?
A. Google DriveやSharePoint上のファイル・文書を分析対象に取り込めると公式発表に記載されています。データウェアハウスを持たない企業でも、共有ドライブの実績ファイルを起点に試すことは可能です。
要点の整理
- 2026年9月10日、OpenAIがChatGPT Workの「Data agent」を発表。社内データ基盤に接続し、質問だけで分析から対話型ダッシュボード作成・共有までを1つの会話で行う
- 接続先はRedshift・BigQuery・Snowflake・Databricks・MongoDB・ClickHouse・Datadogなど。Tableau・Power BI等のBIツールとも連携し、既存権限をそのまま強制する設計
- 追加料金と日本語での提供条件は2026年9月17日時点で公式に確認できていない。NTTデータがAlpha参加済みで、日本から使えない状況ではない
- 企業側の先回り準備は「対応データ基盤の確認」「プラグイン管理ポリシー」「データ権限の棚卸し」の3点。BI解約や新規基盤導入は不要
「作れる人がいないからデータが見られない」という組織の詰まりを、会話で解消しにきた発表です。裏を返せば、データの権限設計と業務用語の定義という地味な下ごしらえができている会社ほど、この波にすぐ乗れます。発表の続報(料金条件・日本語対応)が公式に出た時点で、この記事も更新します。
佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。100社以上の企業向けAI研修・導入支援。著書『AIエージェント仕事術』『Claude仕事術』(SBクリエイティブ・シリーズ累計約6万部)。SBクリエイティブ「ビジネス+IT」ほかで生成AI連載を執筆(NewsPicks最大1,125ピックス)。
この発表を受けて動きたい方へ、次の一歩を3つ用意しています。
- 今日できること:自社で使っているデータ基盤・BIツールが本文の対応リストに含まれるかを確認し、情報システム部門に共有する
- 社内展開を検討中の方:ChatGPT Workのプラン別対応状況を「ChatGPT Workとは|できること・料金・使い方」で確認する
- 導入判断に迷ったら:自社のデータ環境でどこから試すべきか、AI導入支援の無料相談で壁打ちも受け付けています
参考・出典
- OpenAI「Now everyone can put data to work」(2026年9月10日・参照日: 2026-09-17)
- gihyo.jp「OpenAI、ChatGPT WorkのDataエージェントを紹介 ——自然言語で企業データを分析、ダッシュボードも作成」(参照日: 2026-09-17)
- GIGAZINE「ChatGPT Workに企業データを読み取らせ回答やダッシュボード作成に利用できる『Data agent』が登場」(参照日: 2026-09-17)
- ITmedia AI+「ChatGPT Work、質問するだけで社内データ分析・グラフやダッシュボードも作る『Data agent』」(参照日: 2026-09-17)
この記事の内容を社内展開する方へ: ChatGPT/GPT系 法人利用スタートキット(無料・PDF 27ページ) をダウンロードできます。
AIエージェント実装、設計から運用まで伴走します
PoCで終わらせない。AI顧問(月次伴走)として、エージェント設計から運用定着まで貴社の業務プロセスに合わせて並走します。
- マルチエージェント実装の実戦経験
- 初回30分無料・即日返信
お問い合わせフォームから24時間以内にUravation担当者がご返信します。