2026年9月10日(米国時間)、OpenAIが金融機関向けの「ChatGPT for Financial Services」を発表しました。中身は新しいモデルではなく、GPT‑6 AstraにDaloopa・PitchBook・LSEG News・Crunchbaseなどのプレミアム金融データを内蔵し、OpenAI自身のインフラでインデックス化・ホスティングした「データ同梱パッケージ」です。提供対象は「適格な金融機関(eligible financial institutions)」で、価格・最低シート数・提供地域・適格基準はいずれも公表されていません。日本の金融機関が対象に含まれるかどうかも、2026年9月14日時点で公式に確認できていません。
結論:これは「新モデル」の発表ではなく「データ契約とガバナンスの束ね直し」の発表です。日本の実務者が今すぐ動くべきなのは導入検討ではなく、既存のデータベンダー契約と外部委託管理の棚卸しのほうです。
この記事の要点
- 何が:ChatGPT Workを金融業務向けに仕立てた製品。GPT‑6 Astraと内蔵金融データ、企業テンプレート、Enterprise相当のガバナンス機能の組み合わせ
- いつから:2026年9月10日(米国時間)発表、同日から適格な金融機関に提供。一般のChatGPTプランに自動で降ってくる機能ではない
- 誰に影響:一次的には投資銀行・エクイティリサーチ部門。日本の一般事業会社や地域金融機関に今日ただちに影響する変更は確認できていない
対象読者:金融機関のIT・企画・コンプライアンス担当者と、金融業界を顧客に持つ事業会社のAI推進担当者
読了後にできること:この発表が自社の稟議に関係するのか、今は静観でいいのかを、公式に確認できた事実だけで仕分けできる
最終更新:2026年9月14日(一次ソース=OpenAI公式発表・OpenAI公式GPT‑6 Astraページ)
判断の分かれ目は「データを誰が持つか」に尽きる
今回の発表を評価する軸は、正直ひとつしかないと思っています。金融データを、従来どおりベンダー側に置いたまま呼びに行くのか、それともOpenAI側にインデックス化して置くのか。ここです。
モデルの賢さの話でも、UIの話でもありません。OpenAIは公式発表のなかで、内蔵データについて「We index and host this data on OpenAI infrastructure(このデータはOpenAIのインフラ上でインデックス化・ホスティングする)」と明言しています。従来のMCPコネクタのように「問い合わせのたびに第三者システムへ取りに行く」構造ではなく、データの置き場所そのものが動く設計です。
この一点が決まると、後続の論点が芋づる式に決まります。外部委託先の管理、既存データ契約との二重払い、監査証跡の所在、情報障壁(チャイニーズウォール)の担保。逆に言えば、ここを曖昧にしたまま「AIで資料作成が速くなるらしい」という話にすると、稟議は一周回って止まります。
企業向けのAI研修で金融系の参加者からいちばん多く受ける質問が「結局、うちのデータはどこに行くんですか」なんです。今回は、その答えが従来と変わる製品だという理解から入るのが正解だと思っています。業界全体の位置づけは金融業界AI完全ガイド|銀行・信金・証券の実装事例とROIで整理しています。
発表内容の事実整理(2026年9月14日時点で公式に確認できたもの)
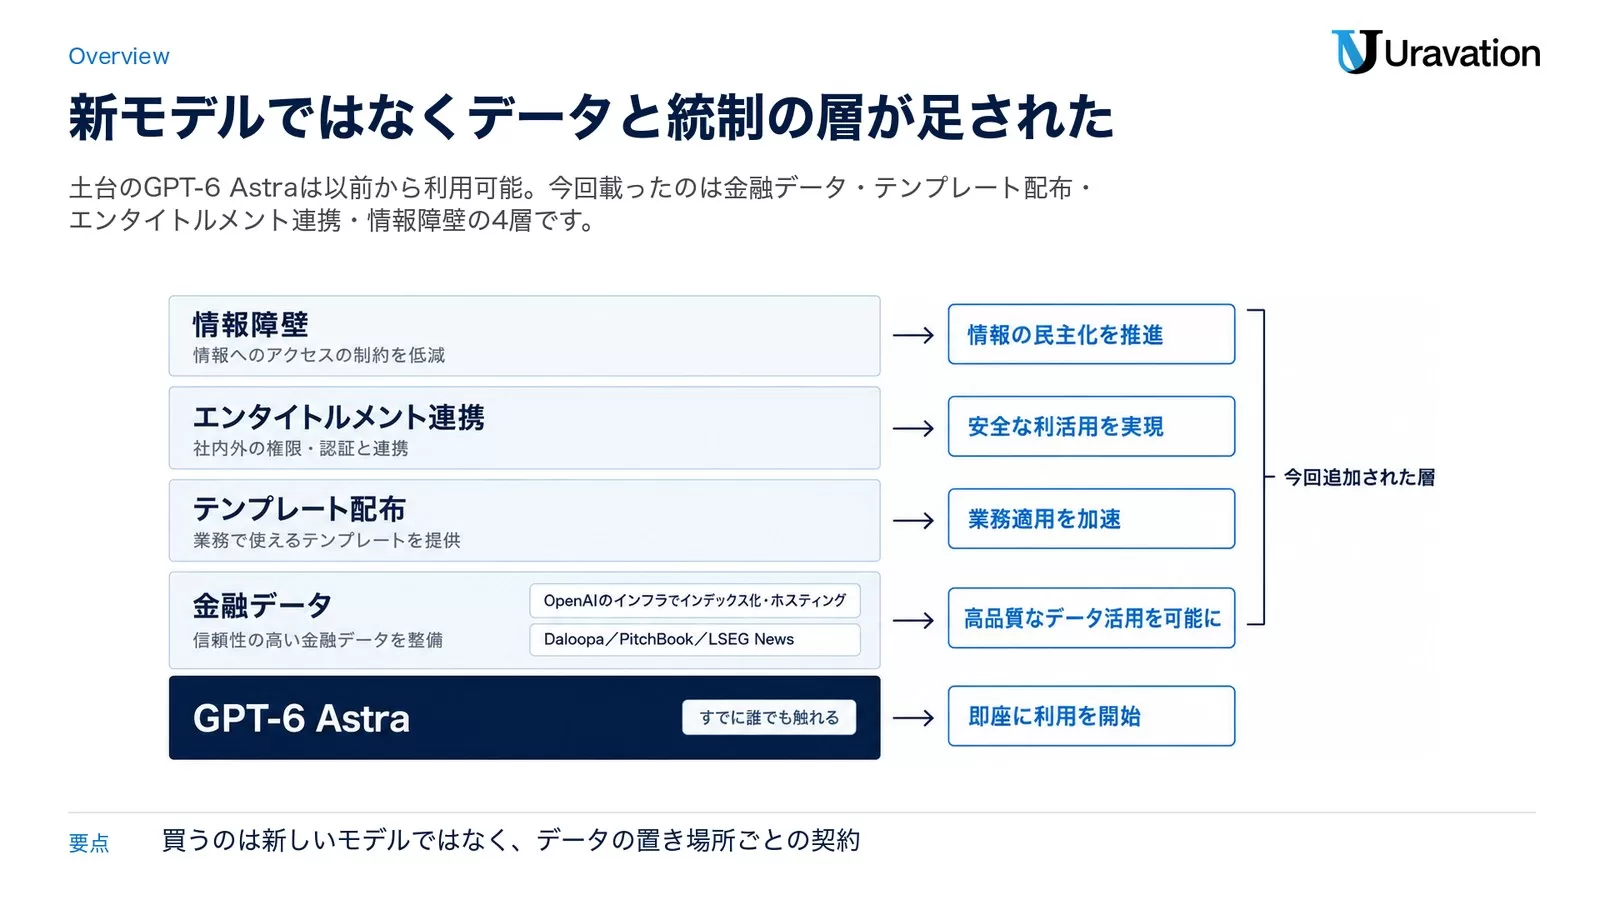
推測を混ぜずに事実だけを並べます。出典列の「公式」はOpenAIの発表本文そのもの、「報道」は発表資料をもとにした各社の記事です。
| 項目 | 内容 | 出典 |
|---|---|---|
| 製品の位置づけ | ChatGPT Workを金融業務向けに仕立てた(tailored)体験。内蔵金融データとGPT‑6 Astraの推論を組み合わせ、リサーチ・財務モデル・顧客向け資料の作成を支援 | 公式 |
| 発表日 | 2026年9月10日(米国時間) | 公式発表を受けた報道(ITmedia/Impress Watch) |
| デザインパートナー | Morgan Stanley、Evercore | 公式 |
| 最初の対象領域 | 投資銀行業務(investment banking)とエクイティリサーチ。他の金融分野へは今後拡張する方針 | 公式 |
| 内蔵データ提供元 | Daloopa、PitchBook、LSEG News、Crunchbase など。決算説明会トランスクリプト、財務諸表、企業ファンダメンタルズ、非上場企業情報などをカバー | 公式 |
| データの持ち方 | OpenAIのインフラ上でインデックス化・ホスティング。個別のデータ契約交渉やコネクタ設定なしで利用開始できる | 公式 |
| 出典表示 | 数値や記述の根拠となる表・本文までさかのぼれる詳細な引用(granular citations) | 公式 |
| 既存契約データの扱い | S&P Capital IQ、LSEG、MSCI、Dow Jones Factiva、Moody’s と共有サインイン・エンタイトルメント連携を「開発中」。ChatGPTのサインインでユーザーを識別し、既に権利を持つデータへ自動的にアクセスさせる構想 | 公式 |
| コネクタ | 50種類以上。Datasite、Box、Preqin、FactSet、Intapp などを含む。利用頻度の高いMCPコネクタは信頼性を最適化 | 公式 |
| 成果物の生成 | 管理者が専用の管理ページからExcel・Word・PowerPointのテンプレートを社内配布可能。自社書式でバリュエーションモデル、リサーチノート、ピッチブックを生成 | 公式 |
| セキュリティ基盤 | ChatGPT EnterpriseのSAML SSO、SCIMプロビジョニング、ロールベースアクセス制御を基盤とする | 公式 |
| 学習利用 | 企業の業務データは既定でモデル学習に使われない。保存時・転送時に暗号化 | 公式 |
| 監査・情報障壁 | 管理者がワークスペースの保持期間を設定可能。OpenAI Compliance Platform経由で対応ログを既存の監査・調査ワークフローへエクスポート可能。複数ワークスペースで情報障壁を構成可能 | 公式 |
| 提供条件 | 「適格な金融機関(eligible financial institutions)」向けに提供。希望する場合はOpenAIまたは担当アカウントチームに問い合わせ | 公式 |
| 価格 | 非公開。最低シート数・提供地域の制限・適格性の判定基準も公表されていない | 公式(記載なし)/報道(VentureBeat) |
表にすると分かりますが、「できること」はかなり具体的なのに、「どう買うか」がほぼ空白なんです。ここが今回の発表のいちばん正直な読みどころだと思います。
「新モデル」ではないことを最初に押さえる
混同されやすいので念のため。GPT‑6 Astra自体は今回の発表より前に公開済みで、OpenAI公式ページでは「ChatGPT Plus、Pro、Business、Enterpriseの全ユーザー、およびOpenAI API、Microsoft Azure、AWS Bedrock」で利用可能になると案内されています。API価格も公開済みで、標準処理は入力100万トークンあたり10ドル、出力100万トークンあたり50ドル。Fast modeは約2倍の速度で価格も2倍です。
つまりモデルはすでに誰でも触れる状態にあり、今回追加されたのは「金融データ」「テンプレート配布」「エンタイトルメント連携」「情報障壁」のレイヤーです。Astra自体の使い方や料金の詳細はGPT‑6 Astraの使い方|ChatGPT・API・料金とGPT‑6 Astra料金|ChatGPTプラン別とAPI単価でまとめています。この2本を読めば、「Astraを使いたいだけなら今回の発表を待つ必要はなかった」ことがはっきりします。
料金・提供条件・日本での利用可否
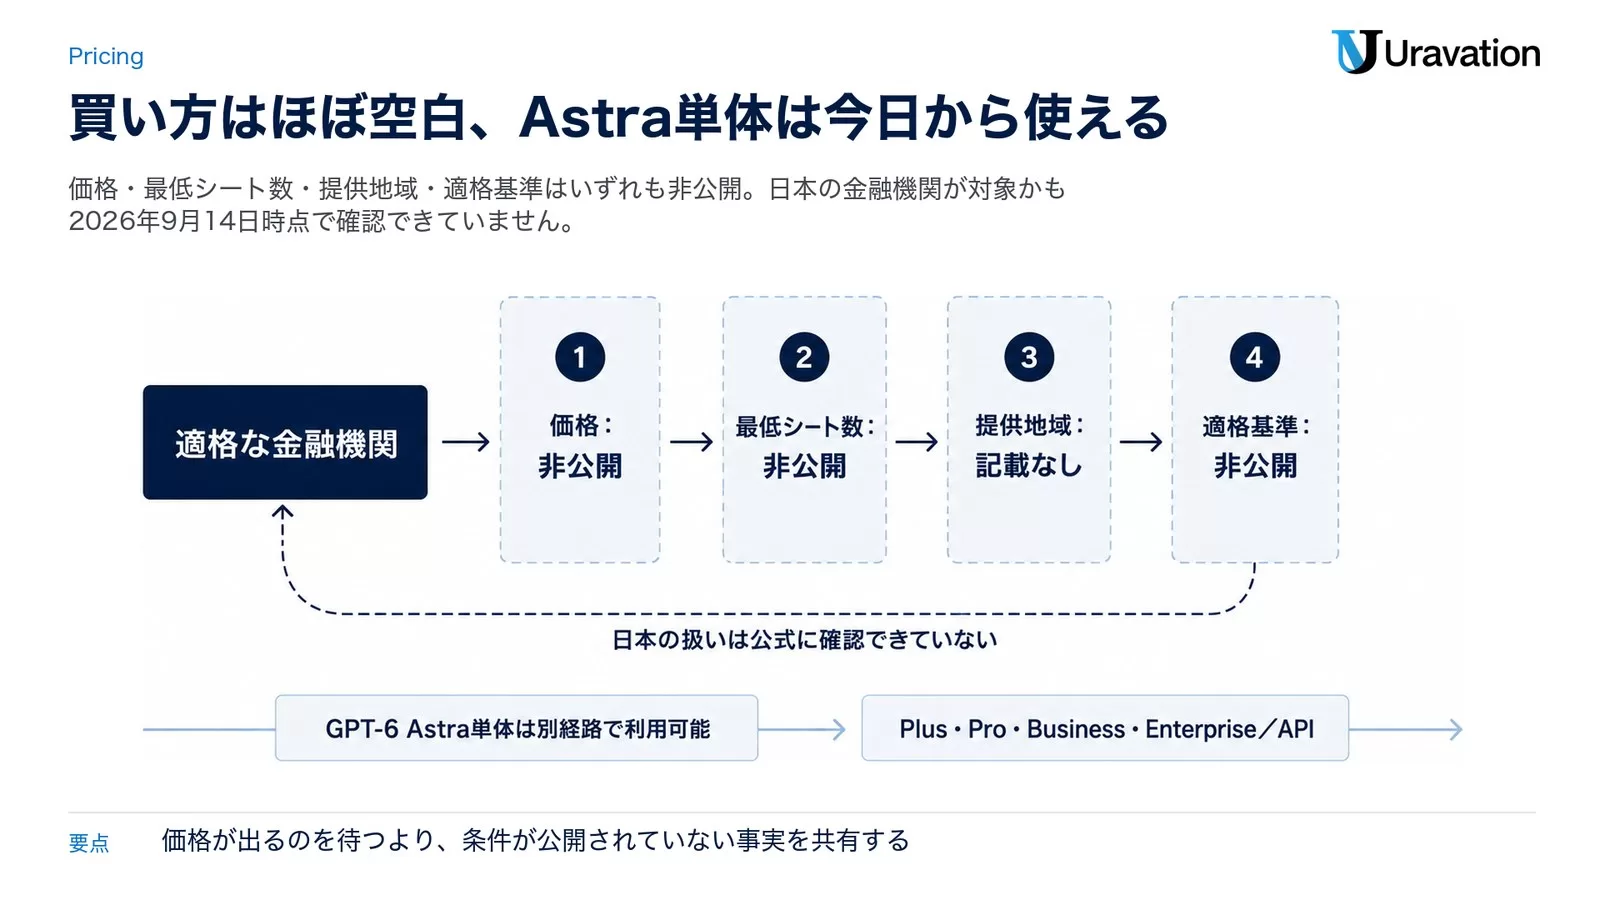
検索でいちばん求められている部分なので、書けることと書けないことを分けて置きます。
| 知りたいこと | 2026年9月14日時点の状況 |
|---|---|
| シート単価・月額 | 公式に非公開。OpenAIは価格を公表していない |
| 最低契約シート数 | 公式に非公開 |
| 提供地域・国別の制限 | 公式発表に記載なし。地域制限の有無自体が確認できていない |
| 日本の金融機関が対象か | 2026年9月14日時点で公式に確認できていない。「適格な金融機関」の判定基準が公表されていないため、日本法人が含まれるかも不明 |
| 既存のChatGPT Business/Enterprise契約からアップグレードできるか | 公式発表に記載なし。問い合わせ導線(担当アカウントチーム)のみ案内 |
| データ保存先のリージョン指定 | 公式発表に記載なし。内蔵データを「OpenAIのインフラでホスティングする」とは書かれているが、地理的な所在は明示されていない |
| GPT‑6 Astra単体の利用 | Plus・Pro・Business・Enterpriseの各プランとAPI/Azure/AWS Bedrockで利用可能(公式)。こちらは今回の発表と無関係に使える |
「公式に確認できていない」が7行中4行という状態は書き手として気が引けますが、ここを推測で埋めたら記事の価値がなくなります。海外報道でも、VentureBeatが「OpenAIは価格、最低シート数、地理的制限、適格性の判定基準のいずれも公表していない」と明記しています。現時点で金額を提示している情報源があれば、公式発表由来ではありません。
欧州では「規制への言及がないこと」が論点になっている
もうひとつ参考になる指摘があります。報道では、The Next Webが「今回の発表にはEUのデータレジデンシー、欧州専用のホスティングリージョン、DORA(デジタル・オペレーショナル・レジリエンス法)への言及がない」と指摘しています。DORAは2025年1月からEU金融機関のICT第三者委託を規律する枠組みで、記録保持・契約条項・出口戦略・レジリエンステストなどを求めます。
これは欧州固有の話に見えて、日本にもそのまま刺さります。後述のとおり、金融庁とFISCの両方が2026年に関連文書を更新しているからです。「発表に書かれていないこと」を洗い出すのが、この手の速報でいちばん実務的な読み方です。
GPT‑6 Astraの「金融向け」性能はどこまで確かめられているか
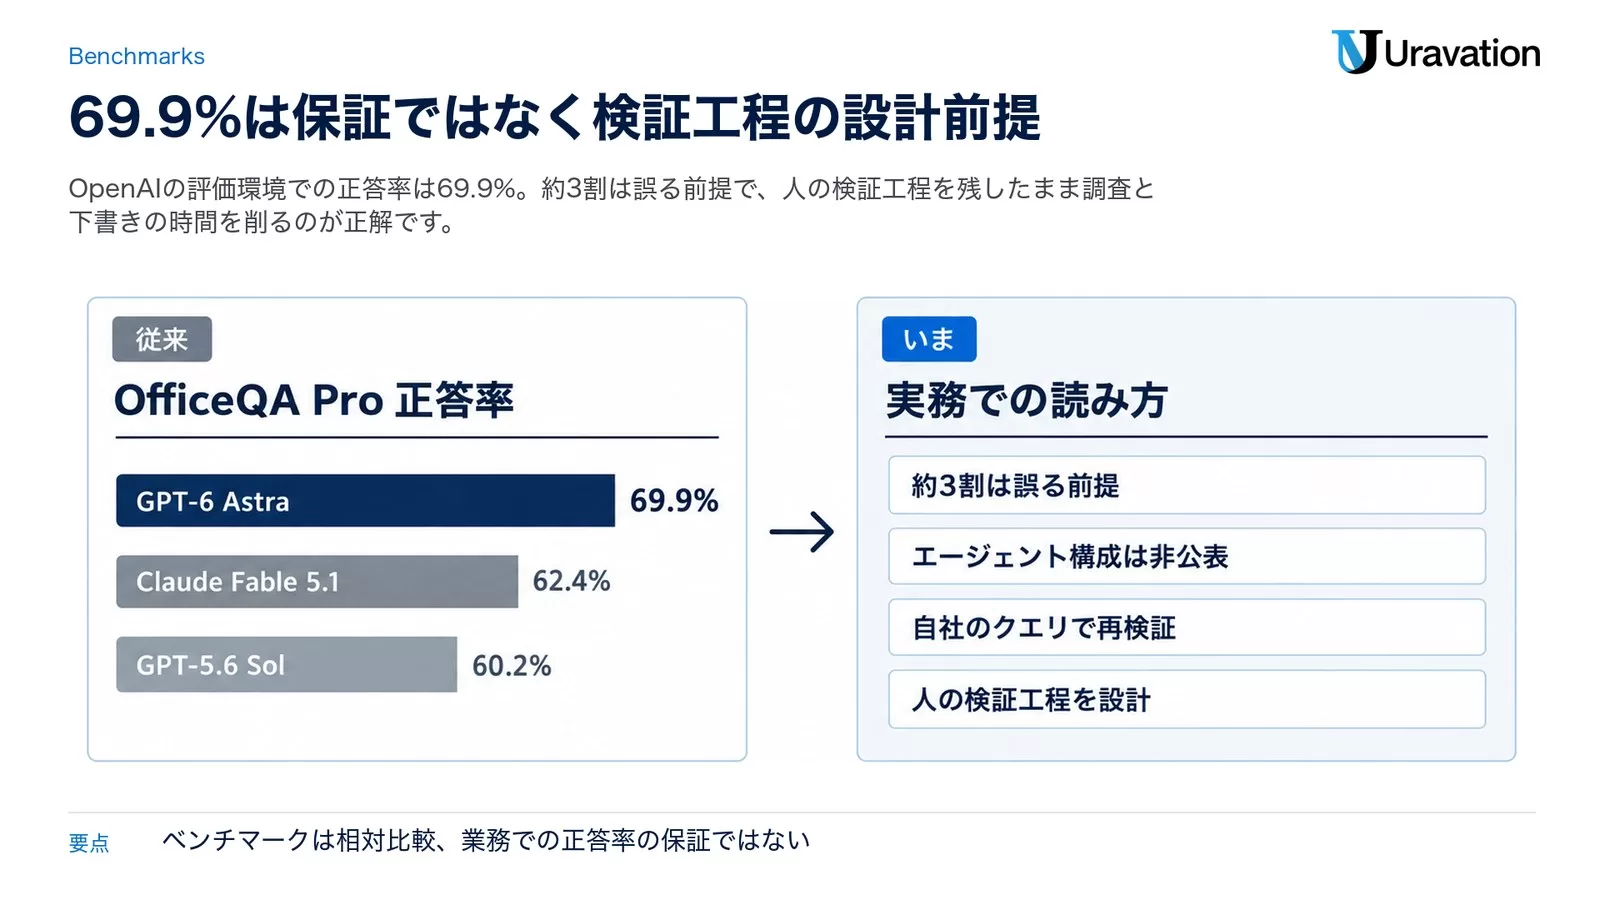
OpenAIは今回、モデル性能の根拠としてOfficeQA Proというベンチマークの結果を提示しています。発表資料の数値として各社が報じているのは次のとおりです。
| モデル | OfficeQA Pro 正答率 |
|---|---|
| GPT‑6 Astra | 69.9% |
| Claude Fable 5.1 | 62.4% |
| GPT‑5.6 Sol | 60.2% |
OfficeQA Proは米財務省の統計資料(Treasury Bulletins)から情報を探して分析する能力を測るベンチマークで、報道によれば約89,000ページ・133問規模の独立開発ベンチマークです。数値はいずれもOpenAI自身の評価環境での結果として公表されたものです。
正直に言うと、この数字は「使える」より「まだ3割は外す」と読むほうが実務的です。金融業務では1件の誤りがバリュエーションモデルや顧客向け資料に混入した瞬間に問題になります。報道では、エージェントのハーネス構成や推論設定が公表されていないため、この表を「金融業務におけるモデルの普遍的な順位」として読むことはできないという指摘も出ています。
コネクタの信頼性についても、OpenAIは最適化前後のエラー率を公表しています。報道されている値は、Quartrが5.09%から1.99%、S&P Globalが6.84%から2.66%、Daloopaが7.53%から2.57%、FactSetが9.59%から6.45%へ改善したというものです。改善幅は明確ですが、テストセットの規模や「エラー」の定義は公表されていないため、自社のクエリ・権限構成で再検証しないと調達の根拠にはなりません。
モデル選定の比較軸そのものはGPT‑6 AstraとFable 5.1・Opus 5比較のほうが役に立ちます。今回のベンチマーク1本で優劣を決めるのは危険です。
日本の金融実務への影響 — 今すぐやること/やらなくていいこと/様子見でよいこと
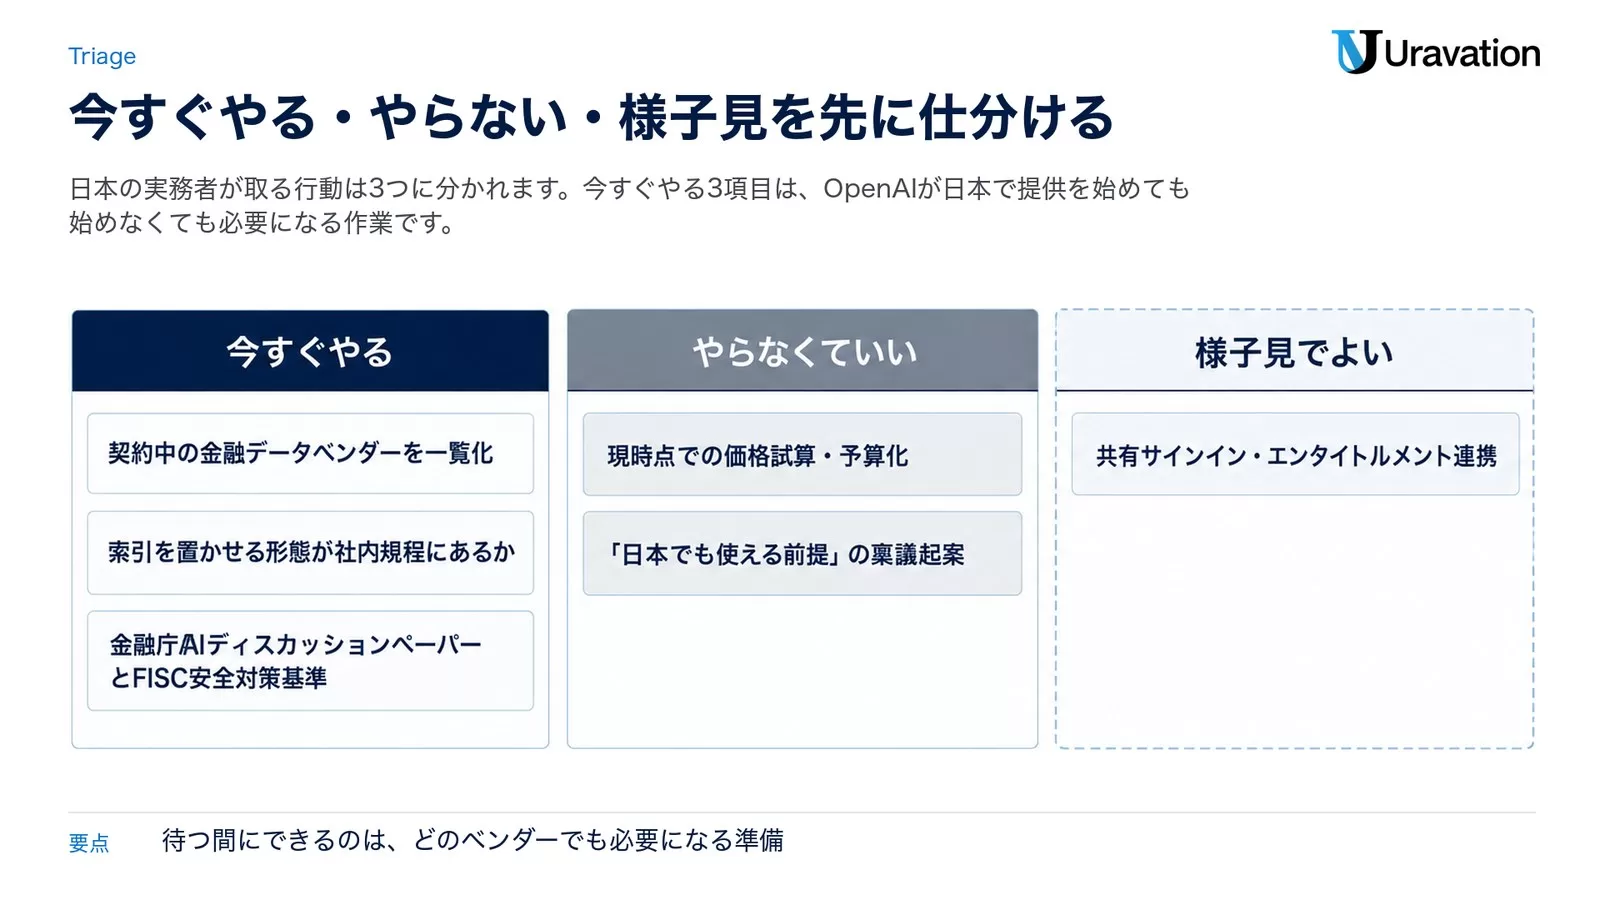
本題です。発表から数日たった2026年9月14日時点で、日本の実務者がとるべき行動を3つに仕分けます。
| 区分 | 具体的なアクション | 理由 |
|---|---|---|
| 今すぐやる | 自社が契約中の金融データベンダーを一覧化し、発表で名前が挙がった提供元(Daloopa/PitchBook/LSEG/S&P Capital IQ/MSCI/Dow Jones Factiva/Moody’s/FactSet/Preqin など)と突き合わせる | 共有サインイン連携が実装されれば、既存契約の権限がそのままAI側に持ち込まれる。影響範囲を先に知っておく |
| 今すぐやる | 既存のAI利用ルールに「外部サービス側にデータをインデックス化・ホスティングさせる形態」の条項があるか確認する | 多くの社内規程は「AIに入力しない情報」は決めていても、「AI事業者側に索引を置かせる」形態を想定していない(本発表の核心はここ) |
| 今すぐやる | 金融庁のAIディスカッションペーパー(第1.1版)とFISC安全対策基準・解説書(第14版)の該当箇所を、担当者が読んだ状態にしておく | 両方とも2026年3月に更新されている。判断の土台が古いまま議論すると出戻る |
| やらなくていい | GPT‑6 Astraを使うために本製品の提供開始を待つこと | Astra自体はPlus・Pro・Business・Enterpriseと API/Azure/Bedrock で既に利用可能(公式) |
| やらなくていい | 現時点での価格試算・予算化 | 価格も最低シート数も非公開。試算した瞬間に根拠のない数字が社内を独り歩きする |
| やらなくていい | 「日本でも使える前提」の稟議起案 | 日本の金融機関が適格対象に含まれるかは公式に確認できていない |
| 様子見でよい | 共有サインイン・エンタイトルメント連携の正式提供 | 公式発表でも「working with(取り組み中)」の段階。実装形態が固まってから評価すれば間に合う |
| 様子見でよい | 投資銀行・エクイティリサーチ以外の業務への展開 | OpenAI自身が「他の金融分野への拡張は今後」と書いている |
| 様子見でよい | 日本語環境での挙動評価 | 発表資料のデモ・データセットは英語圏のもの。日本語の開示資料での精度に関する公式情報は確認できていない |
日本側で参照すべき一次情報は、この2つが最新
「AI事業者にデータを預ける形態をどう評価するか」を議論するとき、日本には参照すべき公的文書が2つあります。どちらも2026年3月に更新されたばかりです。
- 金融庁「AIディスカッションペーパー(第1.1版)」(2026年3月3日公表)。第1.0版(2025年3月公表)に、2025年6月から12月に開催された「金融庁 AI官民フォーラム」で得られた知見を反映して改訂されたものです。金融庁は「リスクベース・アプローチの下でリスクを適切にコントロールしつつ、顧客利便性や業務効率化の向上に繋がる取組みが進展していくこと」を期待すると述べています
- FISC「金融機関等コンピュータシステムの安全対策基準・解説書(第14版)」(PDF版を2026年3月25日公表)。第14版では「AIの安全対策に関する改訂」として、官公庁・各協会・団体が公表したAI・生成AIに関するガイドラインやレポートの内容を安全対策基準に反映したと明記されています
研修の現場で感じるのは、この2つを読まないまま「AIはセキュリティが心配なので」で議論が止まっている組織がまだ多いということです。逆に読んだ担当者がいる組織は、議論が「使うか使わないか」から「どの条件なら使えるか」に変わります。この差は本当に大きいです。
事例区分: 想定シナリオ
以下は企業向けAI研修で繰り返し見てきた典型的なつまずき方を一般化したものです。特定企業の実例ではありません。
よくあるのがこの流れです。海外の大手行が使い始めたニュースが出る。経営から「うちはどうなんだ」と降りてくる。調べる。価格が出てこない。日本で使えるかも分からない。結局「引き続き情報収集します」で止まる——。この時間の使い方が、いちばんもったいないんです。
価格を待つ間にできることは実はたくさんあります。上の表の「今すぐやる」3項目は、OpenAIが日本で提供を始めても始めなくても、どのAIベンダーを選んでも必要になる作業だからです。ガバナンス体制の設計はAIガバナンス委員会の設計と運用、SSO・監査ログまわりの確認項目は法人導入完全ガイド|SSO・監査ログ・SOC2を参照してください。ベンダーが違っても骨格は共通です。
この記事の内容、自社の業務でも回したい?
AI顧問(月次伴走)が、貴社の業務に合わせて導入から定着まで並走します。研修4,000名以上・支援100社以上の実績。まずは30分の壁打ちから。
【要注意】発表直後にやりがちな失敗パターン
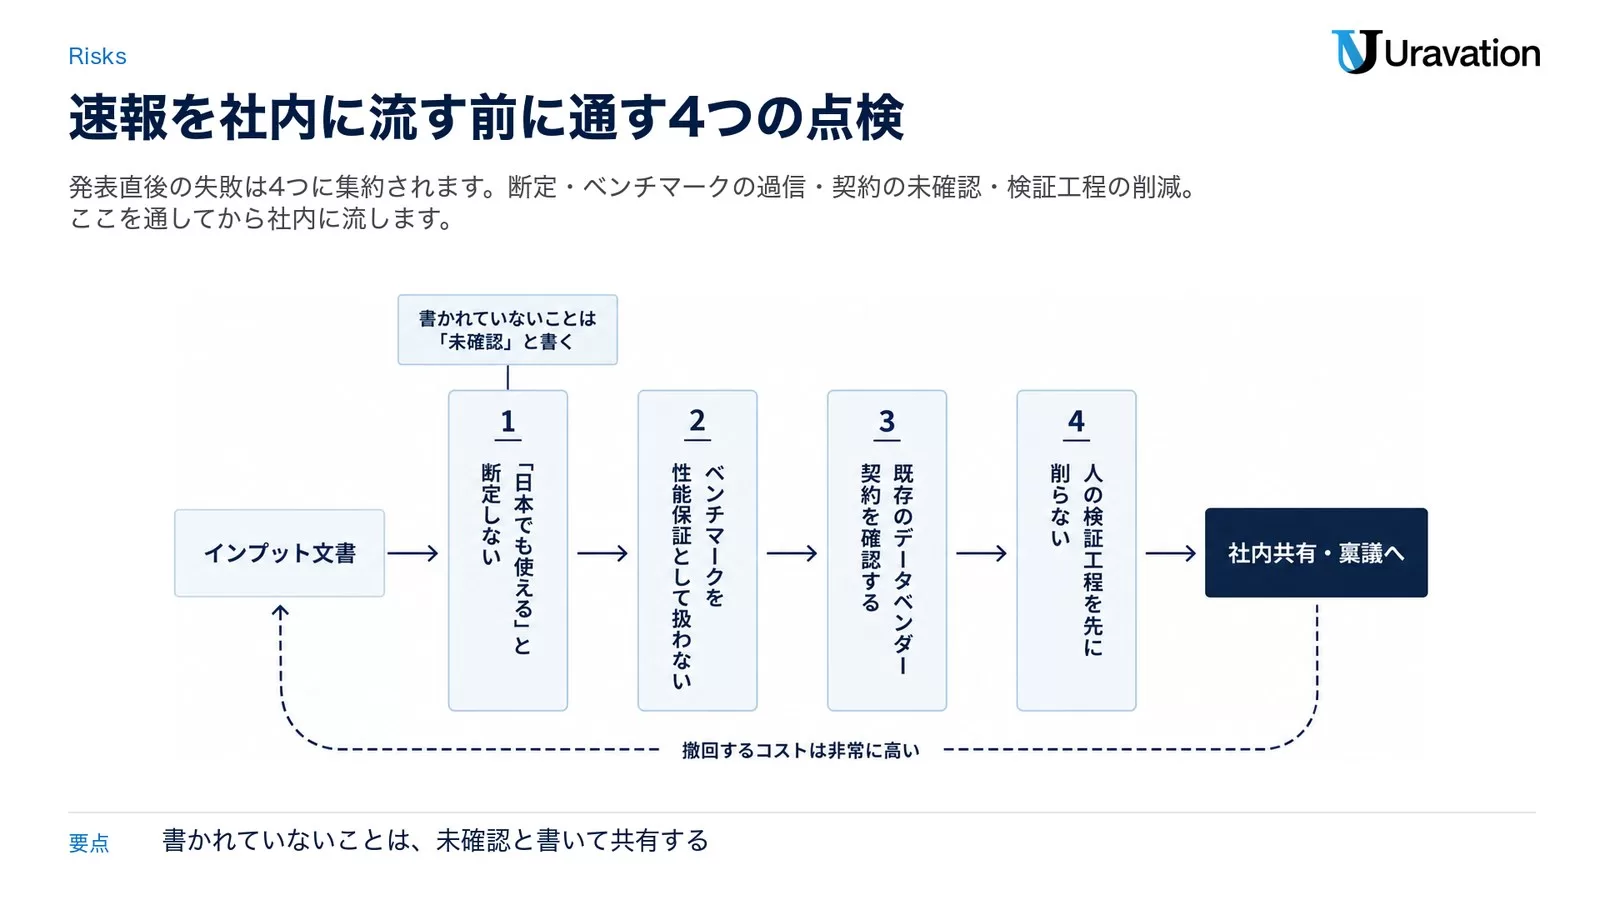
失敗1:報道の見出しだけで「日本でも使える」と社内共有してしまう
❌「OpenAIが金融機関向けサービスを開始。日本の銀行でも利用可能に」
⭕「OpenAIが金融機関向けサービスを発表。提供対象は『適格な金融機関』で、日本の扱いは2026年9月14日時点で公式に確認できていない」
なぜこれが重要か:一度「使える」と流れた情報を撤回するコストは非常に高いです。発表本文の availability 節は1文だけで、地域も価格も書かれていません。書かれていないことは「未確認」と書くのが正解です。
失敗2:ベンチマークの数字を性能保証として扱う
❌「OfficeQA Proで69.9%なので、財務資料の読み取りは実用レベル」
⭕「OpenAIの評価環境でGPT‑6 Astraが69.9%。約3割は誤る前提で、人の検証工程を設計する」
なぜこれが重要か:ベンチマークは「同一条件での相対比較」であって「業務での正答率の保証」ではありません。今回はエージェント構成や推論設定が非公表だと報道で指摘されています。自社の資料・自社のクエリで確かめていない数字を稟議の根拠にしないことです。
失敗3:既存のデータベンダー契約を確認せずに導入を検討する
❌「データが内蔵されているなら、既存の情報端末契約を減らせるのでは」
⭕「内蔵されているのはLSEG『News』などの特定データセット。既存契約の全データが含まれるわけではない」
なぜこれが重要か:VentureBeatは、LSEGが「内蔵データ」と「エンタイトルメント連携」の両方のカテゴリに登場するため、LSEGの全データセットが同梱されていると解釈してはいけない、と明確に注意しています。データ提供元の社名が並んでいるのを見て契約の代替になると判断すると、後で足りないデータが出ます。
失敗4:「AIに丸投げできる」前提で人の工程を先に削る
正直にお伝えすると、この製品でもっとも価値がありそうなのは、生成そのものより引用の粒度のほうです。OpenAIは、調整後EBITDAの根拠となる照合や注記までさかのぼって確認できる点を繰り返し強調しています。裏を返せば人が検証する前提の設計だということ。検証工程を残したまま調査と下書きの時間を削る——これが正しい使い方で、検証工程ごと削ると事故が起きます。
社内検討でそのまま使えるプロンプト5つ
発表内容を自社の判断材料に変換するためのプロンプトです。ChatGPT・Claude・Geminiのいずれでも動きます。
プロンプト1:発表内容を「事実/未確認/推測」に仕分ける
以下のニュース本文を読み、記述を3つに分類して表にしてください。

【分類】
A. 発表元が明言している事実
B. 発表元が触れていない(=未確認)が、実務判断に必要な項目
C. 記事の書き手による解釈・推測

【出力形式】
| 記述 | 分類 | 判断に必要な理由 |

不足している情報があれば、最初に質問してから作業を開始してください。
仮定した点は必ず「仮定」と明記してください。

【ニュース本文】
(ここに発表本文または記事を貼る)
速報を社内共有する前にこれを1回通すだけで「書かれていないこと」が可視化されます。Bの列が、そのまま問い合わせ事項のリストになります。
プロンプト2:既存データベンダー契約との重複を棚卸しする
当社が契約中の金融情報サービスは以下です。

(例)
- ベンダーA:端末◯席、契約更新月◯月、主な利用部門
- ベンダーB:API利用、年間契約、主な利用データ

これに対し、下記の「AI製品に内蔵・連携されるデータ提供元リスト」を突き合わせ、
次の3区分で整理してください。

1. 重複の可能性がある(同じデータを二重に買うリスク)
2. 連携により権限管理の見直しが必要になる
3. 無関係

各区分について、契約担当者が次に確認すべき質問を1つずつ挙げてください。
確認できない事項は「要ベンダー照会」と明記し、推測で埋めないでください。

【データ提供元リスト】
(ここに発表で挙がった提供元名を貼る)
プロンプト3:外部委託・第三者リスクのベンダー質問票をつくる
AI事業者向けの外部委託リスク評価の質問票を作成してください。

【前提】
- 対象は、業務データに加えて有償の市場データを
  AI事業者側のインフラでインデックス化・ホスティングする形態のサービス
- 当社は金融機関で、外部委託先管理の社内規程がある

【出力】以下の観点ごとに、そのまま送れる質問文を3つずつ。
1. データの保存場所と再委託先
2. 監査・ログ取得の範囲と提供形式
3. 契約終了時のデータ返却・削除と移行(出口戦略)
4. 障害時の連絡体制と復旧目標
5. モデル更新・仕様変更の事前通知

曖昧な回答が返りやすい質問には、その旨の注記を付けてください。これは今回の製品に限らずどのAIベンダーにも使い回せます。むしろ先に質問票を作り、どのベンダーにも同じ質問をぶつけるのが比較としていちばん公平です。
プロンプト4:公的文書との突合チェックリストを生成する
以下の2つの公的文書の位置づけを前提に、
生成AIサービスの導入検討時に社内で確認すべきチェックリストを作成してください。

- 金融庁「AIディスカッションペーパー(第1.1版)」(2026年3月3日公表)
- FISC「金融機関等コンピュータシステムの安全対策基準・解説書(第14版)」(2026年3月25日公表)

【出力】
- チェック項目(20個以内・重複なし)
- 各項目の「誰が確認するか」(IT/コンプラ/リスク管理/事業部門)
- 各項目の「証跡として何を残すか」

※ 各文書の条項番号や具体的記述を引用する場合は、
  必ず原文を確認する前提とし、
  あなたの記憶だけで条項番号を書かないでください。
  条項の特定が必要な箇所は「要原文確認」と明記してください。
最後の但し書きが重要です。これがないとAIは条項番号を自信満々に創作します。金融系の文書ほど「それっぽい番号」が出やすいので、必ず入れてください。
プロンプト5:経営向けに1枚で説明する
以下の内容を、金融機関の役員会で使う説明メモにまとめてください。

【制約】
- A4で1枚に収まる分量
- 冒頭3行で「何が発表されたか/当社にいつ影響するか/今期の意思決定が必要か」に答える
- 確認できていない事項は「◯年◯月時点で公式に確認できていない」と明記し、
  推測で埋めない
- 費用に関する記述は、公表されている金額のみ使用する

【元情報】
(ここに整理済みの事実を貼る)

数字と固有名詞は、根拠(出典/計算式)を添えてください。
役員向け資料は「分からないことを分からないと書く」のがいちばん難しい。制約条件に明示しておくと、AIは素直に従ってくれます。
よくある質問
ChatGPT for Financial Servicesは、既存のChatGPT Business/Enterprise契約で使えますか
2026年9月14日時点で、既存プランからの移行方法やアップグレード可否についての公式な説明は確認できていません。公式発表にあるのは「適格な金融機関に提供。関心がある場合はお問い合わせいただくか、担当アカウントチームにご連絡ください」という案内のみです。なお、ChatGPT Enterpriseの利用分析・支出管理まわりの変更はChatGPT Enterprise 利用分析・支出管理を刷新で整理しています。
日本の銀行・証券会社でも申し込めますか
公式発表に地域に関する記述がなく、「適格な金融機関」の判定基準も公表されていないため、2026年9月14日時点では公式に確認できていません。海外報道でも、地理的制限と適格基準がいずれも非公開である点が指摘されています。確実な回答が必要な場合は、OpenAIまたは担当アカウントチームへの直接照会が唯一の方法です。
料金はいくらですか
公表されていません。シート単価も最低シート数も公式発表には記載がありません。なお、GPT‑6 AstraのAPI料金は別途公表されており、標準処理で入力100万トークンあたり10ドル、出力100万トークンあたり50ドルです。こちらは本製品とは別の課金体系です。
内蔵データがあるということは、既存の情報端末契約を解約できますか
その判断はできません。内蔵されているのはDaloopa、PitchBook、LSEG News、Crunchbaseなどの特定データセットで、あるベンダーの全データが含まれるわけではありません。実際、LSEGは「内蔵データ」と「エンタイトルメント連携(開発中)」の両方に登場します。契約見直しはデータセット単位で突き合わせる必要があります。
投資銀行以外の金融業務でも使えますか
OpenAIは、Morgan StanleyとEvercoreとの協業を通じて投資銀行業務とエクイティリサーチを最初の対象領域に定めたと述べており、他の金融サービス分野への拡張は「今後」としています。現時点で他分野向けの提供時期は公式に確認できていません。
参考・出典
- Introducing ChatGPT for Financial Services — OpenAI 公式発表(参照日: 2026-09-14)
- GPT‑6 Astra: A new generation of intelligence — OpenAI 公式(提供プラン・API単価。参照日: 2026-09-14)
- AIディスカッションペーパー(第1.1版)の公表について — 金融庁(令和8年3月3日。参照日: 2026-09-14)
- 「金融機関等コンピュータシステムの安全対策基準・解説書」(第14版)【PDF版】を公表しました — FISC 金融情報システムセンター(2026年3月25日。参照日: 2026-09-14)
- OpenAI、金融機関向け「ChatGPT for Financial Services」 金融データ搭載し「GPT-6 Astra」で分析 — ITmedia NEWS(2026年9月11日。発表日と価格非公開の裏取り。参照日: 2026-09-14)
- OpenAI、金融機関向けに「ChatGPT for Financial Services」を提供 — Impress Watch(2026年9月11日。発表日の裏取り。参照日: 2026-09-14)
- OpenAI launches ChatGPT for Financial Services with integrated data sources — VentureBeat(価格・最低シート数・地域制限・適格基準の非公開、ベンチマークとコネクタ改善値の内訳。参照日: 2026-09-14)
- OpenAI launches ChatGPT for Financial Services with data from S&P, LSEG, Moody’s and PitchBook — The Next Web(EUデータレジデンシー・DORAへの言及がない点の指摘。参照日: 2026-09-14)
結論と次の一歩
もう一度、判断の軸に戻ります。この発表の本質は、金融データの置き場所がベンダー側からAI事業者側へ動きうる、という設計変更です。モデルが賢くなった話でも、日本ですぐ使える話でもありません。
そのうえで、2026年9月14日時点で取るべき次の一歩は3つです。
- 今すぐ:契約中の金融データベンダーを一覧化し、発表で名前が挙がった提供元と突き合わせる。重複と権限の論点だけ先に洗い出しておく
- 次の稟議までに:本記事のプロンプト3で外部委託の質問票を作り、AIベンダー横断で同じ質問をぶつけられる状態にしておく。ベンダーが決まっていなくても作れます
- 四半期の規程見直しで:金融庁のAIディスカッションペーパー(第1.1版)とFISC安全対策基準・解説書(第14版)を突き合わせ、「AI事業者側にデータの索引を置かせる形態」を社内規程が想定しているか確認する
価格も日本での提供可否も、待っていれば分かります。待っている間にできるのは、どのベンダーを選んでも必要になる準備のほうです。そしてこの準備は、AIの話というより、金融機関がずっと前からやってきた外部委託管理の延長線上にあります。そう捉え直すと、議論はかなり進みやすくなるはずです。
あわせて読みたい
- 金融業界AI完全ガイド|銀行・信金・証券の実装事例とROI — 業界全体の実装状況から確認したい方へ
- GPT‑6 Astraの使い方|ChatGPT・API・料金 — 今日から触れるAstra本体の入口
- AIガバナンス委員会の設計と運用 — 外部委託の判断を誰がどう下すかの体制設計
著者:佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。
100社以上の企業向けAI研修・導入支援。著書『AIエージェント仕事術』『Claude仕事術』(SBクリエイティブ・シリーズ累計50,000部突破)。
SBクリエイティブ「ビジネス+IT」ほかで生成AI連載を執筆(NewsPicks最大1,125ピックス)。
ご質問・ご相談は お問い合わせフォーム からお気軽にどうぞ。
この記事の内容を社内展開する方へ: ChatGPT/GPT系 法人利用スタートキット(無料・PDF 27ページ) をダウンロードできます。
AI研修・AI顧問、まず30分の壁打ちから
研修4,000名以上・支援100社以上。研修は助成金の対象可否まで、顧問は月次伴走の中身まで、貴社の場合で具体的にお答えします。
- 100社以上・研修4,000名以上の実績
- 初回30分無料・即日返信
お問い合わせフォームから24時間以内にUravation担当者がご返信します。