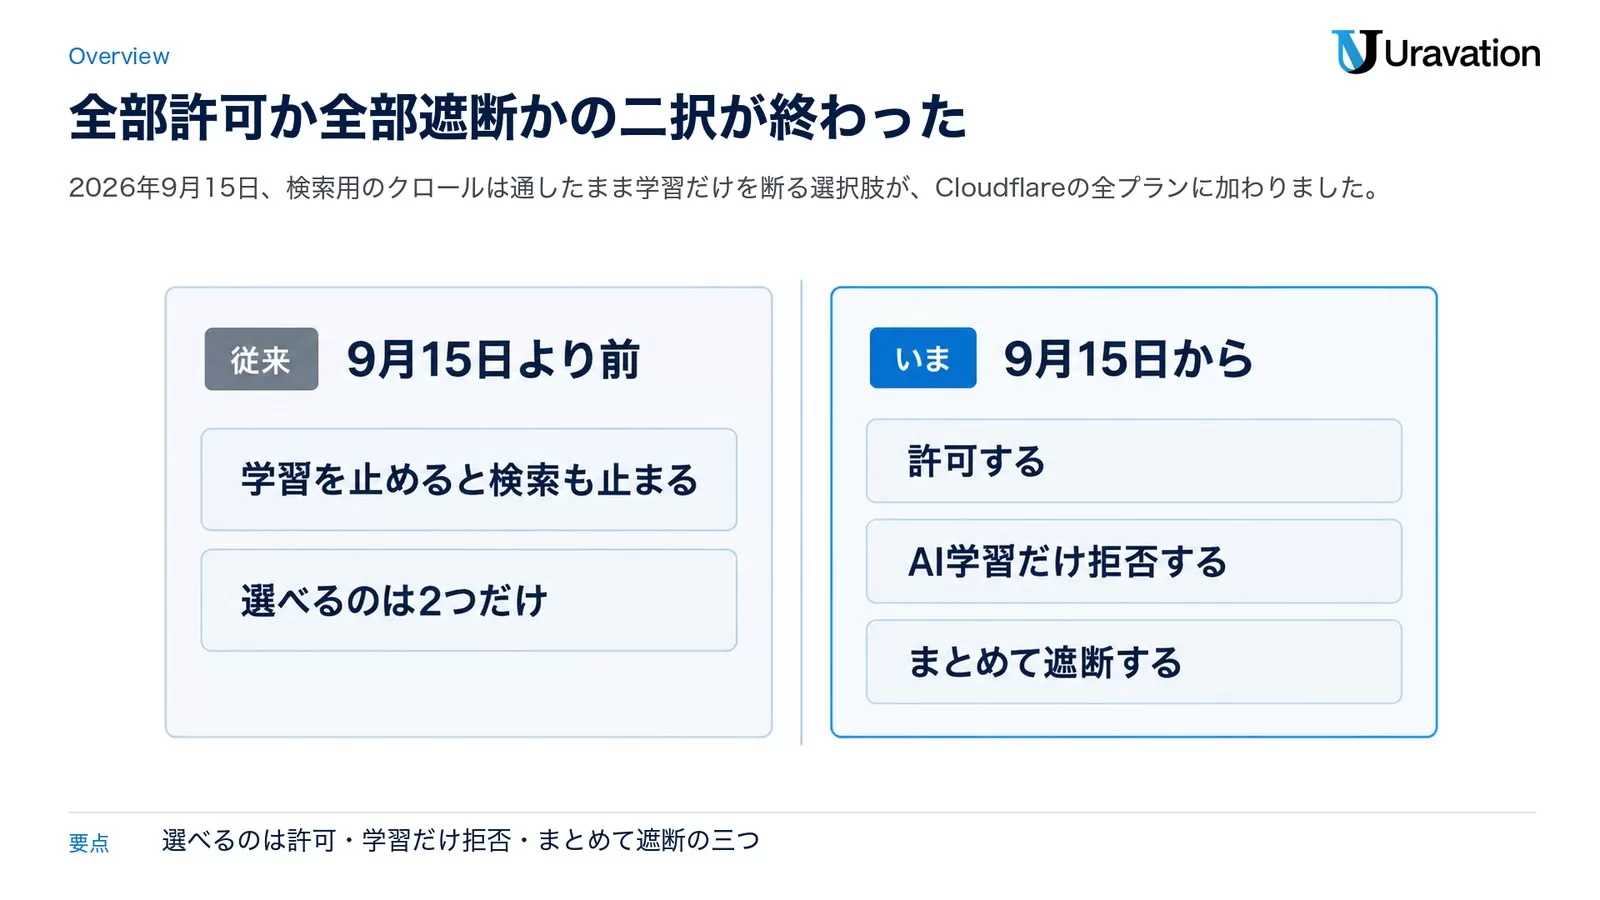
結論(2026年9月20日時点):Cloudflareは2026年9月15日、検索用のクロールは通したままAI学習への利用だけを拒否する「Disallow AI Training」という設定を、全プランで使えるようにしました。これまで「全部許可」か「全部遮断」の二択だったところに、三つ目の選択肢ができたということです。
この記事の要点
- 新しい設定はドメイン単位のSecurity Settings内にあり、Trainingという項目の選択肢として追加された。Searchの項目には追加されていない(出典:Cloudflare公式ブログ・2026年9月15日)。
- Apple(Applebot)・Google(Googlebot)・Microsoft(Bingbot)は、検索と学習を一つのクローラーで兼ねている。Cloudflareはこの三社を「Accountable」と分類し、Disallow AI Trainingを選んでも検索用のクロールは通す扱いにした。
- ただしMicrosoftは、robots.txtでの学習拒否の受け付けを2027年初頭に対応予定と公式に書かれている。今日選んでもBingには自動では伝わらない。
対象読者:自社サイト・オウンドメディアを持ち、AI学習への利用と検索流入のバランスを決めたい中小企業のWeb担当者・経営者。
読了後にできること:自社のサイトがどの型に当てはまるかを判定し、Cloudflareの管理画面のどこを開けばよいか、Cloudflareを使っていない場合は何を書けばよいかまで決められます。
「うちの記事、勝手にAIの学習に使われているんじゃないの?」
これは、AI導入の相談を受けるときにWeb担当の方から実際によく出てくる質問です。そして、やっかいなのは、これまでその問いに対する答えが「止めるなら検索も道連れになります」というものだったことでした。AppleもGoogleもMicrosoftも、検索インデックス用のクロールと、AIモデルの学習用のクロールを、一つのクローラー(Cloudflareの表現では mixed-use crawler = 検索・学習兼用クローラー)で済ませていたからです。片方を断ると、もう片方も断ることになる。だから多くの会社は、納得しないまま「許可」を選び続けてきました。
2026年9月15日、Cloudflareはその二択に三つ目を足しました。「Disallow AI Training」を選ぶと、Applebot・Googlebot・Bingbotは検索のために引き続きサイトを巡回できる一方で、学習には使わないでほしいという意思表示がrobots.txtに書き込まれ、検索を兼ねていない学習専用クローラー(Amazon・Anthropic・Meta・OpenAIのもの)は遮断されます。Cloudflareの公式ブログはこれを「Have it both ways(両取りできる)」と表現しています。
この記事では、公式ブログと公式ドキュメント、それにApple・Google・Microsoftそれぞれの一次情報だけを根拠に、何が拒否できて何は通るのか・会社の種類ごとにどちらを選ぶべきか・実際にどこを触るのかを整理します。Cloudflareを使っていないサイト(レンタルサーバー上のWordPressなど)で近いことをする方法と、その限界も書きます。数字はすべて出典付きで、確認できなかったことは「確認できていない」と書きます。
何が変わったのか|2026年9月15日に増えた3つ目の選択肢
まず、Cloudflareがクローラーをどう分類しているかを押さえます。Cloudflareはボットを「振る舞い」で分類していて、制御できるのは次の3つです(出典:Cloudflare公式ブログ「Have it both ways: stay discoverable in search while disallowing AI training」2026年9月15日/参照日2026-09-20)。
- Search:検索インデックスを作るためのクロール。
- Training:モデルの学習・ファインチューニングのためのクロール。
- Agent:人の指示を受けてその場でページを取りに行くもの。チャットの取得ボットやブラウザ操作エージェントなど。
一つのクローラーが複数の振る舞いを持つことがあり、SearchとTrainingを兼ねるものが「mixed-use crawler(検索・学習兼用クローラー)」です。この兼用こそが、冒頭に書いたジレンマの正体でした。
9月15日以降、Trainingの項目で選べるのは次の4つです。公式ブログの記述をそのまま整理します。
| Trainingの選択肢 | 何が起きるか |
|---|---|
| Allow | 他の設定やWAFルールで遮断されない限り、すべてのクローラーを通す。 |
| Disallow AI Training(新設) | Bot Preference Syncが、該当する「学習させない」という意思表示をrobots.txtに書き出す。Accountableに分類された検索・学習兼用クローラーは検索のために通したまま、それ以外の学習用クローラーは遮断する。遮断されるのはAmazon・Anthropic・Meta・OpenAIが動かしている学習専用クローラーなどで、これらを遮断しても検索には影響しない。 |
| Block on pages with ads | 広告が表示されていると検出されたページに限って、兼用クローラーも含めて遮断する。 |
| Block | 兼用クローラーも含め、すべて遮断する。 |
Disallow AI Trainingという名前は、robots.txtに書き出される Disallow: ディレクティブに由来する、と公式ブログに明記されています。そして重要な制約が二つあります。
一つ目。Disallow AI TrainingはTrainingの選択肢としてのみ用意されていて、SearchとAgentには用意されていません。二つ目。「広告のあるページだけ学習を拒否する」という設定はありません。理由も書かれていて、Cloudflareは広告を出しているページを検出できるものの、その一覧は大きすぎ、変化も速すぎて、robots.txtに書き並べられないからです。robots.txtで表現できる形にしか落とせない、という制約がそのまま仕様になっています。
「Block」の意味が変わった点に注意
ここが今回いちばん見落とされやすいところです。これまで、BlockとBlock on pages with adsは、検索が巻き添えになるのを避けるため、兼用クローラーには適用されていませんでした。9月15日からは適用されます。つまり、以前からTrainingにBlockを設定していたつもりの人が、今後あらためてBlockを選ぶと、Applebot・Bingbot・Googlebotまで止まり、検索流入が消えます。
とはいえ既存ユーザーが今日すぐ壊れるわけではありません。公式ブログの「What you need to do」には「ほとんどの場合、何もする必要はない」と書かれていて、移行ルールが表で公開されています。要点は、これまでTrainingでBlockまたはBlock on pages with adsを選んでいたドメインは、Disallow AI Trainingへ自動的に移行するということ。兼用クローラーごと完全に止めたい場合だけ、あらためてBlockを選び直す必要があります。
同時に、次の整理も公式に告知されています。
- 旧来の「Block AI Bots」は、Search・Training・Agentの細かい制御に置き換わる形で廃止に向かう。公式ドキュメントにも「Block AI bots [Deprecating on September 15, 2026]」と明記されている(出典:Cloudflare Docs「Block AI Bots」/参照日2026-09-20)。
- Managed Robots.txtは、Bot Preference Syncに置き換わる。Managed Robots.txtを有効にしていた顧客は新しい仕組みへ移行される。
- 新しくドメインを追加する一部のケースでは、Disallow AI Trainingが推奨設定に含まれるようになる。
新規ドメインの推奨設定
9月15日以降に新しいドメインをCloudflareへ追加すると、広告で収益を得ているかどうかで2種類のプリセットが提示されます。公式ブログの表をそのまま写すと次のとおりです。
| 項目 | 広告で収益を得ていないサイト | 広告で収益を得ているサイト |
|---|---|---|
| Preference Sync | Enabled | Enabled |
| Search | Allow | Allow |
| Training | Allow | Disallow AI Training |
| Agent | Allow | Block on pages with ads |
広告収益は人がページを見て初めて成立するので、広告ありのサイトほど制限が強いプリセットになる、という説明が添えられています。どちらもオンボーディング中でも後からでも変更できます。
なお、ここで扱っているのは「使ってよいか」という許諾の話であって、法律上の権利関係とは別の話です。生成AIと著作権の実務的な扱いは生成AIの著作権と商用利用|法人の実務対応ガイドで整理しています。
何を拒否できて何は通るのか|検索・学習・エージェントで整理
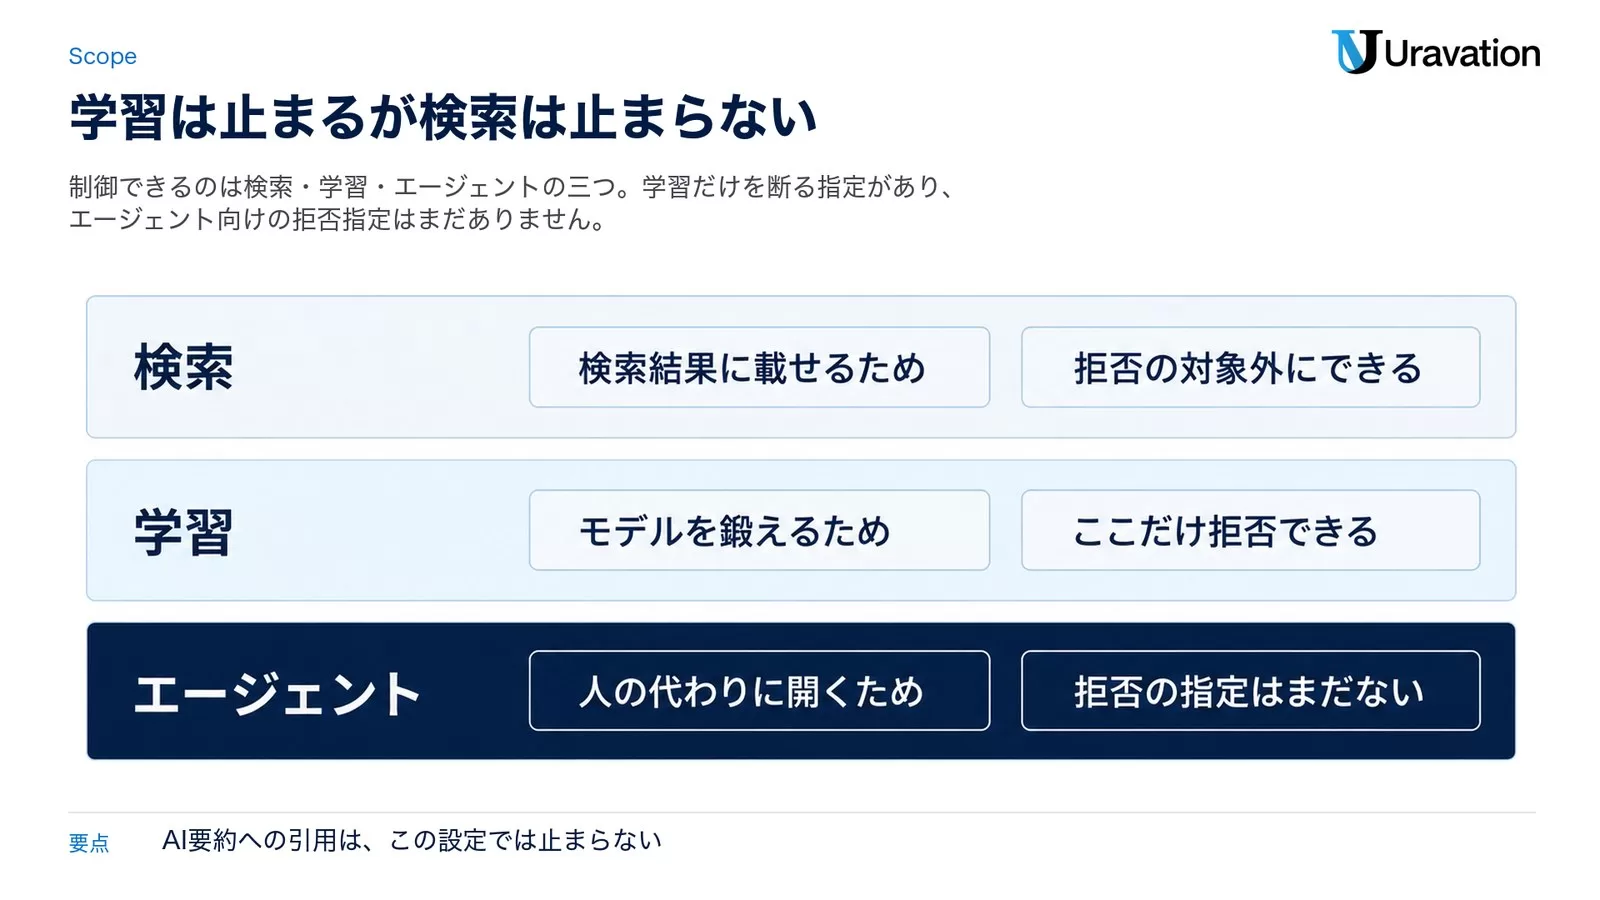
ここが、今回いちばん誤解されやすい部分です。「AI学習を拒否する」と言ったとき、実際には3つの別々の用途が混ざっています。公式の定義に沿って分けます。
| 用途 | Disallow AI Trainingでどうなるか | 根拠 |
|---|---|---|
| 検索インデックスへの掲載 | そのまま残る。Accountableに分類された兼用クローラーは検索のために通る。 | Cloudflare公式ブログ(2026年9月15日) |
| モデルの学習・ファインチューニング | 拒否の意思表示が出る。robots.txtに書き出され、検索を兼ねていない学習専用クローラーは遮断される。 | 同上 |
| AI要約・AI検索の回答への引用 | この設定では止まらない。要約のオプトアウトは各事業者側の仕組みで個別に行う。Cloudflare側からまとめて指定できるようにするのは「来年初めを目標」とされている。 | 同上(What’s next: AI Summaries の節) |
3行目が決定的です。学習拒否と、AI検索の回答に引用されることは別物です。Disallow AI Trainingを選んでも、AI要約に引用されなくなるわけではありません。逆に、AI検索から引用されて指名で問い合わせが来てほしい会社が、「AIに使われたくない」という気分でBlockまで押してしまうと、検索インデックスごと失って何も残らない、という事故が起きます。
Cloudflare自身も、AI要約については単純な是非で割り切れないと書いています。同社が示しているのは次の数字です(いずれも出典はCloudflare公式ブログ、2026年9月15日)。
- 検索で要約を読む利用者は半数を超えており、要約を読んだ利用者はそのまま検索を終える割合が40%以上高い。つまりサイトへの訪問数は減りうる。
- 一方で、AI検索から来た利用者のコンバージョン率は、従来型の検索から来た利用者の3倍から5倍超にのぼる。
訪問は減るが、来る人の本気度は上がる。だから「広告で稼ぐ媒体」と「問い合わせで稼ぐ会社」では最適解が違う、という整理です。Cloudflareは「自社が代わりに選ぶのではなく、判断材料と制御を提供するのが役割だ」と書いています。AI検索側から引用される設計そのものについてはAIEO完全ガイド|AI検索から引用される実装ノウハウにまとめてあります。
Agent(エージェント)に拒否設定がない理由
Agentについては、そもそもDisallowの設定自体が用意されていません。公式ブログの説明はこうです。エージェントは検索の発見可能性とのトレードオフを生まないうえ、インターネットにはまだエージェント向けに拒否の意思を表明する、確立されたディレクティブが存在しない。ai-prefsのような標準が成熟したら、あらためて検討する。現時点で使えるのはAllow / Block on pages with ads / Blockの3つだけ、ということです。
各社クローラーの対応状況|Apple・Google・Microsoft
Cloudflareは今回、クローラー事業者に「Accountable(説明責任を果たしている)」という分類を設けました。この分類に入るには、次の4つを満たすか、期限を決めて満たすと約束する必要があります。
- robots.txtまたは同等の標準で、サイト運営者がAI学習をオプトアウトできる手段があること。
- AI要約をオプトアウトできる手段が、事業者側で直接設定できる形であること(来年からはCloudflare経由でも)。
- どのページが学習に供されたかをURL単位で可視化し、検索での表示状況の指標も提供すること。
- AI学習をオプトアウトしても通常の検索結果に影響しないと保証すること。
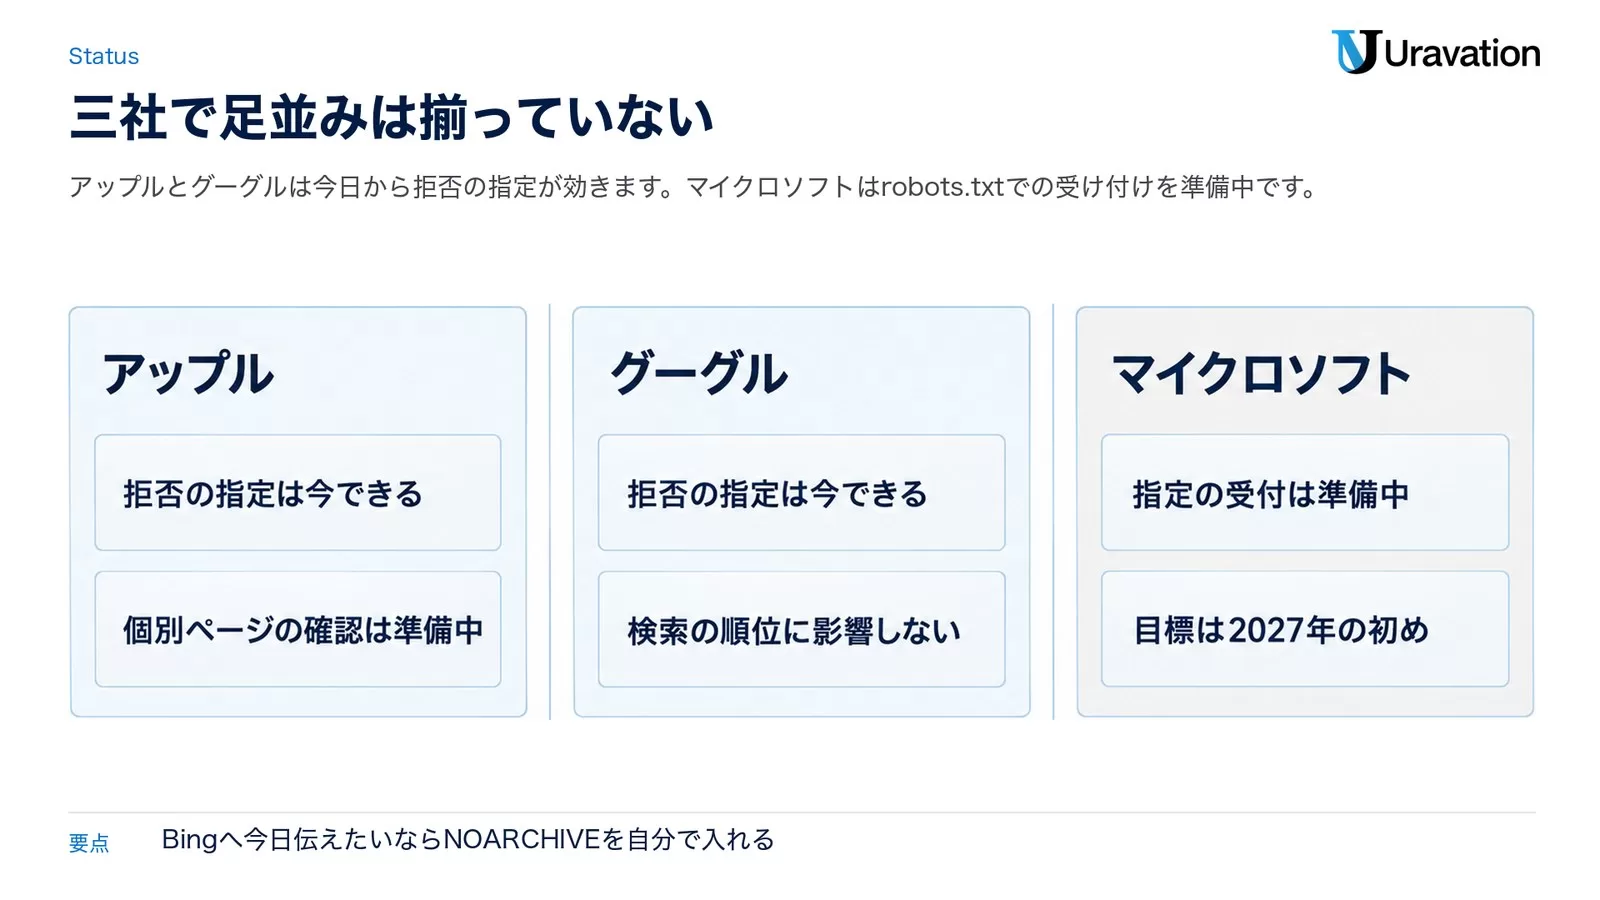
Cloudflareは、Apple・Google・Microsoftの3社がこの基準を満たす(または期限付きで満たすと約束している)と説明しています。各社の状況は次のとおりです。公式ブログの記述に、各社自身の公式ドキュメントで裏を取った内容を並べます。
| 事業者 | 学習拒否の指定方法 | 検索順位への影響 | URL単位の可視化 |
|---|---|---|---|
| Apple(Applebot) | robots.txtで Applebot-Extended をDisallow。AI要約についてはページHTMLの nosnippet、有料記事は isAccessibleForFree: false のラベル付けで除外できる。 | 影響しないとAppleが表明。 | まだ提供されていない。Cloudflareは「来年に向けて開発中の内容を共有された」と記載。 |
| Google(Googlebot) | robots.txtで Google-Extended をDisallow。生成系の検索結果から除外するトグルがウェブマスター向けポータルにある。 | 影響しないとGoogleが表明。 | 検索結果とAI要約の指標は提供済み。Google-Extended関連のURL単位の可視化は「数週間のうちに提供予定」とCloudflareへ共有。 |
| Microsoft(Bingbot) | 現時点ではページに NOARCHIVE メタタグ。robots.txtでのドメイン単位の学習拒否は開発中で、2027年初頭を目標。今日拒否したい場合はNOARCHIVEに加えてBlock URLs / Content Removalツールを使う。 | NOARCHIVEを使っても影響しないとMicrosoftが表明。 | Webmaster Toolsで細かい制御と可視化を提供、とCloudflareが記載。 |
ここも実務上の落とし穴があります。公式ブログにはっきり書かれているのですが、Microsoft側の対応が入るまで、Disallow AI Trainingを選んでもBingに対してrobots.txt経由で学習拒否の意思が自動的には伝わりません。これは、従来のTraining Blockが兼用クローラーに効いていなかったのと実質的に同じ状態だ、とも書かれています。Bingに対して今日止めたいなら、メタタグを自分で入れる必要があります。
各社の一次情報で裏を取った内容
Apple:Appleの公式サポート文書には、Applebot-Extended をrobots.txtでDisallowすると、Applebotが収集したコンテンツをAppleの基盤モデルの学習に使わせないようにできると書かれています。さらに「Applebot-Extendedはウェブページを巡回しない。Applebot-Extendedを拒否したページも検索結果には引き続き含まれうる」と明記されています。Applebot-Extendedは、あくまでApplebotが取得したデータの使い道を決めるための仕組みだということです(出典:Apple「About Applebot」/参照日2026-09-20)。
Google:Googleの公式ドキュメントでは、Google-ExtendedはHTTPリクエスト上の独立したユーザーエージェント文字列を持たず、robots.txtのトークンとして制御専用に使われると説明されています。制御できる用途は、Gemini Appsおよび Vertex AI API for Gemini を支える将来のGeminiモデルの学習と、Gemini Appsおよび Grounding with Google Search on Vertex AI におけるグラウンディング(回答時に検索インデックスの内容をモデルへ渡して正確性と関連性を高めること)です。そして「Google-Extendedは、Google検索への掲載には影響しない」と明記されています(出典:Google「Google’s common crawlers」/参照日2026-09-20)。
Microsoft:Bing Webmaster Blogの2023年9月の告知では、NOARCHIVEを指定したコンテンツはBing Chatの回答に含まれず、回答からリンクもされず、今後はMicrosoftの生成AI基盤モデルの学習にも使われないと書かれています。NOCACHEとNOARCHIVEを併記した場合はNOCACHEとして扱われること、どちらのタグを付けても通常の検索結果には引き続き掲載されることも明記されています(出典:Bing Webmaster Blog「Announcing new options for webmasters to control usage of their content in Bing Chat」2023年9月/参照日2026-09-20)。
検索そのものがAIで組み替わっていく流れについてはGoogle検索が「AI Search」へ大刷新|SEO5アクションも参考になります。
会社の種類別|学習拒否が向くサイト・向かないサイト
ここからが判断です。Cloudflareの公式ブログには、Cloudflare全体の傾向として次の数字が出ています。検索ボットを遮断することを選ぶサイトは1%未満。一方で、学習を止める何らかの仕組みを有効にしているサイトは17%。検索はほぼ全員が歓迎していて、学習については意見が割れている、ということです。この非対称こそが、今回の設定が生まれた理由だと説明されています。
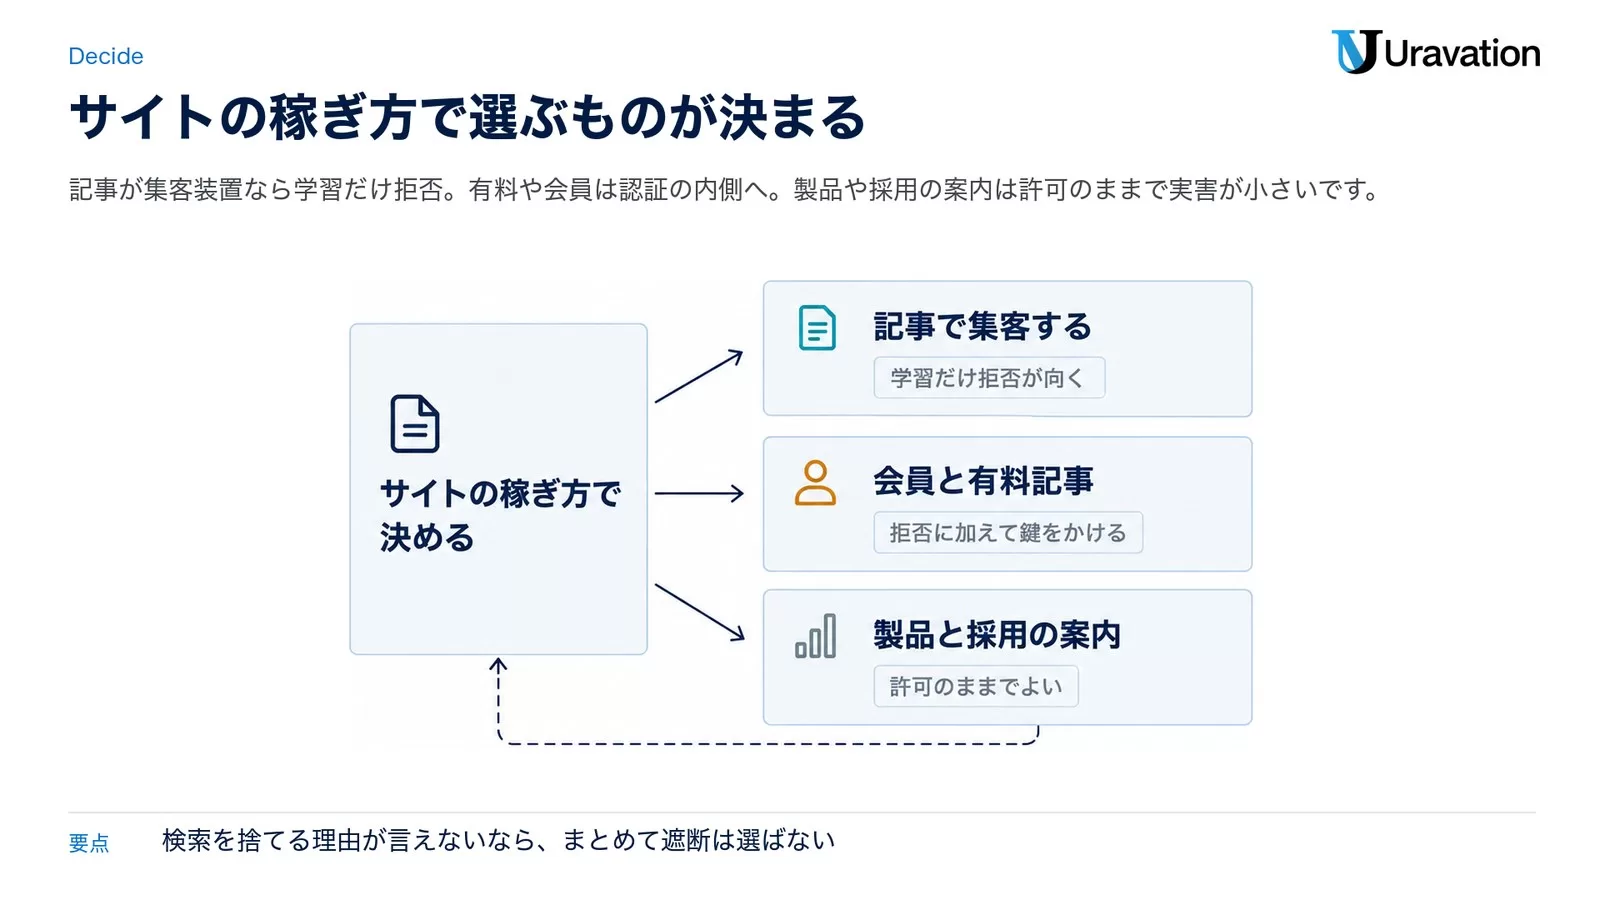
自社がどちらに寄るかは、「サイトが何で稼いでいるか」で決まります。4つの型で整理します。
型1:記事で集客するオウンドメディア・広告収益のある媒体
Disallow AI Trainingが最も向きます。訪問してもらって初めて収益になるのに、学習に使われても直接の見返りがない、という構図がいちばんはっきりしているからです。Cloudflareが新規ドメインの推奨設定で、広告収益ありのサイトだけTrainingをDisallow AI Trainingにしているのも同じ理由です。検索流入は残るので、失うものはほぼありません。
型2:会員制・有料コンテンツを持つサイト
Disallow AI Trainingを選んだうえで、それだけに頼らないでください。公式ドキュメントに明記されているとおり、robots.txtの遵守はあくまで任意です。「このファイルはあなたの意向を表明するものであって、技術的にクローラーのアクセスを防ぐものではない。クローラー事業者の中には Disallow: / のような指示を無視して巡回するものもある」と書かれています(出典:Cloudflare Docs「robots.txt setting」/参照日2026-09-20)。有料部分は認証の内側に置くのが前提で、意思表示はその上に重ねるもの、という順番です。Cloudflare側も「リクエストではなく強制したいならAI Crawl Controlを使う。両方を併用することもできる」と案内しています。
型3:製品サイト・サービス紹介サイト・ECサイト
Allowのままでよい場合が多いです。自社の製品情報がAIの回答に出てくること自体が営業になるからです。Bot Preference Syncの告知記事でも、ECストアは「小さな部屋に合うソファを教えて」とチャットに聞かれたときに自社製品が出てきてほしいので、すべてクロールも学習もされたいと考えるかもしれない、という例が挙げられています。判断の軸は「自社の名前が回答に出ることの価値」と「記事そのものが商品かどうか」です。
型4:採用サイト・コーポレートサイト
どちらでも実害が小さい型です。ページ数が少なく、内容が事実の羅列(会社概要・沿革・募集要項)であることが多いので、学習に使われても失うものが少なく、逆に止めても得るものが少ない。判断コストをかけるより、Allowのまま放置してよい部類です。ただし、採用ページに社員インタビューや技術記事のような独自コンテンツが厚く載っている場合は、型1として扱ってください。
Cloudflareでの設定手順|どこを開いて何を選ぶか
設定場所は公式の表記どおりに書きます。画面のスクリーンショットは載せません(実機をたどれていないため)。
Cloudflare公式ブログの末尾には、「これらの新しい制御は全プランのすべての顧客が利用でき、ドメイン(ゾーン)のSecurity Settingsで設定できる」と書かれています。公式ドキュメント側では、AIボットのポリシーを設定する場所は Security Settings > Configure AI bot policies と案内されています。手順に落とすと次のようになります。
【Cloudflareでの確認・設定手順】
1. Cloudflareダッシュボードにログインし、対象のアカウントとドメイン(ゾーン)を選ぶ
2. Security Settings を開く
3. Configure AI bot policies を開く
4. Search / Training / Agent の3項目の現在値を控える(変更前の記録)
5. Training を「Disallow AI Training」に変更する
6. Search は「Allow」のままであることを確認する
7. robots.txt の設定(Bot Preference Sync)が有効になっていることを確認する
8. 保存後、自サイトの /robots.txt をブラウザで開き、本文が書き換わっているか確認する
4番と8番は飛ばさないでください。変更前の値を控えておかないと、意図しない挙動が出たときに戻せません。8番は、意思表示が実際に外へ出ているかを確認する唯一の方法です。
robots.txtには何が書き込まれるのか
Bot Preference Syncは、ダッシュボードで設定したSearch・Agent・Trainingの方針を、robots.txtに反映し続ける機能です。既にrobots.txtがある場合は、Cloudflareが追加する内容が既存の内容の前に付け足され、既存のDisallow指定はそのまま維持されます(出典:Cloudflare公式ブログ「Say it once: introducing Bot Preference Sync」2026年8月21日/参照日2026-09-20)。公式ブログに載っている例(短縮・匿名化されたもの)は次の形です。
# BEGIN Cloudflare Bot Preference Sync

User-agent: TrainingBot1
User-agent: TrainingBot2
User-agent: TrainingBot3
User-agent: MixedUseBot-Extended
Disallow: /

...

# END Cloudflare Bot Preference Sync
実際にどのボット名が並ぶかは、CloudflareがBotBaseで追跡しているボットに応じて定期的に更新されます。Search・Agent・Trainingに分類された検証済みボットは、Cloudflareの公開ボットディレクトリでいつでも確認できる、と書かれています。
なお、Bot Preference Syncは「カテゴリ単位の方針」を反映する仕組みなので、個別の複雑なカスタムルールは読み取りません。特定の事業者だけ例外にしたいといった細かい運用をしている場合は、同期を切って自分でファイルを管理する選択肢も公式に案内されています。
Content Signalsという別レイヤー
Cloudflareのrobots.txt機能には、ユーザーエージェント単位のDisallowとは別に「Content Signals」という機械可読の指定も含まれます。カテゴリは3つで、search(検索インデックスの構築)、ai-input(リアルタイムの回答生成のためにAIモデルへ入力すること)、ai-train(モデルの学習・ファインチューニング)です。公式ドキュメントに載っている管理コンテンツの例では、次の1行が入ります。
User-Agent: *
Content-signal: search=yes, ai-train=no, use=reference
Allow: /
ここで use=reference というのは、Cloudflareが試験中の content-use という拡張で、アクセスした内容を後から何に再利用してよいかを表すものです。値は3段階で、use=immediate(その場で使うだけで保存も再利用もしない)、use=reference(インデックス化・抜粋・リンクは可)、use=full(要約と再現まで可)。robots.txt機能を有効にした顧客には use=reference が付与される、と書かれています。
一点だけ注意があります。公式ドキュメントには、Google Search Consoleが Content Signals や新しめのディレクティブに対して「Syntax not understood(構文を理解できません)」と報告することがあるが、それによってクロール頻度やSEOに影響が出たことは観測されていない、という注記があります。コンソールに警告が出ても、それ自体を障害として扱わないでください。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修4,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
Cloudflareを使っていないサイトでの代替と限界
レンタルサーバー上のWordPressなど、Cloudflareを経由していないサイトでも、意思表示だけなら自分でrobots.txtに書けます。ただし先に限界を言います。robots.txtは「お願い」であって「防御」ではありません。誰でも書けますが、誰が巡回しているのかを識別することも、なぜ巡回しているのかを判定することも、無視するクローラーを止めることもできません。これはCloudflare自身が公式ブログで「A robots.txt directive alone cannot solve this problem」と書いている点です。守るかどうかは相手次第で、技術的な強制力はゼロです。
そのうえで、各社の公式ドキュメントに載っている構文だけを使うと、次のようになります。創作したディレクティブは1つも入れていません。
# 検索は通したまま、AI学習だけを拒否する最小構成
# 各社の公式ドキュメントに記載された制御用トークンのみを使用

User-agent: Applebot-Extended
Disallow: /

User-agent: Google-Extended
Disallow: /
Applebot-ExtendedはAppleの「About Applebot」に、Google-ExtendedはGoogleの「Google’s common crawlers」に、それぞれこの形で記載されています。どちらも「巡回そのものを止めるトークンではなく、取得済みデータの使い道を制御するためのトークン」であり、検索結果への掲載・順位には影響しないと各社が明記しています。
学習専用クローラーも合わせて止めたい場合は、Cloudflareの管理robots.txtが並べているユーザーエージェント名がそのまま参考になります。公式ドキュメントに載っている一覧は、Amazonbot・Applebot-Extended・Bytespider・CCBot・ClaudeBot・Google-Extended・GPTBot・meta-externalagent です。
# 学習用クローラーへの拒否表明(Cloudflare Docs の管理コンテンツ例に準拠)
User-agent: Amazonbot
Disallow: /

User-agent: Bytespider
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: GPTBot
Disallow: /

User-agent: meta-externalagent
Disallow: /Bingに対して今日から学習利用を止めたい場合は、robots.txtではなくページ側のメタタグです。Microsoftの2023年9月の告知に載っている書き方は次のとおりで、NOARCHIVE を指定したコンテンツは通常の検索結果には引き続き掲載されます。
<!-- Bing: 生成AIの学習・Chat回答への利用を拒否する -->
<meta name="robots" content="noarchive">

<!-- 有料記事など、Chatからの参照は許容したい場合 -->
<meta name="robots" content="noarchive, nocache">
NOARCHIVEとNOCACHEを併記した場合はNOCACHEとして扱われる(=より緩い側が優先される)点に注意してください。全ページを厳格に止めたいなら併記しないことです。
WordPressの場合、robots.txtはプラグインや robots_txt フィルタで出力していることが多く、サーバー上に実ファイルが無いことがあります。書き換えたつもりで反映されていない、という取り違えが起きやすいので、編集後は必ずブラウザで https://自社ドメイン/robots.txt を開いて本文を目で確認してください。
【要注意】やりがちな失敗パターン4つ
失敗1:AIに使われたくないからと「Block」を選んでしまう
❌ Trainingの項目でBlockを選ぶ
⭕ Trainingの項目でDisallow AI Trainingを選ぶ
なぜ重要か:9月15日から、BlockはApplebot・Bingbot・Googlebotにも適用されるようになりました。検索インデックス用のクロールごと止まるので、検索流入が消えます。公式ブログも「兼用クローラーを完全に排除したいなら、今後は自分でそう言う必要がある。Blockを選ぶと、Applebot・Bingbot・Googlebotがサイトへ到達しなくなる。検索も含めて」と念を押しています。名前だけ見て強い方を選ばないでください。
失敗2:学習拒否とAI検索への引用拒否を同じものだと思っている
❌「Disallow AI Trainingにしたから、AIの回答にうちの記事が出ることもなくなる」
⭕「学習は拒否した。AI要約への露出は別の設定で、Cloudflare側からまとめて指定できるようにするのは来年初めが目標」
なぜ重要か:この2つを混同すると、判断の前提が丸ごとずれます。AI検索経由の利用者は従来検索の3倍から5倍超のコンバージョン率だとCloudflareが書いているとおり、引用されること自体は多くの会社にとって利益です。止めるべきは「学習に使われること」であって「回答に出てくること」ではない、というケースの方が中小企業では多数派です。
失敗3:robots.txtを書いたことを「対策完了」と記録してしまう
❌ 社内の管理表に「AI学習対策:robots.txt設定済み・完了」と書く
⭕「AI学習に対する意思表示を公開済み。強制力はないため、機密・有料コンテンツは認証の内側に置く」と書く
なぜ重要か:公式ドキュメントが明記しているとおり、robots.txtの遵守は任意です。「対策完了」と記録されると、次に誰かがそのページを見たときに、本当に守られていると誤解します。意思表示のレイヤーと、強制のレイヤー(アクセス制御・認証・WAF)は、管理表の上でも分けて書いてください。法的なリスク整理は生成AIの著作権リスク7つ|中小企業の規制対応ガイドと合わせて読むと判断しやすくなります。
失敗4:Bingに伝わっていると思い込む
❌「Disallow AI Trainingを選んだので、主要3社すべてに学習拒否が伝わった」
⭕「AppleとGoogleには伝わった。Microsoftのrobots.txt対応は2027年初頭が目標なので、Bingに今日伝えたいならNOARCHIVEを自分で入れる」
なぜ重要か:公式ブログに「そのサポートが提供されるまで、Disallow AI Trainingを選んでもBingへrobots.txt経由で学習拒否の意思が自動的に伝わることはない」と明記されています。三社が同じ扱いだと思って社内に説明すると、後から訂正することになります。
Uravationならこう判断する
100社以上の企業でAI導入を支援してきた立場から言うと、この設定を「AIに反対するかどうか」の踏み絵として扱うと、たいてい判断を誤ります。決めるべきなのは思想ではなく、自社のサイトが何で稼いでいて、そのどこがAIに代替されるのかだけです。
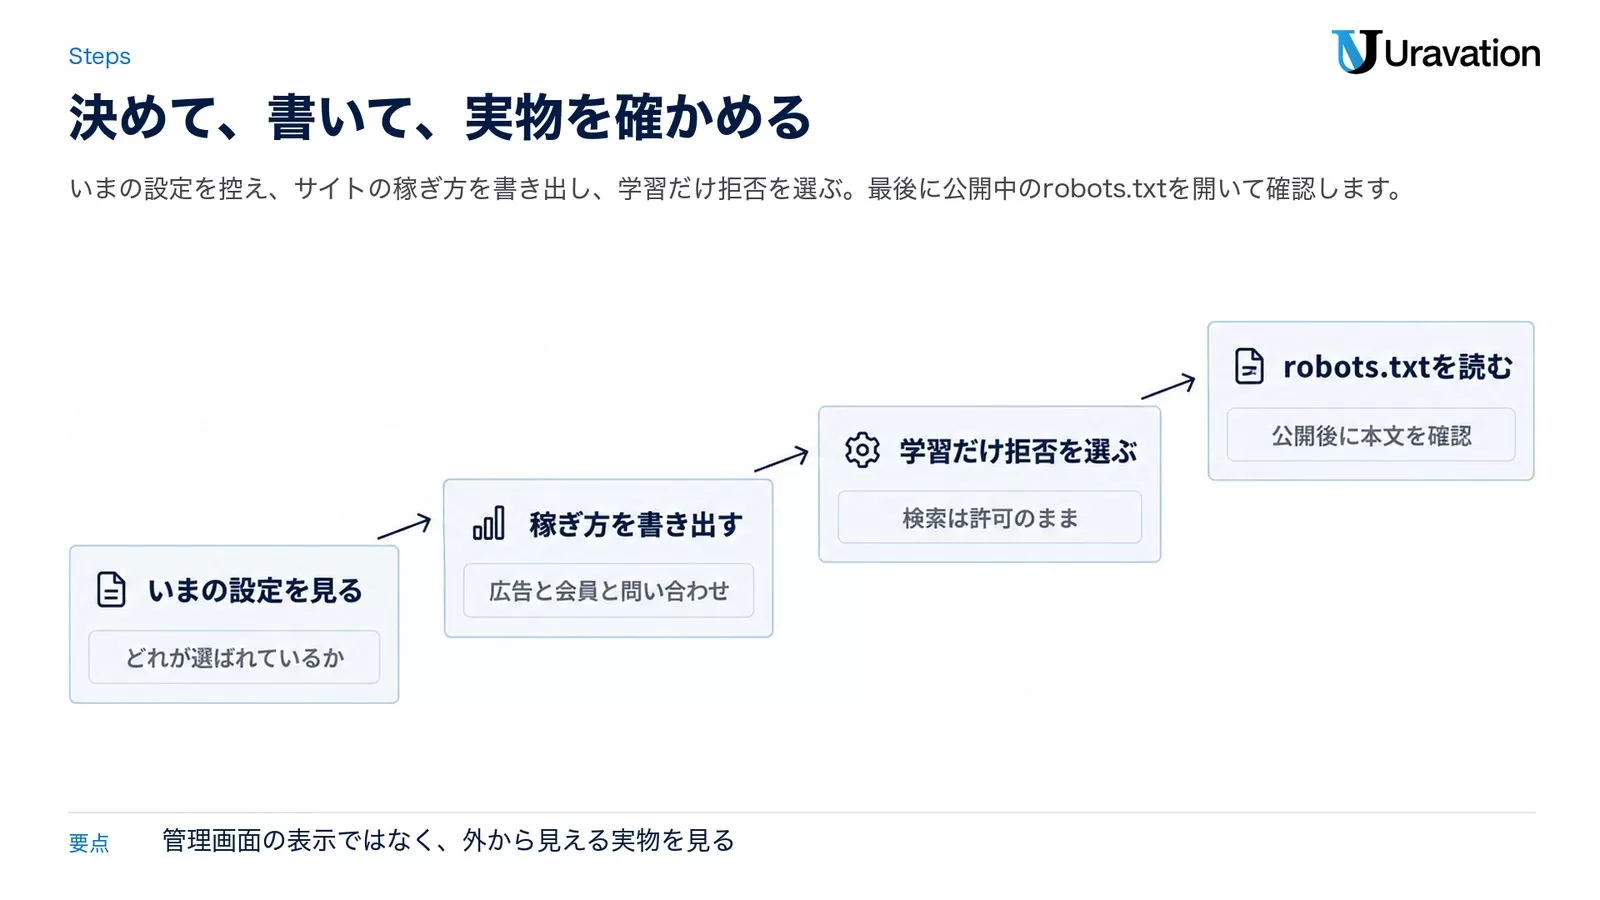
整理すると、こうなります。
- 記事そのものが集客装置になっている会社(オウンドメディア運用型・広告収益型)は、Disallow AI Trainingを選ぶ。検索流入は残るので、実質的に失うものがありません。
- 記事が「入口」で、成約は人が動いて取っている会社(法人向けサービス・受託・士業など)は、迷ったらAllowのままでよい。AI検索の回答に自社が出ることの方が、学習に使われる不利益より大きい可能性が高いからです。
- コンテンツそのものを売っている会社(有料記事・講座・データベース)は、Disallow AI Trainingを選んだうえで、収益の核は認証の内側へ移す。意思表示に強制力がない以上、これは設定の話ではなく設計の話です。
- Blockを選ぶべき会社は、実はかなり少ない。検索を丸ごと捨ててよい理由が明確に言語化できないなら、選ばないでください。
そして、どの型であっても共通してやっておくべきことが一つあります。今の設定値を記録することです。今回の変更で、同じ「Block」という言葉の意味が変わりました。同じことはこれからも起きます。自社が何を選んでいるかを文章で残しておかないと、次に仕様が動いたとき、影響があるのかないのかを誰も判断できません。設定画面のスクリーンショットではなく、「Search=Allow、Training=Disallow AI Training、Agent=Allow、理由:記事で集客しているため」という一文で十分です。
社内で確認するなら、次のチェックリストをそのまま使ってください。
【AI学習の扱いを決めるための社内確認リスト】
□ このサイトは何で収益を上げているか(広告/会員課金/問い合わせ/採用/EC)
□ 記事そのものが商品か、それとも入口か
□ 検索流入が消えた場合、売上に影響が出るか(出るなら Block は選ばない)
□ AI検索の回答に自社名が出ることは、得か損か
□ 有料・会員限定のコンテンツは認証の内側にあるか(robots.txt に依存していないか)
□ 現在の Search / Training / Agent の設定値を記録したか
□ 設定変更後に /robots.txt の本文を実際に開いて確認したか
□ Bing 向けに NOARCHIVE を入れるかどうかを決めたか
□ 変更日と決定理由を、担当者が変わっても読める形で残したか
もう一つ、設定を変えたあとに実際の出力を確認するためのコマンドも置いておきます。管理画面上の表示ではなく、外から見える実物を見るためのものです。
# 自社の robots.txt が実際にどう返っているかを確認する
curl -s https://自社ドメイン/robots.txt

# Cloudflare の同期ブロックが入っているかだけ見る
curl -s https://自社ドメイン/robots.txt | grep -i "Bot Preference Sync"

# Content Signals の行が入っているかを見る
curl -s https://自社ドメイン/robots.txt | grep -i "Content-signal"正直に書いておくと、この設定を入れたからといって、明日から何かが目に見えて変わるわけではありません。学習に使われたかどうかは、サイト運営者からは基本的に見えないからです。だからこそCloudflareは、Accountableの条件に「URL単位でどのページが学習に供されたかの可視化」を入れました。可視化が各社で揃うまでは、意思表示は出した・強制はしていない・確認手段はまだ整っていないという3点を、そのまま社内に共有するのが正確な報告です。
よくある質問
Disallow AI Trainingは有料プランでないと使えませんか
いいえ。Cloudflare公式ブログには「これらの新しい制御は全プランのすべての顧客が利用でき、ドメイン(ゾーン)のSecurity Settingsで設定できる」と明記されています。Bot Preference Syncについても、無料プランからEnterpriseまで全プランで提供されると2026年8月21日の告知に書かれています。
設定すると検索順位は下がりますか
Apple・Google・Microsoftの3社とも、学習拒否の指定は検索順位に影響しないと表明しています。Googleの公式ドキュメントには「Google-Extendedは、Google検索への掲載には影響しない」と書かれており、Appleの公式サポート文書にも「Applebot-Extendedを拒否したページも検索結果には引き続き含まれうる」とあります。Microsoftについても、NOARCHIVEを使っても検索順位に影響しないと表明したとCloudflareが記載しています。ただし、Trainingの項目でBlockを選んだ場合は話が別で、2026年9月15日からは検索用のクロールごと止まります。
すでにTrainingをBlockにしていました。今すぐ何かする必要はありますか
公式ブログによれば、これまでTrainingでBlockまたはBlock on pages with adsを選んでいたドメインは、Disallow AI Trainingへ自動的に移行します。つまり検索は通ったままになります。兼用クローラーごと完全に遮断したい場合だけ、あらためてBlockを選び直す必要があります。逆に言うと、意図せず検索まで止まることはない設計になっています。
Cloudflareを使っていなくても同じことはできますか
意思表示だけなら自分でrobots.txtに書けます。Appleの Applebot-Extended とGoogleの Google-Extended は、各社の公式ドキュメントに記載された制御用トークンなので、そのままDisallowで書けば同じ意味になります。ただし、誰が巡回しているかを識別することも、無視するクローラーを止めることもできません。Cloudflare側が担っているのは「意思表示の公開」だけでなく「識別と遮断」でもある、という差です。
AI要約・AI検索の回答に引用されないようにもできますか
Disallow AI Trainingではできません。2026年9月20日時点では、要約のオプトアウトは各事業者側の仕組みを個別に使う形です。Appleは nosnippet メタタグと有料記事のラベル付け、Googleはウェブマスター向けポータルのトグル、MicrosoftはNOARCHIVEメタタグが該当します。Cloudflare側からまとめて指定でき、かつ「どれくらいの分量まで使ってよいか」まで制御できるようにすることは、来年初めを目標として公表されています。
まとめ:今日から始める3つのアクション
- 今日:自社サイトの
https://自社ドメイン/robots.txtをブラウザで開き、現在どう表明しているかを確認する。何も書かれていないなら、それが現状の回答です。 - 今週中:この記事の「会社の種類別」の4つの型に自社を当てはめ、Search / Training / Agent の3項目をどうするかを1行で決めて記録する。Cloudflareを使っている場合は Security Settings > Configure AI bot policies で現在値を控える。
- 今月中:決めた内容を反映し、反映後の
/robots.txtを実際に開いて確認する。Bing向けのNOARCHIVEを入れるかどうかも同時に決めておく。有料・会員限定のコンテンツがあるなら、robots.txtに頼らず認証の内側にあるかを点検する。
あわせて読みたい
- AIに引用される記事の条件|ChatGPT・Gemini・Claude引用分析 — 学習を断ったうえで、AI検索からは引用されたい場合の設計
- AIEO完全ガイド|AI検索から引用される実装ノウハウ — AI検索経由の流入を取りにいく側の実装
著者:佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。
100社以上の企業向けAI研修・導入支援。著書『AIエージェント仕事術』『Claude仕事術』(SBクリエイティブ・シリーズ累計約6万部)。
SBクリエイティブ「ビジネス+IT」ほかで生成AI連載を執筆(NewsPicks最大1,125ピックス)。
ご質問・ご相談は お問い合わせフォーム からお気軽にどうぞ。
参考・出典
- Have it both ways: stay discoverable in search while disallowing AI training — Cloudflare Blog(2026年9月15日・参照日: 2026-09-20)
- Say it once: introducing Bot Preference Sync — Cloudflare Blog(2026年8月21日・参照日: 2026-09-20)
- robots.txt setting — Cloudflare Docs(最終更新 2026年8月3日・参照日: 2026-09-20)
- Block AI Bots — Cloudflare Docs(最終更新 2026年7月1日・参照日: 2026-09-20)
- About Applebot — Apple Support(参照日: 2026-09-20)
- Google’s common crawlers — Google for Developers(参照日: 2026-09-20)
- Announcing new options for webmasters to control usage of their content in Bing Chat — Bing Webmaster Blog(2023年9月・参照日: 2026-09-20)
この記事の内容を社内で使うなら
研修導入の前後で確認しておきたい40項目を体系化。失敗回避の実践チェックリストです。
- 100社以上・研修4,000名以上の実績
- 初回30分無料・即日返信
資料は受け取りページからすぐにご覧いただけます。