結論(2026年9月時点):NVIDIA B300は公式定価が非公開で、価格は見積ベースです。2026年8月時点の相場はDGX B300(8GPU)が$300,000〜$350,000=約4,800万円〜5,600万円(1ドル159.68円換算)、DGX Station GB300が約1,360万円〜2,000万円、GB300 NVL72は完全見積制、クラウドは1GPU時間あたり中央値$7.85。パートナー間で数百万円の差が出ます。
最終更新日:2026年8月30日(価格・出荷状況・クラウド単価を2026年8月時点の一次情報で全面更新)
結論: NVIDIA B300(Blackwell Ultra)の価格は、2026年8月時点でもNVIDIA公式の定価は公表されておらず、見積ベースです。ただし相場は見えています。8GPU搭載のDGX B300は報道・販売パートナー情報で約$300,000〜$350,000(1ドル159.68円換算で約4,800万円〜5,600万円)、デスクサイド機のDGX Station GB300は報道で約$85,000〜$125,000、72GPUのGB300 NVL72は完全見積制、クラウドのB300時間単価は中央値$7.85/GPU(2026年8月29日時点)です。B300自体は288GB HBM3e・8TB/s・15 PFLOPS FP4という現行世代最高密度のAI推論GPUで、DGX B300は「Shipping Now(出荷中)」になっています。
この記事の要点:
- B300の主要スペック(288GB HBM3e・8TB/s・15 PFLOPS FP4・1,400W TDP)をNVIDIA公式ソースで解説
- DGX B300・GB300 NVL72・DGX Station GB300・HGX B300の価格相場と発売日・出荷状況を2026年8月時点で整理(確認できない数字は「未確認」と明記)
- クラウドでB300を使う場合の時間単価(16社・中央値$7.85/GPU)と、H100/B200からのアップグレード判断基準・FAQ
B300の価格早見表(2026年8月時点)
| 製品 | 構成 | 価格の目安(USD) | 円換算の目安 | 根拠・注記 |
|---|---|---|---|---|
| B300 単体(SXM) | GPU 1枚 | 単体での一般販売なし。業界情報では約$50,000台 | 約800万円前後 | NVIDIA公式単価は2026年8月時点で未確認 |
| HGX B300 | 8× B300ベースボード | サーバーメーカー経由の見積制 | — | NVIDIA公式価格なし。搭載サーバーはDGX B300と同等以上 |
| DGX B300 | 8× B300・2.1TB | 約$300,000〜$350,000(構成・保守により$500,000超の例も) | 約4,800万円〜5,600万円 | 報道・販売パートナー公表レンジ。NVIDIA公式定価は非公開 |
| GB300 NVL72 | 72× B300+36× Grace(1ラック) | 完全見積制 | — | NVIDIA公式・一次報道の価格は2026年8月時点で未確認 |
| DGX Station GB300 | GB300 Grace Blackwell Ultra Desktop Superchip×1・748GB | 約$85,000〜$125,000 | 約1,360万円〜2,000万円 | 報道ではMSI XpertStation WS300が$85,000〜$96,995.99、他OEMは$103,500〜$123,000 |
| クラウド(B300 1GPU・オンデマンド) | 1GPU/時間 | 中央値$7.85/hr(最安$6.33〜最高$17.80) | 約1,250円/時 | getdeploying集計・2026年8月29日更新・16社 |
円換算は1ドル=159.68円(2026年8月28日の欧州中央銀行参照レート)で計算し、概数に丸めています。為替と構成で数百万円単位で動くため、実際の調達では必ず複数パートナーから見積を取ってください。
対象読者: AI推論インフラの選定を検討中のIT責任者・CTO・データサイエンスチームリード
読了後にできること: B300・DGX B300・GB300 NVL72・DGX Station GB300の違いと価格相場を理解し、自社のAIインフラ投資の優先順位を整理できます
「H100をやっと調達できたと思ったら、もう次世代の話が出てきた…」
企業向けAI研修やインフラ選定の相談を受けていると、こんな声を本当によく聞きます。NVIDIA GPUのロードマップは速く、B100→B200→B300、そして2026年秋にはVera Rubinへと半年〜1年サイクルで更新されていくため、「いつ何を、いくらで買えばいいのか」の判断が非常に難しくなっています。
報道では2026年1月に量産出荷が始まり、3月のGTC 2026で「AI推論時代のプラットフォーム」として位置づけられたBlackwell Ultra B300は、特にAI推論(Reasoning)モデルに特化した設計になっています。GPT-4クラス以上のモデルをリアルタイムで動かす、あるいは複数のエージェントを並列で走らせるという用途では、H100とは別次元の性能を発揮します。
この記事では、NVIDIA公式ソースで確認したB300のスペックと、2026年8月時点の価格相場・出荷状況を整理しながら、日本企業がオンプレ投資とクラウド活用をどう判断すべきかを実務的な視点でお伝えします。
Blackwell Ultra B300とは何か ー AI推論時代のGPU再定義
B300(正式名称: NVIDIA Blackwell Ultra)は、2025年3月のGTC 2025でロードマップが発表され、報道では2026年1月から量産出荷が始まったNVIDIAのデータセンターGPUです。GTC 2026(2026年3月16〜19日、サンノゼ)では、NVIDIAが「AI推論時代のAIファクトリープラットフォーム」として正式に位置づけました。GTC 2026の発表が日本企業に与える影響はNVIDIA GTC 2026の企業向けAI発表まとめで整理しています。
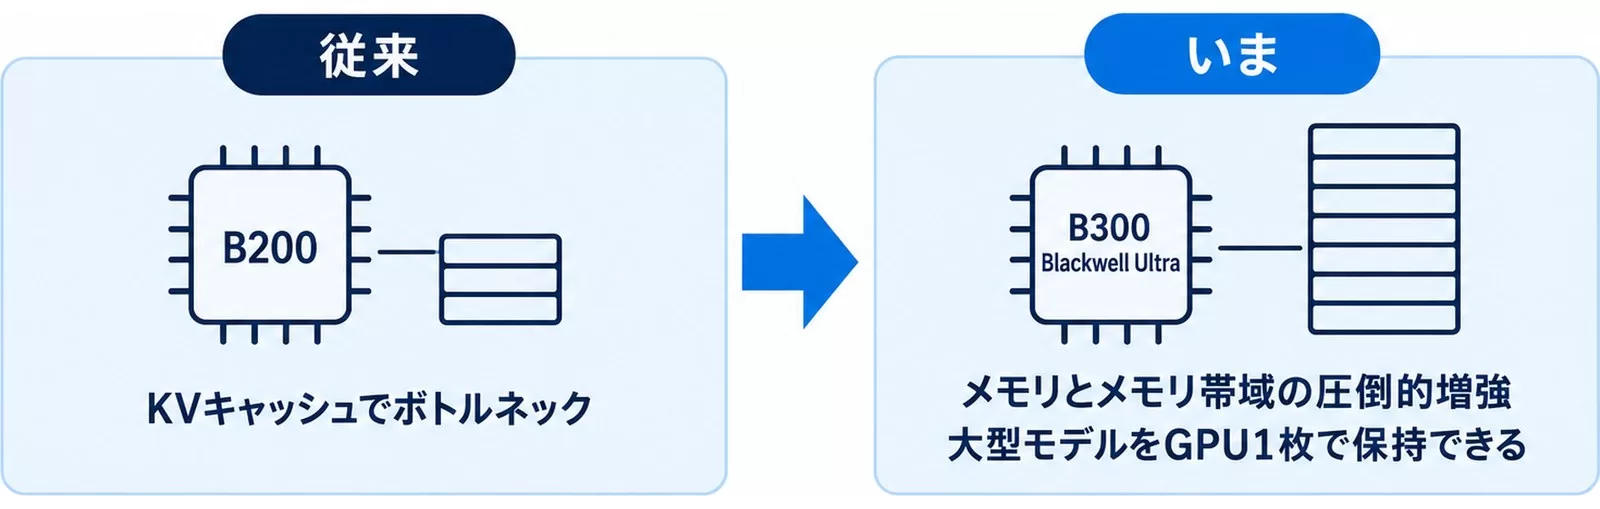
B300の特徴を一言で表すなら、「メモリとメモリ帯域の圧倒的増強」です。前世代のB200と比べてメモリ容量が192GB→288GBへ1.5倍、FP4演算性能も約1.5倍向上しています。
単体GPU(B300)の主要スペック
| スペック | B300(Blackwell Ultra) | B200(Blackwell) | H100(Hopper) |
|---|---|---|---|
| HBM世代 | HBM3e(12-Hi stacks) | HBM3e(8-Hi stacks) | HBM3 |
| メモリ容量 | 288 GB | 192 GB | 80 GB |
| メモリ帯域 | 8 TB/s | 8 TB/s | 3.35 TB/s |
| FP4演算(dense) | 15 PFLOPS | 9 PFLOPS | — |
| TDP | 1,400W | 1,000W | 700W |
| NVLink(GPU間) | 1.8 TB/s(第5世代) | 1.8 TB/s(第5世代) | 900 GB/s(第4世代) |
注目すべきはHBM3eのスタック数が8-Hi→12-Hiに増えた点です。物理的に高く積み上げることで、同じダイサイズのままメモリを増やしています。帯域は8 TB/sと変わりませんが、容量の増加により大型モデルをGPU1枚で保持できるシナリオが格段に広がります。
AI推論における「メモリ容量」の重要性はよく過小評価されます。100億パラメータを超えるモデルの場合、FP16精度で1パラメータあたり2バイトが必要です。つまり700億パラメータ(70B)のモデルを動かすには最低でも140GBのGPUメモリが必要。B200の192GBは十分に見えますが、KVキャッシュ(コンテキスト保持)を加えると一気にボトルネックになります。B300の288GBはこの問題を大きく緩和します。
AI導入戦略の全体像については、AI導入戦略完全ガイドで解説しています。インフラ選定はその一部に過ぎず、組織・データ・ユースケース設計とセットで考える必要があります。
NVIDIA B300の価格|DGX B300・GB300 NVL72・DGX Station GB300
大前提としてNVIDIAはB300系製品の定価を公表していません。DGX B300・GB300 NVL72・DGX Stationの公式ページはいずれも「パートナーに問い合わせ」で価格欄はなく、以下は2026年8月時点でNVIDIA公式・一次報道・販売パートナーの公開情報から確認できる範囲の相場です。
DGX B300の価格(8GPU・約$300,000〜$350,000が中心レンジ)
DGX B300(B300を8基搭載)の価格は、報道・GPU専門ベンダーの公開情報では約$300,000〜$350,000が中心レンジで、ストレージ・ネットワーク・保守契約の組み方によっては$400,000〜$500,000超になる例も報じられています。円換算では1ドル159.68円(2026年8月28日)で約4,800万円〜5,600万円です。国内ではHPCシステムズ、HPCテック、アプライドなどのNVIDIAパートナーが取り扱っており、いずれも見積ベース。複数社から構成を揃えた見積を取ると価格差が数百万円単位で出ます。
価格を押し上げている要因の一つがHBM/DRAM相場の高騰です。2026年第2四半期のDRAM価格上昇がAIハードウェアの調達コストに与えた影響はDRAM価格高騰とAIハードウェアコストへの影響で解説しています。
GB300 NVL72の価格(ラック単位・完全見積制)
GB300 NVL72(B300×72+Grace CPU×36の液冷ラック)の価格は、NVIDIA公式でも一次報道でも2026年8月時点で公式に確認できていません。業界ブログには1ラック数百万ドル規模の推計がありますが一次情報ではないため、本記事では数字として採用しません。実際の調達はHPEやDellなどのOEM、または大手GPUクラウドの専用契約経由で、電源・冷却・設置工事込みのプロジェクト見積になります。
DGX Station GB300の価格(デスクサイド・約$85,000〜$125,000)
DGX Station GB300(旧版の本記事で「DGX Station B300」と表記していた製品の正式名称)は、GB300 Grace Blackwell Ultra Desktop Superchipを1基搭載したデスクサイド機で、NVIDIA公式ページではGPUメモリ252GB HBM3e(7.1TB/s)・CPUメモリ496GB LPDDR5X(合計748GB)、FP4 20 PFLOPS(sparse)、ConnectX-8 SuperNIC(最大800Gb/s)という仕様です。価格はNVIDIA公式では非公開ですが、報道ではMSIのXpertStation WS300が$85,000(TechRadar)〜$96,995.99(CDW掲載)、Tom’s Hardwareは掲載価格を「約$100,000」と報じ、他OEM構成では$103,500〜$123,000が紹介されています。まとめると約$85,000〜$125,000(約1,360万円〜2,000万円)が2026年8月時点の相場で、ASUS・Dell・HP・Gigabyte・MSI・Supermicroが製造パートナー、報道では2026年6月から出荷が始まっています。
HGX B300・単体B300の価格
HGX B300(8基のB300を載せたベースボード)はサーバーメーカーがシステムに組み込んで販売する部材で、NVIDIA公式価格はありません。「hgx b300 価格」は実質的にSupermicro・Dell・HPE・GIGABYTEなどのHGX B300搭載サーバーの見積になり、DGX B300と同等以上のレンジが一般的です。単体B300は一般販売されず、業界情報では約$50,000台とされますが、NVIDIA公式の単価は2026年8月時点で公式に確認できていません。
B300の発売日・出荷状況(2026年8月時点)
- B300 / HGX B300: 2025年3月のGTC 2025で発表。報道では2026年1月から量産出荷が本格化。国内でも2026年4月からB300系の取り扱いを始めた販売代理店があります
- DGX B300: NVIDIA公式ページが「NVIDIA DGX B300 Systems Are Shipping Now(出荷中)」と明記(2026年8月30日参照)。オンプレ・コロケーション・クラウドの3形態でパートナー経由の提供
- GB300 NVL72: NVIDIA公式ページで「Available Now」。ただしラックスケール製品のため、発注から設置まで数ヶ月のプロジェクトになるのが通常
- DGX Station GB300: 報道では2026年6月からOEM各社経由で出荷開始。NVIDIA公式ページには「発売通知を受け取る」フォームが残っており、OEM・地域によって供給差があります
- 需要環境: NVIDIAの2027会計年度第2四半期(2026年7月26日締め)はデータセンター売上が890億ドル(前年同期比117%増)で供給は依然逼迫。「値下がり待ち」は当面期待しにくい状況です
DGX B300とGB300 NVL72 ー システム構成と価格
B300単体GPUは一般に直接販売されません。企業が調達するのは主に以下の3つのシステム形態です。価格の詳細は前章の価格早見表を参照してください。
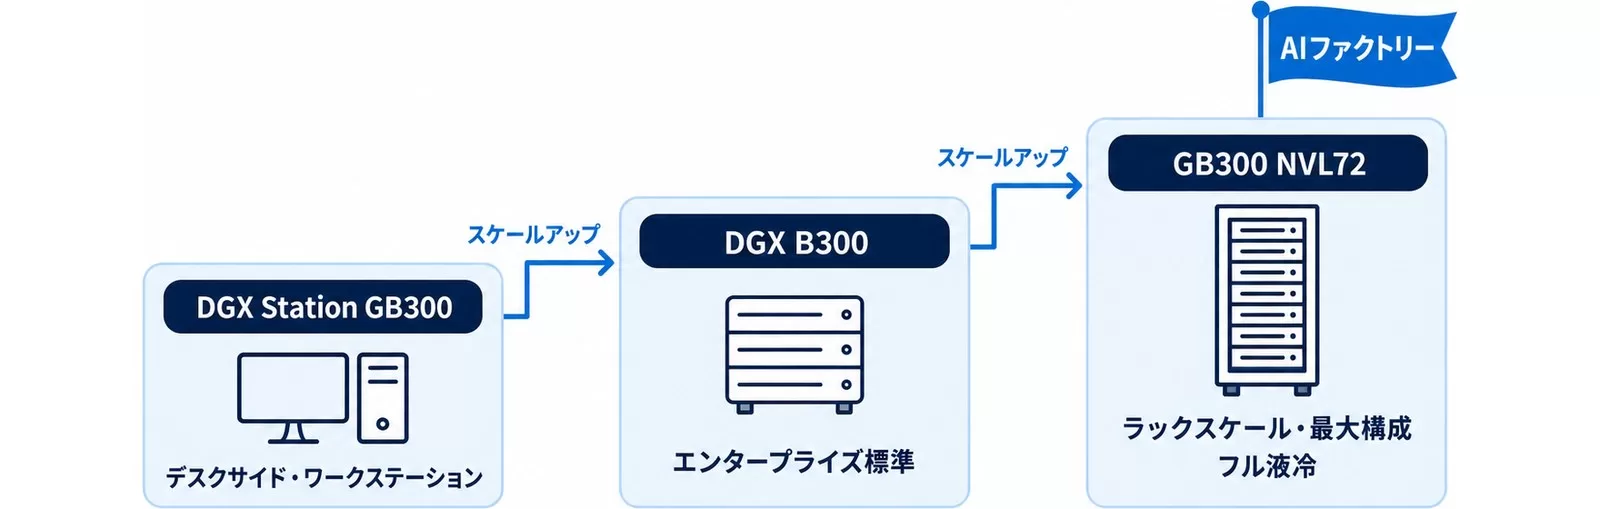
1. DGX B300(エンタープライズ標準)
- GPU構成: 8× Blackwell Ultra SXM B300
- 総メモリ: 2.1 TB(GPU)
- CPU: Intel Xeon 6776P
- FP4演算(sparse): 144 PFLOPS
- FP4演算(dense): 108 PFLOPS(8GPU合計)
- NVLink帯域: 14.4 TB/s(GPU間・NVLink Switch×2)
- 消費電力: 約14 kW
- フォームファクタ: 10U
- 価格帯: 報道・販売パートナー情報で約$300,000〜$350,000(NVIDIA公式定価は非公開・2026年8月時点)
DGX B200(前世代)が$300,000〜$515,000だったことを考えると、B300は価格対性能比が大幅に改善されています。NVIDIAはDGX B300公式ページで「DGX B200比で1.5倍のdense FP4性能・2倍のattention性能」と明示しています。
2. DGX Station GB300(デスクサイド・ワークステーション)
- GPU: GB300 Grace Blackwell Ultra Desktop Superchip(Blackwell Ultra GPU+Grace CPU)
- メモリ: GPU 252GB HBM3e+CPU 496GB LPDDR5X=748GB
- 価格帯: 報道で約$85,000〜$125,000(2026年8月時点)
- 用途: 研究者・デベロッパーのデスクサイドでの大型モデル推論、ファインチューニング
ラックスペースを用意できない組織や、小規模チームが個別に高性能インフラを使いたいケースに適します。液冷設備が不要なため、「B300クラスをまず1台社内に置きたい」という中堅企業の最初の一手として現実的な選択肢です。
3. GB300 NVL72(ラックスケール・最大構成)
| 項目 | GB300 NVL72 |
|---|---|
| GPU数 | 72× Blackwell Ultra |
| CPU数 | 36× NVIDIA Grace(Arm Neoverse V2) |
| 総GPUメモリ | 20 TB(帯域576 TB/s) |
| 総CPUメモリ | 17 TB LPDDR5X(帯域14 TB/s) |
| FP4演算 | 1,440 PFLOPS(sparse)/1,080 PFLOPS(dense) |
| FP8/FP6演算 | 720 PFLOPS |
| NVLink帯域 | 130 TB/s |
| 冷却 | フル液冷ラックスケール |
| ネットワーク | 800 Gb/s/GPU(Quantum-X800 IB or Spectrum-X) |
GB300 NVL72はNVIDIAが「AIファクトリー」と呼ぶフル液冷ラックシステムです。72枚のGPUをNVLinkで全接続し、1ラックで前世代HopperシステムのLLM推論比で11x 高速化、7x 多コンピュート、4x 大メモリ(HGX B300 NVL16とHopperの比較。公式発表)を実現します。さらに公式ページでは「Hopper比でAIファクトリーの出力性能が50x、ユーザーあたり応答性(TPS/ユーザー)が10x、メガワットあたりスループットが5x」としています(※GPU利用効率・スループット改善を含む包括的な指標)。
価格は非公開で、見積もりベースでの販売です。複数ラックを組み合わせてPB級のAIクラスタを構成するのが典型的な用途です。
H100・B200からB300へのアップグレード判断基準
「今すぐB300に移行すべきか」という質問はよく受けます。答えは用途によって大きく異なります。
B300が圧倒的に有利なケース
1. AI Reasoning(推論型)モデルの推論インフラ
OpenAIのoシリーズ、Claudeの拡張思考(Extended Thinking)モード、DeepSeek R1などのReasoningモデルは、長いChain-of-Thoughtを生成するためKVキャッシュが爆発的に増大します。288GBの広大なメモリは、長文推論のレイテンシを劇的に改善します。
2. 70B〜数百Bパラメータモデルの単GPU推論
Llama 4 Maverickのような大型モデルをGPU間を分割せずに単体で動かせる場合、モデル並列によるレイテンシペナルティがゼロになります。
3. マルチエージェント並列処理
複数のAIエージェントが同時に動く環境では、各エージェントのKVキャッシュを独立して確保できる大容量メモリが決定的な差になります。
H100で十分なケース
1. 画像・音声・動画生成(ディフュージョンモデル)
Stable Diffusionや音声TTS等の生成ワークロードはFP16/BF16が主流で、FP4の恩恵は限定的。H100の80GBでも十分なケースが多い。
2. 7B〜13Bモデルのバッチ推論
比較的小さいモデルを大量にバッチ処理する場合、メモリ容量より実効throughputが重要になり、H100でも十分なROIが出る。
3. 既存H100インフラの活用期間中
H100を購入済みで減価償却が終わっていない場合、B300への移行コストを正当化するためには2〜3倍以上の推論需要増が必要です。
なおB200を既に保有し、モデルが192GBに収まっているなら、B300への買い替え効果は小さく「増設ならB300、置き換えならVera Rubin待ち」が合理的です。またNVIDIA一択にせず、推論コスト重視ならAWS TrainiumやGoogle TPU(Ironwood)も比較対象に入れておくと、クラウド価格交渉の材料になります。
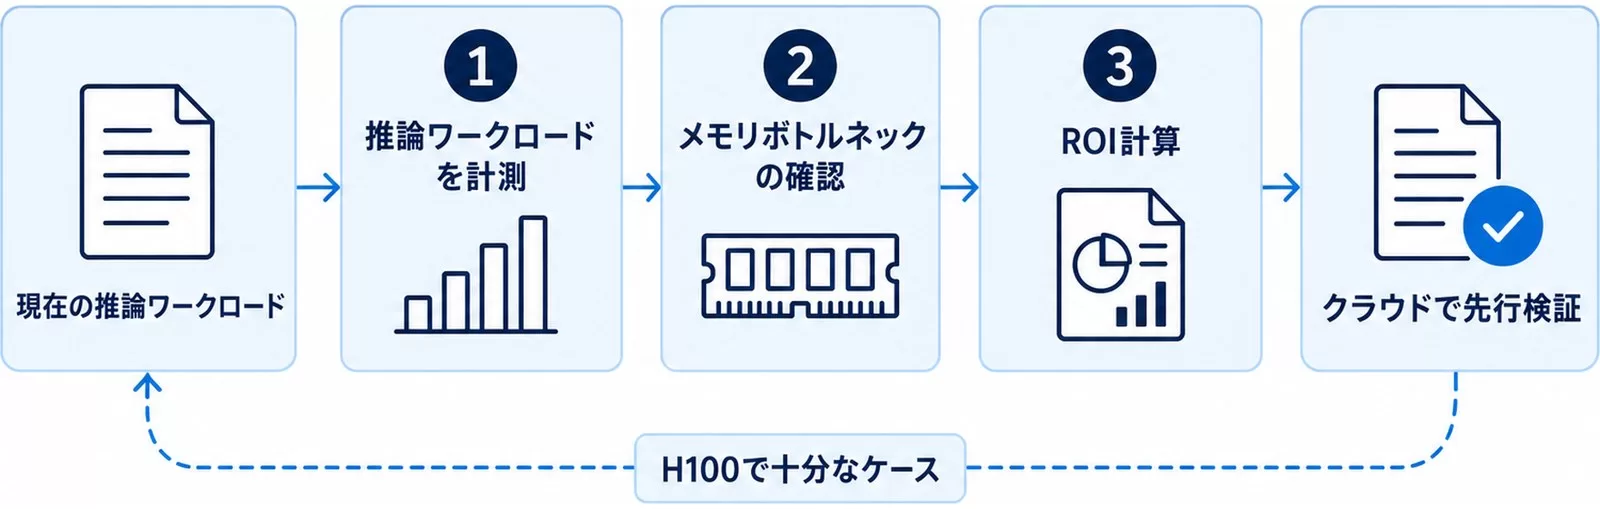
アップグレード判断の実務フロー
以下は私が企業向けに提案している判断フレームワークです:
Step 1: 現在の推論ワークロードを計測
  ├── モデルサイズ(パラメータ数)
  ├── コンテキスト長(最大トークン数)
  └── 同時リクエスト数(ピーク時)

Step 2: メモリボトルネックの確認
  ├── nvidia-smi で GPU Memory Utilization を計測
  └── 70%超 → メモリがボトルネック → B300有利

Step 3: ROI計算
  ├── 現在のクラウドGPU月次コスト
  └── DGX B300(約$300,000〜$350,000)の3年総保有コストと比較

Step 4: クラウドで先行検証
  └── B300オンデマンド(中央値$7.85/GPU/hr)で試用してベンチマーク取得
クラウドでB300を使う ー 2026年8月時点の選択肢
DGX B300は約$300,000〜$350,000という高額システムですが、クラウドで先行検証することで購入前にROIを測定できます。2026年8月29日時点で価格比較サイトgetdeployingが集計するB300のオンデマンド単価は16社・中央値$7.85/GPU/時間です(主要9社を抜粋)。
| プロバイダー | B300 単価/GPU/時間(オンデマンド) | 在庫状況(2026年8月29日時点) |
|---|---|---|
| GPU.ai | $6.33 | 在庫あり(最安) |
| Runpod | $6.94 | 在庫切れ |
| Hyperstack | $7.40 | — |
| Verda | $7.50 | 在庫切れ |
| Nebius | $7.85 | — |
| Spheron | $8.44 | 在庫あり |
| Scaleway | $8.73 | 在庫切れ |
| Oracle Cloud | $15.00 | — |
| AWS | $17.80 | 在庫あり(最高値) |
読み方のポイントは3つです。
- 相場は単GPUあたり$7〜9/時間: H100の$2〜3/時間より高く見えますが、288GBを1枚で使えるため70Bクラス以上ではGPU枚数を減らせ、実効コストは逆転しうる水準です
- 大手は割高、専業は安いが在庫が薄い: AWS($17.80)やOracle($15.00)は専業各社の2倍以上。逆に$7以下の専業勢は在庫切れが目立ち、「安いところにすぐ借りられる」わけではありません
- Reserved・スポットで3〜4割安: 各社料金表ではスポット・長期予約で$5〜6/時間台が提示されています。数ヶ月の検証ならまずReserved見積を取るのが定石です
なお本記事の旧版(2026年5月)に載せていた「Scaleway 8× HGX B300で$1.08/時間」は、2026年8月時点の価格トラッカーでは確認できず(同社のB300は単GPU$8.73〜$10.97/時間で掲載)、本版で訂正します。
GB300 NVL72相当のインスタンスは大手GPUクラウドが専用契約で提供しています。クラウドのB300/GB300インスタンスは提供開始からまだ日が浅く、可用性が不安定なケースがあるため、本番利用の前にSLAとリージョン(東京リージョンの有無)を確認することを推奨します。
この記事の内容、自社の業務でも回したい?
AI顧問(月次伴走)が、貴社の業務に合わせて導入から定着まで並走します。研修4,000名以上・支援100社以上の実績。まずは30分の壁打ちから。
日本企業のオンプレAI投資判断 ー 現実的な検討ポイント
「B300が良いのはわかった。でも日本の中堅企業がいきなり$300,000(約4,800万円)のシステムを買えるのか?」という疑問は当然です。
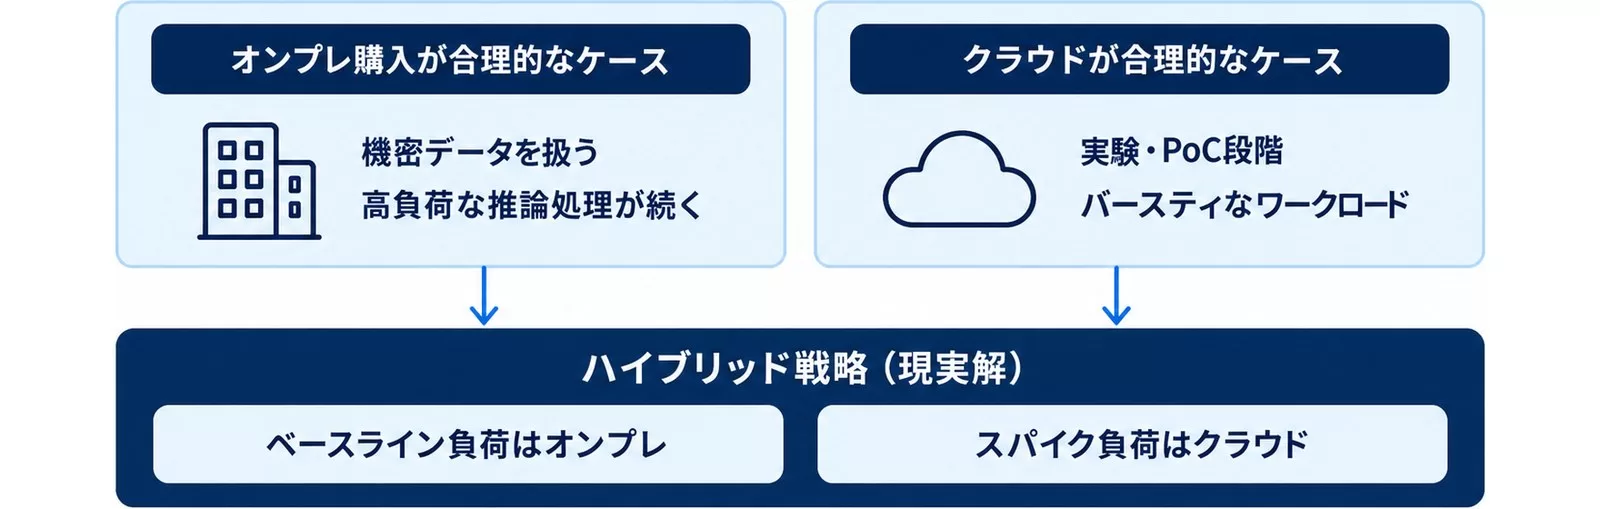
オンプレ購入が合理的なケース
以下の条件が3つ以上揃う場合、DGX B300の購入は投資対効果が出やすいです:
- 月次クラウドGPUコストが$30,000(約480万円)を超えている(B300オンデマンド中央値$7.85なら、8GPUを月480時間使うと約$30,000に達します)
- 社外に出せない機密データを扱うAIシステムを運用する(医療・金融・製造秘密)
- 24時間365日、高負荷な推論処理が続く
- GPUを3年以上使い続ける計画がある
- インフラ運用チームがすでに存在する
クラウドが合理的なケース
- 推論需要がまだ実験・PoC段階
- ピーク・オフピークの差が3倍以上あるバースティなワークロード
- AIシステムのモデルや構成が頻繁に変わる(スタートアップ・研究開発)
- インフラ管理の人的リソースがない
ハイブリッド戦略(現実解)
多くの日本企業が実際に採用しているのは「ハイブリッド戦略」です:
ベースライン負荷(常に発生する推論処理)→ オンプレDGX B300
スパイク負荷(需要ピーク時)→ クラウドB300インスタンスで自動バースト
機密データ処理 → オンプレ固定
R&D・実験 → クラウドの小型インスタンス
NVIDIAはGB300 NVL72の公式ページで「Available Now(現在利用可能)」、DGX B300で「Shipping Now」としていますが、大規模ラックシステムは納期3〜6ヶ月が通常です。DGX B300もリードタイムは短縮傾向にあるものの、2026年8月時点でもBlackwell系の需要集中で数ヶ月待ちになるケースがあります。NTTデータとNVIDIAのAIファクトリー構想のように国内SIerがGB系ラックを保有して提供する形も出てきており、「買う」以外に「国内SIerの設備を借りる」選択肢も検討に値します。
AIエージェントを活用した業務自動化の具体的な導入方法については、AIエージェント導入完全ガイドも参考にしてください。
B300のAI推論性能 ー 技術的な背景
B300がAI推論に強い理由は、スペックだけでなくアーキテクチャ設計に起因します。
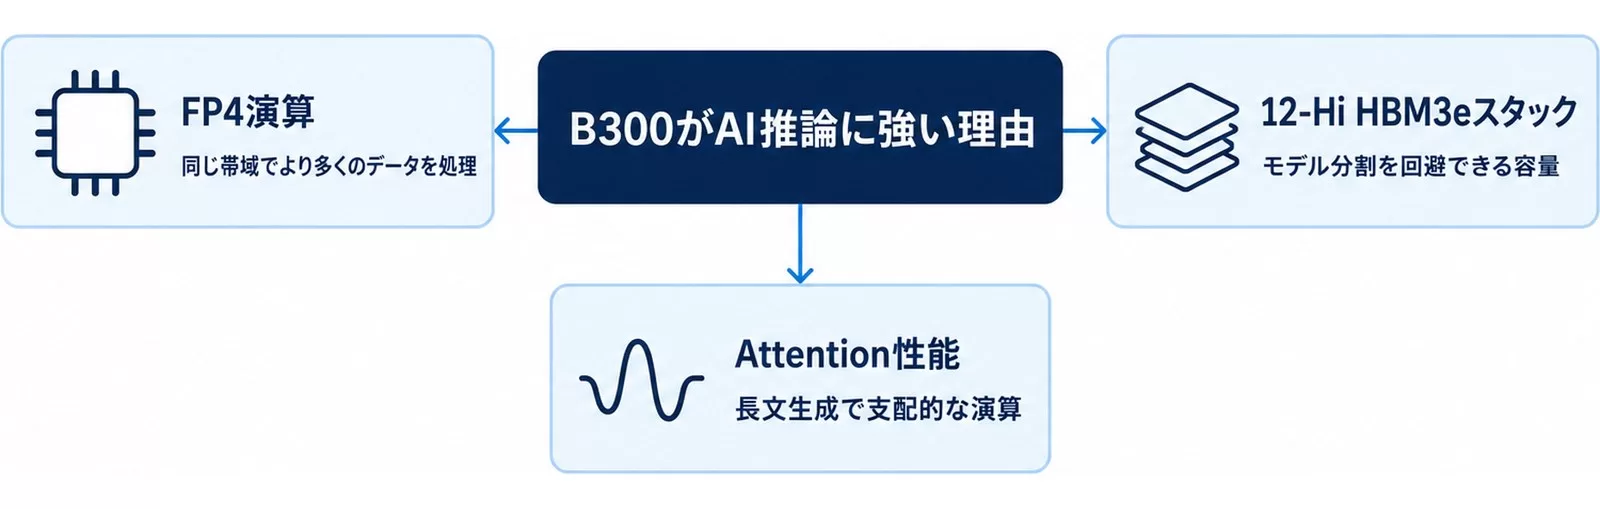
FP4演算の意味
FP4とは4ビット浮動小数点演算のことです。FP16(16ビット)やBF16と比べてデータサイズが1/4のため、同じ帯域でより多くのデータを処理できます。ただし精度が下がるため、モデルの量子化(Quantization)技術と組み合わせることが前提です。
B300のFP4 dense: 15 PFLOPSは、B200の約9 PFLOPSから1.5倍以上の向上です(dense = sparsityなしの実効値)。これは単純な演算速度だけでなく、メモリ帯域効率の改善も含んでいます。
12-Hi HBM3eスタックの実用的意味
従来のHBM3eは8枚のDRAMを縦に積んだ8-Hi構造でした。B300では12-Hi構造にすることで288GBを実現しています。帯域は8 TB/sと変わりませんが、「容量は増えたが帯域は同じ」という点は設計上の意図的なトレードオフです。
推論処理のボトルネックは多くの場合「メモリ帯域」ではなく「メモリ容量」です。大型モデルをロードするための容量が不足すると、モデルをGPU間で分割する必要が生まれ、通信レイテンシが発生します。288GBの広大な容量は、この分割を回避させます。
B300の消費電力と電源・冷却要件
報道ベースの仕様ではB300単体のTDPは1,400W(B200の1,000Wから400W増)、NVIDIA公式ではDGX B300(8GPU)が約14kW、GB300 NVL72はフル液冷ラックとされています。GB300 NVL72のラック単位の消費電力は、NVIDIA公式では2026年8月時点で公表値を確認できていません。実務上の目安は次のとおりです。
- DGX B300 1台: 約14kW=一般的なオフィスビルの1ラック上限(3〜6kW)を大きく超え、高容量の専用回路とラック冷却が前提
- DGX Station GB300: デスクサイド機のため、大規模な電源工事なしで導入しやすい唯一のB300クラス
- GB300 NVL72: 液冷設備(CDU・冷却水配管)が必須。空冷ラックには設置できず、液冷対応コロケーションか新設が必要
Attention Performance(2x vs DGX B200)
NVIDIAの公式発表で「DGX B200比2倍のattention performance」と明示されています。Attentionはトランスフォーマーモデルの中核演算であり、特にReasoningモデルの長文生成で支配的なワークロードです。
GPT-4クラス以上・最新のClaude系モデルで複雑な思考連鎖(CoT)を生成するユースケースでは、このattention改善が直接的なレイテンシ短縮につながります。
Vera Rubin(次世代)との関係 ー 今買うべき?待つべき?
【2026年8月更新】Vera Rubinは2026年6月1日のCOMPUTEX(GTC Taipei)基調講演で量産(フル生産)入りが発表され、2026年下半期からクラウド・パートナー各社への展開が始まる見込みです。公表値は288GBのHBM4(帯域22TB/s)・NVFP4推論50PFLOPS。B300は引き続き現行世代の主力GPUで、以下の「待つべきか」の判断枠組み自体は変わりませんが、2026年末以降の導入計画ならRubinの実提供状況を含めた再評価をおすすめします。
GTC 2026では、B300の次の世代となるVera Rubin(VR200)も発表されました。NVIDIA公式のVera Rubin NVL72ページ(暫定仕様)では、Rubin GPU1基あたり288GBのHBM4・帯域22TB/s・NVFP4推論50 PFLOPS、ラック(72GPU)では20.7TB HBM4・NVFP4 3,600 PFLOPSとされ、B300比で約3.3倍のFP4演算性能です。出荷時期はNVIDIA Newsroomの2026年5月31日(米国時間)発表で「量産出荷は2026年秋(this fall)から」と明記され、旧版の「2026年後半〜2027年前半」より前倒しで確定しました。
一方で報道では、Rubin Ultra世代のKyberラックは製造上の課題で2028年へ後ろ倒しになったとされます(CNBC 2026年7月)。つまり2026年8月時点は、今すぐ買えるのがB300世代、2026年秋以降に順次届くのがVera Rubin、その次は2028年という3段構えです。Vera Rubinの仕様・価格・Blackwellとの違いはNVIDIA Vera Rubinの価格|いつ発売?で詳しく整理しています。
「Vera Rubinまで待つべきか?」という質問には明確な答えがあります:
- 今すぐ推論需要がある → B300で進める: 待てる余裕があれば別ですが、競合がB300でAIを動かしている間に待ち続けるコストのほうが大きい
- 2026年末以降に導入計画 → Vera Rubinを含めて再評価: 2026年秋の量産出荷開始後、実提供リージョンと価格が見えてから判断しても遅くない
- クラウドでテスト → B300でベンチマーク取得: Vera Rubinが出ても、B300クラウドは価格が下がって使いやすくなるだけ
【要注意】B300導入・検討でよくある失敗パターン
失敗1: FP4 PFLOPSだけで比較する
❌ 「B300は15 PFLOPS、H100より何倍も速いはずだから全部置き換える」
⭕ アプリケーションの精度要件・量子化対応状況を先に確認する
FP4演算が生きるのは、モデルをFP4に量子化できる場合のみです。一部の医療・金融系モデルはFP16以上の精度を必要とし、FP4演算の恩恵を受けられません。モデルの量子化戦略を先に検討してから、ハードウェアスペックを評価する順序が重要です。
失敗2: 電力インフラを後回しにする
❌ 「DGX B300を発注してから電源工事の話を始める」
⭕ 発注前に電力・冷却・ラックスペースの調達を確定させる
DGX B300は約14kWの電力を消費します。一般的なオフィスビルのサーバールームでは、電源工事・冷却設備増強に3〜6ヶ月かかるケースがあります。ハードウェアが届いてから初めてインフラ問題が発覚すると、数ヶ月間の稼働遅延につながります。
失敗3: サポート・保守契約を見落とす
❌ 「ハードウェア価格だけで総コストを計算する」
⭕ NVIDIAエンタープライズサポート・保守契約・運用人件費を含めてTCO計算する
DGX B300の約$300,000〜$350,000はハードウェア価格の目安です。3年間のエンタープライズサポート、運用要員のコスト、電力コスト(14kW×24時間×365日は年間約12万kWh)を加えると、総保有コスト(TCO)はハードウェア価格の1.5〜2倍になるケースが多いです。クラウドとの比較はTCOで行うことが必須です。
失敗4: NVLinkトポロジを考慮せずに購入する
❌ 「8GPUあればモデルを分割して並列化できるはず」
⭕ GB300 NVL72のNVLink全接続構成と、DGX B300のSXM構成の違いを理解する
DGX B300の8GPUはNVLink SXMで接続されており、14.4 TB/sの高帯域通信が可能です。ただしGB300 NVL72の72GPU全接続(130 TB/s)とは異なり、GPU間距離・スイッチホップ数が増えます。超大型モデル(数兆パラメータ)の並列訓練を行う場合、NVL72が必要なことがあります。
B300の価格・発売日に関するよくある質問(FAQ)
Q1. NVIDIA B300の価格はいくらですか?
NVIDIA公式の定価は2026年8月時点で公表されていません。相場は、DGX B300(8GPU)が報道・販売パートナー情報で約$300,000〜$350,000(約4,800万円〜5,600万円)、DGX Station GB300が報道で約$85,000〜$125,000、GB300 NVL72は完全見積制です。クラウドなら単GPUあたり中央値$7.85/時間(2026年8月29日時点)で時間貸しできます。
Q2. B300の発売日はいつで、今すぐ買えますか?
2025年3月のGTC 2025で発表され、報道では2026年1月から量産出荷が本格化しました。DGX B300はNVIDIA公式ページで「Shipping Now」、GB300 NVL72は「Available Now」、DGX Station GB300は報道で2026年6月から出荷中です。ただし需要集中でリードタイムは数週間〜数ヶ月あるため、国内パートナーへ早めに見積・納期確認をするのが現実的です。
Q3. B300の消費電力はどれくらいで、B200と何が違いますか?
報道ベースの仕様でB300単体のTDPは1,400W(B200は1,000W)、NVIDIA公式でDGX B300は約14kWです。B200との違いはメモリ容量(192GB→288GB)とFP4演算性能(9→15 PFLOPS dense)で、メモリ帯域(8TB/s)とNVLink(1.8TB/s)は同じです。「より大きいモデルを1枚で持てる」ことがB300の本質で、電源容量が1.4倍必要になる点は導入前に必ず確認してください。
まとめ:B300時代のAIインフラ戦略 ー 今日から始める3つのアクション
Blackwell Ultra B300は、AI推論(Reasoning)時代の到来に合わせて設計された、288GB HBM3e・8TB/s・15 PFLOPS FP4を備えた現行世代で最高密度のAI GPUです。DGX B300(報道・販売パートナー情報で約$300,000〜$350,000)はエンタープライズの標準システム、DGX Station GB300(約$85,000〜$125,000)はデスクサイドの入口、GB300 NVL72は大規模AIファクトリーの選択肢として位置づけられています。NVIDIA公式定価はいずれも非公開で、2026年8月時点の相場は本記事の価格早見表のとおりです。
日本企業がとるべきアクション:
- 今日やること: 現在のGPUワークロードのメモリ利用率を計測する(nvidia-smiまたはクラウドメトリクス)。70%超ならB300が有効な投資先になる可能性が高い
- 今週中: B300のオンデマンドクラウド(中央値$7.85/GPU/時間)で小規模テストを実施し、現行H100/B200比でのlatency・throughputを計測。ROI計算の材料を集める
- 今月中: オンプレ購入・クラウドバースト・ハイブリッドの3シナリオでTCO比較表を作成し、「◯月◯日時点・1ドル◯円換算」を添えて意思決定者に提示する
B300は確かに強力なハードウェアですが、「最新のGPUを買うこと」が目的になってはいけません。自社のAI推論需要・セキュリティ要件・コスト構造を踏まえた上で、最適な調達戦略を選択することが重要です。
AIインフラ投資をどう経営判断に組み込むかについては、AI導入戦略完全ガイドも参考にしてください。また、半導体競争の構図についてはAnthropicのTPU 3.5GW戦略|3社連合の全貌もあわせてご覧ください。
参考・出典
- NVIDIA Blackwell Ultra AI Factory Platform Paves Way for Age of AI Reasoning — NVIDIA Newsroom(参照日: 2026-08-30)
- NVIDIA DGX B300 — nvidia.com(参照日: 2026-08-30)
- NVIDIA GB300 NVL72 — nvidia.com(参照日: 2026-08-30)
- NVIDIA HGX Platform — nvidia.com(参照日: 2026-08-30)
- NVIDIA DGX Station — nvidia.com(参照日: 2026-08-30)
- NVIDIA Vera Rubin NVL72 — nvidia.com(参照日: 2026-08-30)
- NVIDIA Vera Rubin Ramps Into Full Production — NVIDIA Newsroom(参照日: 2026-08-30)
- NVIDIA Announces Financial Results for Second Quarter Fiscal 2027 — NVIDIA Investor Relations(参照日: 2026-08-30)
- B300 Cloud Pricing(28社比較・2026) — getdeploying.com(2026-08-29更新・参照日: 2026-08-30)
- Nvidia’s GB300-powered DGX Station desktop tower listed for nearly $100,000 online — Tom’s Hardware(参照日: 2026-08-30)
- MSI launches $85,000 XpertStation WS300 with Nvidia GB300 Ultra — TechRadar(参照日: 2026-08-30)
- NVIDIA DGX B300 Price — GPUSmith(参照日: 2026-08-30)
- NVIDIA B300とは?B200との違い・価格・出荷時期 — GPUSOROBAN(参照日: 2026-08-30)
- DGX Station GB300 pre-orders open, shipping June 2026 — AIhola(参照日: 2026-08-30)
- DGX Station GB300 vs Custom GPU Server 2026 — VRLA Tech(参照日: 2026-08-30)
- NVIDIA GB300 “Blackwell Ultra” Will Feature 288 GB HBM3E Memory, 1400 W TDP — TechPowerUp(参照日: 2026-08-30)
- Nvidia’s Kyber rack system delays — CNBC(参照日: 2026-08-30)
- NVIDIA DGX B300|HPCシステムズ — hpc.co.jp(参照日: 2026-08-30)
- Nvidia announces Blackwell Ultra and Vera Rubin AI chips — CNBC(参照日: 2026-08-30)
- USD/JPY 参照レート 159.68円(2026-08-28・ECB) — Frankfurter(参照日: 2026-08-30)
著者: 佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。早稲田大学法学部在学中に生成AIの可能性に魅了され、X(@SuguruKun_ai)フォロワー約10万人。100社以上の企業向けAI研修・導入支援を展開。著書『AIエージェント仕事術』(SBクリエイティブ)。SoftBank IT連載7回執筆(NewsPicks最大1,125ピックス)。
ご質問・ご相談はお問い合わせフォームからお気軽にどうぞ。
この記事の内容を社内展開する方へ: AI研修導入40項目チェックリスト(無料・PDF 35ページ) をダウンロードできます。
AI研修・AI顧問、まず30分の壁打ちから
研修4,000名以上・支援100社以上。研修は助成金の対象可否まで、顧問は月次伴走の中身まで、貴社の場合で具体的にお答えします。
- 100社以上・研修4,000名以上の実績
- 初回30分無料・即日返信
お問い合わせフォームから24時間以内にUravation担当者がご返信します。