最終更新日:2026年9月6日(時点表記を9月時点へ更新。2026年8月26日の決算発表以降、NVIDIA公式ニュースルームにVera Rubinの出荷状況・価格に関する新しい発表は確認できていません)
結論: NVIDIA Vera Rubinは2026年8月26日の決算発表で「フル生産中・パートナー各社でラック稼働中」と公式に示され、当初予定の「2026年秋」より前倒しで立ち上がっています。2026年8月26日の決算発表でNVIDIAは、これまでで最も速いペースの立ち上がりになる見通しだと説明しており、2026年8月〜10月期のデータセンター売上のうち約20%(金額換算で約200億ドル規模)をVera Rubinが占める見通しです。価格はNVIDIA公式の定価が2026年9月時点でも非公開のため断定はできませんが、報道ベースでは72基のRubin GPUを積む「VR200 NVL72」ラックが500万〜910万ドル(約8億円〜約14.5億円、$1=¥159.68換算)という数字が出ています。Blackwellと比較して推論トークンコストが最大10倍削減、MoEモデルの訓練に必要なGPU数が4分の1になる次世代AIインフラです。
この記事の要点:
- 2026年8月26日の決算発表で「フル生産中・パートナー各社でラック稼働中」と公式説明(5月時点の「2026年秋に出荷開始」計画から前倒しで立ち上がり)。2026年第4四半期にかけて出荷量が本格的に立ち上がる見通し
- 7チップ構成: Vera CPU・Rubin GPU・NVLink 6を含む6チップに、3月16日追加のGroq 3 LPU(低遅延推論アクセラレータ)を加えた計7チップ
- 価格はNVIDIA公式非公開。報道ベースでVR200 NVL72ラックが500万〜910万ドル、Rubin GPU単体は約5万5,000ドルという数字が出ている
- Blackwell比で推論スループット最大10倍/ワット・MoE訓練GPU数を4分の1に削減
- AWS・Google Cloud・Microsoft Azure・OCI・CoreWeaveなど主要クラウド各社が2026年下半期に展開予定
対象読者: AIインフラへの投資を検討している企業の情報システム部門・経営企画担当者
読了後にできること: Vera Rubinの出荷時期・価格相場とBlackwellとの違いを理解し、自社のAIクラウド戦略を見直すための判断軸を得られる
「GPUって毎年新しいのが出るけど、今回のはどう違うの?」
AI研修で企業のIT部門から何度もこの質問を受けてきました。確かにNVIDIAはここ数年で急速に世代交代を繰り返しており、Ampere→Hopper→Blackwell→Vera Rubinとプラットフォームが変わるたびに「今度こそ意味が変わる」という話が出ます。
ただ、Vera Rubinは少し違います。推論コストの「10倍削減」「MoE訓練GPU数4分の1」という数字が、AI業務活用のコスト構造を根本から変える可能性を持っているからです。しかも2026年8月26日の決算発表で「フル生産中でパートナー各社のラックが稼働中」と公式に示されたことで、「いつ」「いくらで」使えるようになるのかという問いに、ようやく具体的な数字で答えられる段階に入りました。
この記事では、Vera Rubinの出荷状況・価格相場・技術仕様とBlackwellとの比較、主要クラウドパートナーの展開状況、そして日本企業のAIインフラ戦略に対する影響を解説します(2026年9月時点の最新情報に更新)。
Vera Rubinの発表経緯: CES 2026から GTC 2026へ
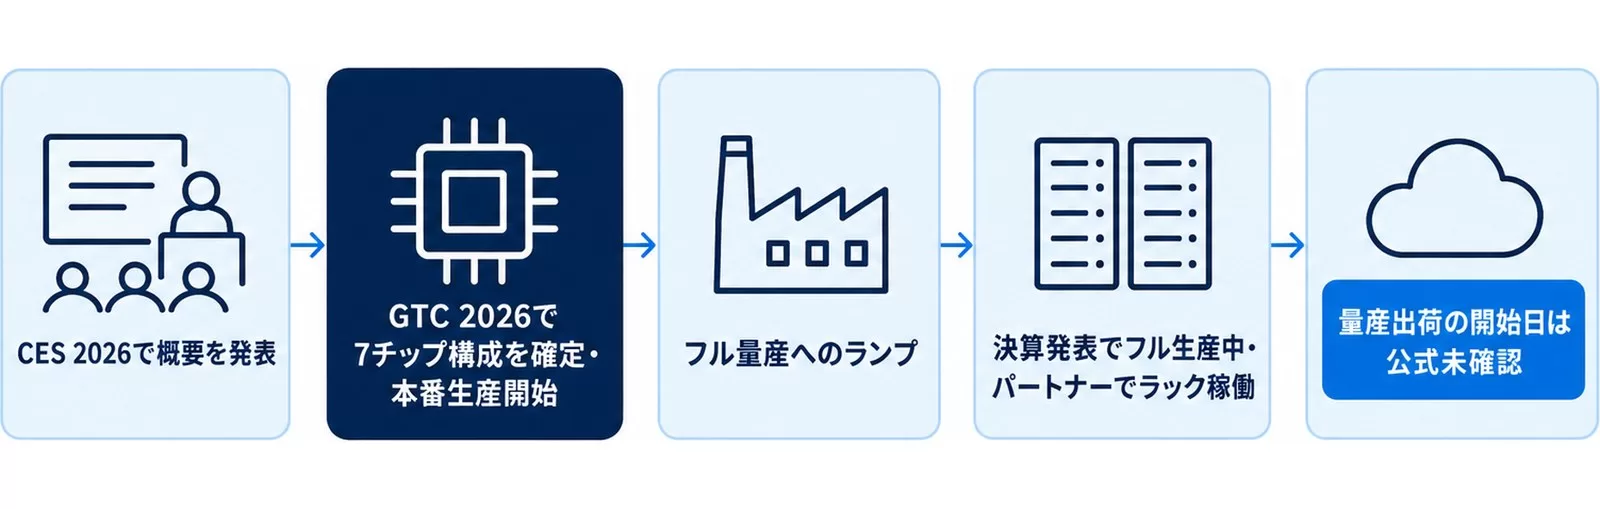
Vera Rubinは2026年1月のCES(Consumer Electronics Show)でNVIDIA CEOのJensen Huangが最初に発表しました。この時点では「次世代プラットフォームの概要」という位置づけでした。
その後、2026年3月16日〜19日のGTC(GPU Technology Conference)2026でJensen Huangが3万人以上の参加者に向けて詳細を発表し、「7チップが本番生産を開始した」と宣言しました。
GTC 2026速報記事(2026年3月公開)でも触れていますが、本記事ではその後の展開状況・クラウドパートナーの詳細・MoE訓練の具体的なインパクトについてアップデートを加えて解説します。
NVIDIAが「Vera Rubin」と命名したのは、20世紀の天文学者Vera Rubinへのオマージュです。彼女は暗黒物質の存在を観測で初めて示した科学者で、「見えないものを計測する」研究姿勢がAI推論の効率化というテーマと重なります。
Vera Rubinはいつ発売される?2026年9月時点の最新状況
「nvidia rubin いつ」で検索する方が最も知りたいのはここだと思うので、時系列で整理します。
| 時期 | 出来事 | ソース |
|---|---|---|
| 2026年1月 | CES 2026でプラットフォーム概要を発表 | NVIDIA公式 |
| 2026年3月16日 | GTC 2026で7チップ構成を確定、本番生産開始を宣言 | NVIDIA公式 |
| 2026年5月31日 | 「フル量産へのランプ」を発表。この時点では「出荷開始は2026年秋(this fall)」という計画だった | NVIDIA Newsroom公式プレスリリース |
| 2026年8月26日 | 決算発表で「フル生産中、CoreWeave・Google Cloud・Microsoft Azure・OCI・Nebiusでラック稼働中」と公式説明。5月時点の「秋に出荷開始」計画より前倒し(量産出荷の開始日そのものは2026年9月時点でも公式に確認できていない) | NVIDIA 2026年8月26日決算発表(2027年度第2四半期) |
| 2026年8月〜10月期 | データセンター売上の約20%(約200億ドル規模)をVera Rubinが占める見通し | 同上(次四半期ガイダンス) |
| 2026年第4四半期〜2027年上半期 | 出荷量の本格的な立ち上がり(volume ramp) | 報道(Tom’s Hardware等) |
結論から言うと、Vera Rubinは「もう出荷が始まっている」段階です。2026年5月末時点でNVIDIAは「出荷開始は秋」と発表していましたが、2026年8月26日の決算発表では、Vera Rubinの生産出荷が同月(2026年8月)にすでに始まっており、NVIDIA史上最も速いペースの立ち上がりになる見通しだという趣旨の説明がありました。
最初に出荷が始まるのはAWS・Google Cloud・Microsoft Azure・OCIの4大ハイパースケーラーと、CoreWeave・Lambda・Nebius・Nscaleの計8社です。Dell・HPE・Lenovo・SupermicroなどのOEM経由での一般提供は2026年下半期を予定しています。
つまり日本企業が「自社のAWS/GCP/Azure環境でVera Rubinベースのインスタンスを使える」ようになるのは、早くても2026年第4四半期以降、本格的な選択肢として現実的になるのは2027年に入ってから、というのが現時点の見立てです。
Vera Rubinの価格はいくら?2026年9月時点で分かっている相場
「vera rubin 価格」「nvidia rubin 価格」で検索する方向けに結論から書くと、NVIDIA公式の定価は2026年9月時点でも公表されていません。B300(Blackwell Ultra)と同様、Vera Rubinもハイパースケーラー向けの大口契約が中心で、個別見積りが基本になります。ただし報道ベースでは相場観が出てきています。
| 項目 | 報道されている価格帯 | 円換算目安($1=¥159.68) | 注記 |
|---|---|---|---|
| Rubin GPU単体 | 約55,000ドル | 約880万円 | ハイパースケーラー向け大口価格の報道ベース。単体販売はなし |
| Vera CPU単体 | 約5,000ドル | 約80万円 | 同上 |
| VR200 NVL72ラック(72GPU構成) | 500万〜910万ドル | 約8億円〜約14.5億円 | 報道により幅あり。当初は500万〜780万ドル台という見方が多かったが、メモリ価格高騰で880万〜910万ドルとする直近の報道もある |
価格が上振れしている主因はメモリです。報道によると、HBM4などメモリのコストがラック総コストの約25%を占めるまで上昇しています。「Vera Rubinで推論コストが10分の1になる」という数字だけを見ると割安に感じますが、初期導入コスト自体はBlackwell世代よりも上がっている点は押さえておく必要があります。
LLM APIの料金相場を横断的に比較したい方は、主要AIモデルのAPI料金比較記事もあわせてご確認ください。
Blackwell Ultra(B300)との価格差は?(3行で)
①世代・設計思想: BlackwellはHopperの延長線上の設計、Vera RubinはCPU・GPU・ネットワークを含む7チップを丸ごと設計し直した新世代です。
②入手性: B300は2026年前半から「Shipping Now(出荷中)」の状態が続いていますが、Vera Rubinは2026年9月時点でもパートナー各社への納入・稼働が始まったばかりです。
③価格帯: B300のDGXサーバーは報道で約30万〜35万ドル(約4,800万〜5,600万円)。Vera RubinのNVL72ラックは同じく報道で500万〜910万ドルで、構成規模が異なるため単純比較はできません。
B300の価格相場・出荷状況の詳細はNVIDIA B300の価格|DGX B300・GB300相場【2026年9月】で解説しています。
Vera Rubinの7チップ構成: 何がどう変わったか
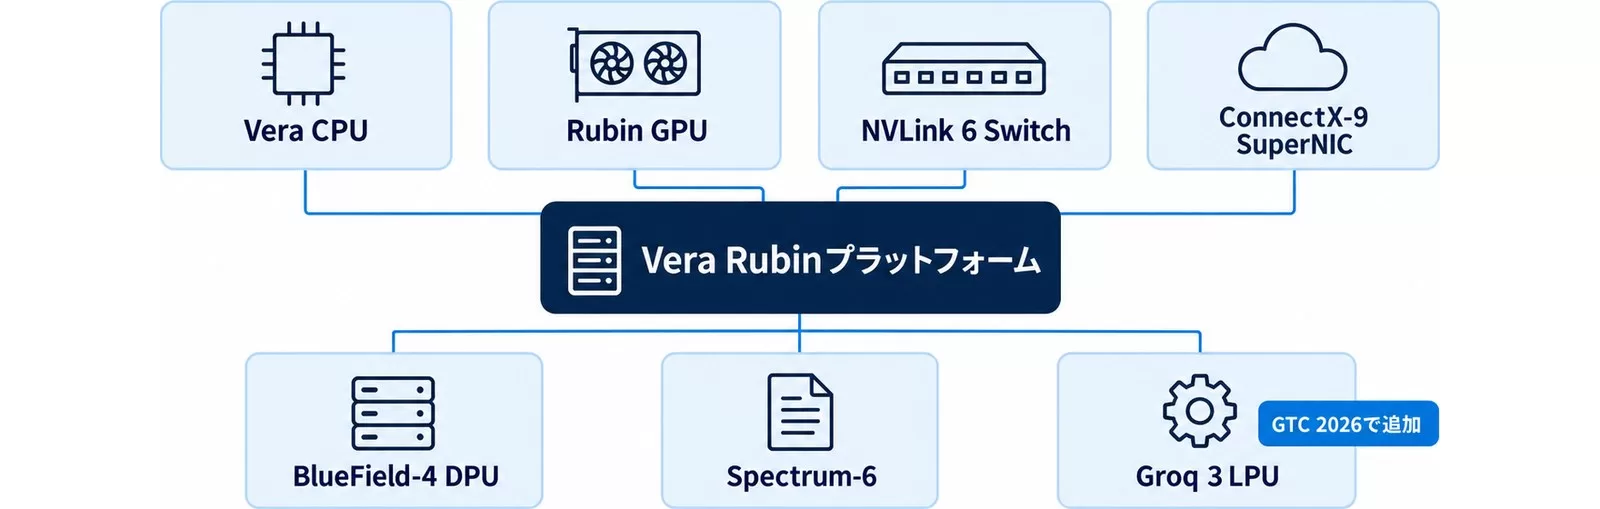
Vera Rubinプラットフォームは以下の7チップで構成されます。6チップはCES 2026時点での発表で、Groq 3 LPUはGTC 2026(3月16日)に追加されました。
| チップ | 役割 | 主な変更点(vs Blackwell) |
|---|---|---|
| NVIDIA Vera CPU | ホストプロセッサ | 88コアのカスタムOlympusコア、Armv9.2互換 |
| NVIDIA Rubin GPU | 主力AI演算 | 336億トランジスタ・デュアルダイ・HBM4・第5世代Tensor Core・第3世代Transformer Engine |
| NVIDIA NVLink 6 Switch | GPU間高速接続 | 3.6TB/s 双方向帯域(GPU1基あたり) |
| NVIDIA ConnectX-9 SuperNIC | ネットワーク | 次世代NIC |
| NVIDIA BlueField-4 DPU | データ処理 | データセンターオフロード専用 |
| NVIDIA Spectrum-6 Ethernet Switch | データセンターネットワーク | ラックスケール対応 |
| NVIDIA Groq 3 LPU(3月16日追加) | 低遅延推論専用 | 256 LPUプロセッサ・128GB オンチップSRAM、35x推論スループット/メガワット |
AI導入戦略の全体像については、AI導入戦略完全ガイドで解説しています。Vera Rubinがインフラ層でどのような位置づけになるかも合わせて読んでみてください。
核心の数字: Blackwell比で何がどう変わるか
Vera Rubinの性能を理解するうえで、Blackwellとの比較は欠かせません。NVIDIA B300の価格|DGX B300・GB300相場【2026年9月】でも触れましたが、VeRa RubinはBlackwellの「後継」ではなく「別設計思想の世代」として位置づけられます。
| 指標 | Blackwell | Vera Rubin | 改善率 |
|---|---|---|---|
| 推論スループット/ワット | 基準 | 最大10倍 | +900% |
| MoEモデル訓練GPU数 | 基準 | 4分の1 | -75% |
| HBM帯域幅(GPU1基) | 8TB/s | 22TB/s(最大) | +175% |
| NVLink帯域幅(GPU1基) | 1.8TB/s | 3.6TB/s | +100% |
| NVL72ラックコンピュート | — | 260TB/s | ラックスケール強化 |
「推論スループット10倍/ワット」という数字が意味することを実務的に解釈すると:
- 同じコストで10倍のAPIリクエストを処理できる(逆に言えば、同じ処理量なら電気代が10分の1になる可能性がある)
- 大規模言語モデルのAPIコストが価格競争によってさらに下がる圧力がかかる
- オンプレミスやプライベートクラウドでのLLM運用コストが下がり、クラウドAPI利用と自社運用のコスト差が縮まる
MoEモデルのGPU数「4分の1」は訓練フェーズの話ですが、これが意味するのは「Claude 4やGPT-5世代のような大規模MoEモデルをより少ないGPUで訓練できる」ということです。AI企業の訓練コストが下がれば、それがAPIの価格競争に波及する可能性があります。
この記事の内容、自社の業務でも回したい?
AI顧問(月次伴走)が、貴社の業務に合わせて導入から定着まで並走します。研修4,000名以上・支援100社以上の実績。まずは30分の壁打ちから。
Groq 3 LPUが加わった理由: 低遅延推論の需要
2026年3月16日に「7チップ目」として追加されたGroq 3 LPU(Low-latency Processing Unit)は、従来のGPUアーキテクチャとは異なる設計思想を持ちます。
LPU(LPXとも表記)の特徴:
- 256個のLPUプロセッサを搭載した1ラック構成
- 128GBのオンチップSRAM(メインメモリが大容量キャッシュとして機能)
- 推論スループット/メガワットがRubin GPUの35倍
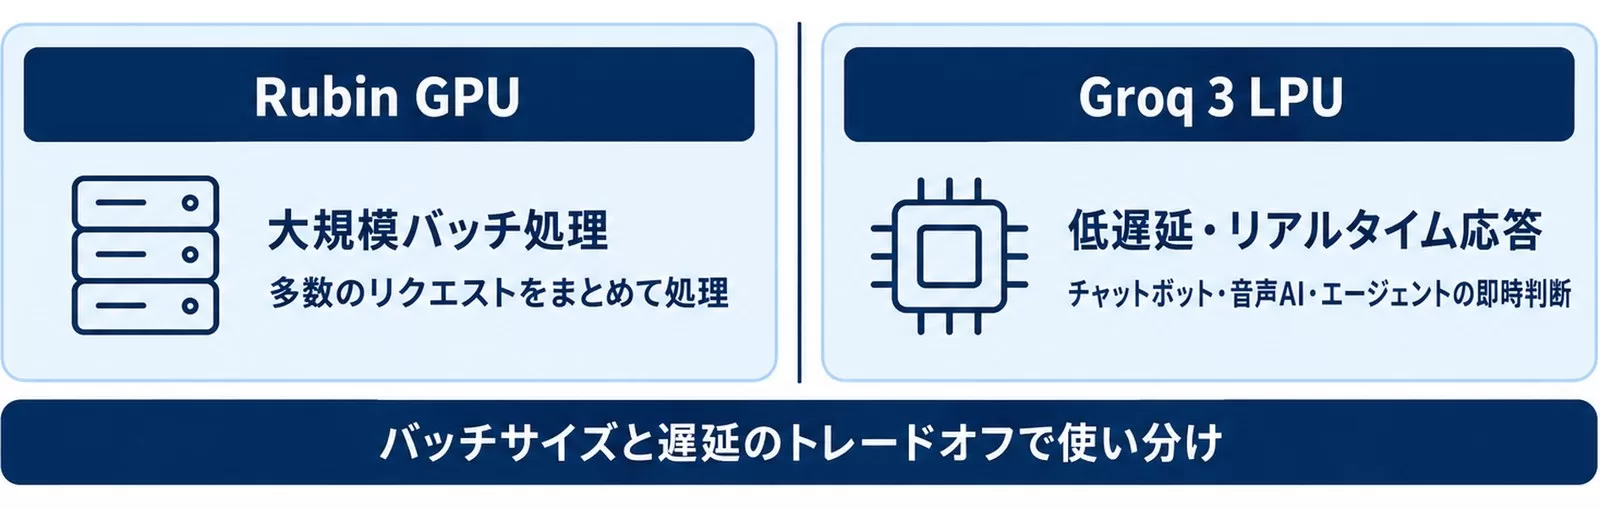
GPUとLPUの使い分けのポイントは「バッチサイズと遅延のトレードオフ」です。大規模バッチ処理(多数のリクエストをまとめて処理)にはRubin GPUが、低遅延・リアルタイム応答(チャットボット、音声AI、エージェントの即時判断)にはGroq 3 LPUが向いています。
AIエージェントの普及が加速するなか、「ユーザーが入力して数百ミリ秒以内に応答する」という低遅延要件が増えています。Groq 3 LPUはその需要に対応するための追加という位置づけです。
Rubin CPX・Rubin Ultra(NVL576)の位置づけ整理
Vera Rubin関連では「Rubin CPX」「Rubin Ultra」という名称も出てきますが、それぞれ発表時期・位置づけが異なるため整理します。
Rubin CPX(2025年9月発表)
Rubin CPXは2025年9月9日にNVIDIAが発表した、長文脈推論(100万トークン級のコーディング・動画生成など)に特化したGPUです。単体で30 PFLOPS(NVFP4)・128GB GDDR7メモリを搭載し、Rubin GPUと組み合わせた「Vera Rubin NVL144 CPX」というラック構成では、8エクサFLOPSのAI性能・100TBの高速メモリを実現するとされています(GB300 NVL72比で最大7.5倍の性能)。「NVL144」という数字はこのRubin CPX組み合わせラックの呼称です。
ただし、2026年3月のGTC 2026でNVIDIAが公式発表した最新の「Vera Rubin POD」構成(7チップ・5つのラックスケールシステム)では、Rubin CPX・NVL144 CPXは含まれていません。低遅延・長文脈の推論という役割は、代わりにGroq 3 LPXが担う設計として整理されているように見えます。Rubin CPX(NVL144 CPX)が今後も独立製品として展開されるかどうかは、2026年9月時点でもNVIDIA公式に確認できていません。
Rubin Ultra(NVL576、2027年後半予定)
Rubin Ultra(開発コード名「Kyber」、NVL576ラック)は、NVIDIAがロードマップとして公開している次々世代のプラットフォームです。1ラックに最大576GPU、HBM4eメモリ1TB、推論性能15エクサFLOPS(FP4)・訓練性能5エクサFLOPS(FP8)という仕様が示されており、NVL72比で最大14倍の性能になるとされています。2026年3月のGTC 2026ではJensen Huang CEOがRubin Ultra世代のハードウェアを展示しましたが、投入時期は2027年後半(H2 2027)の予定です。
2026年9月時点で投資判断の対象にすべきなのは、実際に出荷が始まっている「Rubin GPU + NVL72 + Groq 3 LPU」の主力構成です。Rubin CPXやRubin Ultraは情報が流動的なため、現時点では「今後の選択肢」として押さえておく程度で十分です。
主要クラウドパートナーの展開状況
GTC 2026(3月16日)時点でのVera Rubin展開パートナー(2026年下半期展開予定):
| カテゴリ | 企業 |
|---|---|
| ハイパースケーラー | AWS、Google Cloud、Microsoft Azure、Oracle Cloud Infrastructure(OCI) |
| AIクラウド | CoreWeave、Lambda、Nebius、Nscale |
| その他 | Crusoe、Together AI |
日本企業にとって特に重要なのは、AWS・Google Cloud・Azure・OCIという4大ハイパースケーラーが全て含まれている点です。日本でAIクラウドを利用している企業の多くはこれらいずれかを使っており、追加投資なしにVera Rubinベースのインスタンスが利用できるようになる(2026年下半期以降)見通しです。
2026年9月時点の状況を補足すると、上記パートナー各社への出荷は「予定」から「実際に始まった」段階に進んでいます。ただし各クラウドが日本リージョンでインスタンスを一般提供するタイミングは別問題です。米国リージョンでの先行提供から数ヶ月〜1年程度遅れる可能性がある点は、後述する【要注意】の落とし穴でも触れています。
AnthropicのTPU戦略との対比: GPU路線 vs TPU路線
AnthropicとGoogle・Broadcomのグループが進めるTPU 3.5GW戦略と並べると、米国AI業界の「ハードウェア路線の二極化」が見えてきます。
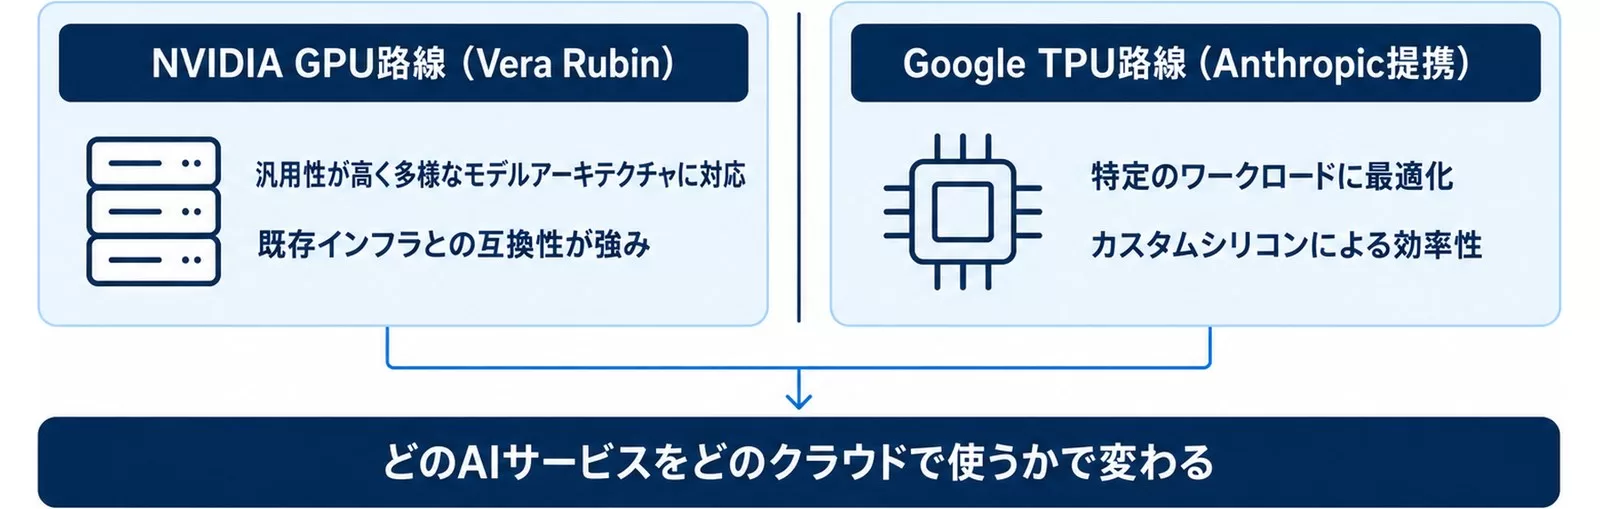
- NVIDIA GPU路線(Vera Rubin): 汎用性が高く、多様なモデルアーキテクチャに対応。AWS・Azure・GCPと組み合わせた既存インフラとの互換性が強み。
- Google TPU路線(Anthropic提携): 特定のワークロード(Google自社モデル、Claude系)に最適化。カスタムシリコンによる効率性。
どちらが「正解」かではなく、企業がどのAIサービスをどのクラウドで使うかによって、実際に動いているハードウェアが変わってきます。API料金に影響を与える要因として把握しておく価値があります。
日本企業のAIインフラ戦略への影響
Vera Rubinが2026年下半期に展開されることで、日本企業のAIインフラ戦略はどう変わるでしょうか。
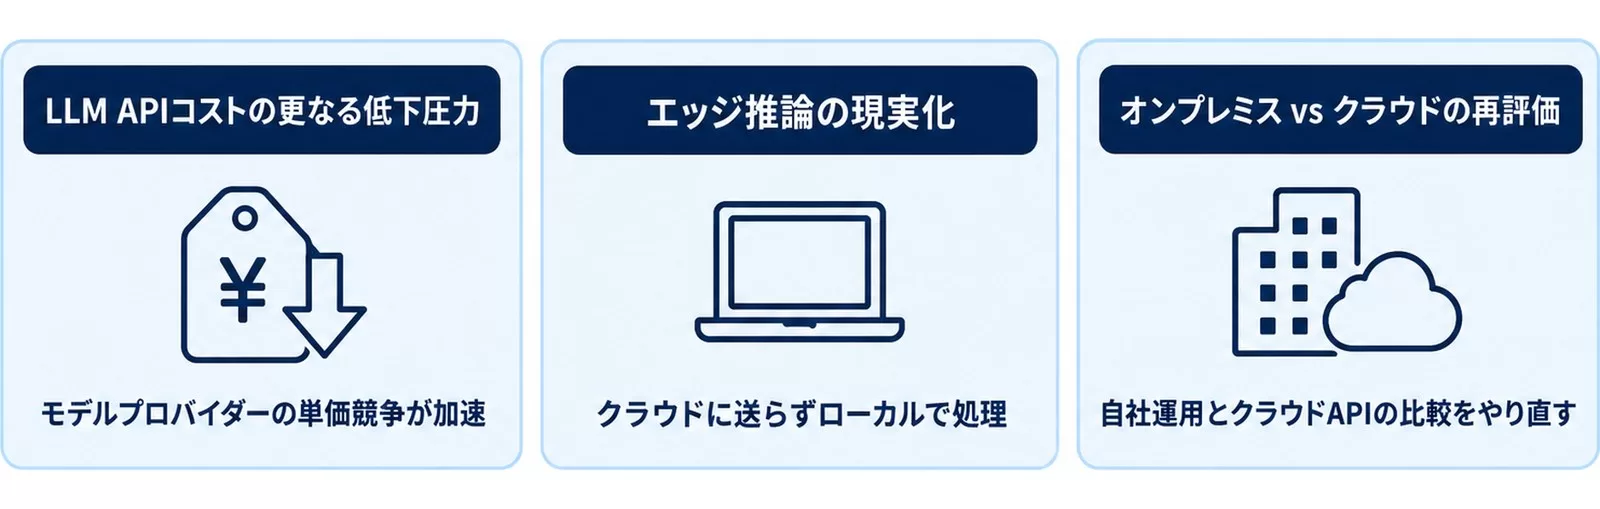
1. LLM APIコストの更なる低下圧力
Vera Rubinで推論コストが10倍効率化されると、OpenAI・Anthropic・Googleなどのモデルプロバイダーの単価競争が加速します。2024年に比べてGPT-4の価格は既に大幅に下がっていますが、Vera Rubin展開後にさらに下がる可能性があります。
「今はAPIコストが高くてAI活用を限定している」という企業にとって、2026年下半期以降のコスト見直しのタイミングは来るでしょう。
2. エッジ推論の現実化
Groq 3 LPUの低遅延特性が普及すると、「クラウドに送らずローカルまたはエッジで推論する」というユースケースが拡大します。医療・金融・製造など、データをクラウドに送れない業界での活用が現実的になります。
3. オンプレミス vs クラウドの再評価
現在、多くの日本企業はAIをクラウドAPIで利用しています。Vera Rubinの効率化により、オンプレミスまたはプライベートクラウドでのLLM運用コストが下がれば、「センシティブデータを社外に出したくない」という企業が自社運用を検討する動きが増えるかもしれません。
【要注意】Vera Rubin情報の読み方の落とし穴
落とし穴1: 「10倍」を全ワークロードに適用して計算する
❌ 「Vera Rubinになったら今のGPUコストが10分の1になる」と計算する
⭕ 「推論スループット/ワット10倍」はワークロードの種類・バッチサイズ・精度設定によって異なるため、特定ワークロードでの実測値を待つ
NVIDIAが発表する性能数値はほぼ全て「ピーク値」または「最適条件」です。実際のAPI処理(様々なリクエストサイズが混在する)では、この数値に近い効率化が実現するとは限りません。
落とし穴2: 「2026年下半期展開」を「すぐ日本で使える」と解釈する
❌ 「2026年夏頃にはAWSで安くなる」と期待して投資計画を立てる
⭕ 「2026年下半期に主要クラウドで展開開始」はあくまで開始時期であり、日本リージョンへの展開や価格競争が起きるまでには時間がかかる可能性がある
新しいGPUインスタンスは米国リージョンで先行展開され、アジア太平洋リージョンへの展開は数ヶ月〜1年程度後になることが多いです。
落とし穴3: CES 2026発表とGTC 2026発表の混同
❌ 「Vera Rubinは2026年1月から本番生産されている」と解釈する
⭕ CES 2026(1月)は概要発表・GTC 2026(3月16日)が本番生産開始宣言と7チップ確定の場
一部の記事でCES 2026が「本番発表」のように書かれていますが、詳細な技術仕様と本番生産開始の宣言はGTC 2026(3月16日)です。情報源の日付に注意が必要です。
落とし穴4: Blackwell B300との世代関係を誤解する
❌ 「Blackwell B300のあとがVera Rubinなので、B300は旧世代になった」と判断する
⭕ B300はBlackwell世代の最上位版として並行展開されており、2026年下半期のVera Rubin展開と競合するわけではない
Blackwell B300はBlackwellアーキテクチャの高密度版として2026年前半に展開中です。NVIDIAはBlackwellとVera Rubinを「異なる世代・異なる用途」として並行展開する可能性があります。
落とし穴5: 報道ベースの価格を「NVIDIA公式価格」と誤認する
❌ 「Vera RubinのNVL72ラックは780万ドル」と、特定の報道の1つの数字を公式価格として社内稟議に使う
⭕ NVIDIA公式の定価は2026年9月時点でも非公開。報道によって500万〜910万ドルと幅があり、実際の契約は個社ごとの見積り・値引き交渉で決まる
特にVera Rubinはメモリ価格の変動が大きく、報道時点によって価格レンジが変わっています。投資計画に使う際は「幅のある相場観」として扱い、実際の調達は必ずクラウド事業者・販売代理店から個別見積りを取ってください。
まとめ: Vera Rubinが示すAIインフラの方向性
Vera Rubinの登場が示す最も重要な方向性は「推論コストの継続的な低下」です。
GTC 2026での発表内容を整理すると:
- 2026年8月26日の決算発表でフル生産・パートナー各社でのラック稼働が公式に示された(5月時点の「秋に出荷開始」計画から前倒し)。NVIDIA公式価格は非公開だが、報道ベースでNVL72ラックは500万〜910万ドル
- Blackwell比で推論スループット/ワット最大10倍・MoE訓練GPU数4分の1
- 7チップ構成(Vera CPU + Rubin GPU + NVLink 6 + ConnectX-9 + BlueField-4 + Spectrum-6 + Groq 3 LPU)が本番生産開始
- AWS・Google Cloud・Azure・OCI・CoreWeaveなど主要クラウドが2026年下半期に展開予定
- Groq 3 LPUは低遅延推論(エージェント・音声AI)に特化した設計で35x推論スループット/メガワット
日本企業にとって「すぐやること」は少ないですが「2026年下半期から2027年にかけてAIクラウドのコスト構造が変わる」という前提で、AIアプリケーションの投資計画を見直す時期がきています。
今日やること: 自社が利用しているクラウド(AWS/GCP/Azure)の「Vera Rubinインスタンス提供」のアナウンスページを確認する(2026年9月時点で出荷は開始済み・自社リージョンでの一般提供時期は個別に要確認)
今週中: 現在のAI API利用コスト(月額)を把握し、Vera Rubin展開後に30〜50%コスト削減できた場合の追加活用シナリオを検討する
今月中: 「2026年下半期のAIコスト低下を見越した業務活用ロードマップ」を経営・IT部門で議論するアジェンダを設定する
よくある質問(FAQ)
Vera Rubinはいつ発売されますか?
2026年1月のCES 2026で概要が発表され、2026年3月16日のGTC 2026で本番生産開始が宣言されました。当初は「2026年秋に出荷開始」という計画でしたが、2026年8月26日の決算発表では「フル生産中で、CoreWeave・Google Cloud・Microsoft Azure・OCI・Nebiusなどのパートナーでラックが稼働中」と説明され、前倒しで立ち上がっています(量産出荷の開始日そのものは2026年9月時点でも公式に確認できていません)。出荷量が本格的に立ち上がるのは2026年第4四半期以降の見通しです。
Vera Rubinの価格はいくらですか?
NVIDIA公式の定価は2026年9月時点でも非公開です。報道ベースでは、72基のRubin GPUを積むNVL72ラックが500万〜910万ドル(約8億円〜約14.5億円)、Rubin GPU単体は約5万5,000ドルという数字が出ています。実際の価格は個社ごとの契約・値引きによって変動します。
Vera RubinはBlackwellと何が違いますか?
Blackwellの延長ではなく、CPU・GPU・ネットワークを含む7チップを新設計したプラットフォームです。推論スループットは最大10倍/ワット、MoE訓練に必要なGPU数は4分の1に削減されます。B300(Blackwell Ultra)は2026年前半から出荷中である一方、Vera Rubinは2026年9月時点でも納入・稼働が始まったばかりという違いもあります。詳しい比較はNVIDIA B300完全ガイドをご覧ください。
参考・出典
- NVIDIA Vera Rubin Opens Agentic AI Frontier — NVIDIA Newsroom(参照日: 2026-05-03)
- Rubin Platform AI Supercomputer — NVIDIA Newsroom(参照日: 2026-05-03)
- Inside the NVIDIA Rubin Platform: Six New Chips, One AI Supercomputer — NVIDIA Developer Blog(参照日: 2026-05-03)
- Nvidia GTC 2026: CEO Jensen Huang sees $1 trillion in orders for Blackwell and Vera Rubin through ’27 — CNBC(参照日: 2026-05-03)
- GTC 2026: Nvidia Unveils Vera Rubin AI Platform, Eyes $1T by 2027 — Data Center Knowledge(参照日: 2026-05-03)
- Vera Rubin Ramps Into Full Production — NVIDIA Newsroom(2026-05-31・参照日: 2026-08-30)
- 2027年度第2四半期決算発表 — NVIDIA Investor Relations(2026-08-26・参照日: 2026-08-30)
- Vera Rubin出荷開始・Q3売上見通し記事 — Tom’s Hardware(参照日: 2026-08-30)
- NVL72ラック価格高騰・メモリコスト記事 — Tom’s Hardware(参照日: 2026-08-30)
- Rubin CPX発表プレスリリース — NVIDIA Newsroom(2025-09-09・参照日: 2026-08-30)
- Vera Rubin POD: Seven Chips, Five Rack-Scale Systems — NVIDIA Developer Blog(2026-03-16・参照日: 2026-08-30)
- Rubin Ultra・Feynmanロードマップ記事 — Tom’s Hardware(参照日: 2026-08-30)
著者: 佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。早稲田大学法学部在学中に生成AIの可能性に魅了され、X(旧Twitter)で活用法を発信(@SuguruKun_ai、フォロワー約10万人)。100社以上の企業向けAI研修・導入支援を展開。著書『AIエージェント仕事術』(SBクリエイティブ)。SoftBank IT連載7回執筆(NewsPicks最大1,125ピックス)。
ご質問・ご相談は お問い合わせフォーム からお気軽にどうぞ。
この記事の内容を社内展開する方へ: AI研修導入40項目チェックリスト(無料・PDF 35ページ) をダウンロードできます。
AI研修・AI顧問、まず30分の壁打ちから
研修4,000名以上・支援100社以上。研修は助成金の対象可否まで、顧問は月次伴走の中身まで、貴社の場合で具体的にお答えします。
- 100社以上・研修4,000名以上の実績
- 初回30分無料・即日返信
お問い合わせフォームから24時間以内にUravation担当者がご返信します。