結論: 2026年9月20日に「Fable 5のthinkingトークンが8月に大きく減った」とする個人の観測が投稿され、翌21日にHacker News一面へ上がりました。ただしAnthropicの公式ドキュメントは「thinkingの量はモデルがリクエストごとに決める」「effortは厳密なトークン予算ではない」と明記しており、外形的な観測だけでは性能低下の証明になりません。判断材料は、自社のログでusage.output_tokens_details.thinking_tokensを数え直すことです。
この記事の要点:
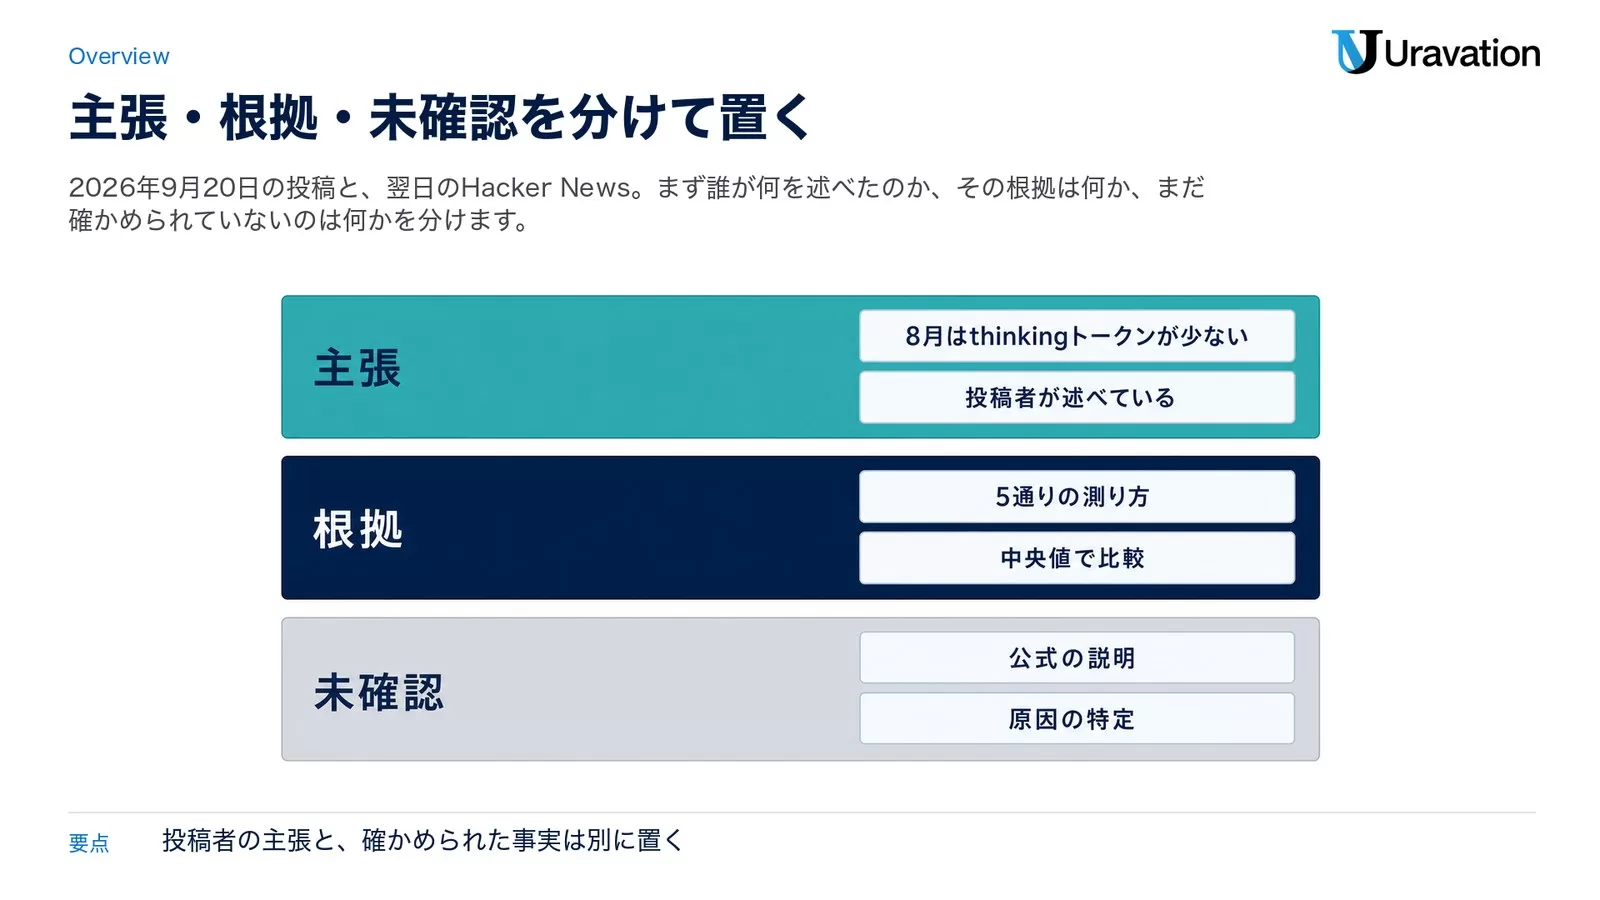
- 観測を投稿したのはLon Lundgren氏(@Lon)。2026年9月20日の投稿は表示18万・いいね1,605件、Hacker Newsの投稿は336ポイント・231コメント(2026年9月22日時点で筆者が確認)
- 公式ドキュメントに書かれているのは「adaptive thinking=モデルが毎回think量を決める」「effortは行動の指針であって固定予算ではない」「thinking表示の既定値は
omittedで本文には返らない」の3点 - Anthropicから今回の投稿への反論・説明は、2026年9月22日時点で公式ブログ・ニュース・エンジニアリングブログのいずれにも確認できていません
対象読者: Claudeを業務や製品に組み込んでいる開発責任者・情報システム部門・AI導入の意思決定者
読了後にできること: 同じ入力をeffort別に投げて、thinkingトークン数と結果を記録する検証を今日中に始められます
「最近のClaude、前より雑になっていませんか?」
法人研修や導入相談の場で、この種の質問が出る頻度は確実に増えています。厄介なのは、聞かれた側も答えようがないことです。体感は残るのに、比べる相手がいない。先週の自分の出力を保存している人はほとんどいません。
そこへ2026年9月20日、ひとつの投稿が入りました。AWS Auroraの設計でSIGMOD Systems Awardを受けたLon Lundgren氏が、「Fable 5がサブスクリプションプランで常時使えるようになったあと、性能が大きく落ちたと感じた。5通りの測り方で、8月は7月よりthinkingトークンが劇的に少なかった」と述べたのです。翌21日にはHacker Newsの一面に上がり、日本語圏でもじわじわ話題になり始めました。
この記事では、この論争を「性能が落ちた/落ちていない」のどちらかに決めつけません。やるのは、①誰が何を測ってどう述べているかを分けて置く、②その測り方で言えること・言えないことを線引きする、③Anthropicの公式ドキュメントに実際に書かれていることを引く、④自社の環境で同じことを確かめる手順を渡す、の4つです。感覚の議論を、数字で切り分けられる議論に移すための材料としてお使いください。
いま何が起きているのか|投稿とHacker Newsの反応
時系列で事実だけを並べます。以下はすべて、2026年9月22日に筆者が投稿とHacker NewsのAPIで直接確認した内容です。
| 日時(UTC) | 出来事 | 確認できた数値 |
|---|---|---|
| 2026年9月20日 21:59 | Lon Lundgren氏(@Lon)がXに観測を投稿。グラフ画像1枚を添付 | 表示180,440・いいね1,605・リポスト99・返信68 |
| 2026年9月21日 16:13 | 同投稿がHacker Newsへ「Fable 5 – Median thinking declined in August」として投稿される | 336ポイント・231コメント |
| 2026年9月22日 | Anthropicの公式ブログ・ニュース・エンジニアリングブログに、この件への言及は確認できず | — |
ここで押さえておきたいのは、この投稿が「匿名の体感」ではないことです。投稿者はAmazon Aurora の設計でSIGMOD Systems Awardを受け、AWS SimSpace Weaverを作った経歴をプロフィールに掲げている実名アカウントです。だからといって主張が自動的に正しくなるわけではありませんが、「よくある愚痴」として流せる種類のものでもない、という位置づけになります。
一方でHacker Newsのコメント欄は、賛同一色ではありません。231件のコメントを読むと、大きく3つの立場に割れています。「自分も同じ劣化を感じている」という体感派、「新しいものに慣れただけの認知バイアス(hedonic adaptation)ではないか」という懐疑派、そして「そもそもthinkingトークンはクライアントに返ってこないのに、どうやって測ったのか」という測定方法への疑問です。3つ目は技術的にいちばん重い指摘で、後述するとおり公式ドキュメントを読むと答えが出ます。
投稿者が述べていること|「8月はthinkingトークンが少なかった」
投稿本文は短く、主張は2文です。原文を訳して整理すると次のようになります。
Anthropicが Fable 5 をサブスクリプションプランで常時利用できるようにしたあと、性能が大きく落ちたことに気づいた。モデルが以前より頭が悪く感じられたが、その理由を説明できなかった。5通りの方法で測ったところ、8月は7月と比べて劇的に少ないthinkingトークンしか出ていなかった。(Lon Lundgren氏、2026年9月20日の投稿より筆者訳)
投稿に添えられているのは横長のグラフ画像1枚で、本文に数値の内訳は書かれていません。Hacker News側のタイトル「Median thinking declined in August(8月にthinkingの中央値が下がった)」から、中央値という統計量で比較したことが読み取れます。
重要なのは、ここまでが「投稿者がそう述べている」という事実であって、「Fable 5の性能が落ちた」という事実ではない、という点です。両者は別物です。投稿者の観測が正しかったとしても、それがモデルの重みの変更を意味するのか、提供側の設定変更なのか、投稿者自身の使い方の変化なのかは、この投稿からは決まりません。
Fable 5とFable 5.1の仕様差についてはFable 5.1とFable 5の違いに比較表をまとめています。8月から9月にかけては世代の切り替わりも重なっているため、どのモデルIDを見ていたかで話が変わります。
thinkingトークンとは|公式ドキュメントに書かれている仕組み
ここから公式の話です。Anthropicのプラットフォームドキュメントは、thinkingについて次のように書いています(参照日2026年9月22日)。
課金は出力トークン、ただし本文には返らない
公式の Thinking ページには「Claudeが推論に使ったトークンは、その思考テキストがあなたに返されない場合でも出力トークンとして課金され、応答本文と合わせて max_tokens に算入される」と明記されています。
そして表示の既定値が重要です。Claude Fable 5.1・Fable 5・Opus 5・Sonnet 5では thinking.display の既定値が "omitted" で、thinkingブロックは返るものの中身のテキストは空になります。"summarized" を指定すると要約された思考が返りますが、公式は「課金されるのは元のリクエストが生成した完全なthinkingトークンであって、要約のトークンではない。課金される出力トークン数は、応答で見えるトークン数と一致しない」と明示的に警告しています。
つまり「画面に出ている思考テキストの長さ」を数えても、実際のthinking量にはならないということです。Hacker Newsで出ていた「どうやって測ったのか」という疑問は、ここに直結します。
数えるための公式フィールドがある
では何を数えるのか。公式の Steering thinking ページに答えが書かれています。「課金対象の出力トークンのうち、どれだけが内部推論に使われたかを見るには、応答の usage.output_tokens_details.thinking_tokens を読む。この値はモデルが生成した生の推論を反映し(本文に返る要約テキストではない)、常に output_tokens 以下になる」とあります。ストリーミング時は最後の message_delta イベントにだけこの内訳が現れる、という注記もついています。
公式に載っている応答例はこの形です。
{
  "usage": {
    "input_tokens": 25,
    "output_tokens": 348,
    "output_tokens_details": {
      "thinking_tokens": 312
    }
  }
}
この1フィールドがあるかないかで、議論の質がまったく変わります。体感で「雑になった」と言う代わりに、「同じ入力で thinking_tokens が何から何に変わった」と言えるからです。
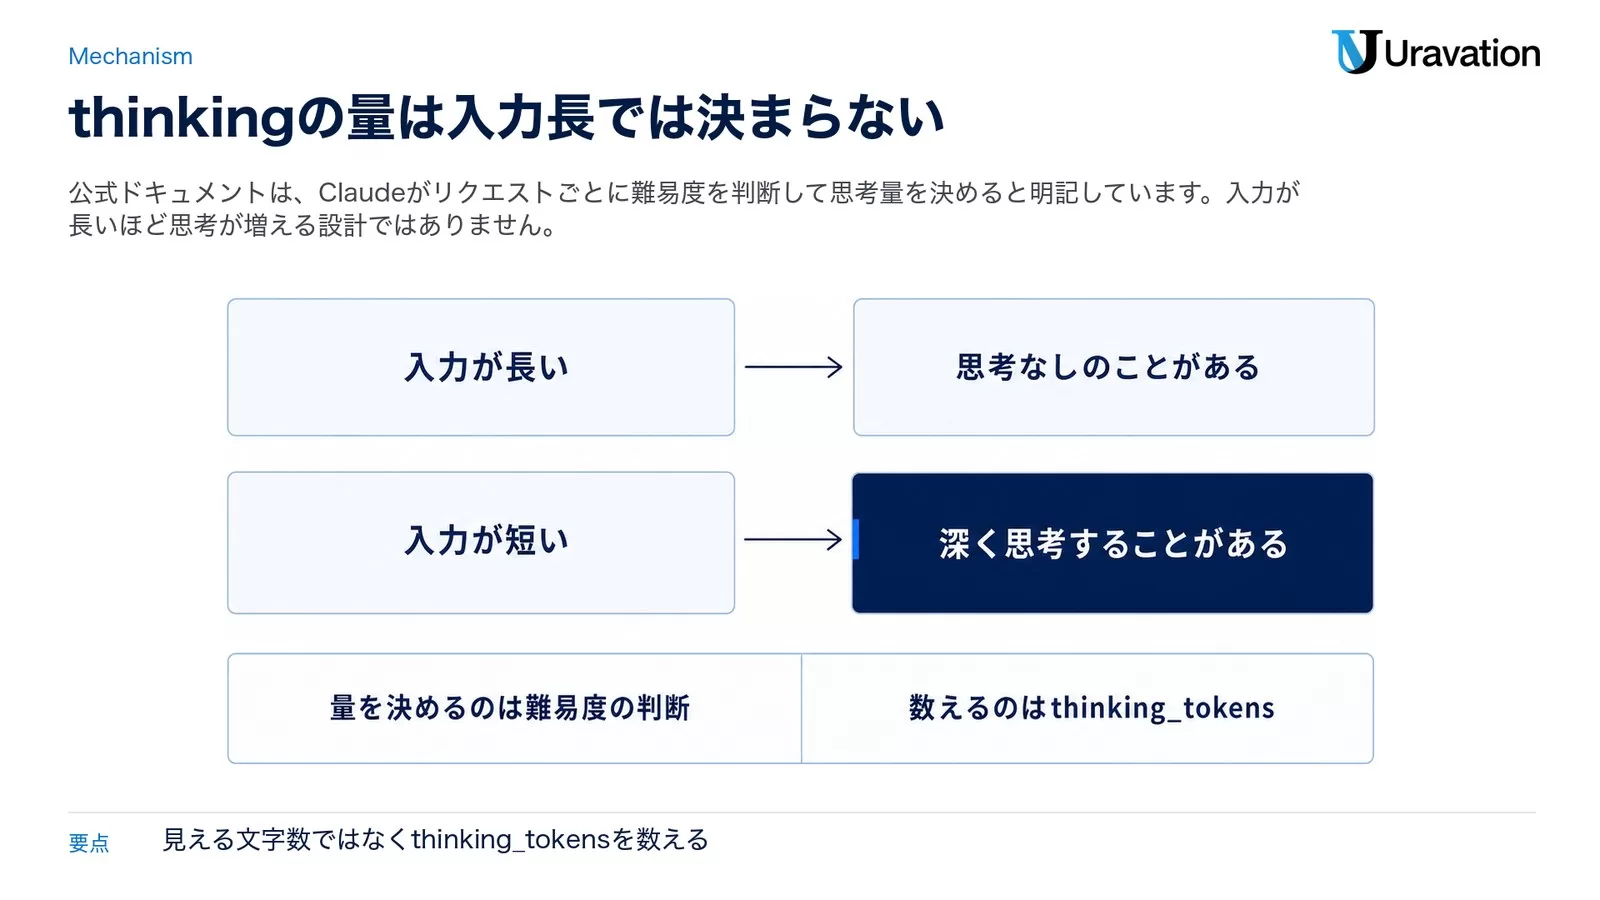
thinkingの量を決めているのはモデル自身
もうひとつ、今回の論争の核心にあたる記載があります。同じSteering thinkingページの冒頭です。
Claudeのthinkingはadaptive(適応的)である。モデルはリクエストごとに評価し、思考するかどうか、どれだけ思考するかを自分で決める。(中略)この判断はリクエスト単位で起きる。同じ会話の中に、思考したターンと思考しなかったターンが混在しうる。(Anthropic公式ドキュメントより筆者訳)
「すべてのアシスタントターンがthinkingブロックから始まると仮定するアプリケーションロジックを書かないこと」とまで書かれています。thinkingトークン数は、そもそも入力の大きさに比例する設計ではない、というのが公式の説明です。
公式が明記していること|effortとadaptive thinkingの仕様
thinkingの深さを外から動かす唯一の公式な制御が effort パラメータです。Effort ページには5段階が定義されています。
| effort | 公式に書かれたthinkingの挙動 | 想定用途 |
|---|---|---|
max | 常に思考し、思考の深さに制約なし | 最も深い推論が要る作業 |
xhigh | 常に深く思考し、探索を広げる | 長時間のエージェント作業・コーディング |
high(既定) | ほぼ常に思考する。複雑なタスクで深い推論 | 複雑な推論・難しいコーディング |
medium | 中程度の思考。単純な問い合わせでは思考を省くことがある | 速度・コスト・性能の折り合い |
low | 思考を最小化。速度優先の単純タスクでは思考を省く | サブエージェント・低遅延用途 |
そして公式は、このパラメータの性格をはっきり限定しています。「effortは行動の指針(behavioral signal)であって、厳密なトークン予算ではない。低いeffortでも、十分に難しい問題についてはClaudeは依然として思考するが、同じ問題に対して高いeffortのときよりは思考量が少なくなる」。
加えて「thinkingトークンの予算は設定できない(You don’t set a thinking token budget)」とも書かれています。コストを縛れるのは max_tokens(出力全体のハード上限)と effort(ソフトな指針)の2つだけ、という整理です。
モデル別の公式仕様(2026年9月22日時点)
比較の土台として、公式のモデル一覧から関係する数値を引きます。
| 項目 | Claude Fable 5.1 | Claude Opus 5 | Claude Sonnet 5 |
|---|---|---|---|
| APIのモデルID | claude-fable-5-1 | claude-opus-5 | claude-sonnet-5 |
| Thinking | Adaptive(常時オン) | Adaptive | Adaptive |
| 既定のeffort | high | high | high |
| 入力(100万トークンあたり) | $10 | $5 | $2 |
| 出力(100万トークンあたり) | $50 | $25 | $10 |
| コンテキスト | 1Mトークン | 1Mトークン | 1Mトークン |
| 最大出力 | 128Kトークン | 128Kトークン | 128Kトークン |
Fable 5.1はFable 5と同じ入出力単価で、キャッシュ読み取りだけが100万トークンあたり$0.25に下がっています(他モデルは基本入力価格の10%、Fable 5.1系は2.5%)。料金の全体像と第三者の実測値はClaude Fable 5.1は本当に安いかでまとめています。
プラン側の提供条件
今回の投稿の前提にある「サブスクリプションでの提供」についても、公式の料金ページの記載を引いておきます(2026年9月22日時点)。
| プラン | 料金 | Fableの扱い(公式の記載) |
|---|---|---|
| Free | $0 | 対象外(Sonnet・Haikuのみ) |
| Pro | 年払いで月$17($200一括)/月払い$20 | 使用量クレジット経由 |
| Max | 月$100から | 使用量クレジット経由 |
| Team | 標準シート 年払いで1席あたり月$20/プレミアムシート 1席あたり月$100 | プレミアムシートで使用量クレジット経由 |
| Enterprise | 年払いで1席あたり月$20(別途、利用量に応じた費用) | 利用可 |
クレジットの消費量やリセットの仕組みはFable 5.1の利用クレジット・上限・リセットに分けて書いています。ここで押さえるべきは、プランで使う場合と API で使う場合では、そもそも制御できる項目が違うということです。APIなら effort を固定できますが、チャット画面の利用者は固定できません。
この観測で言えること・言えないこと
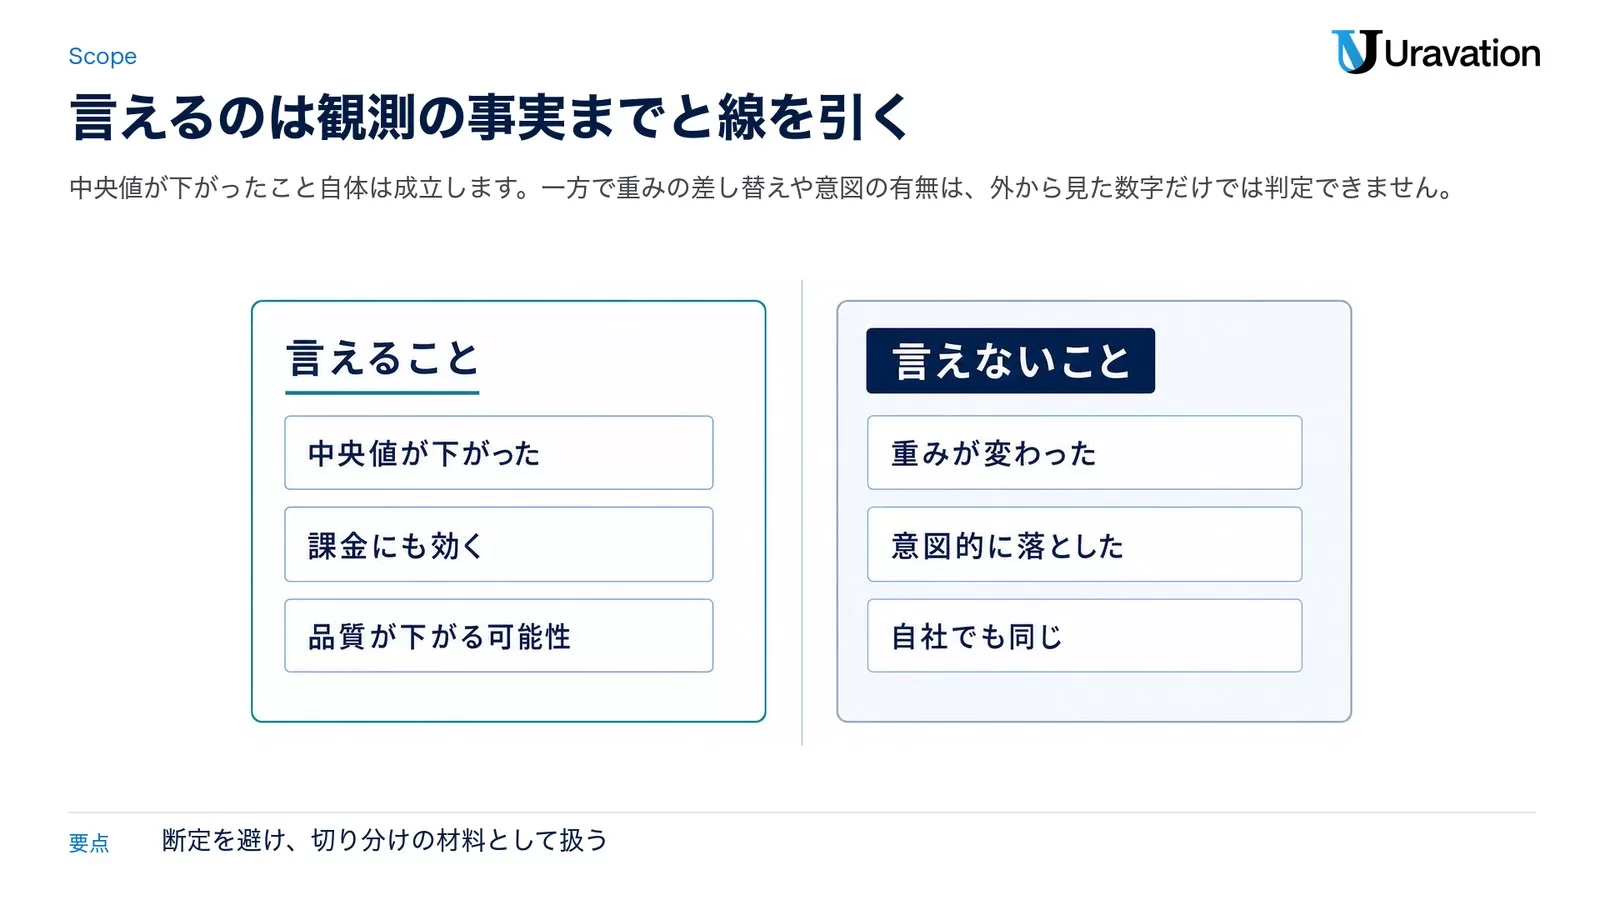
ここが記事の中心です。今回の観測は「thinkingトークンの中央値が月をまたいで下がった」という形をしています。この形から論理的に言えることと、言えないことを分けます。
言えること
- 観測期間中、その人のトラフィックにおいてthinkingトークンの中央値が下がった。ログが正しければ、これは事実として成立します
- thinkingトークンは課金される出力トークンである。したがって、この変化はコストにも直接効きます(公式ドキュメント記載)
- thinking量が減れば、推論が効くタスクでの品質が下がる可能性がある。公式も「思考を減らす方向にステアリングすると、推論が効くタスクで品質が下がることがある」と警告しています
言えないこと
- 「モデルの重みが入れ替えられた」とは言えない。thinking量の変化は、モデル本体以外の多くの要因で起こりえます
- 「入力に比例しなかったから異常だ」とは言えない。公式はthinking量をリクエストごとにモデルが決める設計だと明記しており、入力長への比例は仕様上そもそも保証されていません
- 「意図的に品質を落とした」とは言えない。意図の有無は外形的な観測からは判定できません
- 「自社環境でも同じことが起きている」とは言えない。effort設定・プロンプト・ツール構成・使うモデルIDが違えば結果は変わります
交絡しやすい要因
7月と8月の比較で、モデル以外に変わりうるものを公式ドキュメントから拾うと、少なくとも次があります。
- 使っているモデルIDの世代が変わった。Fable 5.1は2026年9月に登場しており、月をまたぐ比較は世代の切り替わりをまたぐ可能性があります
- effortの既定値が経路ごとに違う。公式には「
highを明示的に設定することは、パラメータを省略するのとまったく同じ挙動になる」とあります。逆に言えば、呼び出し側のライブラリやツールがどのeffortを送っているかで結果は変わります - プロンプト自体が変わった。公式は「思考の頻度はプロンプトで誘導できる」と明記しており、システムプロンプトの一文で thinking の発火率が動きます
- ツール利用の構成が変わった。公式によればFable 5.1はFable 5と比べて「1ターンあたり1回のツール呼び出しになることがあり、Fable 5なら複数をまとめて出していた」挙動差があります
この4点はどれも、ログ上は「thinkingトークンが減った」という同じ形に見えます。だから、外から見るだけでは切り分けられないのです。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修4,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
Anthropicの説明は出ているか|2026年9月22日時点の確認
結論から書きます。2026年9月22日時点で、今回の投稿に対するAnthropicの公式の反論・説明は確認できていません。 公式ニュース一覧(anthropic.com/news)、エンジニアリングブログ、プラットフォームドキュメントの更新履歴を確認しましたが、該当する記載は見つかりませんでした。今後公式の説明が出た場合、この記事は内容を追記します。
ただし、同種の報告に対してAnthropicが過去にどう対応したかの記録は2件公開されています。これは「今回もこうだ」という根拠にはなりませんが、何を確認しに行くべきかの手がかりになります。
2026年4月23日の報告書(Claude Code品質報告への回答)
An update on recent Claude Code quality reports では、Claude Code・Claude Agent SDK・Claude Coworkに影響した3つの変更が特定されています。
- 3月4日:Claude Codeの既定の推論effortを
highからmediumに変更(遅延短縮のため)。利用者の要望を受けて4月7日に撤回 - 3月26日:プロンプトキャッシュ最適化の不具合で、セッション途中の推論履歴が毎ターン破棄されていた。4月10日(v2.1.101)で修正
- 4月16日:システムプロンプトがツール呼び出しの間の応答を25語以内に制限していた。4月20日に撤回
すべて4月20日(v2.1.116)で解消。Anthropicはこの報告書で「我々は意図的にモデルを劣化させることはない。APIと推論レイヤーが影響を受けていないことは即座に確認できた」と述べています。注目すべきは、3件のうち1件が「effortの既定値変更」だったことです。モデルは同じでも、呼び出し側の既定値が変われば体感は変わります。
2025年9月17日の報告書(3つの基盤バグ)
より古いA postmortem of three recent issues では、コンテキストウィンドウのルーティング誤り、出力の破損、TPUコンパイラの不具合という3件の基盤バグが公表されました。ここでAnthropicは「需要・時間帯・サーバ負荷を理由にモデル品質を下げることはない」と述べ、同時に「より感度の高い評価」「本番システムでの継続的な品質評価」「より速いデバッグ用ツール」を整備すると約束しています。
2件に共通するのは、利用者の体感報告が先にあり、後から具体的な原因が特定されたという順序です。体感は無価値ではない。ただし体感のままでは原因にたどり着けない、というのが過去の記録から読み取れることです。
自社で確かめる5つの手順|同じ入力でthinkingトークンを数える
ここからは手を動かす話です。以下はすべて公式ドキュメントに記載された操作だけで構成しています。存在しないコマンドは使いません。
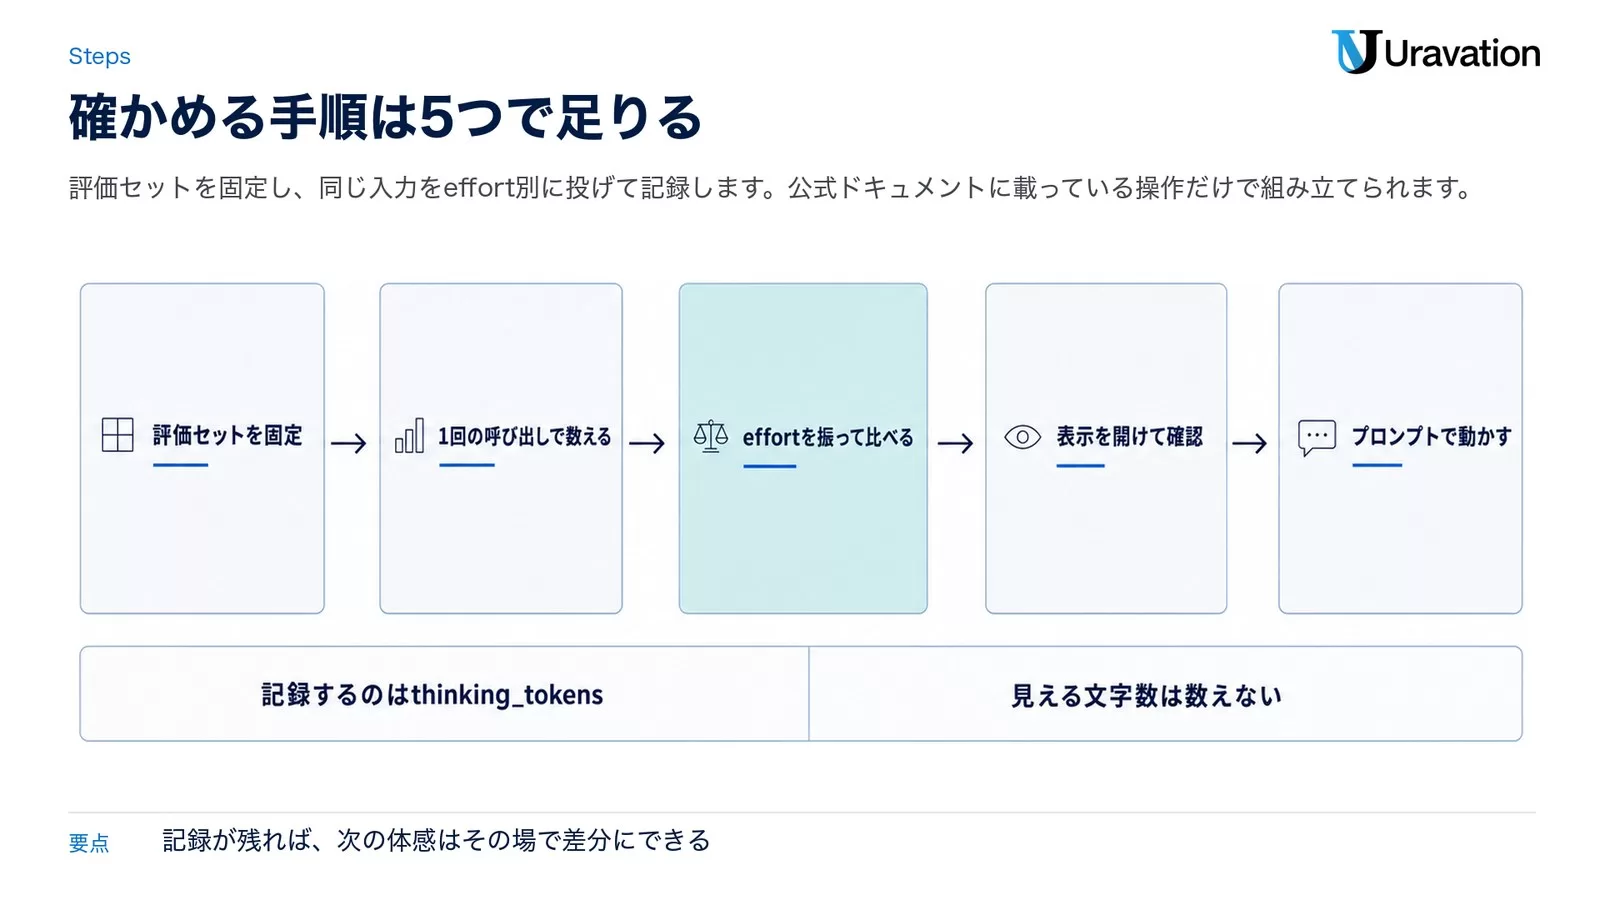
手順1:評価セットを固定する
いちばん大事な準備です。自社の業務で実際に使っている入力を10〜20件選び、一字一句変えずに固定します。公式も「代表的なトラフィックのサンプルを、ガイダンスありとなしで走らせ、thinkingがどれだけの頻度で発火するか、出力トークン使用量、遅延、重要なケースでの回答品質を比較すること」と推奨しています。
【社内共有用テンプレ:評価セット記録フォーマット】

検証ID:EVAL-2026-09-__
対象モデルID:claude-fable-5-1 / claude-opus-5(両方記録)
effort設定:low / medium / high / xhigh / max のどれを送ったか
max_tokens:(値)
システムプロンプト:(全文をそのまま保存。バージョン番号を振る)
入力No.1〜20:(本文をそのまま保存)
記録する値:output_tokens / thinking_tokens / 所要秒数 / 合否判定(人が5段階)
実施日時(JST):
実施者:
手順2:thinkingトークンを読む1回の呼び出し
公式のEffortページに載っているcURLの形に、usageを読む処理を足したものです。
curl https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-1",
    "max_tokens": 16000,
    "output_config": { "effort": "high" },
    "messages": [{
      "role": "user",
      "content": "(ここに評価セットの入力をそのまま入れる)"
    }]
  }'
返ってきたJSONの usage.output_tokens_details.thinking_tokens が、この1回で内部推論に使われた課金対象トークン数です。output_tokens から引けば、応答本文側におおよそ何トークン使われたかが分かります。
手順3:effortを振って同じ入力を比べる
ここが切り分けの本体です。同じ入力を、effortだけ変えて投げます。
import anthropic, json, datetime

client = anthropic.Anthropic()
PROMPT = "(評価セットの入力をそのまま)"

for level in ["low", "medium", "high", "xhigh", "max"]:
    r = client.messages.create(
        model="claude-fable-5-1",
        max_tokens=16000,
        output_config={"effort": level},
        messages=[{"role": "user", "content": PROMPT}],
    )
    d = r.usage.output_tokens_details
    print(json.dumps({
        "ts": datetime.datetime.now().isoformat(timespec="seconds"),
        "effort": level,
        "output_tokens": r.usage.output_tokens,
        "thinking_tokens": getattr(d, "thinking_tokens", None),
        "stop_reason": r.stop_reason,
    }, ensure_ascii=False))
公式は「effortを変えるとプロンプトキャッシュが無効化される」と明記しているので、この検証はキャッシュ前提の本番フローとは分けて走らせてください。また stop_reason が max_tokens になっている場合は、思考の途中で打ち切られています。公式の指示どおり max_tokens を上げるか、effortを下げるかのどちらかで対処します。
手順4:思考テキストを見たいときだけ表示を開ける
既定では思考の中身は返りません。中身を見たい場合は公式の指定で開けます。
{
  "model": "claude-fable-5-1",
  "max_tokens": 16000,
  "thinking": { "type": "adaptive", "display": "summarized" },
  "messages": [{ "role": "user", "content": "..." }]
}ただし公式の警告どおり、ここで返るのは要約された思考であって生の思考ではありません。「要約は、あなたがリクエストで指定したモデルとは別のモデルが処理する」「thinking機能の改善に伴い、要約の挙動は変更されうる」とも書かれています。要約テキストの長さを検証指標にしてはいけません。 見るのは必ず thinking_tokens の数値です。
手順5:思考の発火をプロンプトで動かしてみる
effortを変えずに、システムプロンプトの一文だけで挙動が動くかを確かめます。公式ドキュメントに載っている文面がそのまま使えます。
【思考を抑えたいとき(公式の例文)】
Extended thinking adds latency and should only be used when it
will meaningfully improve answer quality, typically for problems
that require multistep reasoning. When in doubt, respond directly.

【思考を促したいとき(公式の例文)】
This task involves multistep reasoning. Think carefully before responding.
この2文を入れた場合と入れない場合で thinking_tokens が動くなら、自社の体感の一部はプロンプト側で説明できるということです。公式も「ステアリングの効き方は正確な言い回しに敏感である」と注記しています。
会話の途中でeffortを切り替えたい場合は、Fable 5.1・Mythos 5.1・Opus 5に限りベータ機能が用意されています。ベータヘッダ mid-conversation-output-config-2026-07-01 を付け、内容が空の role: "system" メッセージに新しいeffortを載せる形です。Fable 5はこの機能に対応しておらず400エラーを返す、と公式に明記されています。
{
  "role": "system",
  "content": [],
  "output_config": { "effort": "low" }
}
【要注意】検証でやりがちな失敗4つ
失敗1:画面に出ている思考テキストの長さを数える
❌ チャット画面やAPIレスポンスに見えている思考の行数・文字数を比べる
⭕ usage.output_tokens_details.thinking_tokens の数値を比べる
なぜ重要か: 公式は「課金される出力トークン数は、応答で見えるトークン数と一致しない」と警告しています。既定値では思考テキストは空で返りますし、summarized にしても返るのは別モデルが作った要約です。見える長さと実際の思考量は別物です。
失敗2:入力が大きいのにthinkingが増えないことを異常と判断する
❌ 「長い資料を渡したのにthinkingトークンが伸びない=手を抜いている」
⭕ 「thinking量は入力長ではなく、モデルが判断した難易度で決まる」と前提を置く
なぜ重要か: 公式は「Claudeはリクエストごとに入力の複雑さを検討し、より深い推論が答えを改善するかどうかを決める」と書いています。単純な事実確認の質問は、入力が長くてもthinkingブロックがまったく出ないことがあります。これは仕様です。
失敗3:月単位の平均だけで比べる
❌ 7月の平均と8月の平均を1つの数字で比べて結論を出す
⭕ 同じ入力・同じeffort・同じモデルIDで揃えた小さなセットで比べる
なぜ重要か: 月をまたぐ集計は、モデル世代の切り替わり・自分のプロンプト変更・タスク構成の変化を全部飲み込んでしまいます。Fable 5とFable 5.1では、公式が認めている挙動差だけでも「ツール呼び出しのまとめ方」「低effortでの検索頻度」「ファイル編集の仕方」など複数あります。
失敗4:検証結果を残さずに議論する
❌ 「先週より雑」「今日は調子がいい」で社内の判断が揺れる
⭕ 評価セットと thinking_tokens のログを日付つきで保存し、差分で話す
なぜ重要か: 過去2件のAnthropicの報告書は、いずれも利用者の体感報告が先にあり、後から原因が特定されました。ただし原因特定に使われたのは体感ではなくログです。自社にログが残っていなければ、公式に問い合わせるときも「なんとなく悪い」以上のことが言えません。本番運用でつまずきやすい点はClaude Fable 5 失敗ケース10選にも整理しています。
Uravationならこう判断する|法人が今できる備え
この種の論争は今後も繰り返し起きます。そのたびに全社で騒ぐのではなく、仕組みで受け止められるようにしておくのが実務的な答えです。順番に4段階で考えます。
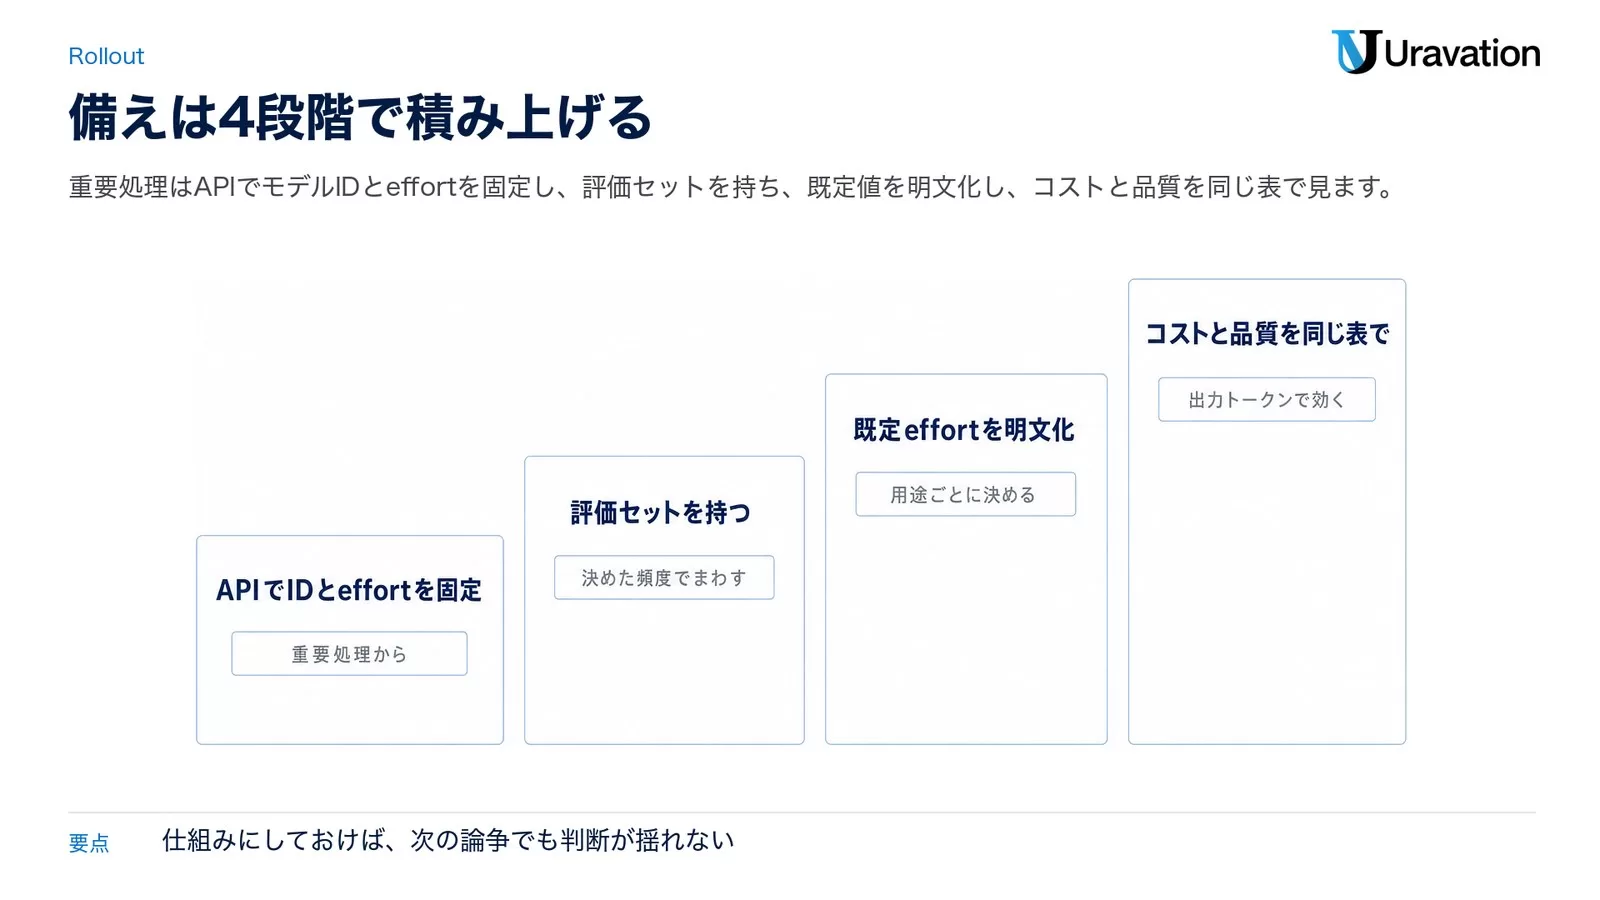
第1段階:重要処理はAPIで、モデルIDとeffortを固定する
チャット画面経由の利用は、提供側の設定変更を受けます。業務の中核に置く処理は、モデルIDとeffortを明示的に指定したAPI呼び出しにしておきます。公式のモデルIDはすべて固定スナップショットとされており(「日付なしのIDも、それ自体が固定されたスナップショットである」と公式に記載)、IDを固定すれば少なくとも「別の世代に切り替わっていた」という交絡は消せます。
第2段階:評価セットを持ち、定期的に回す
手順1で作った評価セットを、月1回など決めた頻度で回して thinking_tokens と合否を記録します。これがあると、次に「落ちた気がする」という声が上がったときに、その場で差分を出せます。
第3段階:effortの既定値を社内で明文化する
2026年4月の報告書で撤回された変更のひとつは「既定effortの引き下げ」でした。逆に言えば、自社のツールやラッパーがどのeffortを送っているかを把握していない組織は、同種の変化に気づけません。用途ごとに「この処理は xhigh」「この処理は low」と決めて文書にします。
第4段階:コストと品質を同じ表で見る
thinkingトークンは課金対象の出力トークンです。effortを上げれば品質が上がる可能性と同時に、100万トークンあたり$50の出力側コストが増えます。品質だけ、コストだけを見る会議をやめて、同じ表に並べて判断します。ベンチマーク指標の読み方はFable 5.1ベンチマーク9指標にまとめています。
よくある質問
Fable 5の性能は本当に落ちたのですか?
2026年9月22日時点で、性能が落ちたと断定できる公開情報はありません。あるのは、Lon Lundgren氏が「5通りの測り方で8月のthinkingトークンが7月より劇的に少なかった」と述べている観測と、それに対する賛否です。Anthropicからの説明は確認できていません。自社で判断する場合は、同じ入力・同じeffort・同じモデルIDで thinking_tokens を比べてください。
thinkingトークンはどこで見られますか?
APIの応答に含まれる usage.output_tokens_details.thinking_tokens です。公式ドキュメントに「課金対象の出力トークンのうち内部推論に使われた分を見るためのフィールド」と明記されています。ストリーミングでは最後の message_delta イベントにだけ現れます。チャット画面の利用では、このフィールドは見られません。
effortを上げれば必ず賢くなりますか?
公式は「effortは行動の指針であって厳密なトークン予算ではない」と書いています。上げれば思考量が増える傾向はありますが、保証された量が決まるわけではありません。また出力トークンが増えるぶんコストと遅延も増えます。Opus 5については「effortを変えても応答の見た目の長さは確実には短くならない。長さはプロンプトで指定すること」という注記もあります。
Anthropicは過去にモデルを意図的に劣化させたことがありますか?
Anthropicは公開の報告書で「我々は意図的にモデルを劣化させることはない」(2026年4月23日)、「需要・時間帯・サーバ負荷を理由にモデル品質を下げることはない」(2025年9月17日)と述べています。一方で、既定effortの引き下げ・キャッシュの不具合・システムプロンプトの語数制限といった、体感品質に影響する変更やバグが実際に起きて撤回・修正された記録も同じ報告書に公開されています。
チャット画面しか使っていない場合、何ができますか?
thinkingトークン数は見られませんが、同じ入力を保存して定期的に投げ直し、出力を日付つきで残すことはできます。数値で比べたい場合は、検証用に少額のAPI利用枠を用意し、評価セットだけをAPIで回すのが現実的です。プラン側の使い方と設定の入口はFable 5.1の使い方に整理しています。
まとめ:今日から始める3つのアクション
- 今日やること: 自社の業務で使っている入力を3件選び、そのままの文面でファイルに保存する。これが評価セットの最初の3件になります
- 今週中: その3件をeffort
low/high/xhighでAPIに投げ、thinking_tokensとoutput_tokensと合否を記録する。差が出るかどうかを自分の目で見る - 今月中: 用途ごとの既定effortを文書にし、重要処理のモデルIDを固定する。次に「落ちた気がする」という声が出たとき、その場で差分を出せる状態にしておく
あわせて読みたい:
- Claude Fable 5.1とは?変更点・料金・使い方 — 世代間の変更点と公式仕様
- Fable 5.1とFable 5の違い — 比較表と移行判断
著者: 佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。
100社以上の企業向けAI研修・導入支援。著書『AIエージェント仕事術』『Claude仕事術』(SBクリエイティブ・シリーズ累計約6万部)。
SBクリエイティブ「ビジネス+IT」ほかで生成AI連載を執筆(NewsPicks最大1,125ピックス)。
この記事の検証手順を自社の環境で組み立てたい、社内の評価セットの設計から相談したい、という場合はお問い合わせフォームからお気軽にどうぞ。
参考・出典
- Steering thinking — Anthropic 公式ドキュメント(参照日: 2026-09-22。
usage.output_tokens_details.thinking_tokens・effort段階表・コスト制御の記載) - Thinking — Anthropic 公式ドキュメント(参照日: 2026-09-22。課金の扱い・
displayの既定値・要約された思考の注意書き) - Effort — Anthropic 公式ドキュメント(参照日: 2026-09-22。5段階の定義・「行動の指針であって厳密なトークン予算ではない」の記載・会話途中のeffort変更ベータ)
- Models overview — Anthropic 公式ドキュメント(参照日: 2026-09-22。モデルID・単価・コンテキスト・既定effort)
- What’s new in Claude Fable 5.1 — Anthropic 公式ドキュメント(参照日: 2026-09-22。Fable 5からの挙動差・キャッシュ読み取り単価)
- Claude 料金ページ — Anthropic(参照日: 2026-09-22。プラン料金とFableの提供条件)
- An update on recent Claude Code quality reports — Anthropic(2026年4月23日公開・参照日: 2026-09-22)
- A postmortem of three recent issues — Anthropic(2025年9月17日公開・参照日: 2026-09-22)
- Lon Lundgren氏の投稿 — X(2026年9月20日投稿・参照日: 2026-09-22)
- Fable 5 – Median thinking declined in August — Hacker News(2026年9月21日投稿・参照日: 2026-09-22)
この記事の内容を社内で使うなら
Fable 5を「試す」から「業務で使う」へ。どの業務に効くか、料金プランの選び方、社内で安全に使う設定まで、この1冊で判断できます。
- 30分・オンライン
- 売り込みでなく業務診断
- 完全マンツーマン
資料は受け取りページからすぐにご覧いただけます。