この記事の要点(2026年9月22日時点・最終更新:2026年9月)
- Grok 4.7は、SpaceXAIが2026年9月21日(米国時間)に公開した、コーディングと知識労働向けの最上位モデルです。公式は「Grok 4.6と同じ価格・同じ速度で提供する」と書いています。
- API料金は100万トークンあたり入力2ドル・出力6ドルから(プロンプトが20万トークン未満のとき)。20万トークン以上になると入力4ドル・出力12ドルに切り替わります。
- コンテキスト長は500,000トークン、学習データは2026年5月まで。入力はテキストと画像、出力はテキストのみで、出力の長さ上限はありません。
- 入口は4つ:xAI API(モデル名
grok-4.7)、Grok Build(既定モデル)、Cursor(全プラン)、GitHub Copilot(Pro・Pro+・Max・Business・Enterprise)。消費者向けのGrokアプリでの提供は、公式発表に記載がありません。 - この記事を読むべき人:社内のコーディング支援やドキュメント作成にどのモデルを使うか決める立場の経営者・情報システム責任者・開発リーダー。
- 今日できること:いま従量課金で使っているモデルの直近1か月の入力・出力トークン数を出し、この記事の単価表に当てはめて差額を計算する。
コーディング用のモデルを選ぶとき、実際に効いてくるのは「ベンチマークの点数」ではなく「1つの作業を終わらせるのにいくらかかるか」です。長い工程を何十回も往復するエージェント型の使い方では、単価の差がそのまま月末の請求書の差になります。2026年9月21日(米国時間)に公開されたGrok 4.7は、ここを正面から狙ったモデルです。公式発表の見出しは「comparable modelsの半分の価格で2倍速い」。そして本文には、前世代のGrok 4.6と同じ価格・同じ速度で提供すると書かれています。
提供元はSpaceXAI(旧xAI)。発表ページによると、Grok 4.7はGrok 4.6より大きい新しいベースモデルを使い、「何時間もかかる問題」に重みを置いた難しいタスクの組み合わせで、より長い強化学習を回して作られています。公式が挙げる改善点は3つ。自分の作業を検証する力、長いコンテキストの扱い、そしてGrok Botのハーネス(実行環境)をそのまま理解すること。いずれも「1回の質問に答える」より「長い工程を自分で進める」ことに寄った改善です。
日本の法人にとって判断材料になるのは、価格・仕様・データの扱い・入口の4点です。API料金は100万トークンあたり入力2ドル・出力6ドル(2026年9月時点の概算で、1ドル150円なら入力約300円・出力約900円)。コンテキスト長は500,000トークン。データは「明示的な許可なく学習に使わない」と公式FAQが明記し、既定では監査目的で30日だけ保存されます。入口はxAI API・Grok Build・Cursor・GitHub Copilotの4つで、それぞれ課金の出どころが違います。
この記事では、SpaceXAIの発表ページ・公式ドキュメント(モデルページ/料金ページ/リリースノート/セキュリティFAQ/Grok Buildの企業導入ページ)と、GitHubの公式チェンジログを1つずつ読んだうえで、料金表・仕様表・使い方の手順・管理者が先に決めることを整理します。確認できなかった項目は「2026年9月22日時点で公式に確認できていない」とそのまま書きます。
【開発者向け】API・Grok Build・GitHub Copilot・Cursor での設定手順
モデル ID の指定、xAI API の最小リクエスト、GitHub Copilot と Cursor で Grok 4.7 を選ぶ手順、20万トークン超で単価が倍になる条件は、開発者向けの姉妹サイト AIgent Lab に分けて書きました。 → Grok 4.7をAPI・Copilot・Cursorで使う【2026年9月】
Grok 4.7とは|2026年9月21日に公開された最上位モデル
Grok 4.7は、SpaceXAIが「コーディング、エージェント的なタスク、知識労働のために作ったフロンティアモデル」と説明しているモデルです。公式ドキュメントのモデル一覧では、「コードをはじめ、あらゆる用途の主力モデル。エージェント的なツール呼び出し、最小限のハルシネーション、設定可能な推論」と紹介されています。用途別の推奨表でも、コードとチャットの両方でGrok 4.7が指定されています(画像はGrok Imagine Image 2.0、動画はGrok Imagine Video 1.5、音声はGrok Voice API)。
発表ページの説明を分解すると、前世代との違いは次の3つに整理できます。
- ベースモデルが新しく、大きい:Grok 4.6と比べて「new, larger base model」と明記されています
- 学習の中身が「長い仕事」寄り:何時間もかかる問題に重みを置いた、より難しいタスクの組み合わせで、より長い強化学習を回したと書かれています
- 自己検証と長文脈の扱いが改善:「自分の作業をより注意深く検証する」「より長いコンテキストを管理できる」という表現が使われています
加えて、Grok Botのハーネスをネイティブに理解するよう学習させた結果、会話的なタスクと一般的な知識労働も改善した、とされています。つまり「コーディング専用に振り切ったモデル」ではなく、長い工程を任せる用途を中心に据えた汎用の最上位モデルという位置づけです。
名前の付き方にも触れておきます。SpaceXAIのAPIでは、<モデル名>が最新の安定版、<モデル名>-latestが最新版、<モデル名>-<日付>が特定のリリースを指す固定名です。公式は「ほとんどの利用者には、自動で最新機能が入る<モデル名>か-latestを推奨する」と書いています。バージョンを固定したい本番環境では日付付きを選ぶ、という使い分けになります。
提供状況と料金|APIは入力2ドル・出力6ドルから
料金は、プロンプトの長さで2段階に分かれます。公式の料金ページは「short context」と「long context」という名前で、しきい値を20万トークンとしています。注意が必要なのは、しきい値を超えたときの課金の仕方です。公式は「long contextの料金が適用されるモデルでは、リクエストのプロンプトがしきい値に達した時点で、そのリクエストの全トークンにlong contextの料率が適用される」と書いています。超えた分だけ高くなるのではなく、そのリクエスト全体が高い側に乗ります。
xAI APIの料金(100万トークンあたり・2026年9月22日時点)
| モデル | コンテキスト | 入力(20万未満) | キャッシュ入力(20万未満) | 出力(20万未満) | 入力(20万以上) | キャッシュ入力(20万以上) | 出力(20万以上) |
|---|---|---|---|---|---|---|---|
grok-4.7 | 500,000トークン | $2.00 | $0.50 | $6.00 | $4.00 | $1.00 | $12.00 |
grok-4.6 | 500,000トークン | $2.00 | $0.50 | $6.00 | $4.00 | $1.00 | $12.00 |
grok-4.5 | 500,000トークン | $2.00 | $0.30 | $6.00 | $4.00 | $0.60 | $12.00 |
grok-build-0.1 | 256,000トークン | $1.00 | $0.20 | $2.00 | $2.00 | $0.40 | $4.00 |
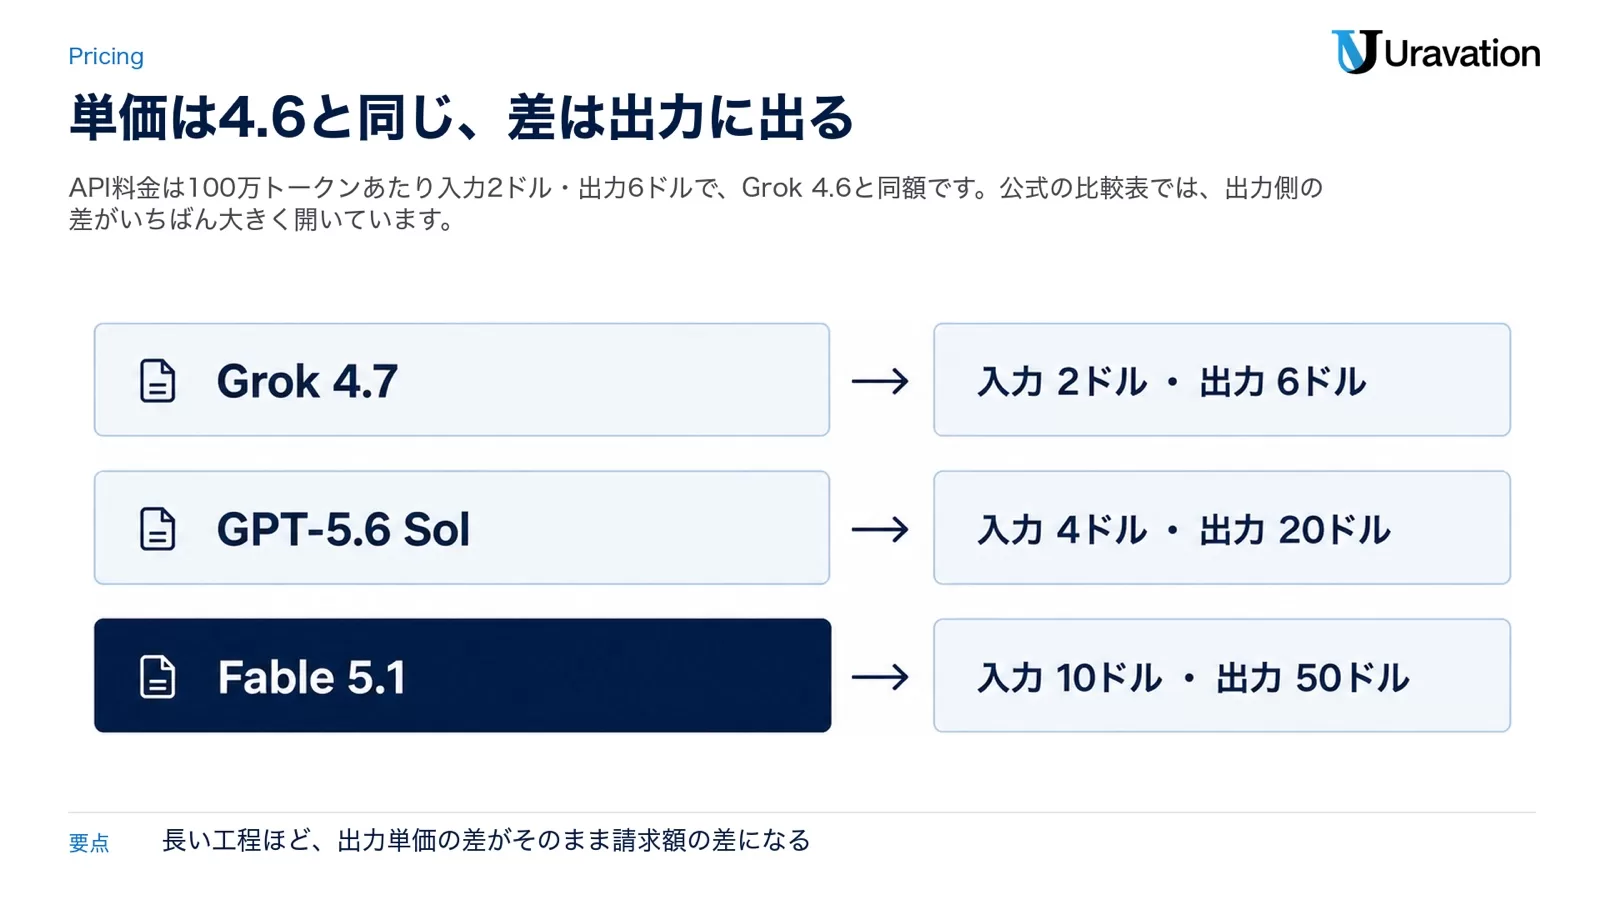
Grok 4.7とGrok 4.6の単価は同じです。発表ページの「Grok 4.6と同じ価格・同じ速度で提供する」という記述と一致します。乗り換えの判断で「値上がりするかもしれない」という心配は、2026年9月22日時点では不要です。
発表ページが並べた他社モデルとの単価差
公式発表には、Grok 4.7・Grok 4.6・GPT-5.6 Sol・Fable 5.1の単価とベンチマークを並べた表が載っています。単価の部分だけ抜き出すと次のとおりです。
| モデル(公式表の推論設定) | 入力(100万トークン) | 出力(100万トークン) |
|---|---|---|
| Grok 4.7(xHigh) | $2 | $6 |
| Grok 4.6(High) | $2 | $6 |
| GPT-5.6 Sol(Max) | $4 | $20 |
| Fable 5.1(Max) | $10 | $50 |
出力側の差が大きいのが特徴です。エージェント型の使い方では、推論トークンと最終応答の両方が出力として課金されるため、ここの差は積み上がります。他社を含めた横断の単価表は主要AIモデルAPI料金の横断比較にまとめてあります。
「Grok 4.7 Fast」はAPIでは使えない
発表ページには「出力速度が2倍のfast版を2倍の価格で提供する」という1文があります。この位置づけが、公式ドキュメントではもう少し厳密に書かれています。
- Grok 4.7 Fastは同じモデルを速いインフラで提供するもので、トークン料率は標準の2倍
- 使えるのはCursorとGrok Buildだけ。公開されているxAI APIでは使えない
- Grok Buildの無料枠には含まれない
- Cursorでは、Cursor側のプランを通して課金される
| Grok 4.7 Fast(100万トークンあたり) | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
| プロンプト20万トークン未満 | $4.00 | $1.00 | $12.00 |
| プロンプト20万トークン以上 | $6.00 | $1.50 | $18.00 |
米国内処理の専用エンドポイントは10%高い
データの処理場所を米国内に固定したい場合、https://us.api.x.ai/v1という米国リージョン専用のエンドポイントが用意されています。トークン料金は標準の1.1倍、つまり10%の上乗せです。Grok 4.7の場合、20万トークン未満で入力$2.20・キャッシュ入力$0.55・出力$6.60、20万トークン以上で入力$4.40・キャッシュ入力$1.10・出力$13.20になります。このエンドポイントで使えるのは、2026年9月22日時点ではgrok-4.7とgrok-4.6だけです。
サーバー側ツールは別課金
Web検索やコード実行といったSpaceXAI側のツールを使うと、トークン課金とは別に呼び出し回数で課金されます。
| ツール | ツール名 | 料金 |
|---|---|---|
| Web検索 | web_search | 1,000回あたり$5 |
| X検索 | x_search | 1,000回あたり$5(下記の変更あり) |
| コード実行 | code_execution | 1,000回あたり$5 |
| 添付ファイル検索 | attachment_search | 1,000回あたり$10 |
| コレクション検索(RAG) | collections_search | 1,000回あたり$2.50 |
X検索については、公式料金ページに警告が出ています。2026年9月21日の米国太平洋時間12時から、X検索の課金が「取得した投稿1,000件あたり$5」「取得したユーザープロフィール1,000件あたり$10」に変わり、従来の「呼び出し1,000回あたり$5」を置き換えるという内容です。検索やスレッド取得で返ってきた投稿は、親投稿・引用投稿も含めてすべて数えられます。X連携を前提に設計していた場合は、この日を境に見積もりを引き直す必要があります。
ファイルとコレクションの保存にも料金がかかります。ファイル保存は1GiBあたり1日$0.025、コレクション保存は1GiBあたり1日$0.10です。
仕様とGrok 4.6からの変化|500,000トークンと推論4段階
公式のモデルページに載っている仕様表を、日本語に置き換えて整理します。
| 項目 | 公式値(2026年9月22日時点) |
|---|---|
| モデル名 | grok-4.7 |
| コンテキスト長 | 500,000トークン |
| 学習データの締め | 2026年5月 |
| 入出力の種類 | 入力はテキストと画像、出力はテキストのみ |
| 出力の上限 | テキスト出力の長さ上限なし |
| 推論の強さ | low/medium/high(既定)/xhigh |
| 対応API | Responses API、Chat Completions |
| 使えるツール | 関数呼び出し、Web検索、X検索、コード実行 |
| 画像入力の制限 | 1枚20MiBまで、枚数制限なし、jpg/jpegまたはpng |
コンテキスト長500,000トークンは、現行の主要モデルのなかでも広い部類です。ただし前述のとおり、プロンプトが20万トークンを超えた時点で料率が2倍側に切り替わるので、「広いから全部入れる」という使い方は費用面で不利になります。各社のコンテキスト長は主要AIモデルのコンテキスト長 横断比較で並べています。
推論の強さは4段階、既定はhigh
Grok 4.7・Grok 4.6・Grok 4.5はreasoning_effortというパラメータに対応しています。指定しない場合の既定値はhighで、推論そのものを無効にすることはできません。公式は用途を次のように説明しています。
| 設定 | 公式の説明 | 向いている用途 |
|---|---|---|
low | 推論トークンをいくらか使うが、それでも速い | 待ち時間に敏感なエージェント用途、単純なツール呼び出し |
medium | 待ち時間にそこまで敏感でない用途向けに、より深く考える | 複雑なデータ分析、長文脈の推論 |
high(既定) | より多くの推論トークンを使って深く考える | 非常に難しい問題、複雑な数学、多段階の論理 |
xhigh | 推論の深さは最大、その分だけ待ち時間も長い | 応答速度より答えの質が大事な最難関の問題 |
xhighはGrok 4.6以降で使えます。対応していないモデル(Grok 4.5など)にxhighを指定するとhighとして扱われます。また、推論モデルではpresencePenalty・frequencyPenalty・stopが使えず、これらを含むリクエストはエラーになります。既存のコードを移す際に引っかかりやすい点です。
公式ベンチマークで見た4.6からの変化
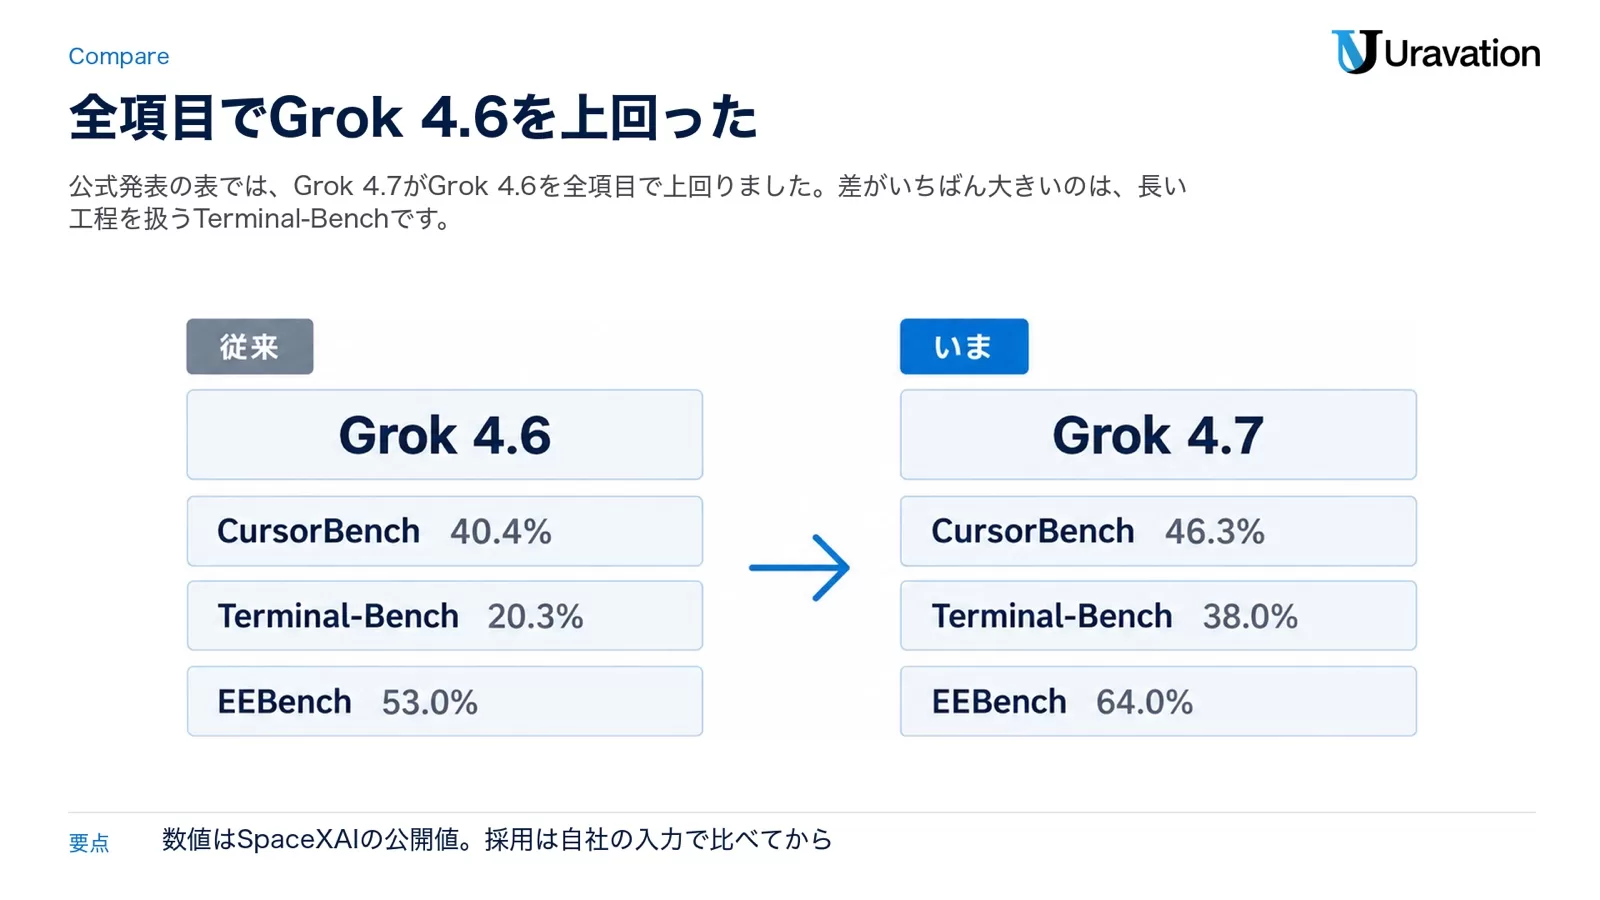
発表ページの表から、Grok 4.7(xHigh)とGrok 4.6(High)の数値を並べます。参考として、同じ表に載っているGPT-5.6 Sol(Max)とFable 5.1(Max)も併記します。数値はすべてSpaceXAIが公開した表の値です。
| ベンチマーク(公式の分類) | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0(ソフトウェア工学) | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1(ソフトウェア工学) | 71.0%(高負荷設定) | 65.2% | 72.7% | 70.0% |
| EEBench(電気工学) | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1(数時間のオフィス作業) | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0(数時間のターミナル作業) | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark(法務) | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional(臨床推論) | 56.7% | 48.5% | 60.5% | 62.1% |
読み取れることは3つです。第一に、Grok 4.7は全項目でGrok 4.6を上回っています。特にTerminal-Bench 4.0は20.3%から38.0%へと差が大きく、公式が強調する「長い工程」の改善と整合します。第二に、コーディングの主要指標であるCursorBench 4.0とTerminal-Bench 4.0では、Fable 5.1が上位です。第三に、EEBenchとHarvey Legal Agent Benchmarkでは、Grok 4.7が比較対象のなかで最も高い値になっています。
公式は別途、専門職の業務を扱うGDPvalのElo値も公開しています。Fable 5.1(max)が1735、Grok 4.7(xhigh)が1695、Grok 4.6(high)が1605、GPT-6 Astra(max)が1542です。「Grok 4.7はGrok 4.6をGDPvalとAA Briefcaseの両方で改善し、他のフロンティアモデルと同等の性能を示す」というのが公式の表現です。
安全性については、SpaceXAIが「これまでで最も強い拒否性能とジェイルブレイク耐性」と説明しています。具体的な数値として、LatchBioのバイオセーフティベンチマークで62.4%と首位、自社のHackerBench v0.3では危険な二重用途プロンプトの通過を3.3%に抑えた、という2点が挙げられています。なお、これらはSpaceXAI自身が公表した値であり、第三者による独立検証の結果ではありません。モデル横断の性能比較はAIモデル性能比較も合わせて確認してください。
どこから使えるか|4つの入口と選び方
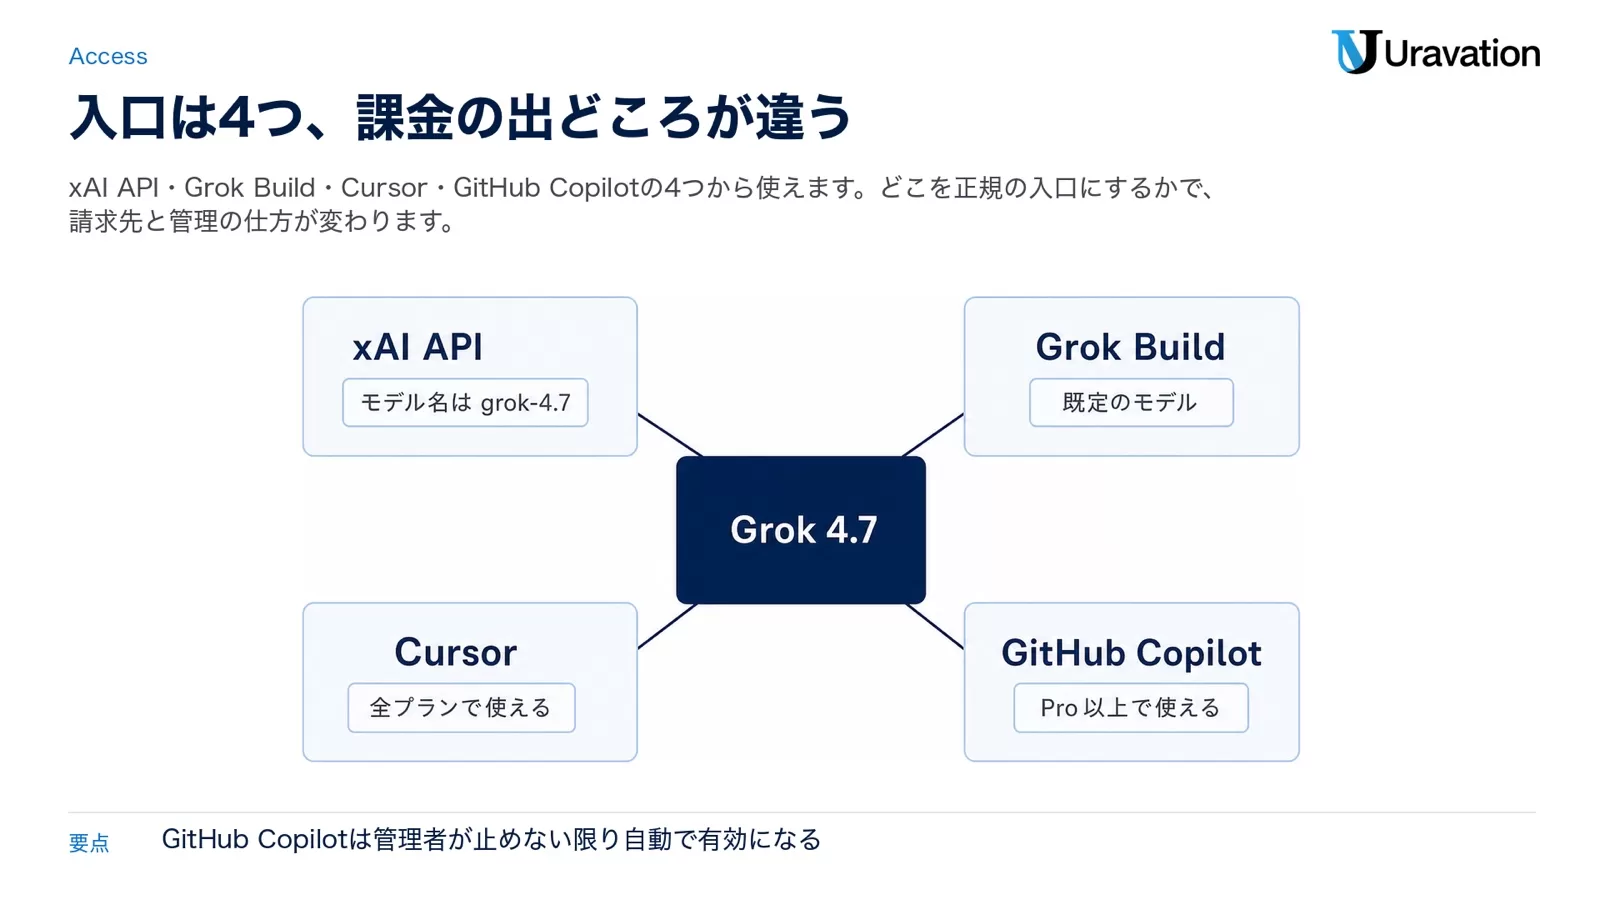
発表ページは提供先を「本日からCursorとGrok Buildで利用可能。加えてGrok API、サードパーティのコーディングハーネス、モデルルーターとクラウドプラットフォームを通じても利用できる」と説明しています。公式ドキュメントの「Where it runs」にはもう少し具体的に書かれており、GitHubの公式チェンジログがGitHub Copilotでの提供を発表しています。法人が選ぶ入口は、実質4つです。
| 入口 | 使い方 | 課金の出どころ |
|---|---|---|
| xAI API | モデル名にgrok-4.7を指定。Responses APIとChat Completionsに対応 | SpaceXAIへの従量課金(コンソールでキーを発行) |
| Grok Build | コーディングエージェントの既定モデル。TUI・ヘッドレス・ACP経由で利用 | Grok Build側(無料枠あり。Fast版は無料枠の対象外) |
| Cursor | 全プランで利用可能と公式ドキュメントに明記 | Cursorのプラン |
| GitHub Copilot | Pro・Pro+・Max・Business・Enterpriseで、モデル選択から指定 | GitHub Copilotの従量課金(提供元の定価で請求) |
このほか、公式ドキュメントはモデルゲートウェイとしてOpenRouter、Vercel、Cloudflareを挙げています。既にこれらのゲートウェイ経由で複数モデルを切り替えて使っている場合は、モデル名の差し替えだけで試せます。
GitHub Copilotでの提供条件
GitHubのチェンジログ(2026年9月21日付)には、法人の管理者が知っておくべき内容が書かれています。
- 対象はCopilot Pro、Pro+、Max、Business、Enterprise。Freeは挙げられていません
- モデル選択で指定できる場所は、Visual Studio Code、Visual Studio、Copilot CLI、GitHub Copilot cloud agent、GitHub Copilotアプリ、JetBrains、Xcode、Eclipse
- 課金は「提供元の定価で、従量課金として請求される」
- ロールアウトは段階的で、すぐに表示されない場合がある
- BusinessとEnterpriseの管理者は、Copilot設定のモデルポリシーでアクセスを管理できる。既定のモデル有効化の下では、管理者が全体の既定をオフにするか、このモデルを明示的に無効化していない限り、新しいモデルは自動的に有効になる
最後の1行が重要です。社内でCopilotを使っている企業では、管理者が何もしなければGrok 4.7が自動的に選べる状態になります。利用するモデルを社内規程で限定している場合は、ロールアウトが届く前にモデルポリシーを確認しておく必要があります。
消費者向けのGrokアプリでの提供は未記載
grok.comやiOS・Androidアプリ、X上のGrokといった消費者向けの入口でGrok 4.7が使えるかどうかは、2026年9月22日時点で公式に確認できていません。発表ページが挙げている提供先はCursor、Grok Build、Grok API、サードパーティのコーディングハーネス、モデルルーターとクラウドプラットフォームで、消費者向けプランへの言及がないためです。月額プランでの利用可否は、公式の発表を待つのが確実です。なお、Grokの契約・解約まわりの手順はGrokの解約方法にまとめてあります。
法人の業務での使いどころ|向く仕事と外したほうがいい仕事
ベンチマークの並びと公式の説明から、Grok 4.7が向く業務と、いまは別の手段を使ったほうがいい業務を分けて考えます。
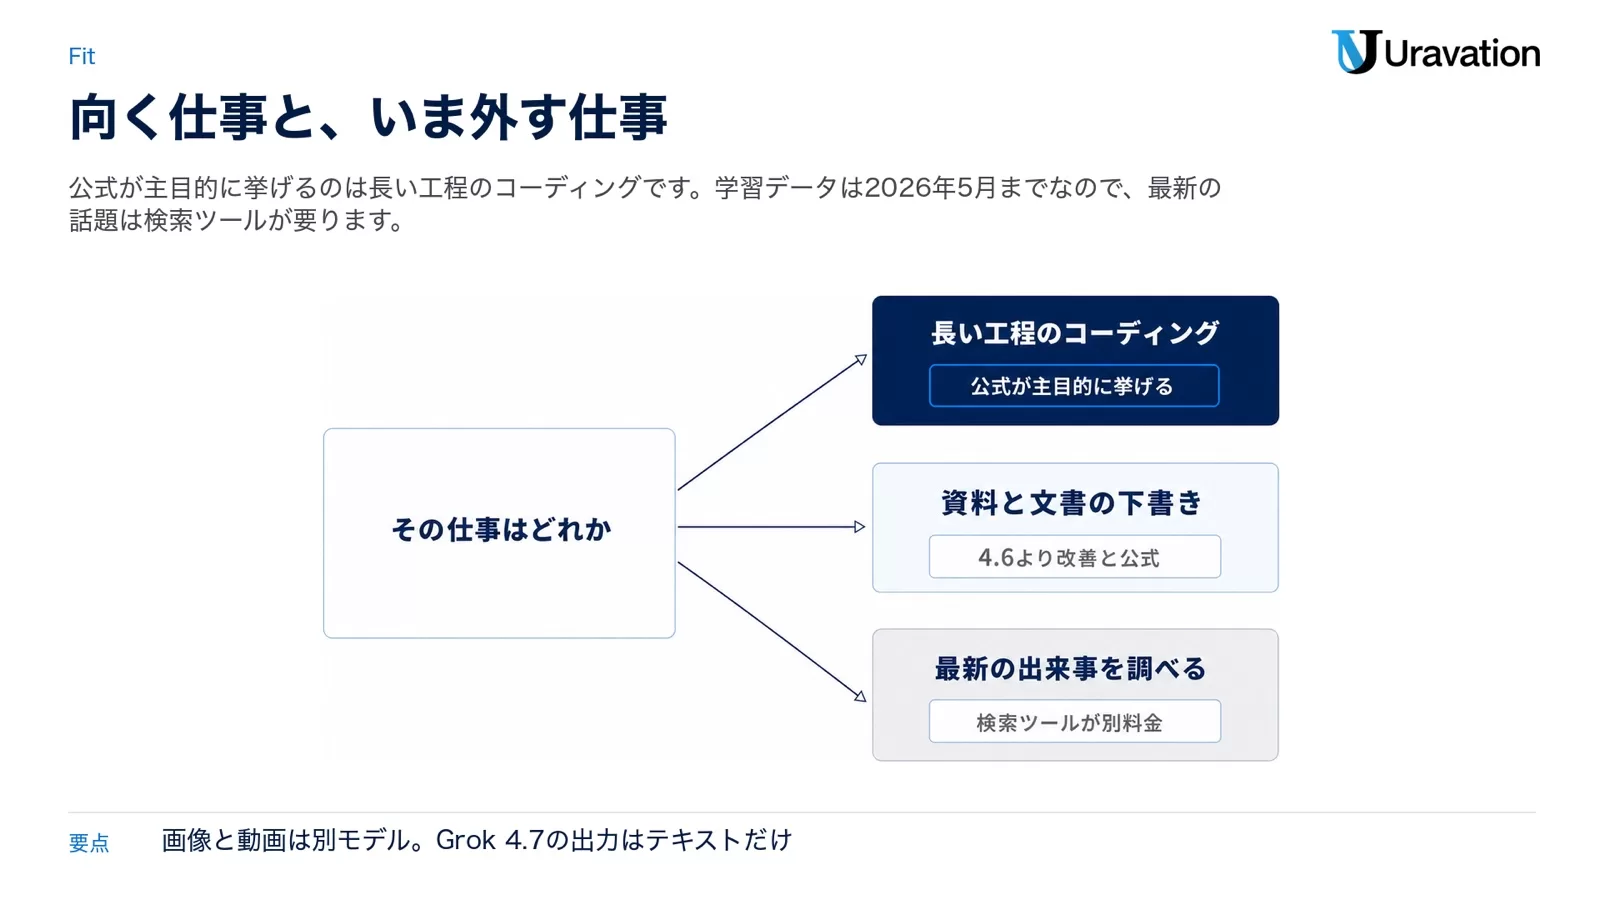
向いている業務
- 長い工程のコーディング:公式が主目的として挙げている領域です。Terminal-Bench 4.0の20.3%から38.0%への改善は、コマンドを何度も打ち直すような作業を任せる前提での改善と読めます
- 資料・文書の下書き:公式は「Grok 4.7は文書やプレゼンテーションの作成がより得意になった」と書いています。GDPvalとAA Briefcaseの両方でGrok 4.6を上回った、というのが根拠です
- 技術仕様の読み込みと整理:EEBench(電気工学)で64.0%と、比較表のなかで最も高い値が出ています。図面や仕様書を扱う製造業の検討材料になります
- 長い資料をまとめて読ませる作業:コンテキスト長500,000トークンを活かせる場面です。ただし20万トークンを超えると料率が上がる点は計算に入れてください
いまは外したほうがいい業務
- 最新の出来事を調べる作業:学習データは2026年5月までです。公式ドキュメントは「Grokは学習データに含まれていない最新の出来事やデータを知らない」と明記し、Web検索・X検索のサーバー側ツールを有効にするよう案内しています。ツールを使えば別料金が発生します
- 画像や動画を作る作業:Grok 4.7の出力はテキストのみです。画像はGrok Imagine Image 2.0、動画はGrok Imagine Video 1.5が公式の推奨で、料金体系も別です(Grokで動画生成する方法を参照)
- 医療・臨床に関わる判断:HealthBench Professionalでは56.7%で、比較表のなかでは下位です。そもそも業務判断に使う領域ではありませんが、ベンチマーク上も優位はありません
もう1つ、法人特有の注意点があります。ベンチマークの数値はすべてSpaceXAIが自社で公開したものだということです。推論設定も各社で揃っていません(Grok 4.7はxHigh、Grok 4.6はHigh、他社はMax)。社内で採用を決めるときは、公開値をそのまま根拠にせず、自社の実際の作業で同じ入力を通して比べるのが確実です。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修4,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
管理者が先に決めること|データの保持・処理場所・通信先
モデルの性能より先に決めるべきなのが、データの扱いです。SpaceXAIの公式セキュリティFAQから、法人が判断すべき点を抜き出します。
学習利用と保存期間
公式FAQは「xAIは、明示的な許可なく顧客のAPI入力・出力で学習することはない」と明記しています。そのうえで、既定の挙動は次のとおりです。
- すべてのAPIリクエストとレスポンスは、不正利用が疑われた場合の監査のため、暗号化された状態で30日サーバーに保存される
- このデータで学習は行われず、30日後に自動削除される
ゼロデータ保持(ZDR)を有効にすると何が止まるか
より厳しいデータ取り扱いが必要なチーム向けに、ゼロデータ保持(ZDR)が用意されています。ただし公式は「ほとんどのお客様には、ZDRの有効化を推奨しません」と警告を出しています。保存されたデータに依存する機能が使えなくなるためです。
| ZDRで使えなくなる機能 | 理由(公式の説明) |
|---|---|
| APIキー単位のリクエストログ | リクエストとレスポンスのログが保持されないため |
| ステートフルなResponses API | 会話履歴をサーバー側に保存できないため(store_messages、previous_response_idが使えない) |
| Files API | アップロードしたファイルがサーバー側に保存されるため |
| Collections API(RAG) | 検索対象の文書を保存する必要があるため |
| Batch API | 処理されるまでリクエストを保存する必要があるため |
| 遅延完了(deferred completions) | 取得されるまで結果を保存する必要があるため |
| 画像・動画出力の保存 | xAI側に出力を保持しないため。画像はbase64のみ、動画は自前のアップロード先が必要 |
| 音声エージェントの会話履歴 | 会話が保持されないため |
ZDRはチーム単位で、APIキーごとに分けることはできません。有効化はチーム管理者がコンソールから自分で行えますが、事前にFilesとCollectionsを削除する必要があります。有効になっているかどうかは、コンソールのチーム設定の「Active」バッジ、チーム選択画面の「ZDR」バッジ、そしてすべてのAPIレスポンスに付くx-zero-data-retentionヘッダーの3か所で確認できます。プログラムから確かめられるのは3つ目です。
処理場所を米国内に固定する場合
既定のエンドポイントhttps://api.x.aiは処理リージョンを保証しません。米国内での処理を求められる場合は、前述のhttps://us.api.x.ai/v1を使います。ただし公式は保証の範囲を明示しており、Files、Collections、サーバー側ツール、自社システムからエンドポイントまでのネットワーク経路は保証の対象外です。また画像生成・動画生成・音声APIは提供されません。
準拠・監査まわり
- SOC 2 Type 2に準拠。NDAを締結した顧客はTrust Centerで認証状況を確認できる
- HIPAA対応(BAA)は、公式のBAA質問票に回答すると担当者から連絡が来る流れ
- 監査ログはコンソールから閲覧可能。イベントID・説明・ユーザーで絞り込み、日付範囲での表示もできる
- APIキーの管理:公式は「パスワードやクレジットカード情報と同じ機密情報として扱う」「チームメンバー間で共有しない」「環境変数か秘密情報管理ツールで保管する」「公開リポジトリにコミットしない」「定期的にローテーションする」と案内しています。SpaceXAIはGitHubのシークレットスキャンと連携しており、漏えいを検知するとキーを無効化してメールで通知します
Grok Buildを社内端末に配る場合の通信先
コーディングエージェントのGrok Buildを社内で配布する場合、情報システム部門が許可すべき通信先が公式の企業導入ページに整理されています。すべてHTTPS(443番ポート)です。
| 区分 | ホスト | 用途・ブロックした場合の影響 |
|---|---|---|
| 必須 | cli-chat-proxy.grok.com | 推論プロキシ、設定 |
| 必須 | auth.x.ai | OAuth2/OIDC認証 |
| 任意 | api.x.ai | 推論プロキシではなくAPIキー認証を使う場合のみ必要 |
| 任意 | code.grok.com | セッション同期・共有。ブロックするとセッションはローカルのみになり、共有リンクが使えない |
| 任意 | assets.grok.com | プロフィール画像・UIアセット。ブロックしてもアバターが表示されないだけ |
| 任意 | x.ai/storage.googleapis.com | シェルスクリプト版インストーラとアプリ内更新でのみ必要。npm配布なら不要 |
企業のOIDCを使う場合は、自社IdPのドメイン(例:login.microsoftonline.com)も許可します。通信はTLS 1.2または1.3で、無効化する設定はありません。TLSインスペクションを行うプロキシを通す場合は、プロキシのCA証明書をOSのトラストストアに入れる必要があります。プロキシのアイドルタイムアウトは10分以上にするよう公式が案内しています(長いモデル応答の途中で切断されるのを避けるため)。
設定の優先順位は5層で、最上位が/etc/grok/requirements.tomlです。ここに書いた設定は下位の層・リモート設定・ユーザー設定から上書きできないため、公式は「コンプライアンス上ゆずれないポリシーにはこの層を使う」と案内しています。MDMやゴールデンイメージでの一括配布を想定した仕組みです。
始め方の手順|APIキーの発行から最初の実行まで
ここから先は、公式ドキュメントに掲載されている操作だけを並べます。自社で動かしていない挙動については書きません。
手順1:APIキーを発行して環境変数に入れる
公式のクイックスタートでは、console.x.aiでアカウントを作成してクレジットを入れ、APIキーのページでキーを発行し、環境変数として設定する流れになっています。
export XAI_API_KEY="your_api_key"プロジェクトの.envファイルに書く場合は次の形です。
XAI_API_KEY=your_api_key手順2:最初のリクエストを送る
公式ドキュメントに載っているcurlの例です。モデル名にgrok-4.7を指定します。
curl https://api.x.ai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -d '{
    "model": "grok-4.7",
    "input": "Fix this function and explain the bug: function median(a){a.sort();return a[a.length/2]}"
}'Pythonの公式SDK(pip install xai-sdk)を使う場合は次の形です。
import os
from xai_sdk import Client
from xai_sdk.chat import user

client = Client(api_key=os.getenv("XAI_API_KEY"))

chat = client.chat.create(model="grok-4.7")
chat.append(user("Fix this function and explain the bug: function median(a){a.sort();return a[a.length/2]}"))

print(chat.sample().content)OpenAIのSDKをそのまま使うこともできます。base_urlを差し替えるだけです。既存のコードを持っている企業には、この経路がいちばん早いはずです。
from openai import OpenAI

client = OpenAI(
    api_key="<YOUR_XAI_API_KEY_HERE>",
    base_url="https://api.x.ai/v1",
)

response = client.responses.create(
    model="grok-4.7",
    input="Fix this function and explain the bug: function median(a){a.sort();return a[a.length/2]}",
)

print(response.output_text)
手順3:推論の強さを用途に合わせる
既定はhighです。待ち時間を抑えたいバッチ処理や単純なツール呼び出しではlowを、答えの質を最優先する場面ではxhighを指定します。以下は公式ドキュメントの例に沿った書き方です。
import os
import httpx
from openai import OpenAI

client = OpenAI(
    base_url="https://api.x.ai/v1",
    api_key=os.getenv("XAI_API_KEY"),
    timeout=httpx.Timeout(3600.0),
)

response = client.responses.create(
    model="grok-4.7",
    reasoning={"effort": "low"},
    input="この仕様書の変更点を箇条書きで3つに整理してください。",
)公式SDKではreasoning_effort="high"のようにチャット作成時に渡します。なお、タイムアウトの値が長く設定されているのは、推論に時間がかかる前提のためです。
手順4:Grok Buildを入れて既定モデルとして使う
コーディングエージェントのGrok Buildは、Grok 4.7が既定モデルです。公式のインストール手順は次のとおりです。
curl -fsSL https://x.ai/cli/install.sh | bash
cd your-project
grokWindowsのPowerShellではirm https://x.ai/cli/install.ps1 | iex、npm配布を使う場合はnpm install -g @xai-official/grokです。初回起動時はブラウザが開いて認証します。ブラウザが使えない環境ではXAI_API_KEYを設定してから起動します。スクリプトから呼ぶヘッドレス実行は次の形です。
grok -p "Explain this codebase"
grok -p "Explain the architecture" --output-format streaming-json
手順5:キャッシュのキーを付けて費用を下げる
公式のモデルページは、「prompt_cache_keyを設定することを強く推奨する」と書いています。理由は、このキーが同じ会話のリクエストを同じサーバーへ振り分けるためです。公式の表現では、設定しないとキャッシュが冷えたサーバーに当たって入力料金を満額払うことが多くなるとされています。Responses APIではprompt_cache_key、Chat Completionsではx-grok-conv-idヘッダーが対応する指定です。キャッシュ入力の単価は100万トークンあたり$0.50なので、長い会話を何度も回す用途では差が大きく出ます。
加えて、長いエージェントループではコンテキスト圧縮(context compaction)の利用が案内されています。また、Responses APIではgrok-4.7がreasoning.encrypted_contentを常に返します。次のリクエストのinputにそのまま戻せば、会話履歴を自分で管理している場合でも推論の続きが保たれます。
【要注意】請求と品質でつまずく失敗パターン4つ
公式ドキュメントの記載から、法人利用で起きやすい形に直して4つ挙げます。
失敗1:長い資料を丸ごと投げて、請求が跳ねる
❌ 500,000トークン入るからと、議事録や仕様書をまとめて1リクエストに詰め込む
⭕ プロンプトが20万トークンを超えないところで区切る。超える設計にするなら、料率が2倍側に切り替わる前提で見積もる
公式は「プロンプトがしきい値に達した時点で、そのリクエストの全トークンに長文脈の料率が適用される」と書いています。20万トークンを1トークンでも超えたら、そのリクエスト全体が入力$4・出力$12になります。「広いコンテキストを使い切る」設計は、費用面では逆効果になりがちです。
失敗2:キャッシュのキーを付けずにマルチターンを回す
❌ 会話を続けるアプリでprompt_cache_keyを指定しないまま本番に出す
⭕ 会話ごとに固定のキーを付ける(Chat Completionsならx-grok-conv-idヘッダー)
公式が「強く推奨する」と書いている項目です。キャッシュ入力は$0.50、通常の入力は$2.00。同じ前提文を毎回送る設計では、この差がそのまま積み上がります。
失敗3:推論の強さを既定のまま大量処理に使う
❌ 分類や抽出のようなバッチ処理を、既定のhighのまま流す
⭕ 用途ごとにlow/medium/high/xhighを決めてから流す
推論トークンは出力として課金されます。公式はlowを「待ち時間に敏感なエージェント用途と単純なツール呼び出し」向けとしています。単純作業にhighを使い続けると、品質は変わらないまま費用と待ち時間だけが増えます。なお、推論を完全に切ることはできません。
失敗4:ZDRを「念のため」有効にして機能が止まる
❌ セキュリティ要件を詰める前に、とりあえずZDRを有効化する
⭕ 既定の30日保持で社内規程を満たせるかを先に確認し、満たせない場合だけZDRにする
公式自身が「ほとんどのお客様には推奨しない」と書いています。ZDRを有効にすると、ステートフルなResponses API、Files、Collections、Batch API、遅延完了、画像・動画出力の保存が止まります。設計が固まってから切り替えると、作り直しになる範囲が広がります。ZDRはチーム全体にかかり、APIキー単位では分けられない点も設計に影響します。
Uravationならこう判断する|1業務で試してから広げる
新しいモデルが出るたびに全社で切り替えを検討していると、判断のコストのほうが高くつきます。Grok 4.7のように「前世代と同じ単価で性能が上がった」型の更新は、判断の手順を決めておけば短時間で済みます。私たちが法人のご相談で使っている順番は次の4段階です。
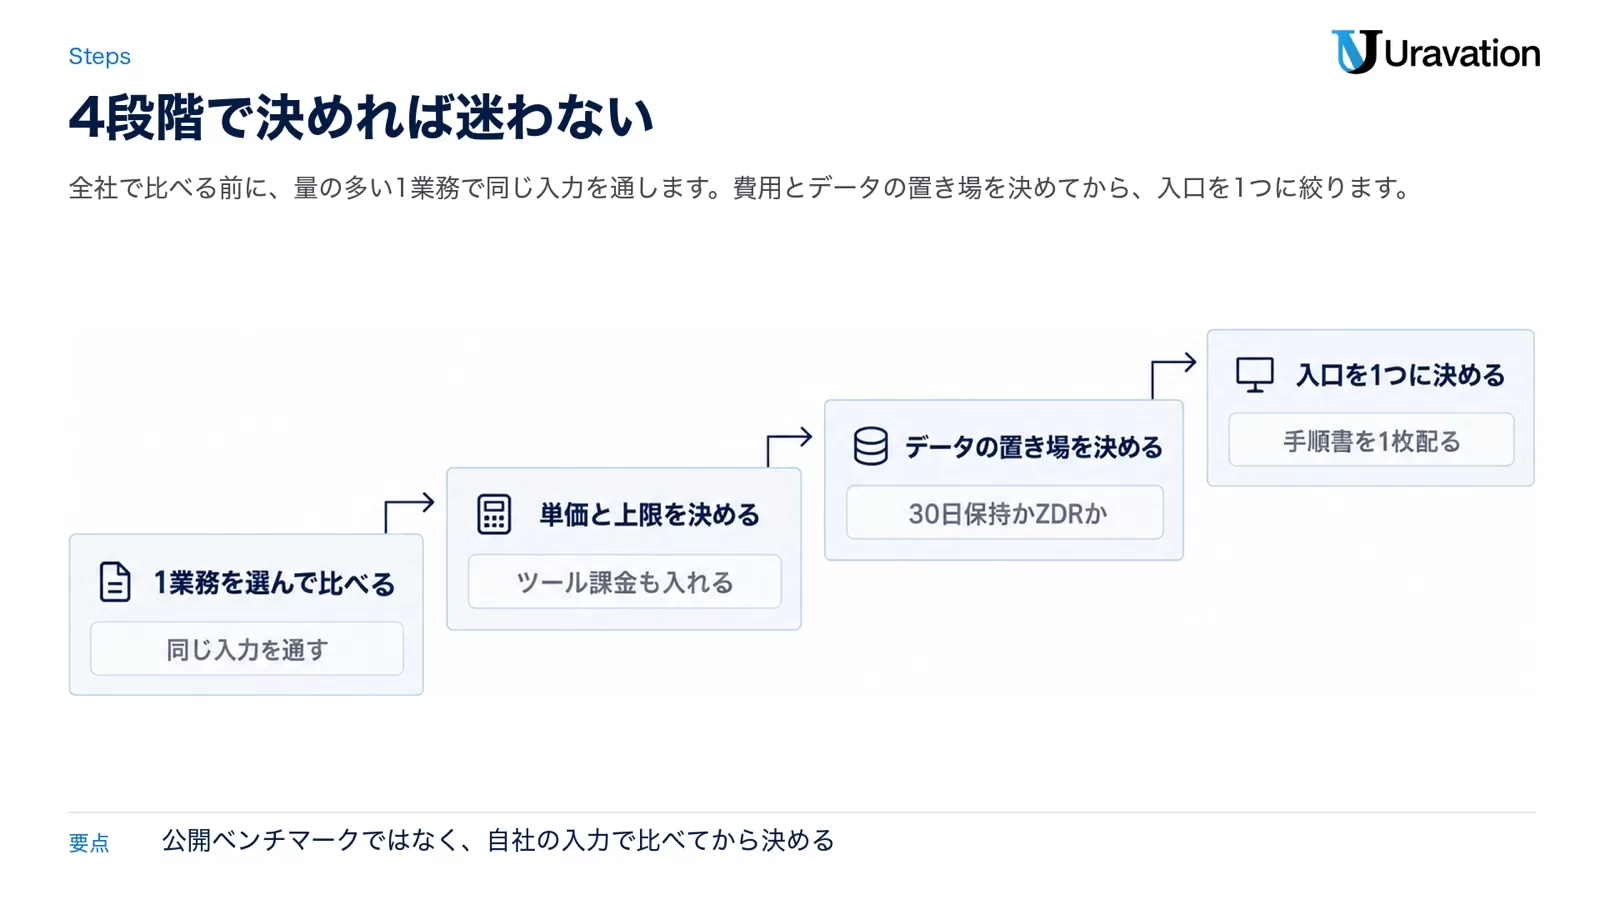
段階1:いま使っている1業務を選んで、同じ入力で比べる
全社比較ではなく、いちばん量の多い1業務に絞ります。すでにAI支援を入れているコードレビュー、仕様書の要約、問い合わせ対応の下書きなどが候補です。同じ入力を現行モデルとGrok 4.7に通し、答えの質・所要時間・かかったトークン数の3つを記録します。公開ベンチマークではなく自社の入力で比べるのは、SpaceXAIの公開値が自社の作業と一致する保証がないからです。
段階2:単価と上限を先に決める
入力$2・出力$6を基準に、その業務の月間トークン数を掛けて上限額を決めます。このときサーバー側ツール(Web検索$5/1,000回など)と、20万トークン超で料率が変わる点を必ず織り込みます。X検索を使う設計なら、2026年9月21日からの新しい課金方式(取得した投稿1,000件あたり$5、プロフィール1,000件あたり$10)で計算します。
段階3:データの置き場所を決める
既定の30日保持で足りるのか、ZDRが要るのか、米国内処理の保証が要るのかを、情報システム部門と法務で先に決めます。ZDRを選ぶとFiles・Collections・Batch APIが使えなくなるため、この判断はアーキテクチャに直結します。社内規程に「保存期間」と「処理場所」の記述がない場合は、ここで追記するのが現実的です。
段階4:入口を1つに決めて、手順を残す
API・Grok Build・Cursor・GitHub Copilotのどれを正規の入口にするかを決め、課金の出どころを一本化します。特にGitHub Copilotは、管理者が何もしなければ新しいモデルが自動的に有効になる仕様です。社内で使うモデルを限定している企業は、モデルポリシーの確認を手順に入れてください。そのうえで、使い方の手順書を1枚だけ作って配ります。
Grok APIそのものの使い方や法人での運用設計は、Grok API完全ガイドに詳しくまとめています。
よくある質問
Grok 4.7は無料で使えますか?
xAI APIは従量課金で、無料ではありません。Grok Buildには無料枠があり、Grok 4.7が既定モデルですが、速度が2倍の「Grok 4.7 Fast」は無料枠に含まれないと公式ドキュメントに明記されています。CursorとGitHub Copilotでは、それぞれのプランの範囲で利用します(Cursorは全プラン、GitHub CopilotはPro・Pro+・Max・Business・Enterprise)。消費者向けのGrokアプリや無料プランで使えるかは、2026年9月22日時点で公式に確認できていません。
Grok 4.6から乗り換えるべきですか?
API単価は同じ(入力$2・出力$6)で、公式は「同じ価格・同じ速度で提供する」と書いています。公開されたベンチマークでは全項目でGrok 4.6を上回っており、特にTerminal-Bench 4.0は20.3%から38.0%へ変わっています。切り替え自体はモデル名をgrok-4.7に変えるだけです。ただしxhighを使うと推論トークンが増え、出力として課金されるため、請求額は設定次第で変わります。
入力した内容は学習に使われますか?
公式のセキュリティFAQは「xAIは、明示的な許可なく顧客のAPI入力・出力で学習することはない」と明記しています。既定では、不正利用が疑われた場合の監査のためにリクエストとレスポンスが暗号化された状態で30日保存され、その後自動削除されます。保存自体を避けたい場合は、チーム単位でゼロデータ保持(ZDR)を有効にできますが、Files・Collections・Batch APIなど保存に依存する機能が使えなくなります。
GPT-5.6 SolやFable 5.1とどちらがよいですか?
公式発表の比較表では、CursorBench 4.0(46.3%対51.8%)とTerminal-Bench 4.0(38.0%対57.9%)でFable 5.1が上、DeepSWE v1.1(71.0%対72.7%)とHealthBench Professional(56.7%対60.5%)でGPT-5.6 Solが上です。一方、EEBench(64.0%)とHarvey Legal Agent Benchmark(19.6%)ではGrok 4.7が最も高い値です。単価は入力でGPT-5.6 Solの半分、Fable 5.1の5分の1です。これらはSpaceXAIが公開した値なので、採用判断は自社の作業で比べたうえで行ってください。
社内端末にGrok Buildを入れるとき、何を許可すればよいですか?
公式の企業導入ページによると、必須の通信先は推論プロキシと設定用のcli-chat-proxy.grok.com、認証用のauth.x.aiの2つです(いずれもHTTPS・443番ポート)。企業のOIDCを使う場合は自社IdPのドメインも追加します。code.grok.com(セッション同期)、assets.grok.com(UIアセット)などはブロックしても中核機能に影響しません。コンプライアンス上ゆずれない設定は、上書きできない最上位の層/etc/grok/requirements.tomlに置くのが公式の推奨です。
まとめ|2026年9月22日時点で押さえる5点
- Grok 4.7は2026年9月21日(米国時間)公開。コーディングと知識労働向けの最上位モデルで、公式は「Grok 4.6と同じ価格・同じ速度」と説明しています
- API料金は100万トークンあたり入力$2・出力$6から。プロンプトが20万トークン以上になると、そのリクエスト全体が入力$4・出力$12に切り替わります
- 仕様はコンテキスト500,000トークン、学習データは2026年5月まで、入力はテキストと画像。推論の強さは4段階で既定は
high、無効にはできません - 入口は4つ:xAI API、Grok Build(既定モデル)、Cursor(全プラン)、GitHub Copilot(Pro以上)。速度2倍の「Fast」版はCursorとGrok Build限定で、公開APIでは使えません
- 管理者が先に決めるのは3つ:データの保持(既定30日かZDRか)、処理場所(標準か米国内専用エンドポイントか)、Grok Buildを配るなら許可する通信先
単価が据え置きで性能が上がった更新なので、すでにSpaceXAIのAPIを使っている企業は、モデル名の差し替えだけで比較を始められます。新規に検討する企業は、料金より先にデータの取り扱いを社内で確定させるほうが、結果的に早く進みます。
この記事を書いた人
佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。
100社以上の企業向けAI研修・導入支援。著書『AIエージェント仕事術』『Claude仕事術』(SBクリエイティブ・シリーズ累計約6万部)。
SBクリエイティブ「ビジネス+IT」ほかで生成AI連載を執筆(NewsPicks最大1,125ピックス)。
次の一歩
- いまの使用量を単価表に当てはめる:直近1か月の入力・出力トークン数を出し、この記事の料金表で計算し直してください。20万トークンを超えるリクエストがどれくらいあるかも合わせて数えると、切り替えの効果がはっきりします
- データの取り扱いを社内で確定させる:保存期間・処理場所・利用できるモデルの3点を文書にしておくと、新しいモデルが出るたびの判断が短くなります。社内規程の整備は法人向けAI研修でも扱っています
- 自社の業務で比較する場を作る:同じ入力を複数モデルに通して比べる仕組みは、一度作ると次のモデル更新でも使えます。設計のご相談はお問い合わせから受け付けています
参考・出典
- SpaceXAI「Introducing Grok 4.7」(2026年9月21日・発表内容、単価とベンチマークの表、提供先)(参照日:2026年9月22日)
- SpaceXAI公式ドキュメント「Grok 4.7」(仕様表、Fast版の位置づけ、提供場所、prompt_cache_key)(参照日:2026年9月22日)
- SpaceXAI公式ドキュメント「Pricing」(トークン単価、Fast版の料率、米国リージョン、ツール課金、保存料金)(参照日:2026年9月22日)
- SpaceXAI公式ドキュメント「Models」(モデル一覧、用途別の推奨、エイリアス規約、画像入力の制限)(参照日:2026年9月22日)
- SpaceXAI公式ドキュメント「Release Notes」(2026年9月21日・grok-4.7の提供開始と詳細)(参照日:2026年9月22日)
- SpaceXAI公式ドキュメント「Reasoning」(reasoning_effortの4段階と制約)(参照日:2026年9月22日)
- SpaceXAI公式ドキュメント「Security」(学習利用、30日保持、ZDR、米国内処理、SOC 2、監査ログ)(参照日:2026年9月22日)
- SpaceXAI公式ドキュメント「Grok Build」(インストール、起動、ヘッドレス実行、設定ファイル)(参照日:2026年9月22日)
- SpaceXAI公式ドキュメント「Enterprise Deployments」(通信先、TLS、設定の5層)(参照日:2026年9月22日)
- SpaceXAI公式ドキュメント「Quickstart」(APIキーの発行、最初のリクエスト)(参照日:2026年9月22日)
- GitHub Changelog「Grok 4.7 is now available in GitHub Copilot」(2026年9月21日・対象プラン、利用できる場所、管理者のモデルポリシー)(参照日:2026年9月22日)
この記事の内容を社内で使うなら
AIエージェントの基礎から経営としての導入判断、実演の再現手順まで。講演完全版のWeb資料を、ご登録いただいた方に閲覧URLでお送りします。
- 100社以上・研修4,000名以上の実績
- 初回30分無料・即日返信
資料は受け取りページからすぐにご覧いただけます。