2026年9月30日時点で、中国 Z.ai(旧 Zhipu AI)のオープンウェイトモデル GLM-5.3 について、Anthropic は2026年9月29日、攻撃コードを端から端まで自律的に組み立てる能力を確かめたと発表しました。Chrome などに使われる V8 エンジンの既知の脆弱性を対象にした評価では、410回の試行のうち50回で攻撃コードを完成させ、同社の Claude Mythos Preview(56回)とほぼ並びました。モデルの重みは誰でも入手できるため、安全策を外した改変版が公開から数日で出回った、とも報告しています。企業がまず見直すのは、更新の適用の速さと、自社で動かすモデルの安全策を誰が持つか、の2点です。
この記事の要点(2026年9月30日時点)
- Anthropic の検証(2026年9月29日掲載)では、GLM-5.3 は既知の脆弱性から攻撃コードを完成させる試験で410回中50回成功。Claude Mythos Preview は同じ試験で56回でした
- 同社の模擬試験では、GLM-5.3 の安全策は単純な手法で64%〜100%の割合で回避できたと報告されています。安全策を外した改変版では、有害な依頼を断る割合が90%超から2%〜12%に下がりました
- 米国立標準技術研究所(NIST)の CAISI は2026年9月17日、GLM-5.3 を「これまでに公開された中で最もサイバー能力の高いオープンウェイトモデル」と評価。米国の最先端モデルからは約4か月遅れとしています
- Anthropic は、同じ能力が守る側にも役立つと書いています。試験で見つけたブラウザの脆弱性は保守者に報告済みで、ほかの報告も確認のうえ順次伝えるとしています
- Z.ai 側の見解は、2026年9月30日時点で公式に確認できていません
対象読者:情報システム・セキュリティの担当者、AI の社内ルールを持つ管理部門、オープンウェイトモデルの自社運用を検討している開発責任者。読み終えたらできること:今回の発表で確かめられたことと、確かめられていないことを社内で説明し、自社で先に確かめる5つの項目を書き出せます。
最終更新:2026年9月30日。この記事は、Anthropic の発表ページ(2026年9月29日掲載)と、NIST の CAISI の評価ページ(2026年9月17日掲載)を読み、書かれている内容を整理したものです。攻撃の手順や、安全策を外す方法には触れません。扱うのは「何が確かめられたか」と「会社は何を備えるか」です。後半の「確かめる5つ」は当社の見方です。GLM-5.3 そのものの料金とライセンスは GLM-5.3 のオープンウェイト公開の解説 にまとめています。
Anthropicが発表した内容|GLM-5.3の検証結果
発表は、Anthropic の Frontier Red Team(同社のモデルや他社のモデルの危険な能力を調べる部門)によるものです。題名は「GLM-5.3 and the spread of advanced cyber capabilities」で、2026年9月29日付で掲載されました。
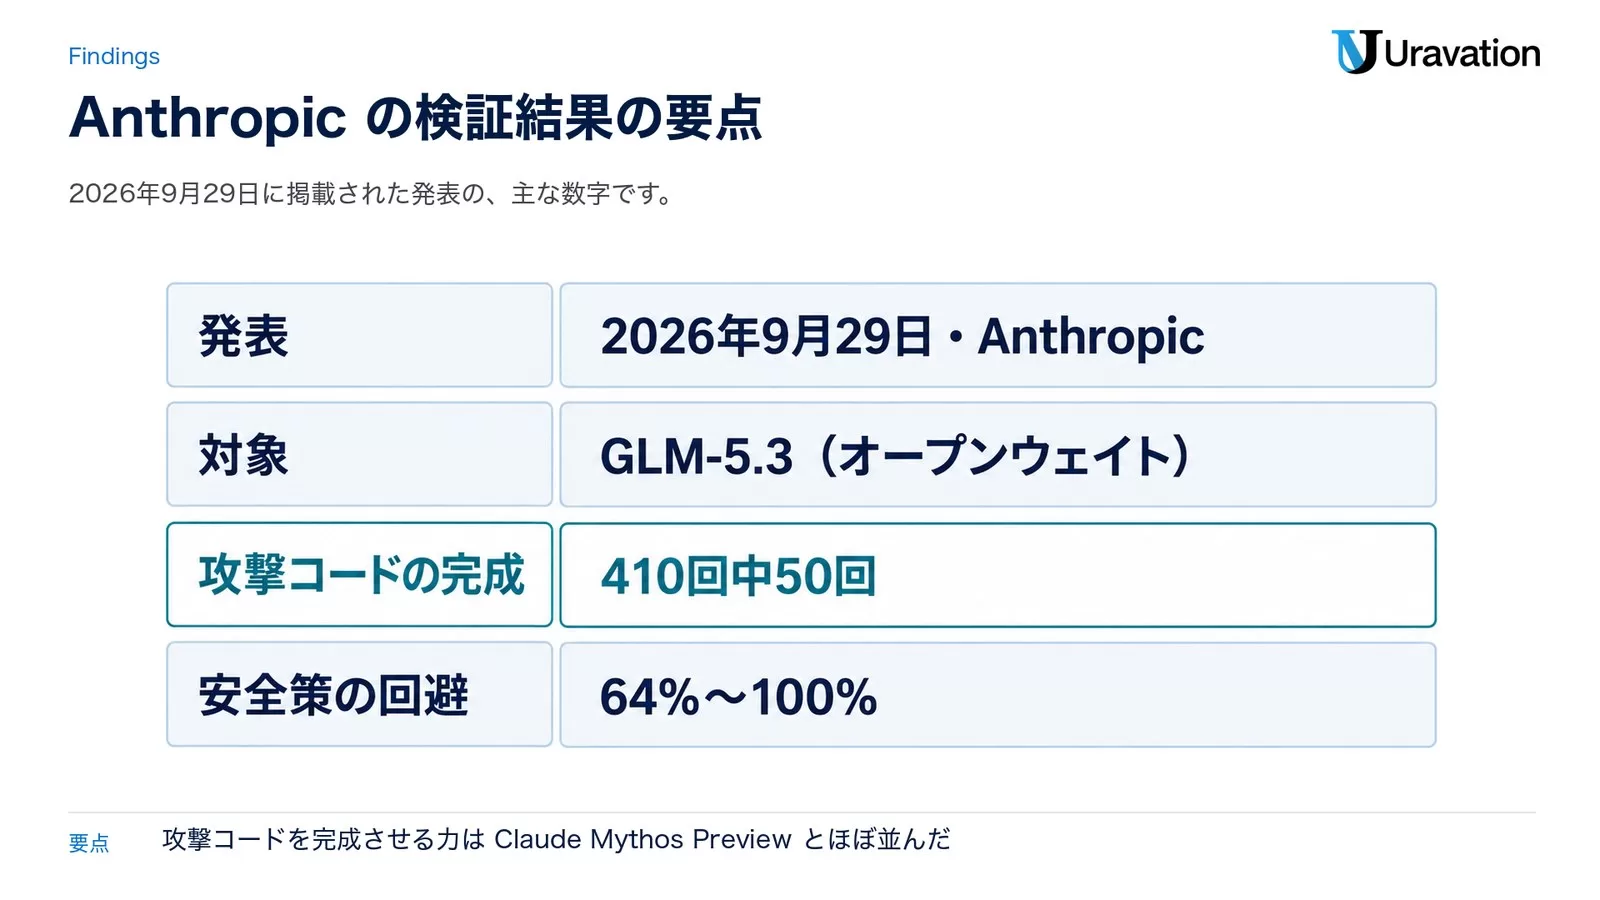
| 項目 | 内容(Anthropic の発表の記載) |
|---|---|
| 掲載日 | 2026年9月29日 |
| 対象のモデル | GLM-5.3(Z.ai。旧 Zhipu AI) |
| 確かめたこと | 攻撃コードを端から端まで自律的に組み立てる能力と、安全策の破られやすさ |
| 攻撃コードの完成 | V8 エンジンの既知の脆弱性を使う試験で410回中50回(Claude Mythos Preview は56回) |
| 安全策の回避 | 模擬試験で、単純な手法により64%〜100%の割合で回避 |
| 改変版の拒否率 | 有害な依頼を断る割合が、90%超から2つの試験で約3%と約2%、もう1つで12%に低下 |
| 安全策のある Claude | 同じ手法では、試験した有害な作業を実行させられなかった |
Anthropic は5か月前に Claude Mythos Preview を発表した時、この種の能力はいずれ多くのモデルに広がると見ていた、と書いています。そのため Mythos Preview は、審査を通った防御側の組織に限って提供されました。今回の発表は、「そのモデルが来た」という報告です。
何が確かめられたのか|攻撃コードを自律的に完成させる能力
検証は、外部とつながらない隔離された環境で、試験用に用意した対象だけを相手に行われています。Anthropic が力点を置いたのは、脆弱性を見つける力よりも、見つかった脆弱性を実際に動く攻撃コードに仕上げる力です。Mythos Preview がそれ以前の Claude から大きく伸びたのがこの部分だったためです。
結果は2種類の試験で示されています。
| 試験 | GLM-5.3 | Claude Mythos Preview | それ以前のモデル |
|---|---|---|---|
| ExploitBench(V8 の既知の脆弱性から攻撃コードを完成させる) | 410回中50回 | 410回中56回 | 発表の本文に数値の記載なし |
| Anthropic 社内の試験(オープンソースの脆弱性を見つけて制御を奪う・100問) | 4% | 6% | Claude Opus 4.6 と GLM-5.2 は0 |
2つ目の試験で GLM-5.3 は Mythos Preview を下回っています。ただ Anthropic は、前の世代のモデルが1問も成功しなかったことを挙げ、意味のある一線を明らかに越えた、と評価しています。
人の専門家が GLM-5.3 を使う形の試験も行われました。研究者は短い時間だけ関わり、あとはモデルに作業を任せています。この試験で GLM-5.3 は、広く使われているソフトウェアから、それまで知られていなかった脆弱性を複数見つけ、組み合わせて動く攻撃コードにしました。Anthropic は、見つけた脆弱性を保守者に報告済みで、他の報告も確認のうえ順次伝えるとしています。
安全策はどこまで効くのか|64%〜100%で回避
GLM-5.3 には、明らかに有害な依頼を断る安全策が組み込まれています。Anthropic の報告は、その安全策が簡単に回避されるか、取り除かれる、という内容です。
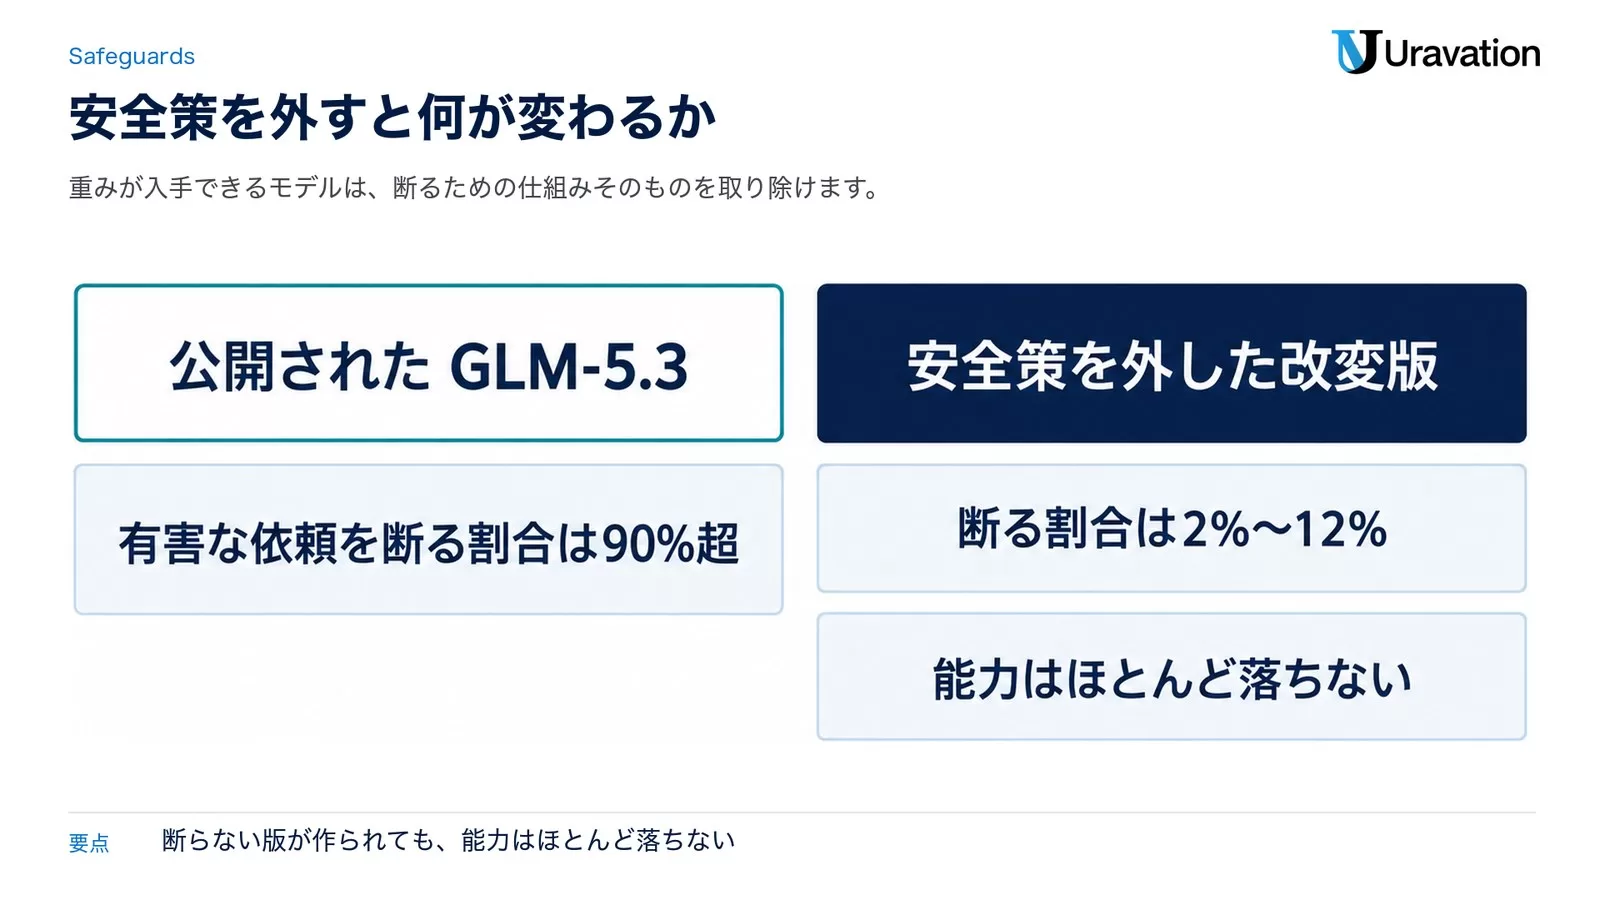
模擬の環境で、重要なシステムを攻撃するよう露骨に依頼する試験では、手を加えない GLM-5.3 はすべて断りました。ところが、単純な手法を使うと結果が変わり、手法によって64%、92%、100%の割合でモデルが依頼に応じたと報告されています。同じ手法は、安全策のある Claude では通らなかった、というのが Anthropic の説明です。
もっとも影響が大きいのは、重みが入手できることそのものです。重みを手元に置ける人は、安全策を外す加工をモデルに施せます。Anthropic によると、加工の後も能力はほとんど落ちず、科学の一般的な能力を測る試験では加工前と同じ成績でした。こうした改変版は、GLM-5.3 の公開から数日のうちに複数の開発者が公開しています。
この記事では、回避の手法と加工のやり方は書きません。読者の判断に必要なのは、「断るように作られたモデルでも、重みが出回れば断らない版が作られる」という事実です。
米政府機関CAISIの評価|最先端から約4か月遅れ
Anthropic の発表の12日前、NIST の Center for AI Standards and Innovation(CAISI)が GLM-5.3 のサイバー能力の評価を出しています。Anthropic は、能力についての自社の結果は CAISI とおおむね一致すると書いています。
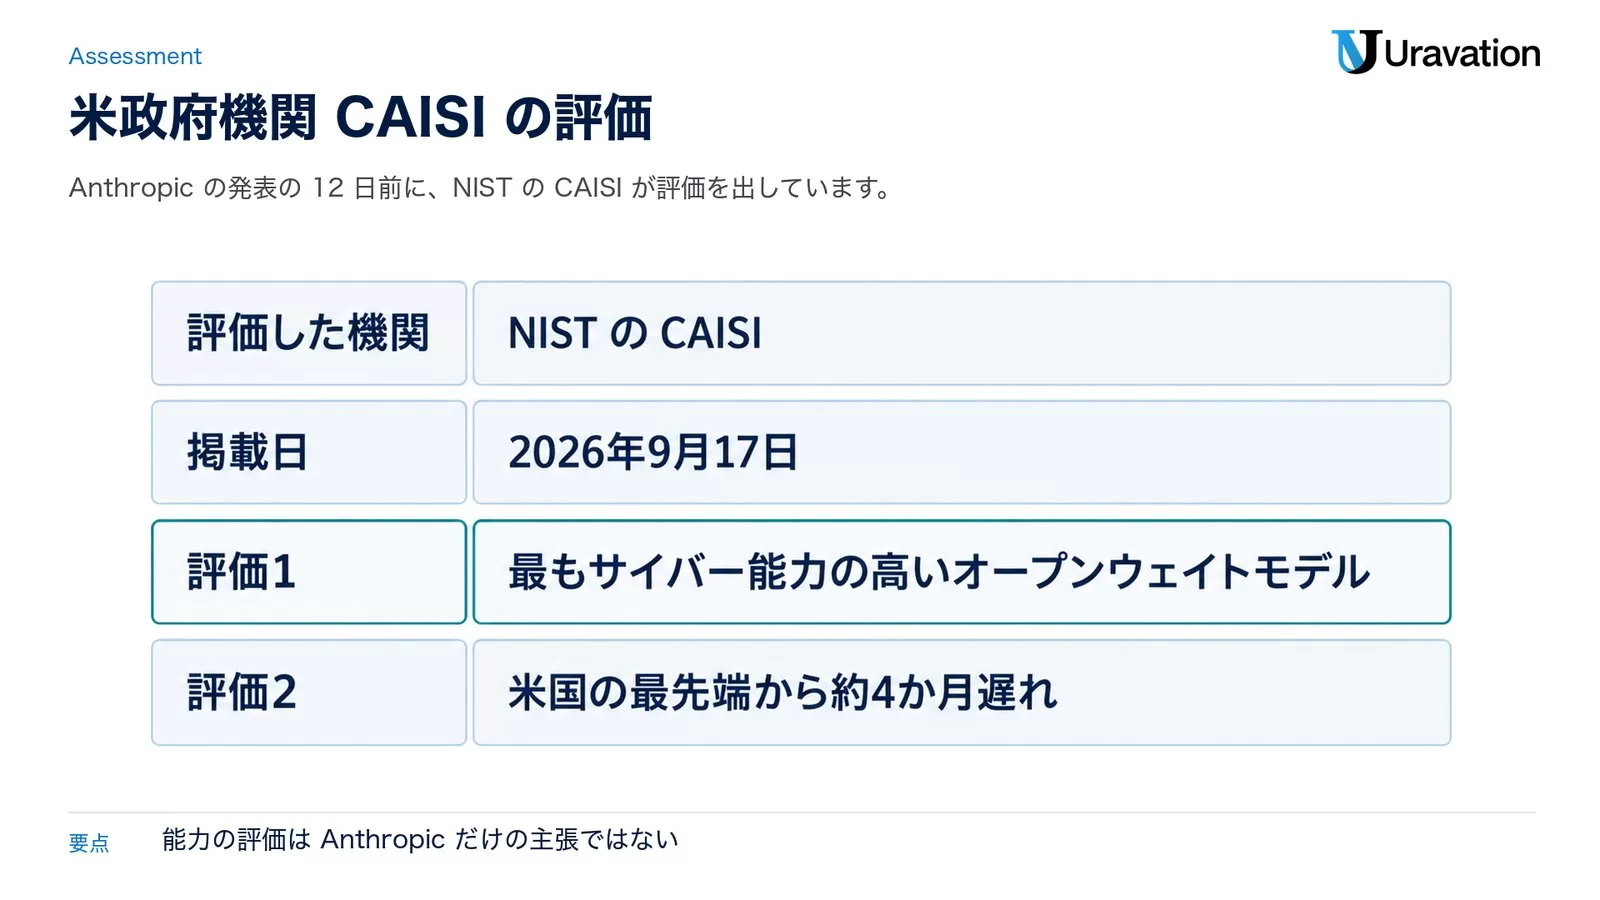
CAISI の要点は2つです。GLM-5.3 は、これまでに公開されたオープンウェイトモデルの中でサイバー能力がもっとも高い。一方で、米国の最先端モデルと比べると明らかに低く、CAISI の複数の試験をまとめた指標で約4か月遅れている、というものです。
| 試験(CAISI) | GLM-5.3 | 米国の最先端 | 中国のそれまでの最高 |
|---|---|---|---|
| SEC-Bench Pro(183問) | 40.4% | 90.2% | 27.3% |
| ExploitBench(41問・16点満点の平均) | 61.1% | 100.0% | 32.2% |
| ExploitGym(502問) | 9.4% | 44.4% | 2.6% |
| CAISI OSS-Fuzz(297問) | 7.7% | 23.2% | 2.4% |
出典:CAISI’s Assessment of Z.ai’s GLM-5.3 Cyber Capabilities(NIST・2026年9月17日)。
読む時に気をつける点があります。CAISI の比較では、米国のモデルは安全策を切った状態で試験され、「米国の最先端」には審査を通った利用者にしか提供されていないモデルも含まれます。Anthropic はここを強調しています。攻撃者は米国のモデルのそうした版を簡単には使えませんが、GLM-5.3 は誰でもダウンロードできます。能力の高さでは米国のモデルが上でも、手に入りやすさでは逆になる、という指摘です。
なぜオープンウェイトだと話が変わるのか
API で提供されるモデルは、提供する会社のサーバーで動きます。利用者が送れるのは入力だけで、安全策は会社の側にあり、不正な使い方が見つかれば利用を止められます。オープンウェイトモデルは、重みそのものを利用者が持ちます。動かす場所も、安全策を残すかどうかも、持っている人が決められます。
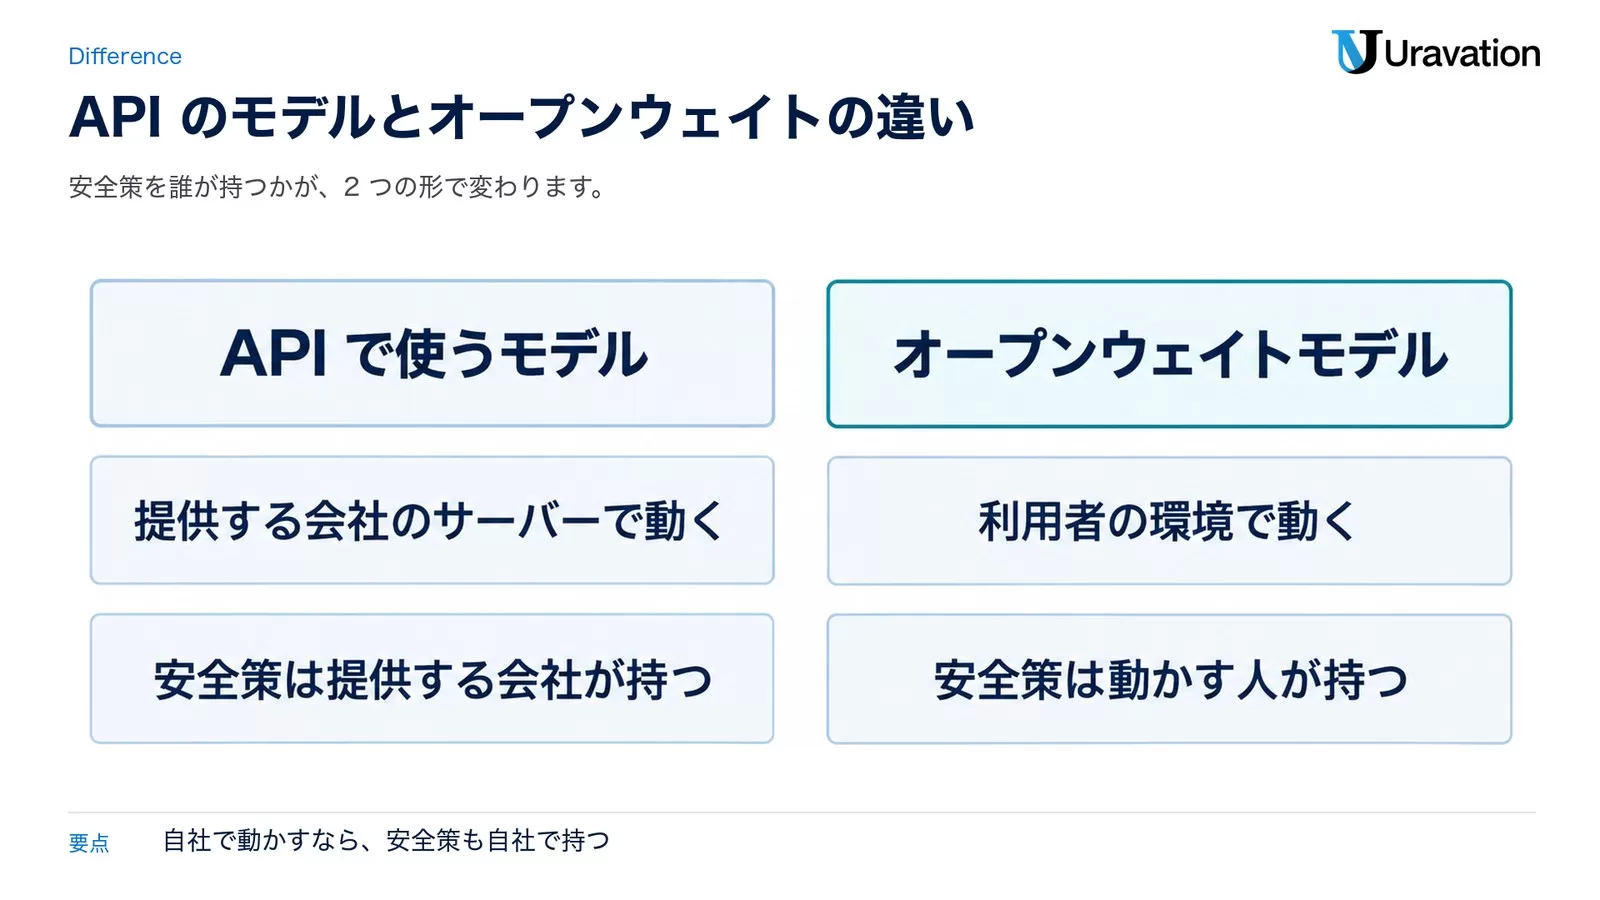
| 項目 | API で使うモデル | オープンウェイトモデル |
|---|---|---|
| モデルが動く場所 | 提供する会社のサーバー | 利用者の環境 |
| 安全策の持ち主 | 提供する会社 | 動かす人 |
| 不正利用への対処 | 提供する会社が利用を止められる | 公開後は止める手段がない |
| 改変 | 重みには触れられない | 安全策を外す加工ができる |
これは、オープンウェイトの利点の裏返しでもあります。データを外に出さずに動かせる、自社の用途に合わせて調整できる、特定の会社に依存しない、という理由で自社運用を選ぶ企業もあります。オープンウェイトをめぐる規制の議論と、AI 各社の立場の違いは オープンウェイトAI規制論争の解説 で整理しています。
当社の見方として、発表を読む時の前提も書いておきます。Anthropic は重みを公開しないモデルを主力にする会社で、オープンウェイトへの規制に慎重な姿勢を取る側とは立場が違います。今回の発表も、各国政府に十分に能力の高いモデルの安全性試験を求め、守る側への最先端モデルの提供を広げるという同社の主張とつながっています。一方で、能力の評価そのものは政府機関の CAISI が先に出しており、Anthropic だけの主張ではありません。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修4,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
企業への影響|攻める側の道具が増え、守る側にも使える
Anthropic は、GLM-5.3 によって、悪意のある者が脆弱性を見つけて悪用する能力を、実質的な制限なしに手にする可能性が高いと評価しています。国家が関わる攻撃者もそうでない攻撃者も、この種のモデルを実害のために使う可能性が高い、とも書いています。
会社の側から見ると、変わるのは攻撃の種類よりも速さと数です。脆弱性が公表されてから、それを突く攻撃コードが出回るまでの時間が縮みます。修正が出ているのに適用していない機器やソフトウェアが、これまでより早く狙われる前提に立つ必要があります。AI を使った攻撃の全体像と、専任の部門がない会社の備えは AIサイバー攻撃の動向と防御の解説 を見てください。
同じ能力は守る側にも使えます。Anthropic は、守る側は手に入る中で最良の道具を使うべきだとし、審査を通った組織に最先端のモデルを提供する取り組みを広げるとしています。同社の Project Glasswing では、防御側の組織が10,000件を超える脆弱性を見つけたと報告されています。取り組みの中身は Project Glasswing の解説 にあります。
自社で先に確かめる5つ
ここからは当社の見方です。今回の発表を受けて、専任のセキュリティ部門がない会社でも先に確かめておける項目を5つ挙げます。
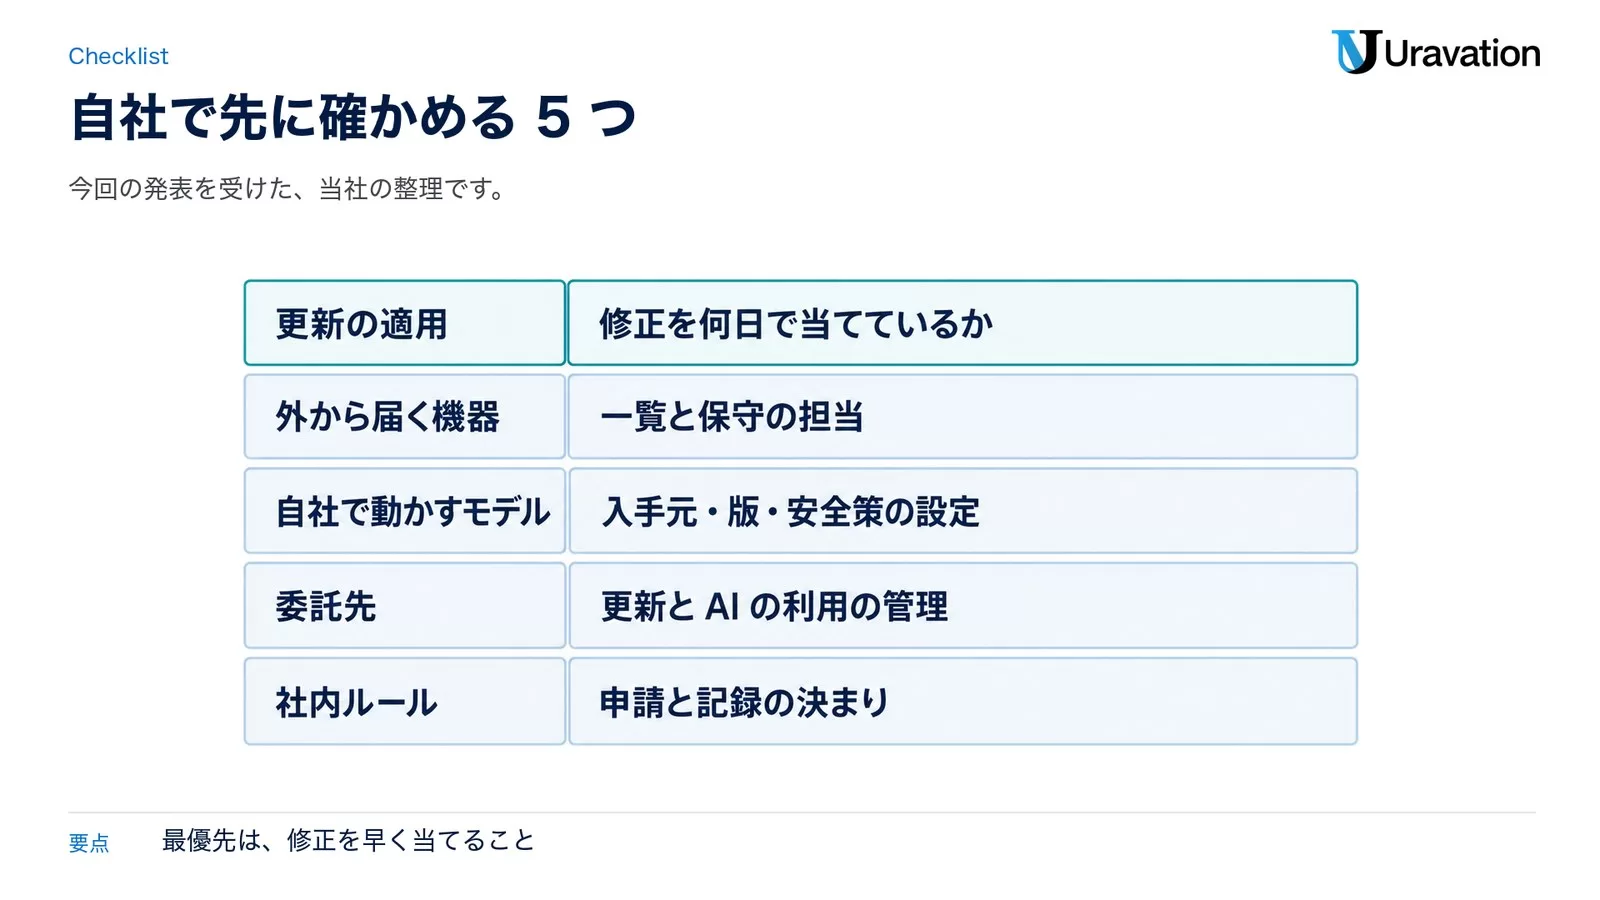
| 項目 | 確かめること |
|---|---|
| 1. 更新の適用 | ブラウザ・OS・ネットワーク機器の修正が、公表から何日で適用されているか。自動更新が止まっている端末がないか |
| 2. 外から届く機器 | VPN 機器、リモート接続、公開しているサーバーの一覧と、それぞれの保守の担当 |
| 3. 自社で動かすモデル | オープンウェイトモデルを社内で動かしている場合、入手元、版、安全策の設定を誰が管理しているか |
| 4. 委託先 | システムの開発や運用を任せている会社が、更新の適用と AI の利用をどう管理しているか |
| 5. 社内ルール | オープンウェイトモデルを業務で使う時の申請と記録の決まりがあるか |
1つ目が最優先です。今回の検証の中心になった試験は、修正が出ている既知の脆弱性を対象にしたものです。修正を早く当てることは、新しい道具を入れなくてもできる対策です。例えば Google は2026年9月29日に、深刻度「重大」1件を含む32件のセキュリティ修正を入れた Chrome の更新を公開しています(修正の中には、今回の検証で対象になった V8 エンジンのものも含まれます)。
3つ目は、自社運用を検討している会社に関わります。API で使う時は提供する会社が持っていた安全策を、自社で動かす時は自社が持つことになります。入手する時は開発元の公式の公開ページから取得し、出どころの分からない改変版を業務に使わないことが基本です。社内で把握されていない AI の利用を洗い出す手順は シャドーAIエージェントの棚卸し手順 で扱っています。
社内の確認に使える指示文の雛形5つ
上の5項目を社内で進める時に、手元の生成 AI に渡せる指示文です。[ ]の中を自社の内容に置き換えて使ってください。出てきた内容は、自社の実際の状況と照らして確かめてから使います。
1. 更新の適用状況を確かめる表を作る
当社は従業員[人数]名の[業種]です。社内の端末と機器について、セキュリティ更新の適用状況を確かめる一覧表の様式を作ってください。
列: 種類(パソコン・スマートフォン・ネットワーク機器・サーバー)/台数/自動更新の設定/最後に更新を確かめた日/保守の担当/気づいた点
記入の手順を3行で添え、専門用語には短い説明を付けてください。
2. 社内で使っている AI モデルの一覧を作る
社内で使っている AI モデルとサービスを棚卸しする表の様式を作ってください。
列: 名称/提供する会社/使い方(クラウドのサービス・API・自社の環境で動かす)/入手元/版/管理している部署/安全策の設定を決めている人
「自社の環境で動かす」に当てはまる行について、追加で確かめる項目を5つ挙げてください。
3. 委託先に確認する文面を作る
システムの開発・運用を委託している会社に、次の点を確認する文面を丁寧語で作ってください。
確認したい点: セキュリティ更新を公表から何日以内に適用する運用か/当社のシステムの開発や運用に AI を使っているか/使っている場合のモデルの種類と管理の方法/確認の結果を書面で受け取れるか
相手を疑う書き方にせず、当社の定期的な確認として依頼する形にしてください。
4. 社内ルールに足す条文の案を作る
当社の AI 利用ルールに、オープンウェイトモデル(重みを入手して自社の環境で動かせるモデル)の扱いを足します。条文の案をA4で半ページ以内で作ってください。
入れる項目: 使う前の申請先/入手元は開発元の公式の公開ページに限ること/出どころの分からない改変版を使わないこと/動かす環境と扱ってよい情報の範囲/記録に残すこと
断定できない点は[要確認]と書いてください。
5. 経営層への報告を1枚にまとめる
次の内容を、経営層向けの報告としてA4で1枚にまとめてください。
内容: [この記事の要点を貼る]
構成: 何が起きたか(3行)/当社への影響(3行)/今月中に確かめること(5項目・担当と期限の欄つき)/判断をお願いしたいこと
専門用語を避け、数字には出典の名前を添えてください。
【要注意】読み違えやすい点
❌「GLM-5.3 を業務で使うと、自社が攻撃される」
⭕ 今回の発表は、攻撃者が手にできる能力についての報告です。モデルを使う会社が、使ったことで直接危険になるという内容ではありません。
❌「オープンウェイトモデルは危険なので、すべて禁止すべきだ」
⭕ Anthropic 自身が、同じ能力は守る側にも役立つと書いています。必要なのは、入手元と版と安全策の設定を管理することです。
❌「米国のモデルより約4か月遅れなら、まだ心配ない」
⭕ 比較の対象になった米国のモデルは、安全策を切った状態で試験されており、審査を通った利用者にしか提供されていない版も含まれます。GLM-5.3 は誰でも入手できる点が違います。
❌「競合する会社の発表なので、割り引いて読めばよい」
⭕ 立場を踏まえて読むことは大切ですが、能力の評価は政府機関の CAISI が先に出しています。2つの評価はおおむね一致しています。
よくある質問
GLM-5.3とは何ですか?
中国の Z.ai(旧 Zhipu AI)が開発した AI モデルです。CAISI によると2026年8月14日に公開され、その2週間後にモデルの重みが公開されました。重みを入手して自社の環境で動かせる、オープンウェイトモデルです。
オープンウェイトとは何ですか?
学習済みのモデルの重みを公開し、利用者が自分の環境で動かしたり調整したりできる形のことです。学習データや開発の工程まで公開されるとは限らないため、オープンソースとは区別して使われます。
Anthropicは何を問題にしているのですか?
高いサイバー能力を持つモデルが、実質的な安全策なしに誰でも入手できる形で公開されたことです。同程度の能力を持つ他のモデルは、安全策を付けるか、利用者を限定して提供されている、と同社は書いています。
Z.aiはこの発表にどう答えていますか?
2026年9月30日時点で、Z.ai の公式の見解は確認できていません。確認でき次第、この記事に追記します。
中小企業でも対応が必要ですか?
必要です。攻撃コードが早く出回るようになると、修正を当てていない機器は会社の規模に関係なく狙われます。まずは更新の適用状況と、外から届く機器の一覧を確かめてください。
AIを守る側で使うことはできますか?
できます。脆弱性の発見と修正に AI を使う取り組みは広がっており、Anthropic も守る側への提供を広げるとしています。自社のシステムを診断する場合は、対象と範囲を決め、結果を人が確かめる手順を置いてください。
まとめ
Anthropic は2026年9月29日、オープンウェイトモデルの GLM-5.3 が攻撃コードを端から端まで自律的に組み立てられること、安全策が簡単に回避または取り除かれることを確かめたと発表しました。NIST の CAISI も9月17日に、GLM-5.3 をもっともサイバー能力の高いオープンウェイトモデルと評価しています。同じ能力は守る側にも使えますが、修正を当てていない機器が狙われるまでの時間は短くなる前提に立つ必要があります。
まず、更新の適用状況と外から届く機器の一覧を確かめるところから始めてみてください。AI の社内ルールの見直しや、部門ごとの使い方を含めた研修を検討している場合は、法人向け生成AI研修 の内容をご覧のうえ、お問い合わせ からご相談ください。
参考・出典
- GLM-5.3 and the spread of advanced cyber capabilities(Anthropic・2026年9月29日)(参照日: 2026-09-30)
- CAISI’s Assessment of Z.ai’s GLM-5.3 Cyber Capabilities(NIST・2026年9月17日)(参照日: 2026-09-30)
- Project Glasswing の経過報告(Anthropic)(参照日: 2026-09-30)
- Stable Channel Update for Desktop(Chrome Releases・2026年9月29日)(参照日: 2026-09-30)
- 「誰でも入手できるAI」がサイバー攻撃を自律構築 Anthropicが「GLM-5.3」に警鐘(ASCII.jp・2026年9月30日の報道)(参照日: 2026-09-30)
この記事の内容を社内で使うなら
Claude Codeを非エンジニアが業務で使うための実践ガイド。ユースケースと導入手順をまとめています。
- 30分・オンライン
- 売り込みでなく業務診断
- 完全マンツーマン
資料は受け取りページからすぐにご覧いただけます。