2026年10月28日時点で、OpenAI が10月26日に公開した ChatGPT の利用データ「OpenAI Signals v3.0」を Uravation が日本の行で集計すると、個人向けプランで ChatGPT が仕事にいちばん多く使われている業務は「文章や文書の編集」で、日本の分類済みの仕事のメッセージの 14.51% を占めました(2026年7〜9月)。2 位は「ビジュアルデザインや展示の制作」6.66%、3 位は翻訳などが入る「言語、文化、宗教に関する情報の解説」4.53% です(OpenAI「広がる ChatGPT の仕事の世界」・OpenAI「データと方法論」)。対象は個人向けの ChatGPT プランだけで、企業向けプランのメッセージと Codex(OpenAI のプログラミング向けの AI エージェント)の利用は含まれていません。
結論:このデータを踏まえると、社員向けの ChatGPT 研修は「文章や文書の編集」から始め、その前に「仕事で使ってよいアカウント」と「入れてよい情報」を決めるのが自然な順番です。
- 要点1:日本の個人向けプランの分類済みの仕事のメッセージでは、文章や文書の編集が 14.51% で 1 位(2026年7〜9月・Uravation 集計)。2025年1〜3月から 7 つの四半期続けて 1 位です
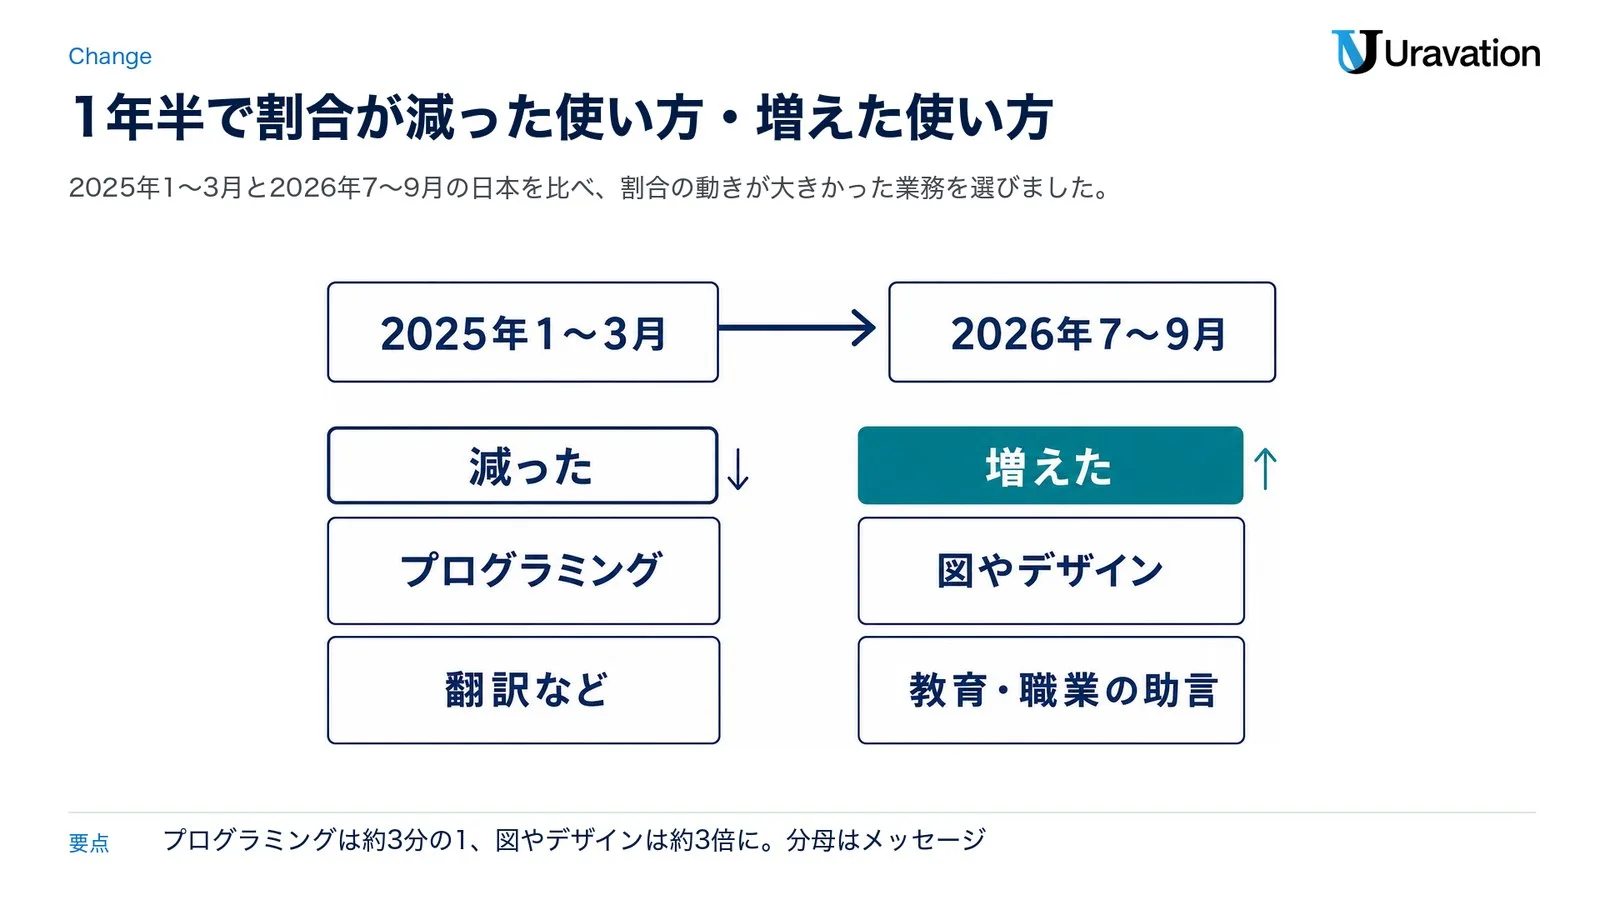
- 要点2:同じ分母(日本の個人向けプランの分類済みの仕事のメッセージ)で 2025年1〜3月と2026年7〜9月を比べると、プログラミングの割合は 9.35% から 2.88% に下がり、図やデザインは 2.13% から 6.66% に上がりました。上位 10 の区分(「その他の IWA」を含む)の合計は 59.6% から 47.4% で、使い道が広がっています
- 要点3:日本の個人向けプランのメッセージのうち、仕事に関係すると分類されたのは 28.5% でした(2026年9月・世界全体は 32.2%)。メッセージの中の割合で、人数や会社の数でも、使いこなしの度合いでもありません
- 要点4:企業向けプランと Codex は入っていません。データ辞書は、仕事での利用を少なめに示している可能性が高いと説明しています
対象読者:社員に ChatGPT を使わせ始めた、または研修を考えている経営者・部門の責任者・情報システムの担当者
読了後にできること:日本の上位の業務を手がかりに、研修で最初に扱う業務と、研修の前に決めるルールを書き出せます
「社員に ChatGPT を使わせ始めたけれど、何から教えればいいのか」。研修を考えるときに、最初に出てくる問いです。
10月26日の公開は、この問いに数字の手がかりをくれます。OpenAI は約 100 か国・165 の業務の区分について、国ごと・四半期(3 か月ごとの区切り)ごとの割合を CSV(表計算ソフトで開けるカンマ区切りの表のファイル)で公開しました。ライセンスは CC BY 4.0(出典を示せば利用・共有・改変ができるライセンス)です。そこで Uravation は CSV の日本と米国の行を集計し、日本の上位の業務を一覧にしました。
この記事では、データが何を数えているかを確かめたうえで、日本の上位 10 業務、1 年半の変化、米国との違いを見て、研修で教える順番と研修の前に決めるルールに落とし込みます。日本と米国の割合は「OpenAI Signals v3.0(CC BY 4.0)を Uravation が日本・米国の行で集計」した値で、分母は断りがない限り「その国の分類済みの仕事のメッセージ(個人向けプラン)」です。74 か国の平均など OpenAI が示した値と、世界全体の表の値は、その都度書き分けています。最終更新:2026年10月28日。
OpenAI Signalsとは|何のデータで、何が入っていないか
OpenAI Signals は、OpenAI の経済研究チームによるデータ・調査・分析・事例をまとめたページです(OpenAI Signals・データと方法論)。10月26日の v3.0 では、個人ユーザーが仕事で ChatGPT をどう使っているかを、業務の区分ごとの割合で示すデータが国別に加わりました。
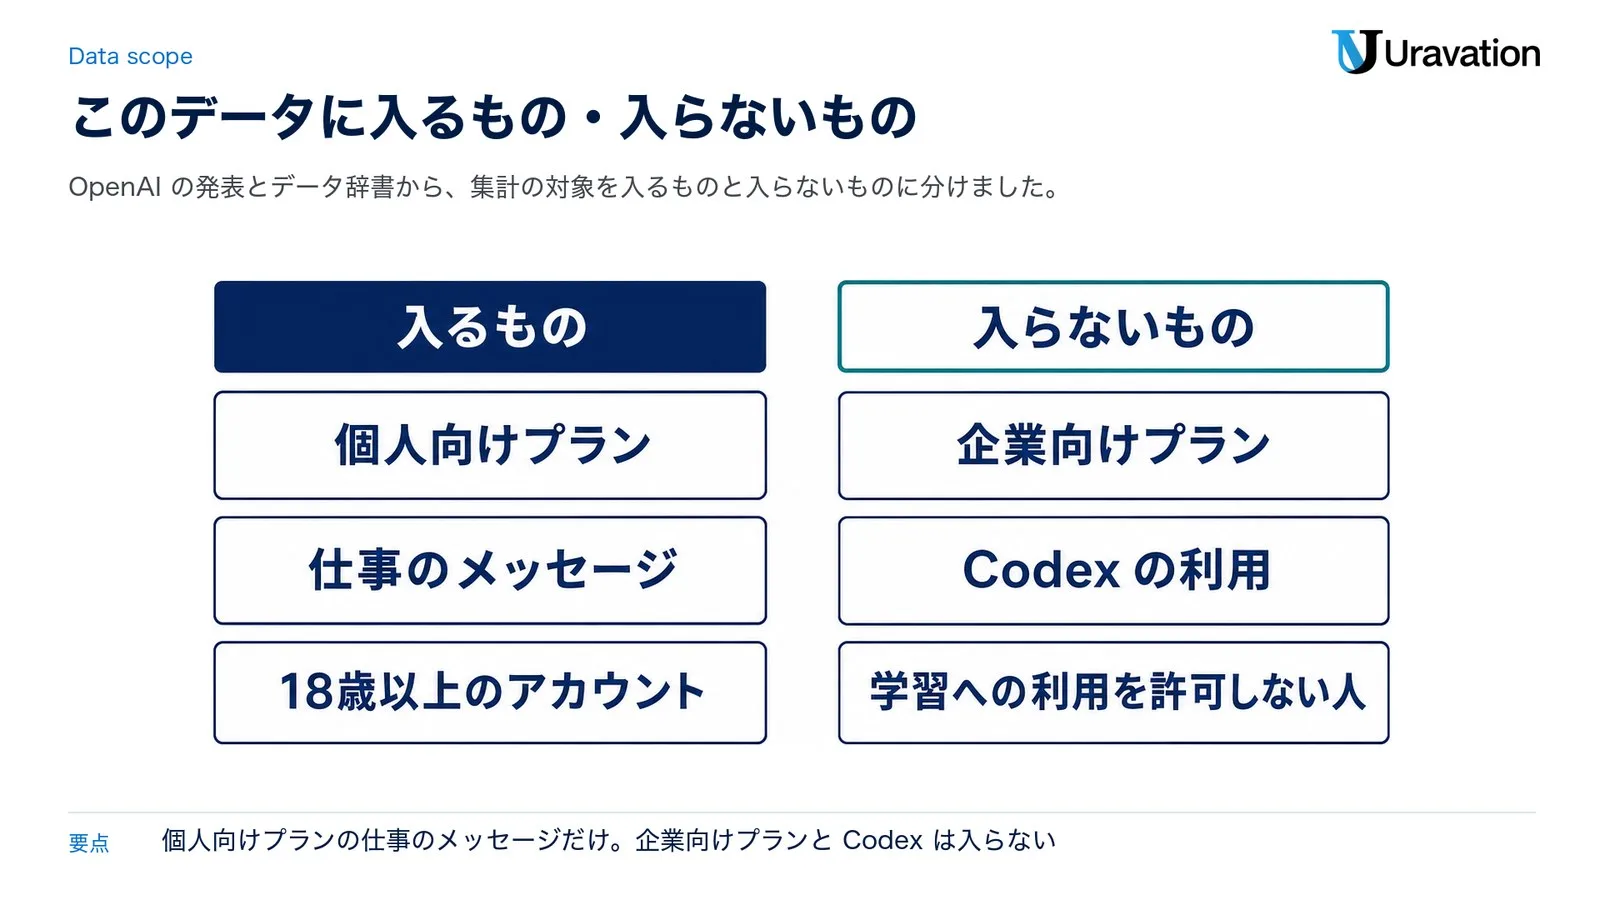
元になっているのは、毎月 100 万件の個人向け ChatGPT のメッセージを分類した結果です(2024年7月〜2026年9月・18 歳以上と申告したアカウントのメッセージ)。分類は人ではなく、文章を読んで区分を判定する AI のプログラム(分類器)が自動で行います。研究者は個別の会話を読まず、個人を特定できる情報を消してから分類し、公開するのは集計した統計(割合と順位)だけです。少人数のグループの結果は出さず、個々のメッセージを守るために統計的なノイズも加えています(OpenAI Signals のデータ辞書・OpenAI の発表)。
たとえるなら、図書館が本の題名も借りた人の名前も出さずに、「分類ごとに何%借りられたか」だけを公表するようなものです。違うのは、その分類を AI が自動でつけている点です。
業務の区分は O*NET の IWA
業務の区分には、米国労働省(雇用訓練局)が提供する職業情報の枠組み ONET(オーネット)の「中間レベルの業務活動」(Intermediate Work Activities、IWA)を使っています。OpenAI の説明では、ONET は職業ごとに違うタスクを、職業をまたいで共通する業務活動にまとめた標準的な枠組みです(OpenAI の発表)。たとえば文書を直す仕事は営業にも人事にもあるので、職種が違っても同じ区分で数えられます。
IWA の下には、さらに細かい業務(Detailed Work Activities、DWA)が並んでいて、それぞれの区分にどんな作業が入るかを確かめられます(O*NET 30.0 の DWA Reference)。この記事で「〜が入る」と書いている作業の中身は、この DWA の一覧から引いています。
入るもの・入らないもの
| 区分 | 中身 | 根拠 |
|---|---|---|
| 入るもの:個人向けプラン | データ辞書に載っているプランの種類は free(無料版)と、有料の個人向けプランの go・plus・pro の 4 つ | データ辞書(plan_type 列の説明) |
| 入るもの:仕事のメッセージ | 業務の区分の表は、仕事に関係すると分類されたメッセージだけを数える | データ辞書(表の定義) |
| 入るもの:18歳以上のアカウント | 18 歳以上と申告したアカウントから送られたメッセージ | データ辞書(方法の概要) |
| 入らないもの:企業向けプラン | 企業向けプランのメッセージは含まない | OpenAI の発表・データ辞書 |
| 入らないもの:Codex の利用 | Codex のデータは含まない | OpenAI の発表・データ辞書 |
| 入らないもの:学習への利用を許可しない人 | アカウントを削除した人と、データを学習に使うことを許可していない人は集計の対象から外している | データ辞書(方法の概要) |
データ辞書は、企業向けのメッセージを含まないため「仕事での利用を少なめに示している可能性が高い」とも書いています。企業向けプラン(ChatGPT Business・Enterprise など)での使い方は、このデータには出てきません(データ辞書の Methodology At A Glance)。
v2.0 までとの違い
業務活動のデータは以前から米国の分だけありましたが、国別に見られるようになったのは v3.0 からです。データ辞書の変更履歴(Changelog)をまとめると次のとおりです。
| 項目 | v2.0 まで | v3.0(2026年10月26日) |
|---|---|---|
| 業務活動(IWA)の表 | 米国の月ごとの表 2 つ | 国×四半期の表 1 つ(仕事のメッセージ) |
| 集計に使うメッセージの数 | 毎月 30 万件 | 毎月 100 万件(過去の期間も増やして集計し直した) |
| 最新の期間 | 2026年4〜6月 | 2026年7〜9月 |
| 米国の州の順位 | 年ごと | 四半期ごと |
会社での AI の導入状況は、別の「Enterprise Signals」が業界や職能別に追っています(データと方法論のページの案内)。今回の業務活動のデータは、あくまで個人向けプランの側です。
10月26日に公開された内容の要点
OpenAI は2026年10月26日、日本語版の発表「広がる ChatGPT の仕事の世界」で、約 100 か国の 165 種類の業務活動を対象にしたデータを公開しました。要点は次のとおりです(OpenAI の発表・データと方法論・データ辞書)。
| 項目 | 内容 |
|---|---|
| 公開日 | 2026年10月26日(OpenAI の日本語版の発表の日付) |
| データの名前 | OpenAI Signals v3.0(OpenAI が示す引用の名前) |
| 対象 | 個人向け ChatGPT プランの仕事のメッセージ。企業向けプランのメッセージと Codex の利用は含まない |
| 業務の区分 | O*NET の IWA に基づく 165 種類。CSV で数えると、件数の少ない業務をまとめた「その他の IWA」を含めて 165 |
| 国 | 約 100 か国。業務の区分の CSV に一度でも出てくる国は 94 で、四半期ごとに載る国の数は変わる |
| 期間 | 2025年1〜3月(第1四半期)から 2026年7〜9月(第3四半期)までの四半期ごと |
| OpenAI が示した結果 | すべての四半期で観測された 74 か国の平均で、分類済みの仕事のメッセージに占める上位 10 の活動の割合が 56.0% から 51.1% に下がった |
| ライセンス | CC BY 4.0(クリエイティブ・コモンズの表示 4.0)。利用・共有・改変ができ、出典の明示か引用が必要 |
OpenAI はこの結果について、仕事での利用が最も一般的な活動に集中する度合いは下がり、時間とともに各国で特定の仕事への特化が進んで、その仕事の種類は国によって違っていたと説明しています。国内では10月27日に GIGAZINE と Impress Watch がこの公開を報じました。
日本の上位10業務|2026年7〜9月の集計
日本の行(country 列が JP)を、2026年7〜9月の割合の大きい順に並べると次のとおりです。分母は日本の分類済みの仕事のメッセージで、個人向けプランだけを数えています(企業向けプランと Codex は含みません。OpenAI Signals v3.0 の CSV を Uravation が集計)。
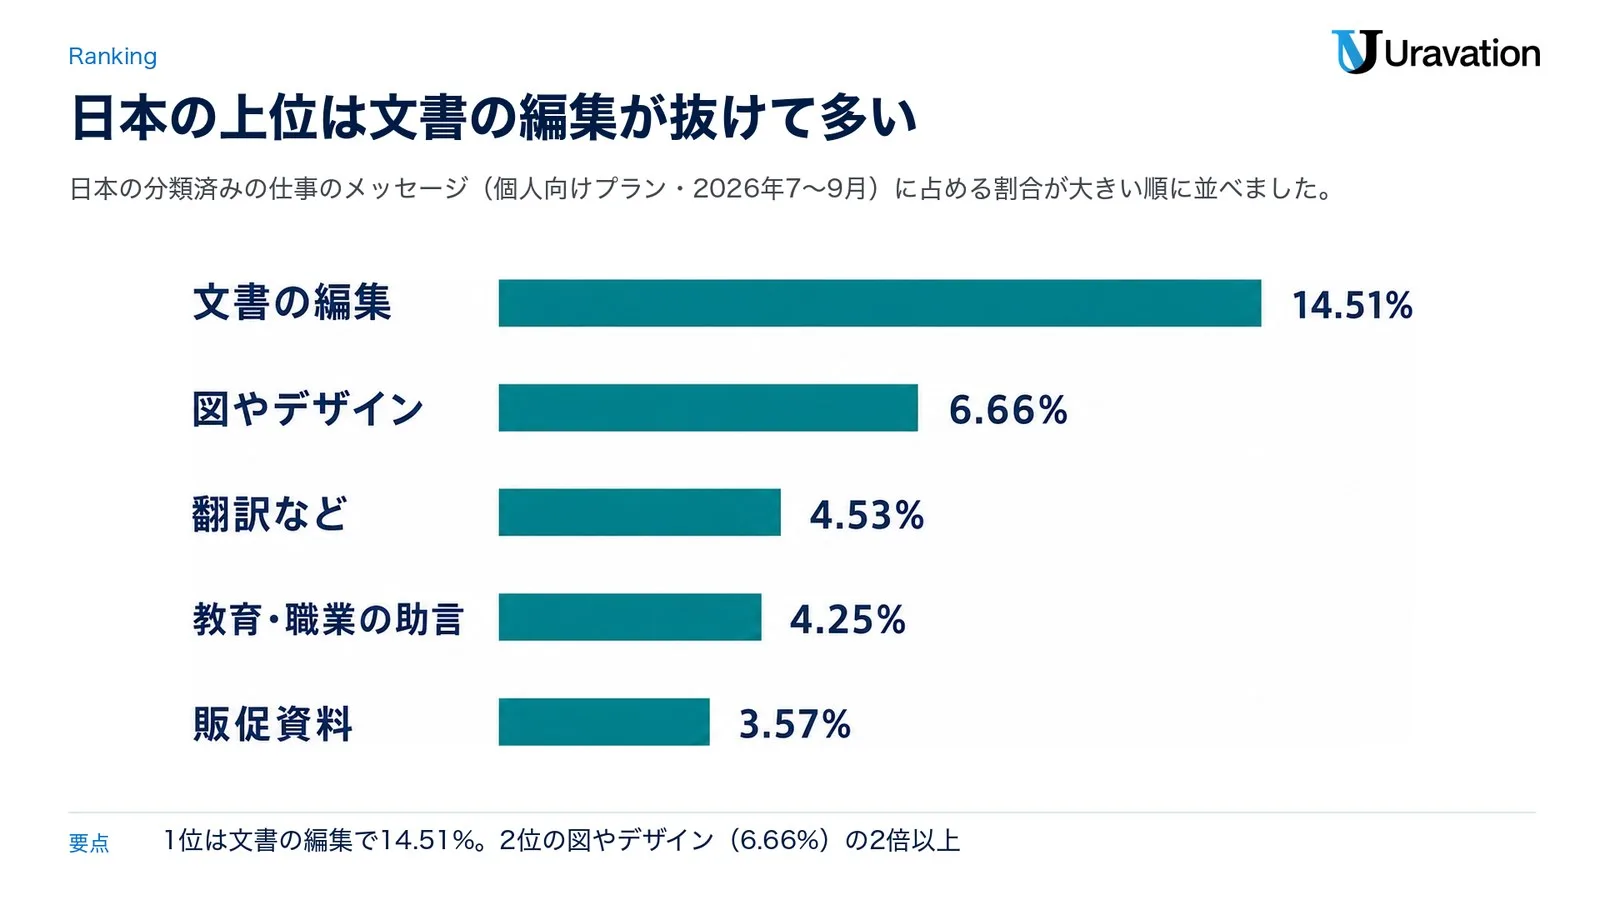
| 順位 | 業務(OpenAI 日本語版の表記と英語名) | この記事での呼び方 | 2026年7〜9月 | 2025年1〜3月(順位) |
|---|---|---|---|---|
| 1 | 文章や文書の編集(Edit written materials or documents) | 文書の編集 | 14.51% | 19.22%(1位) |
| 2 | ビジュアルデザインや展示の制作(Create visual designs or displays) | 図やデザイン | 6.66% | 2.13%(9位) |
| 3 | 言語、文化、宗教に関する情報の解説(Interpret language, cultural, or religious information for others) | 翻訳など | 4.53% | 8.79%(3位) |
| 4 | 教育や職業に関する助言(Advise others on educational or vocational matters) | 教育・職業の助言 | 4.25% | 2.67%(8位) |
| 5 | マーケティング・販促資料の制作(Develop marketing or promotional materials) | 販促資料 | 3.57% | 3.75%(5位) |
| 6 | コンピューターの問題の解決(Resolve computer problems) | コンピューターの問題 | 3.13% | 5.77%(4位) |
| 7 | 商品やサービスに関する情報の取得(Obtain information about goods or services) | 商品・サービスの情報 | 3.02% | 1.83%(14位) |
| 8 | コンピューターシステムや生産設備のプログラミング(Program computer systems or production equipment) | プログラミング | 2.88% | 9.35%(2位) |
| 9 | その他の IWA(件数の少ない業務をまとめた区分) | その他の IWA | 2.67% | 1.10%(18位) |
| 10 | 芸術・商業目的の執筆(Write material for artistic or commercial purposes) | 記事・広告文の執筆 | 2.22% | 3.09%(6位) |
| 11 | 情報提供資料や教材の作成(Prepare informational or instructional materials) | 説明資料や教材 | 2.15% | 1.87%(12位) |
表の注:順位は「その他の IWA」も 1 つの区分として並べています(この数え方で、OpenAI が示した 74 か国の平均 56.0%・51.1% を再現できました)。名前のある業務は 11 位までで 10 件です。12 位は「個人的な問題についての相談対応」2.10% でした。割合は CSV の値を小数点以下 2 桁に四捨五入しています。
1 位の文書の編集は 14.51% で、2 位の図やデザイン(6.66%)の 2 倍以上あります。しかも 2025年1〜3月から 2026年7〜9月まで、7 つの四半期すべてで 1 位でした。新しく書く区分(記事・広告文の執筆 2.22%、説明資料や教材 2.15%)と比べても、手元の文章を直す区分のほうがずっと大きいんです。上位 10 の区分(「その他の IWA」を含む 1〜10 位)を足すと 47.4% で、残りの半分以上はそれより小さい区分に散らばっています。
それぞれの区分に入る作業
- 文書の編集:O*NET の細かい業務は「文章を編集する(Edit written materials)」と「文書を編集する(Edit documents)」の 2 つです
- 図やデザイン:製品やサービスの図、流れ図、情報を図などで表したもの、印刷物のレイアウト、画像やコンピューターグラフィックスの作成などが入ります
- 翻訳など:「他の人のために情報を翻訳する(Translate information for others)」と「文化や宗教の情報を解説する」の 2 つです
- 教育・職業の助言:進路や仕事・キャリアについての助言、教育の方法についての助言などが入ります
- 販促資料:販促物やマーケティングの資料、営業の説明資料の中身づくりが入ります
いずれも O*NET 30.0 の DWA Reference の記載です(O*NET)。
CSV で同じ数字を確かめる手順
- OpenAI の「データと方法論」のページを開き、「データの CSV ファイルをダウンロード」から zip ファイル(data-download-csv.zip)を保存する
- zip を開き、public_release_csv フォルダにある share_of_work_related_messages_by_onet_iwa_country_quarter.csv を表計算ソフトで開く
- country 列で JP(日本)を、quarter 列で 2026-07-01(2026年7〜9月。四半期は初日の日付で表す)を選んで絞り込む
- share_of_messages 列を大きい順に並べ替える。値は 0〜1 の割合なので、100 倍すると % になる
- iwa_cleaned 列の番号(例:4.A.2.b.1.I07)の英語名を、同じフォルダの README.pdf(データ辞書)の付録の一覧で引く
- 大きい分類で見たいときは、番号の頭(例:4.A.2.b)が同じ行の値を足し上げる。OpenAI のグラフの大きい分類は 7 つで、4.A.1 で始まる行と 4.A.3 で始まる行は、それぞれまとめて 1 つに足す
- 社内資料や記事に使うときは「OpenAI Signals v3.0」と CC BY 4.0 を明記し、絞り込みや足し上げをしたことも書き添える
Uravation はこの手順で集計し、同じ数え方(「その他の IWA」も 1 区分)で、OpenAI が示した 74 か国の平均(56.0% と 51.1%)が再現できることも確かめました。日本語の業務名は、OpenAI の日本語版のページで使われている表記に合わせています。
1年半で変わったこと|プログラミングの割合が下がり、図やデザインが約3倍に
2025年1〜3月と2026年7〜9月の日本を比べると、割合が減った業務と増えた業務がはっきり分かれました。動きの大きかった業務は次のとおりです(分母はどちらも日本の分類済みの仕事のメッセージ・個人向けプラン。OpenAI Signals v3.0 の CSV を Uravation が集計)。
| 業務 | 2025年1〜3月 | 2026年7〜9月 | 変化 |
|---|---|---|---|
| プログラミング | 9.35% | 2.88% | 約 3 分の 1 に |
| 翻訳など | 8.79% | 4.53% | 約半分に |
| コンピューターの問題 | 5.77% | 3.13% | 約半分に |
| 文書の編集 | 19.22% | 14.51% | 下がったが 1 位のまま |
| 図やデザイン | 2.13% | 6.66% | 約 3 倍に |
| 教育・職業の助言 | 2.67% | 4.25% | 約 1.6 倍に |
| 商品・サービスの情報 | 1.83% | 3.02% | 約 1.7 倍に |
| 個人的な問題についての相談対応 | 0.64% | 2.10% | 約 3 倍に |
割合の差(ポイント)で見ると、下がり方がいちばん大きかったのはプログラミング、上がり方がいちばん大きかったのは図やデザインです。文書の編集は割合こそ下がりましたが、1 位のままでした。四半期ごとの動きは次のとおりです。
| 四半期 | 文書の編集 | 図やデザイン | 翻訳など | プログラミング | 上位 10 の区分の合計 |
|---|---|---|---|---|---|
| 2025年1〜3月 | 19.22% | 2.13% | 8.79% | 9.35% | 59.6% |
| 2025年4〜6月 | 15.93% | 3.83% | 6.27% | 6.67% | 52.8% |
| 2025年7〜9月 | 16.16% | 2.85% | 6.42% | 5.73% | 51.5% |
| 2025年10〜12月 | 17.49% | 2.89% | 6.29% | 4.74% | 51.0% |
| 2026年1〜3月 | 16.58% | 3.41% | 5.20% | 3.22% | 49.3% |
| 2026年4〜6月 | 15.87% | 5.51% | 5.43% | 3.01% | 48.8% |
| 2026年7〜9月 | 14.51% | 6.66% | 4.53% | 2.88% | 47.4% |
2 位の業務は、プログラミング(2025年1〜6月)、翻訳など(2025年7〜12月)、教育・職業の助言(2026年1〜3月)、図やデザイン(2026年4〜9月)と入れ替わってきました。ただし 2026年4〜6月は、図やデザイン 5.51%、翻訳など 5.43%、教育・職業の助言 5.32% の僅差でした。
使い道が広がった
上位 10 の区分を足した割合は、日本で 59.6%(2025年1〜3月)から 47.4%(2026年7〜9月)に下がりました。OpenAI が示した 74 か国の平均は 56.0% から 51.1%(OpenAI の発表)なので、日本の下がり幅(約 12 ポイント)は平均(約 5 ポイント)の 2 倍以上です。74 か国の中でも、日本の下がり幅は大きいほうでした(Uravation 集計。ポイント差で並べると上から 3 番目ですが、2 番目の国との差は約 0.1 ポイントで、元の値に対する比率で比べると 4 番目になるため、順位までは決めつけられません)。一部の業務に集まっていた使い方が、多くの業務に散らばってきたと読めます。
ただし、これは割合の変化で、件数の変化ではありません。プログラミングの割合が下がった理由も、このデータからは分かりません。Codex の利用はもともと入っていませんし、米国でもプログラミングは 6.69% から 2.40% に下がっています。
米国との比較|日本は翻訳と助言が多く、販促と教材は少なめ
同じ 2026年7〜9月の米国の行と並べました。分母はそれぞれの国の分類済みの仕事のメッセージ(個人向けプラン)です(OpenAI Signals v3.0 の CSV を Uravation が集計)。
| 業務 | 日本(順位) | 米国(順位) |
|---|---|---|
| 文書の編集 | 14.51%(1位) | 17.10%(1位) |
| 図やデザイン | 6.66%(2位) | 7.63%(2位) |
| 翻訳など | 4.53%(3位) | 1.71%(13位) |
| 教育・職業の助言 | 4.25%(4位) | 3.39%(4位) |
| 販促資料 | 3.57%(5位) | 5.02%(3位) |
| コンピューターの問題 | 3.13%(6位) | 2.79%(7位) |
| 商品・サービスの情報 | 3.02%(7位) | 2.92%(5位) |
| プログラミング | 2.88%(8位) | 2.40%(その他の IWA と同じ値で 9〜10位) |
| 記事・広告文の執筆 | 2.22%(10位) | 2.61%(8位) |
| 説明資料や教材 | 2.15%(11位) | 2.92%(6位) |
| 個人的な問題についての相談対応 | 2.10%(12位) | 0.57%(38位) |
| 上位 10 の区分の合計 | 47.4% | 49.2% |
| 大きい分類「計画と意思決定」 | 35.1% | 39.6% |
表の注:順位は「その他の IWA」を 1 区分として含めた数え方です(日本は 9 位、米国はプログラミングと同じ値)。割合は小数点以下 2 桁に四捨五入しているので、米国の商品・サービスの情報(5 位)と説明資料や教材(6 位)は同じ 2.92% に見えます。
1 位と 2 位は日米で同じです。違いが大きいのは翻訳などで、日本の 4.53% は米国(1.71%)の 2.6 倍あります。個人的な問題についての相談対応も日本のほうが多く、反対に販促資料と説明資料や教材は米国のほうが多めでした。
大きい分類では、どちらの国も計画と意思決定がいちばん大きく、上位 10 の区分の合計は日本のほうがやや小さい(使い道が散らばっている)結果でした。なぜ違うのかは、このデータは示していません。OpenAI も国ごとの違いについて「各国で行われる仕事の種類や、AI ツールへのアクセスの違いを反映している可能性がある」と述べるにとどめています(OpenAI の発表)。
仕事のメッセージの割合|日本28.5%・世界32.2%(2026年9月)
ここまでの割合は「仕事のメッセージの中の内訳」でした。では、個人向けプランのメッセージのうち、仕事に関係すると分類されたメッセージはどれくらいあるのか。日本は 2026年9月に 28.5% で、世界全体は 32.2%、米国は 33.1% でした(OpenAI Signals v3.0 の share_of_messages_by_work_related_country_month.csv と share_of_messages_by_work_related_month.csv を Uravation が集計)。
| 月 | 日本 | 米国 | 世界全体 |
|---|---|---|---|
| 2024年7月 | 53.2% | 51.4% | 51.6% |
| 2025年1月 | 45.3% | 41.2% | 40.3% |
| 2025年9月 | 30.4% | 35.1% | 33.2% |
| 2026年3月 | 28.5% | 34.2% | 31.2% |
| 2026年9月 | 28.5% | 33.1% | 32.2% |
日本は 2024年7月には 53.2% で、世界全体(51.6%)より高い割合でした。その後は世界全体と同じように下がり、2026年1月からは毎月、世界全体を下回っています。月ごとの上下もあり、2026年8月の日本は 25.7% でした。
個人向けプランの種類別の表もあります。世界全体の 2026年9月で、仕事に関係するメッセージの割合は無料版(free)24.7%、Go 42.4%、Plus 50.8%、Pro 68.1% でした(share_of_messages_by_work_related_plan_type_month.csv)。有料の個人向けプランほど、仕事の割合が高く出ています。この表は世界全体の値だけで、国別の値はありません。
注意したいのは、割合が下がったからといって、仕事での利用が減ったとは限らない点です。分母は全部のメッセージなので、仕事以外の使い方が増えれば、仕事の割合は下がります。国どうしを比べるときも同じで、日本の割合が世界全体や米国より低くても、日本で ChatGPT を仕事に使う量が少ないとは限りません。使いこなしの度合いを示す数字でもありません。このデータには割合はあっても、メッセージの件数は出ていません。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修6,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
数字を読むときの注意5つ
このデータは便利ですが、読み方を間違えると逆の結論になりかねません。社内で数字を使う前に、次の 5 つを押さえておいてください。
1. 「最多」は数える階層で変わる
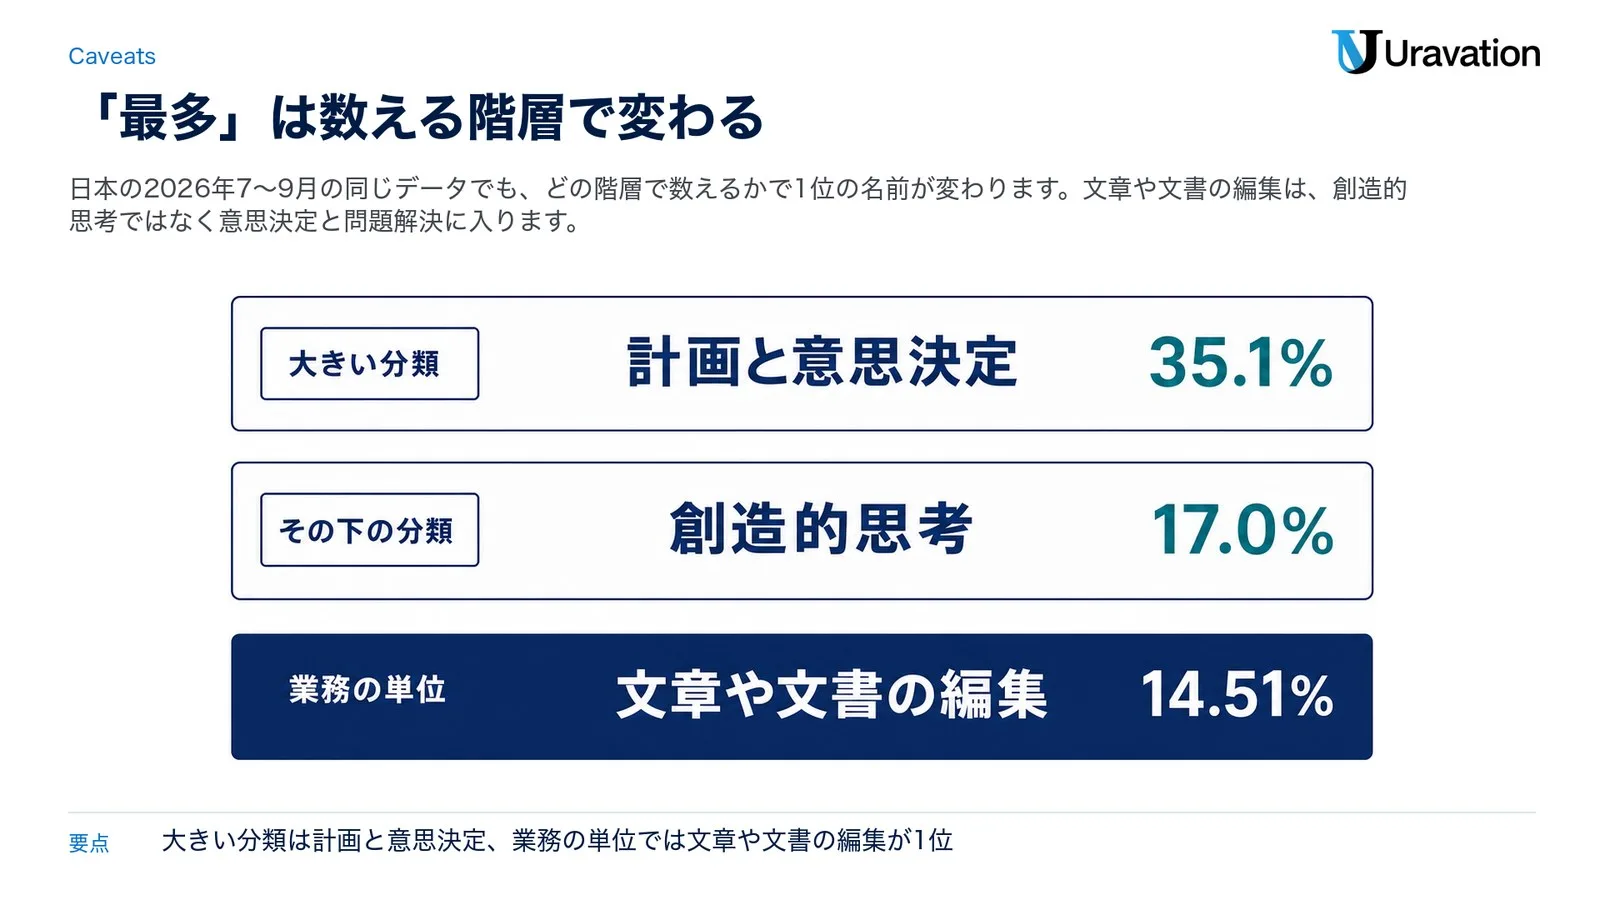
ONET の区分は階層になっています。日本の 2026年7〜9月で、大きい分類で数えると「計画と意思決定」(OpenAI 英語版の表記は Planning and decisions、ONET の名前は Reasoning and Decision Making)が 35.1% で最多、その下の分類では「創造的思考」(Thinking Creatively)が 17.0% で最多、業務の単位(IWA)では「文章や文書の編集」が 14.51% で最多です。分母はいずれも日本の分類済みの仕事のメッセージです。
しかも O*NET では、文章や文書の編集が「計画と意思決定」の中の「意思決定と問題解決」に入っています。計画と意思決定の 35.1% のうち 14.51 ポイントは文章や文書の編集で、名前から想像する「計画を立てる・決める」仕事だけではありません。創造的思考の 17.0% にも、図やデザイン(6.66%)や販促資料(3.57%)が入っています(データ辞書の IWA の一覧・O*NET)。この公開を伝える記事や解説で「最多」として挙がる業務が違って見えるのは、主にこの階層の違いと、国・期間の選び方の違いによるものです。
2. 対象は個人向けプランだけ
企業向けプランのメッセージと Codex の利用は入っていません。データ辞書は、企業向けのメッセージを含まないため、仕事での利用を少なめに示している可能性が高いと説明しています。アカウントを削除した人と、データを学習に使うことを許可していない人も外されています。会社の決まりで、個人のアカウントの学習への利用をオフにしている社員のメッセージも、このデータには入りません。また「日本」は、リクエストに関連づけられた国が日本のメッセージで、国籍で分けたものではありません(データ辞書の country 列の説明)。
3. 分母はメッセージで、人数ではない
14.51% は「日本の分類済みの仕事のメッセージ 100 件のうち、約 15 件が文章や文書の編集」という意味です。「働く人の 14.51%」でも「会社の 14.51%」でもありません。メッセージで数えるので、たくさん送る人の使い方ほど大きく出ます。
4. 分類は AI の推定で、数字にはノイズがある
区分は分類器が推定したもので、本人が申告したものではありません。差分プライバシー(個々のメッセージが推測できないように、集計値にわざと小さな乱れを加える方法)のノイズも入っています。さらにデータ辞書は、どの表も毎月 100 万件の同じメッセージから作っているので、細かく分けた表ほど元になる件数が少なく、値のばらつきが大きいと説明しています(データ辞書の FAQ)。業務の区分の表は、国と四半期ごとに実質 1,000 件以上のメッセージがある場合だけ載り、2026年7〜9月に載っているのは 76 か国です(データ辞書の Differential Privacy Process)。小数点以下の小さな差で順位を決めつけないでください。米国のプログラミングと「その他の IWA」は、CSV の値(小数点以下 5 桁)まで同じで、どちらも 2.40% でした。
5. 「その他の IWA」は 1 つの業務ではない
「その他の IWA」は、件数の少ない業務を、プライバシーと集計の安定のためにまとめた区分です(データ辞書)。どの業務をまとめるかは、当初の米国の ChatGPT のサンプルで安定して集計できる基準に届いたかどうかで決めています(OpenAI の発表)。日本の行も同じ 165 の区分で数えています。日本では 1.10% から 2.67% に増え、2026年7〜9月は 9 番目の大きさでした。OpenAI は、米国の職業の仕事の中身(雇用者数で重みづけ)の約 43% が「その他の IWA」に入ると説明していて、資材の運搬や車両の運転、健康・医療記録の管理などが含まれます(OpenAI の発表)。日本の 2026年7〜9月でも、体を使う作業の分類(Performing Physical and Manual Work Activities)は合わせて 0.1% でした。体を動かす現場の仕事は、このデータの上位には出てきにくいということです。
自社の研修とルールにどう使うか
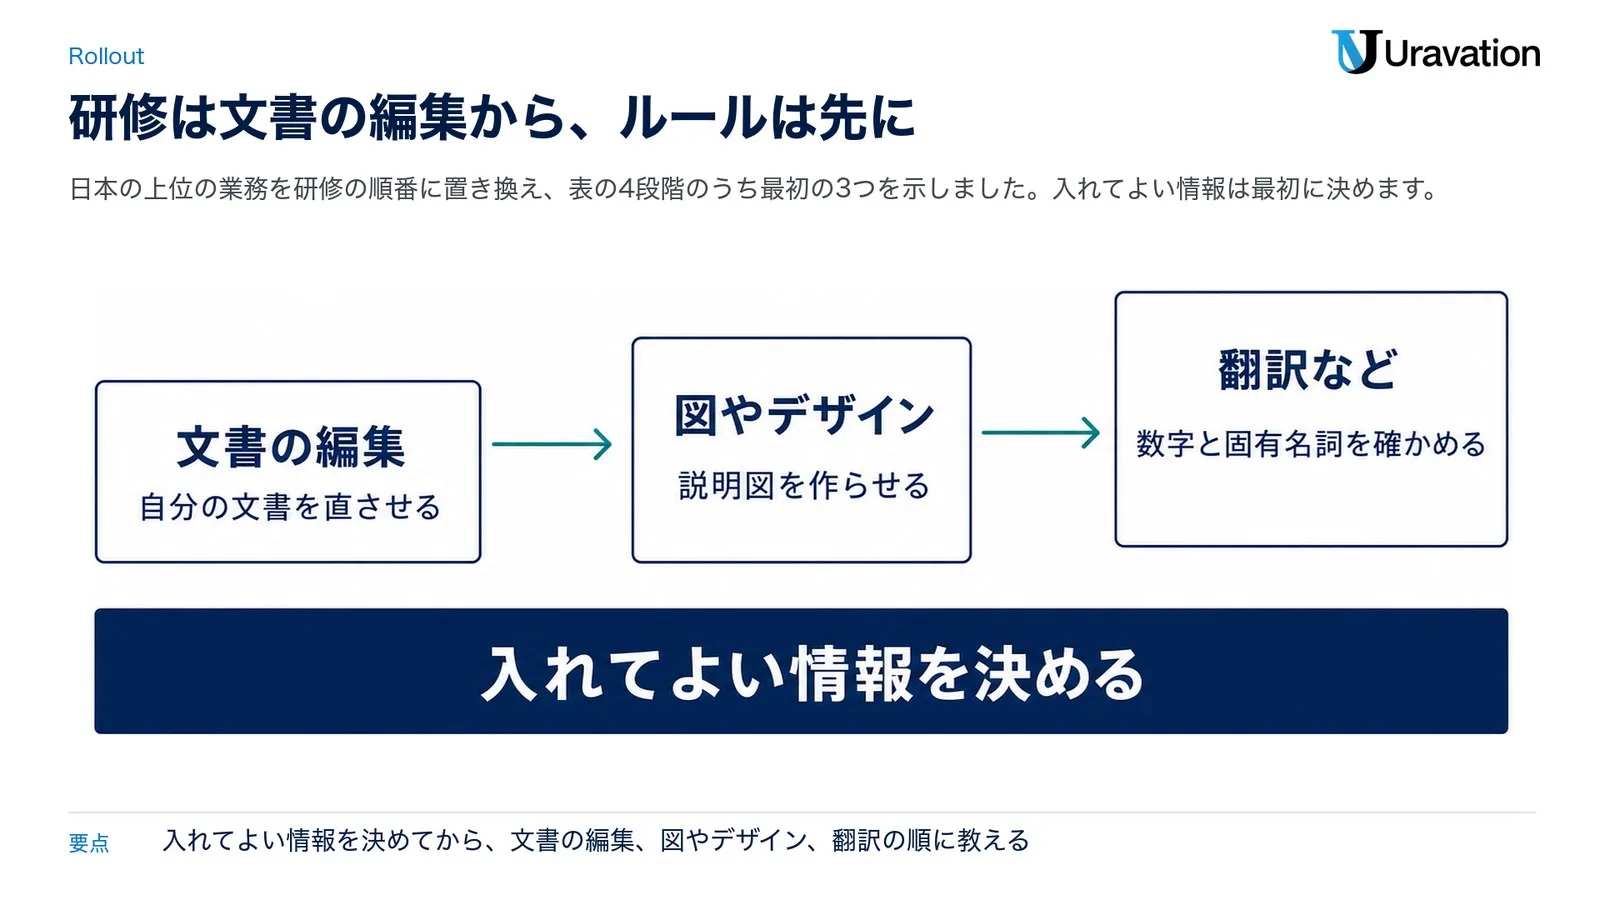
このデータは個人向けプランの集計なので、自社の使われ方そのものではありません。それでも「多くのメッセージが何の仕事に使われているか」は、研修で何から教えるかを決める材料になります。日本の上位の業務を、研修の順番に置き換えると次のようになります。4 位の教育・職業の助言(進路やキャリア、教育の方法についての助言)は、多くの部署に共通する研修の題材にしにくいため、ここでは外しました。
研修は「文書の編集」から始める
| 順番 | 扱う業務(このデータの区分) | 研修で練習すること | セットで決めること |
|---|---|---|---|
| 1 | 文書の編集(日本 1 位・14.51%) | 自分の文書を直させる。直した箇所を自分で読んで確かめる | 入れてよい文書の範囲 |
| 2 | 図やデザイン(1 年半で約 3 倍・6.66%) | 説明図を作らせる。資料の構成やレイアウトの案を出させる | 社外に出す図や画像を誰が確かめるか |
| 3 | 翻訳など(日本 3 位・米国の 2.6 倍) | 訳させて、訳文の数字と固有名詞を確かめる | 社外向けの訳文を誰が確かめるか |
| 4 | 販促資料・説明資料や教材 | 下書きを作らせ、事実と表現を人が直す | 公開や提出の前の確認の手順 |
1 番目を文書の編集にするのは、日米とも 7 つの四半期すべてで 1 位だったからです。自分の文書なら、直した結果が良いかどうかを本人がすぐ判断できます。部門ごとに扱う業務を変える設計は、部門別AI研修の設計法|営業・経理・人事でカリキュラムをどう変えるかで詳しく書いています。基本の操作から確かめたい場合は、ChatGPT 使い方完全ガイド|初心者から業務活用までが入り口になります。
研修の前に、入れてよい情報を決める
このデータが数えているのは、個人向けプランでの仕事のメッセージです。言い換えると、企業向けプランではない個人向けのアカウントでも、仕事に ChatGPT が使われているということです。研修の前に、次の 4 つのルールを決めておきます。
- 仕事で使ってよいアカウント:会社が契約したプランだけにするか、個人のアカウントも認めるか。会社が把握していない AI の業務利用(シャドー AI)の見つけ方は、シャドーAIとは|事例・リスク・見つけ方と対策にまとめています
- 入れてよい情報:文書を直す使い方では、文書そのものを入力することになります。顧客の情報・社外秘・個人情報をどこまで入れてよいかを、例を挙げて決めます
- 出力を誰が確かめるか:図やデザイン、訳文、販促資料は社外に出やすい成果物です。出す前に確かめる人と手順を決めます
- 使い方の振り返り:研修の前と後に「何に使っているか」を同じ区分で聞きます。上位 10 業務の表をそのまま選択肢に使えます
ルールの作り方そのものは、AI利用ガイドライン策定7ステップ|社内ルール雛形付きで手順を紹介しています。決めた依頼の型をチームで使い回す方法は、ChatGPT「Skills」で業務改革|企業向け活用シナリオと手順が参考になります。
自社の状況を確かめるチェック表
| 確かめること | 確かめ方 | まだなら |
|---|---|---|
| 仕事で使ってよいアカウントが決まっている | 社内ルールの文面を見る | 会社の契約だけか、個人のアカウントも認めるかを決める |
| 入れてはいけない情報の例を社員が言える | 研修や面談で 3 つ挙げてもらう | 顧客の情報・社外秘・個人情報の例を書き出す |
| 文書の編集を研修で扱っている | 研修の内容を見る | 最初の回の題材にする |
| 社外に出す図や訳文の確認者が決まっている | 部署の手順を見る | 確かめる人と手順を決める |
| 社員が何に使っているかを聞いたことがある | アンケートの記録を見る | 上位 10 業務の表を選択肢にして聞く |
| 開発部門の使い方を別に把握している | 開発の責任者に聞く | このデータに入らない Codex なども含めて聞く |
【要注意】よくある読み違い4つ
読み違い1:割合を人数と読む
❌「日本の働く人の 28.5% が ChatGPT を仕事に使っている」
⭕「日本の個人向けプランのメッセージのうち、仕事に関係すると分類されたメッセージが 28.5%(2026年9月)。企業向けプランのメッセージは入っていない」
なぜ重要か:分母はメッセージで、人数でも会社の数でもありません。日本の会社での普及率としては使えません。
読み違い2:プログラミングに使う人が減った
❌「ChatGPT をプログラミングに使う人が減った」
⭕「日本の個人向けプランの分類済みの仕事のメッセージの中で、プログラミングの割合が 9.35% から 2.88% に下がった(2025年1〜3月から 2026年7〜9月)。Codex の利用は入っていない」
なぜ重要か:割合の変化は、件数の変化とは限りません。開発部門の研修を、この数字だけで後回しにしないでください。
読み違い3:経営の判断にいちばん使われている
❌「日本では ChatGPT が経営の判断にいちばん使われている」
⭕「大きい分類の『計画と意思決定』が 35.1% で最多(日本の個人向けプランの分類済みの仕事のメッセージ・2026年7〜9月・企業向けプランと Codex は含まない)。ただしその 4 割ほどは文章や文書の編集(14.51%)で、O*NET の分類でこの中に入っている」
なぜ重要か:分類の名前だけを見て研修の中身を決めると、実際に多い「文書を直す」使い方を教えそびれます。業務の単位まで下りて確かめます。
読み違い4:このデータで自社の使われ方が分かる
❌「これを見れば、うちの社員が ChatGPT を何に使っているか分かる」
⭕「分かるのは、個人向けプランの仕事のメッセージ全体の傾向。企業向けプランと Codex は入らず、データ辞書は仕事での利用を少なめに示している可能性が高いと書いている」
なぜ重要か:自社の使われ方は、業種や職種で変わります。上位 10 業務を選択肢にして、社内で聞いて確かめるのが確実です。
Uravationならこう判断する
正直に言うと、このデータだけで研修の中身を決めることはできません。個人向けプランの集計で、自社の社員の使い方とは違うからです。それでも、法人の研修を考える立場から見ると、次の判断には十分な材料になります。
- 研修の 1 コマ目は文書の編集にする:日米とも 7 つの四半期すべてで 1 位です。自分の文書を題材にすれば効果を本人が確かめやすく、何を入力してよいかの線引きも同時に練習できます
- 図やデザインと翻訳は、作らせ方より「出す前の確認」を先に教える:図やデザインは 1 年半で約 3 倍、翻訳などは米国の 2.6 倍です。どちらも社外に出る成果物になりやすく、確認の手順がないと誤りがそのまま外に出ます
- プログラミングの割合の低下を理由に、開発の研修を外さない:Codex は入っておらず、米国でも同じように下がっています。開発部門の使い方は、このデータとは別に確かめます
- ルールは研修の前に置く:このデータそのものが、個人向けプランで仕事が行われていることを示しています。使ってよいアカウントと入れてよい情報を決めてから、使い方を教えます
- 自社の数字は自社で取る:上位 10 業務の表を選択肢にしたアンケートを研修の前と後に取れば、自社で多い使い方とその変化が見えます。アンケートは答えた人の数、このデータはメッセージの割合なので、数字どうしを直接比べないでください
よくある質問
ChatGPT は仕事で何にいちばん使われていますか?
165 の業務の単位で数えると、日本では「文章や文書の編集」がいちばん多く、2026年7〜9月の個人向けプランの分類済みの仕事のメッセージの 14.51% でした。2 位は図やデザイン 6.66%、3 位は翻訳など 4.53% で、米国でも 1 位は文章や文書の編集(17.10%)です。大きい分類で数えると、日本では「計画と意思決定」35.1% が最多です。OpenAI Signals v3.0 を Uravation が集計した値で、企業向けプランと Codex は含みません。
日本の ChatGPT のメッセージのうち、仕事に関係するものはどれくらいですか?
日本の個人向けプランのメッセージのうち、仕事に関係すると分類されたメッセージは 2026年9月に 28.5% でした(世界全体は 32.2%、米国は 33.1%)。これはメッセージの中の割合で、使っている人の数や会社の数でも、使いこなしの度合いでもありません。分母には仕事以外のメッセージも入るので、世界全体や米国より低いからといって、日本で仕事に使う量が少ないとは限りません。企業向けプランのメッセージは入っていないため、データ辞書は仕事での利用を少なめに示している可能性が高いと説明しています。
ChatGPT Business や Enterprise の利用も入っていますか?
入っていません。OpenAI は企業向けプランのメッセージと Codex の利用を含まないと説明していて、データ辞書に載っているプランの種類も free・go・plus・pro の 4 つ(無料版と有料の個人向けプラン)です。会社が契約した ChatGPT での使い方を知りたい場合は、このデータではなく、自社の利用状況を確かめる必要があります。企業での AI の導入状況は、OpenAI の「Enterprise Signals」が業界や職能別に追っています。
日本と米国でいちばん違う業務は何ですか?
上位 10 の業務の中で差が大きいのは翻訳など(言語、文化、宗教に関する情報の解説)です。2026年7〜9月の個人向けプランの分類済みの仕事のメッセージで、日本は 4.53%(3 位)、米国は 1.71%(13 位)でした。違う理由は、このデータからは分かりません。
このデータは社内資料や記事に使えますか?
使えます。OpenAI Signals のデータは CC BY 4.0 のライセンスで提供されていて、利用・共有・改変ができますが、出典の明示か引用が必要です。引用の名前は「OpenAI Signals v3.0」です。国や期間で絞り込んだり足し上げたりした場合は、そのことも書き添えます。
社員研修は何から始めればよいですか?
このデータからは「文章や文書の編集」から始めるのが自然です。日本の個人向けプランの分類済みの仕事のメッセージで 14.51%(2026年7〜9月)と 2 位の 2 倍以上あり、7 つの四半期すべてで 1 位でした。研修の前に、仕事で使ってよいアカウントと入れてよい情報を決め、自社の使い方は上位 10 業務の表を選択肢にして社内で確かめてください。
まとめ
OpenAI が10月26日に公開した OpenAI Signals v3.0 を日本の行で集計すると、ChatGPT が仕事に使われる業務の 1 位は文章や文書の編集(14.51%)で、図やデザイン(6.66%)、翻訳など(4.53%)が続きました(2026年7〜9月・個人向けプランの分類済みの仕事のメッセージ)。1 年半でプログラミングの割合は約 3 分の 1 に、図やデザインは約 3 倍になっています。企業向けプランと Codex は入らず、分母はメッセージです。研修は文章や文書の編集から始め、その前に仕事で使ってよいアカウントと入れてよい情報を決める。これが、このデータを踏まえた順番です。
あわせて読みたい:
- ChatGPTビジネス活用ガイド|業務別の使い方と7プラン比較(業務別の使い方とプランの違い)
- 部門別AI研修の設計法|営業・経理・人事でカリキュラムをどう変えるか(部門ごとの研修の組み立て)
著者:佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。
100社以上の企業向けAI研修・導入支援。著書『AIエージェント仕事術』『Claude仕事術』(SBクリエイティブ・書籍シリーズ累計66,000部)、『AI推進担当になったら読む本』(大和書房)。
SBクリエイティブ「ビジネス+IT」ほかで生成AI連載を執筆(NewsPicks最大1,125ピックス)。
今日から始める3つのアクション
- 今日やること:ChatGPT を仕事に使っている社員に、この記事の上位 10 業務のどれに使っているかを聞く
- 今週中:仕事で使ってよいアカウントと、入れてよい情報・入れてはいけない情報を 1 枚に書き出す
- 今月中:文書の編集を題材に社内の勉強会を 1 回開き、終わったら同じ区分で使い方を聞き直す
ご質問・ご相談はお問い合わせフォームからお気軽にどうぞ。
参考・出典
- 広がる ChatGPT の仕事の世界(OpenAI・2026年10月26日)(参照日: 2026-10-28)
- ChatGPT’s expanding world of work(OpenAI・英語版・2026年10月26日)(参照日: 2026-10-28)
- データと方法論(OpenAI Signals)(参照日: 2026-10-28)
- OpenAI Signals README・データ辞書(Version 3.0)(参照日: 2026-10-28)
- OpenAI Signals v3.0 の CSV 一式(zip・約 2MB)(参照日: 2026-10-28)
- OpenAI Signals(OpenAI)(参照日: 2026-10-28)
- DWA Reference – ONET 30.0 Data Dictionary(ONET Resource Center・米国労働省 雇用訓練局)(参照日: 2026-10-28)
- ChatGPTがどんな仕事に使われているのかわかるレポートが公開される(GIGAZINE・2026年10月27日・報道)(参照日: 2026-10-28)
- ChatGPT、仕事での利用が多様化 日本では「計画・意思決定」が最多(Impress Watch・2026年10月27日・報道)(参照日: 2026-10-28)
- 本文の日本と米国の割合:OpenAI Signals v3.0(CC BY 4.0)を Uravation が日本・米国の行で集計(国と四半期で絞り込み、割合を % に直して並べ替え、O*NET の上の階層で足し上げた)
この記事の内容を社内展開する方へ: ChatGPT Work 仕事の任せ方キット(無料・PDF 32ページ+Excel/Word) をダウンロードできます。