

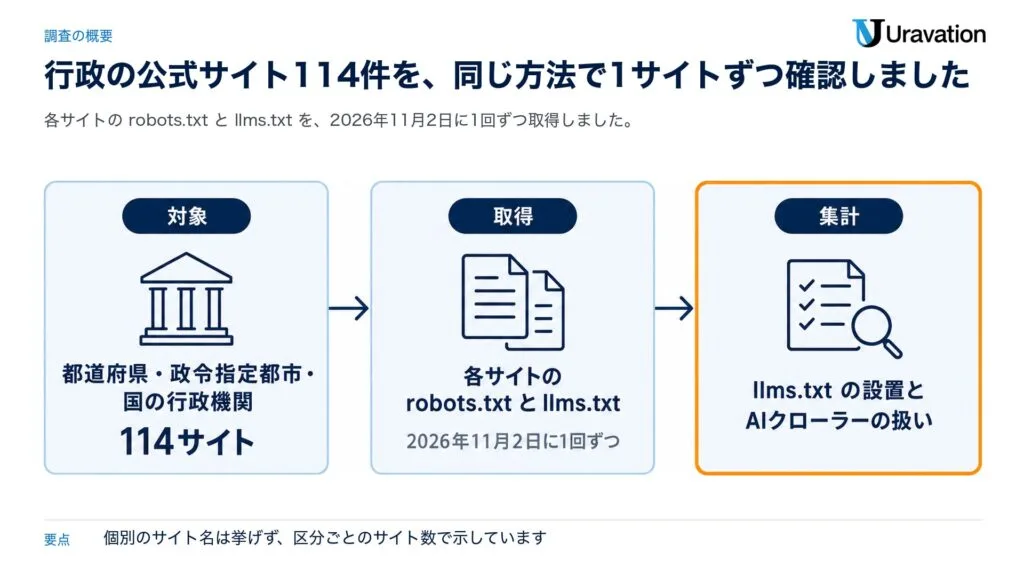
生成AIの研修・コンサルティング・開発を行う株式会社Uravation(本社:東京都文京区、代表取締役:佐藤 傑)は、47都道府県・20政令指定都市・府省庁など国の行政機関の公式サイト計114サイトについて、「robots.txt」でのAIクローラーの扱いと、AI向けのサイト案内ファイル「llms.txt」の設置を2026年11月2日に調べました。robots.txtに応答のあった106サイトのうち104サイト(98.1%)には、AIクローラーの記載がありませんでした。サイト名は挙げず、区分ごとの数で示します。
調査の要点
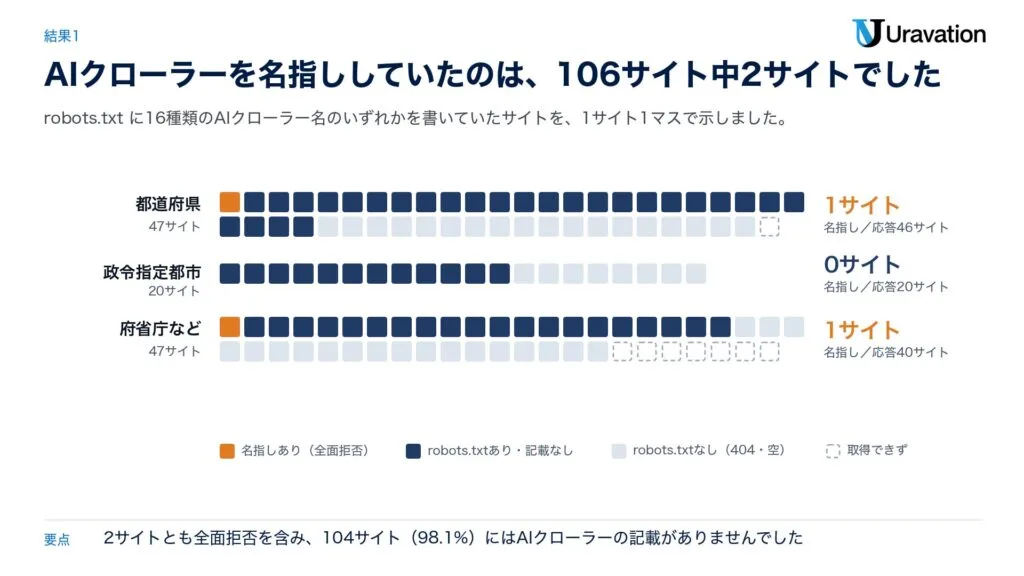
- AIクローラーの名指しは106サイト中2サイト(1.9%)で、2サイトとも全面拒否を含みます
- llms.txtの設置は103サイト中1サイト(1.0%)。都道府県と政令指定都市は0でした
- すべてのクローラーにサイト全体を拒否していたサイトは0でした
調査の背景
OpenAI・Anthropic・Perplexityは、AI検索で使うクローラー(OAI-SearchBot、Claude-SearchBot、PerplexityBot)を公開しています。OpenAIは、OAI-SearchBotを拒否したサイトはChatGPTの検索の回答に表示されない(リンクとして出ることはある)としています。学習用のクローラーについては、文化審議会著作権分科会法制度小委員会の「AIと著作権に関する考え方について」(2024年3月15日)が、robots.txtでのアクセスの制限を、サイトの管理者の判断で行える技術的な措置の例に挙げています。
結果1:AIクローラーを名指ししていたのは106サイト中2サイト(1.9%)
16種類のAIクローラー名のいずれかを書いていたのは、都道府県46サイト中1、政令指定都市20サイト中0、府省庁など国の行政機関40サイト中1の計2サイトで、どちらも、いずれかを全面拒否(Disallow: /)していました。
ボット別の全面拒否はGPTBot、OAI-SearchBot、Bytespiderが各1サイトで、Amazonbotは巡回の間隔(Crawl-delay)だけの名指しが1サイトです。ClaudeBot、Claude-SearchBot、PerplexityBot、Google-Extendedなど残りの12種類は、どのサイトにも書かれていませんでした。
結果2:llms.txtを置いていたのは103サイト中1サイト(1.0%)
llms.txtに応答のあった103サイトのうち、設置していたのは国の行政機関の1サイトで、都道府県(46サイト)と政令指定都市(20サイト)は0でした。100サイトは404(ファイルなし)、2サイトはエラーのページに転送されました。
結果3:robots.txtのテキストが返ったのは106サイト中61サイト(57.5%)
区分ごとでは、都道府県が60.9%(46サイト中28)、政令指定都市が60.0%(20サイト中12)、府省庁など国の行政機関が52.5%(40サイト中21)で、残る45サイトは404(ファイルなし)か中身が空のファイルでした。名前の書かれていないクローラーには「」(すべてのクローラー)向けの規則が当てはまり(RFC 9309)、「」向けにサイト全体を拒否していたサイトは0でした。
区分ごとの結果
数字は「該当するサイト数/応答のあったサイト数」です。
- 都道府県(47サイト):robots.txt 28/46、llms.txt 0/46、AIクローラーの名指し 1/46
- 政令指定都市(20サイト):robots.txt 12/20、llms.txt 0/20、AIクローラーの名指し 0/20
- 府省庁など国の行政機関(47サイト):robots.txt 21/40、llms.txt 1/37、AIクローラーの名指し 1/40
- 参考:日経225構成銘柄(2026年10月23日の当社調査):robots.txt 102/184、llms.txt 9/180、AIクローラーの名指し 9/184
当社の見方
行政の公式サイトの98.1%は、robots.txtでAIのクローラーをほかのクローラーと分けて扱っていませんでした。当社では、サイトの運営者が先に確かめることは2点あると考えています。1点目は、学習用のクローラーを止める場合に、AI検索用のクローラーまで止めていないか。2点目は、よく聞かれる質問に一次情報で答えるページを、AIにも分かる形で示せているかです。llms.txtはその示し方の一つです。
調査の方法
- 期間:2026年11月2日15時3分〜20分(公式サイトの確認と、robots.txt・llms.txtの取得)
- 対象:全国知事会「都道府県情報」の47都道府県、総務省「指定都市一覧」の20市、e-Govポータル「国の行政機関」の59機関(外局・特別の機関などを含む)。ほかの機関と同じサイトの中にある12機関をまとめて数え、計114サイトです
- 取り方:各サイト直下の /robots.txt と /llms.txt を1サイトずつ、1.5秒以上の間隔を空けて取得しました。当社の調査と分かる名前を名乗り、ブラウザを装っていません。失敗した分だけ1回取り直しました
- 判定:日経225構成銘柄の調査と同じ基準です。llms.txtはHTTP 200でテキストが返ったものを設置ありとし、robots.txtは16種類のAIクローラー名(GPTBot、OAI-SearchBot、ClaudeBot、PerplexityBotなど)ごとに、全面拒否・一部拒否・名指しで許可・記載なしに分けました
- 取得できず:アクセス拒否(403)と接続の失敗は分母から外しました(robots.txtは8サイト、llms.txtは11サイト)
調査の限界
- robots.txtはクローラーへの意思表示で、アクセスを制限する仕組みではありません(RFC 9309)。実際の読み取りは各社のクローラーの作りによります
- 2026年11月2日時点の状態です。サイト直下以外のllms.txtと、別のドメインの特設サイトは対象外です