結論:2026年10月3日時点のLangfuseは、LLMアプリやAIエージェントの実行内容を追跡し、品質を評価し、プロンプトと検証用データを管理するオープンソースのAIエンジニアリング基盤です。AIエージェント自体を動かす製品ではなく、動いている処理を観測して改善につなげます。
- できること:トレース、オンライン/オフライン評価、プロンプト管理、データセット実験を一つの画面とAPIで扱えます。
- 料金:Langfuse Cloudは無料のHobbyからEnterpriseまで4段階。OSS版はライセンス料とUnit課金がありませんが、インフラと保守は自社負担です。
- 選び方:まず1回の処理が何Unitになるか、必要な過去データ参照期間、データ所在地、SSO・監査要件、セルフホストの運用者を確認します。
向いている読者:OpenAI、LangChain、独自SDKなどでLLMアプリを開発し、「遅い・高い・品質が揺れる」の原因を処理単位で追いたい開発責任者、情報システム部門、AI推進担当者です。
最初にすること:代表的な1業務を選び、成功・失敗の判定基準を決めてから、Hobbyまたは検証用セルフホスト環境にトレースを1本送ります。
よくある誤解は、「Langfuseを入れればAIエージェントが動き、品質も自動で上がる」というものです。実際には、Langfuseはエージェントのホスティングや実行を担いません。公式も、エージェントを実行する製品ではないと明記しています。OpenAIやLangChain、LangGraph、自社コードなどが実行した処理を記録し、どこで失敗したか、どのプロンプト版が良かったかを判断するための基盤です。
「オープンソースなら本番運用も無料」という見方にも注意が必要です。自前ホストでは製品利用料が無料でも、データベース、保存、バックアップ、更新、障害対応を自社が担います。Cloudとの違いは運用責任の置き場所です。
Langfuseは「実行基盤」ではなく改善の計器盤
Langfuseの役割は、LLMアプリの入力から最終出力までを一つの処理としてつなぎ、その途中を観測可能にすることです。公式のデータモデルは、個々の処理を表すObservation、1回のリクエストを束ねるTrace、複数のTraceにまたがる会話を束ねるSessionという階層で整理されています。
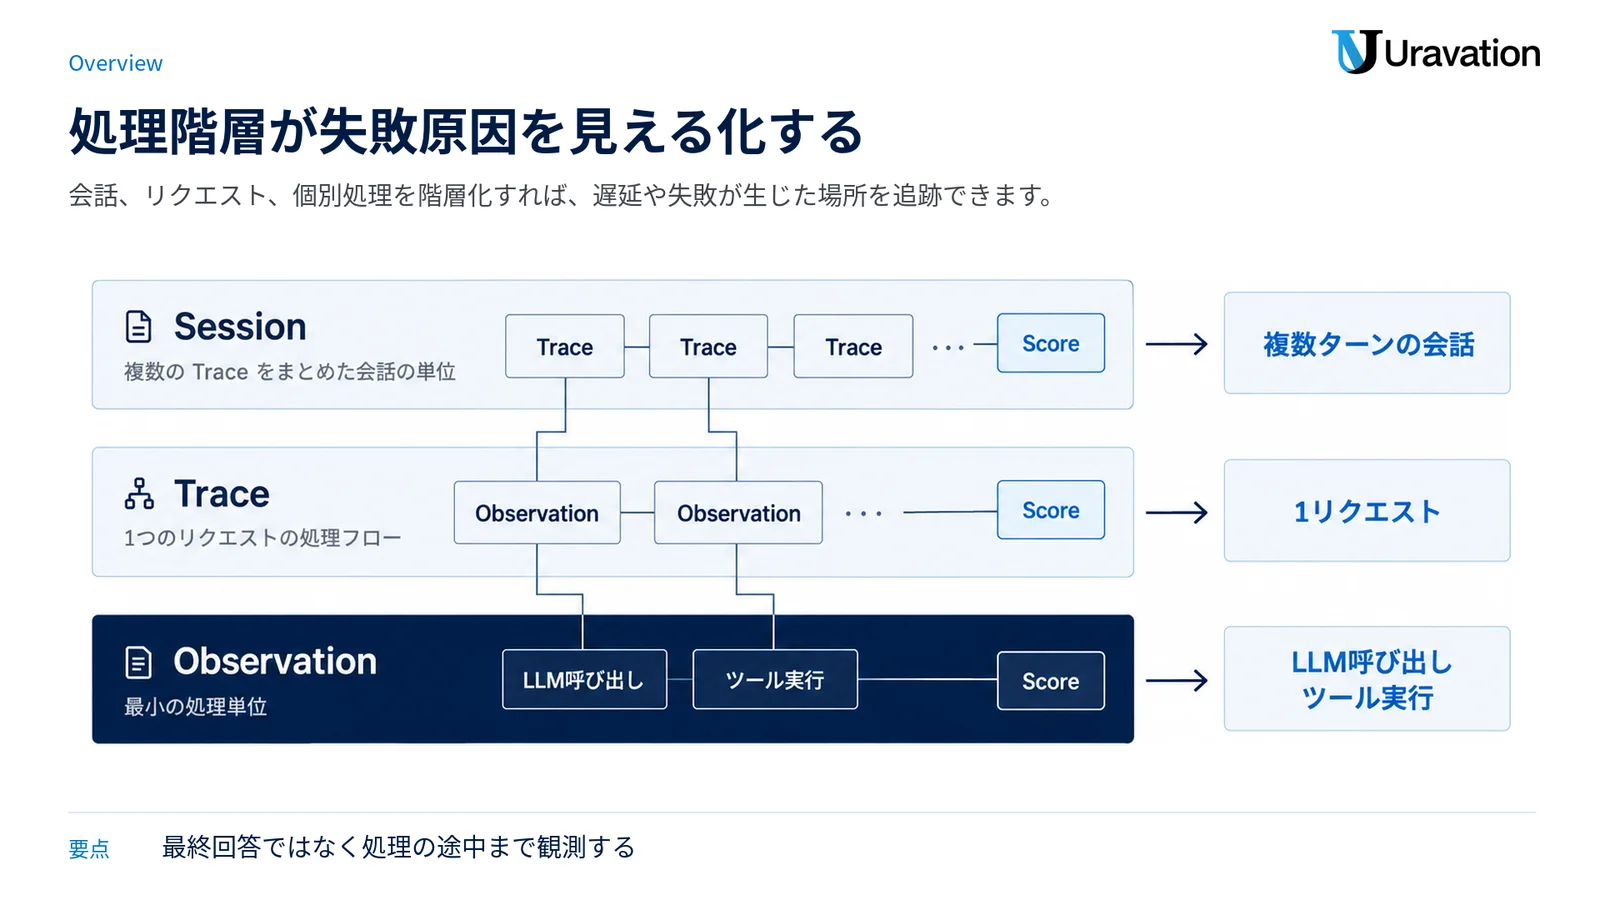
- Observation:LLM呼び出し、ツール実行、検索、埋め込み、ガードレールなどの個別処理
- Trace:ユーザーからの1リクエストや、AIエージェントが一つのタスクを終えるまでの処理
- Session:複数ターンの会話、継続する問い合わせ、同じ業務スレッド
これにより、最終回答だけを見て「なんとなく悪い」と判断する状態から抜け出せます。たとえば、検索結果は取得できたのに要約段階で情報を落としたのか、外部ツールがタイムアウトしたのか、再試行が増えて料金と遅延が膨らんだのかを、処理の階層に沿って確認できます。詳しいデータ構造はLangfuse公式のObservability Data Modelで確認できます。
複数の監視製品を含む全体設計を先に整理したい場合は、UravationのAIエージェント観測・評価完全ガイドもあわせて確認してください。今回の記事は、その中でもLangfuse単体の現行機能・料金・導入判断に絞っています。
OpenTelemetryを土台にPython・JS以外にも接続できる
現行SDKはOpenTelemetry基盤です。PythonとJavaScript/TypeScriptに加え、OpenTelemetry経由でJava、Go、独自実装からも送信でき、モデルやフレームワークをまたぐ観測軸を作れます。
ただし、SDKだけでは業務上の成否は分かりません。Trace名、セッション、環境、リリース、プロンプト版、業務結果のScoreまで設計して初めて運用判断に使えます。
記録から改善までをつなぐ4つの機能
Langfuseの価値は、ログ閲覧だけではなく、観測した事実を評価と変更管理へつなげられる点にあります。4機能は別々に導入するより、「記録する→悪い処理を見つける→再現用データにする→変更案を比較する」という循環で使うと理解しやすくなります。
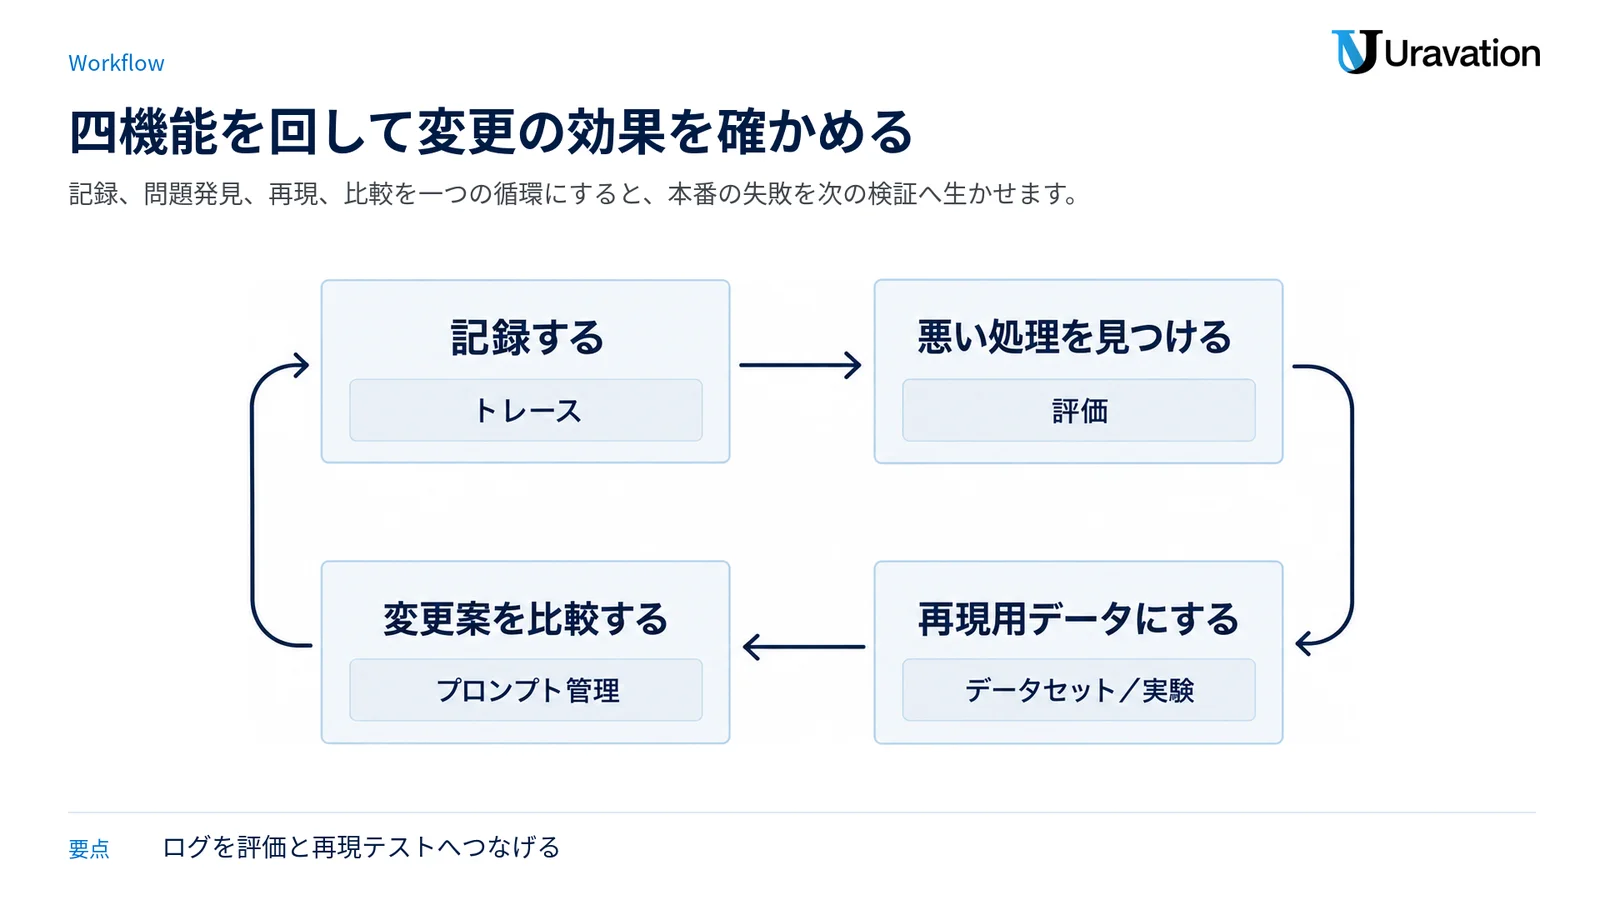
| 機能 | 確認・管理できるもの | 法人運用での使いどころ |
|---|---|---|
| トレース | 入力、出力、モデル、トークン、コスト、遅延、エラー、ツール・検索の順序 | 失敗箇所と再試行、ループ、遅い処理の特定 |
| 評価 | LLM-as-a-Judge、コード評価、人手評価、ユーザーフィードバック、独自Score | 品質基準を数値・カテゴリ・真偽・テキストで残す |
| プロンプト管理 | 本文、変数、バージョン、ラベル、キャッシュ、Traceとの関連 | 本番版の切り替え、比較、問題発生時の切り戻し |
| データセット/実験 | 入力、期待出力、実験Run、候補モデル・プロンプトのScore | 変更前後を同じ検証条件で比較し、公開判断を残す |
トレース:答えではなく「答えができるまで」を見る
トレースでは、プロンプトとモデル出力だけでなく、トークン使用量、コスト、遅延、エラー、取得した文書、ツール呼び出し、タグ、ユーザー、セッションなどを記録できます。AIエージェントではObservationの入れ子から処理グラフを表示できるため、同じツールを何度も呼ぶループや、どの経路で停止したかを追いやすくなります。公式の対象範囲はObservability Overviewにまとまっています。
評価:本番監視と公開前テストを同じScoreで扱う
評価には、本番Traceへ継続的に付けるオンライン評価と、データセットに候補版を実行するオフライン評価があります。評価方法はLLM-as-a-Judgeだけではありません。コードによる判定、人手アノテーション、利用者の反応、外部パイプラインの結果もScoreとして保存できます。Scoreは数値、カテゴリ、真偽、テキストに対応し、Trace、Observation、Session、実験Runなどへ関連付けられます。
2026年9月23日の公式ブログでは、利用者の不満、訂正、再質問、解決確認といった会話シグナルを捉える例が紹介されました。社内AIエージェントでは、単発回答の正誤だけでなく、「同じ質問が続いた」「人への引き継ぎが必要だった」「最後に解決した」という会話単位の結果も評価対象にできます。これは機能の新設を断定するものではなく、既存の評価基盤を会話品質に使う公式の運用例です。
プロンプト管理:コード変更と文面変更を切り分ける
Prompt Managementでは、Text/Chatプロンプトを中央管理し、変更ごとに不変のバージョンを残せます。productionやlatest、任意のラベルは特定バージョンへのポインタとして働きます。Traceと使用したプロンプト版を結び付ければ、「回答品質が落ちたのはモデル変更か、検索処理か、プロンプト変更か」を切り分けやすくなります。
注意したいのはキャッシュです。公式ドキュメントでは、SDKの既定キャッシュTTLは60秒です。更新直後に旧版が短時間返る可能性を踏まえ、緊急切り戻しの手順や検証方法を決めておく必要があります。詳細はPrompt Management OverviewとPrompt Cachingで確認できます。
データセット:失敗Traceを再現可能な検証材料に変える
Datasetは、入力と任意の期待出力を持つDataset Itemの集合です。同じDatasetに対して、プロンプト、モデル、アプリコードの候補を実行し、結果を比較できます。良い検証にするには、同じDataset VersionとEvaluator定義を使い、アプリのコミット、プロンプト版、モデル版、評価器版をメタデータとして残します。
本番の失敗をDatasetへ追加すれば、修正後の再発を検査できます。元TraceとDataset Itemの保持は別で、実験中のTraceやScoreは保持ポリシーの対象です。残す証跡を導入時に決め、公式のDatasetsで仕様を確認してください。
料金はUnit数と運用責任で読む
Langfuse Cloudの請求単位は、ユーザー数でも単純なリクエスト数でもありません。公式の定義は「Trace数+Observation数+Score数」です。たとえば、1回のエージェント実行で1 Trace、10 Observation、2 Scoreが作成されれば13 Unitsです。LLM-as-a-Judgeや実験が作るTrace、Observation、ScoreもUnitに含まれるため、本番アクセス数だけから費用を見積もるとずれます。
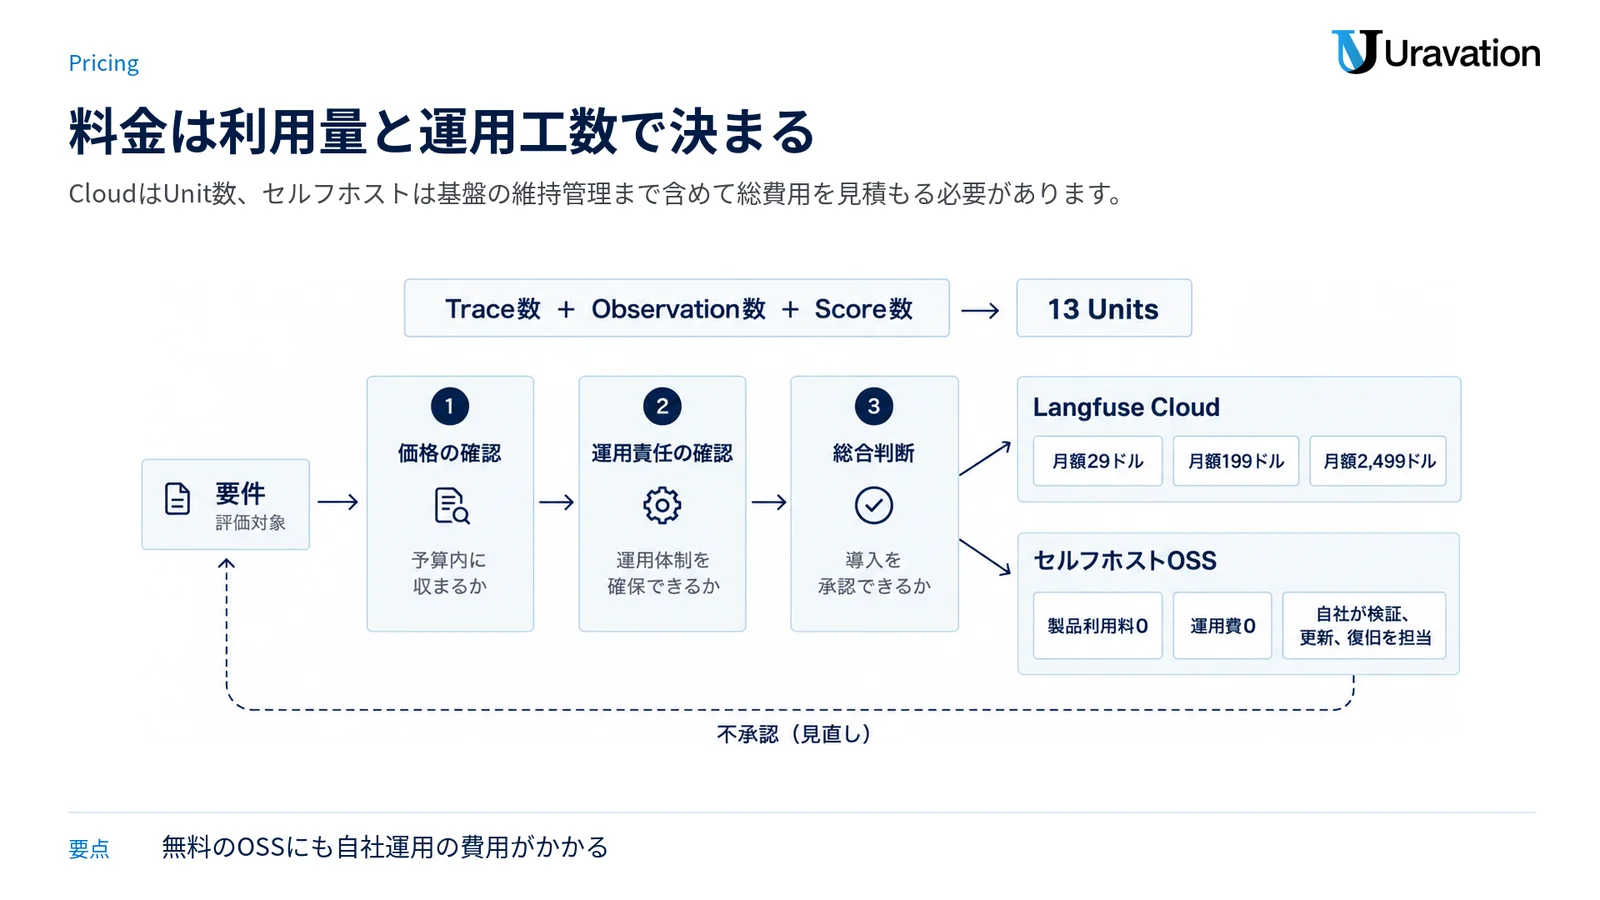
次の料金は、2026年10月3日にLangfuse Pricingで確認した米ドル建ての表示です。税、為替、個別契約条件は含めず、契約前に公式画面で再確認してください。
| Cloudプラン | 基本料金 | 含有Unit/月 | 過去データ参照 | 主な上限・特徴 |
|---|---|---|---|---|
| Hobby | 無料 | 50,000 | 30日 | 2ユーザー、取り込み1,000件/分、Annotation Queue 1、Alert 2 |
| Core | 月額29ドル | 100,000 | 90日 | ユーザー無制限、取り込み4,000件/分、Annotation Queue 3、Alert 20 |
| Pro | 月額199ドル | 100,000 | 3年 | 取り込み20,000件/分、Annotation Queue無制限、Alert 50、保持期間管理 |
| Enterprise | 月額2,499ドルと表示 | 100,000 | 3年 | カスタム制限、Alert 100、監査ログ、SCIM、SLA |
Core、Pro、Enterpriseは100,000 Unitsを超える最初の段階が100,000 Unitsあたり8ドルで、量に応じて単価が下がります。Hobbyには追加単価の表示がありません。ProのTeams Add-onは月額300ドル。Enterpriseの契約期間や個別条件は営業窓口への確認が必要です。
セルフホストは「製品利用料0」と「運用費0」を分ける
Self-Hosted Pricingでは、OSS版のコア機能とAPI、Unit、Project、Userが無料・無制限と案内されています。コア部分はMITライセンスですが、リポジトリ内のEnterprise Edition用ディレクトリは別ライセンスです。「全コードが無条件にMIT」とは言えません。
セルフホストではClickHouse、PostgreSQL、Redis/Valkey、S3互換ストレージなどを自社で管理します。Docker Composeはローカル検証や単一VMで試すには分かりやすい一方、公式ガイドは高可用性、拡張、バックアップを備えない構成だと注意しています。本番では、Kubernetes/Helmやクラウド別テンプレートの検討に加え、復旧試験、容量監視、更新の検証、脆弱性対応まで担当を置く必要があります。
| 判断軸 | Langfuse Cloud | セルフホストOSS |
|---|---|---|
| 開始の速さ | アカウントとキーの準備後に接続しやすい | データベース、ストレージ、認証、ネットワークの構築が必要 |
| 費用の中心 | プラン基本料金とUnit課金 | インフラ、バックアップ、監視、保守担当の工数 |
| データ所在地 | US、EU、JP。Pro以上はHIPAA向けリージョンも選択肢 | 自社が選ぶ環境に置ける |
| 更新・障害対応 | サービス側が基盤を運用 | 自社が検証、更新、復旧を担当 |
| 向く条件 | 運用負荷を抑え、機能検証を早く始めたい | 閉域・データ統制要件があり、基盤運用者を確保できる |
日本リージョンは東京のAWS ap-northeast-1です。リージョン間は分離されているため、契約時にデータ所在地を決めます。Cloud、自前ホストのどちらでも、送信前マスキング、権限、保存、削除、監査のルールは必要です。
LangSmithとの違いは所属する開発基盤と運用の置き場所
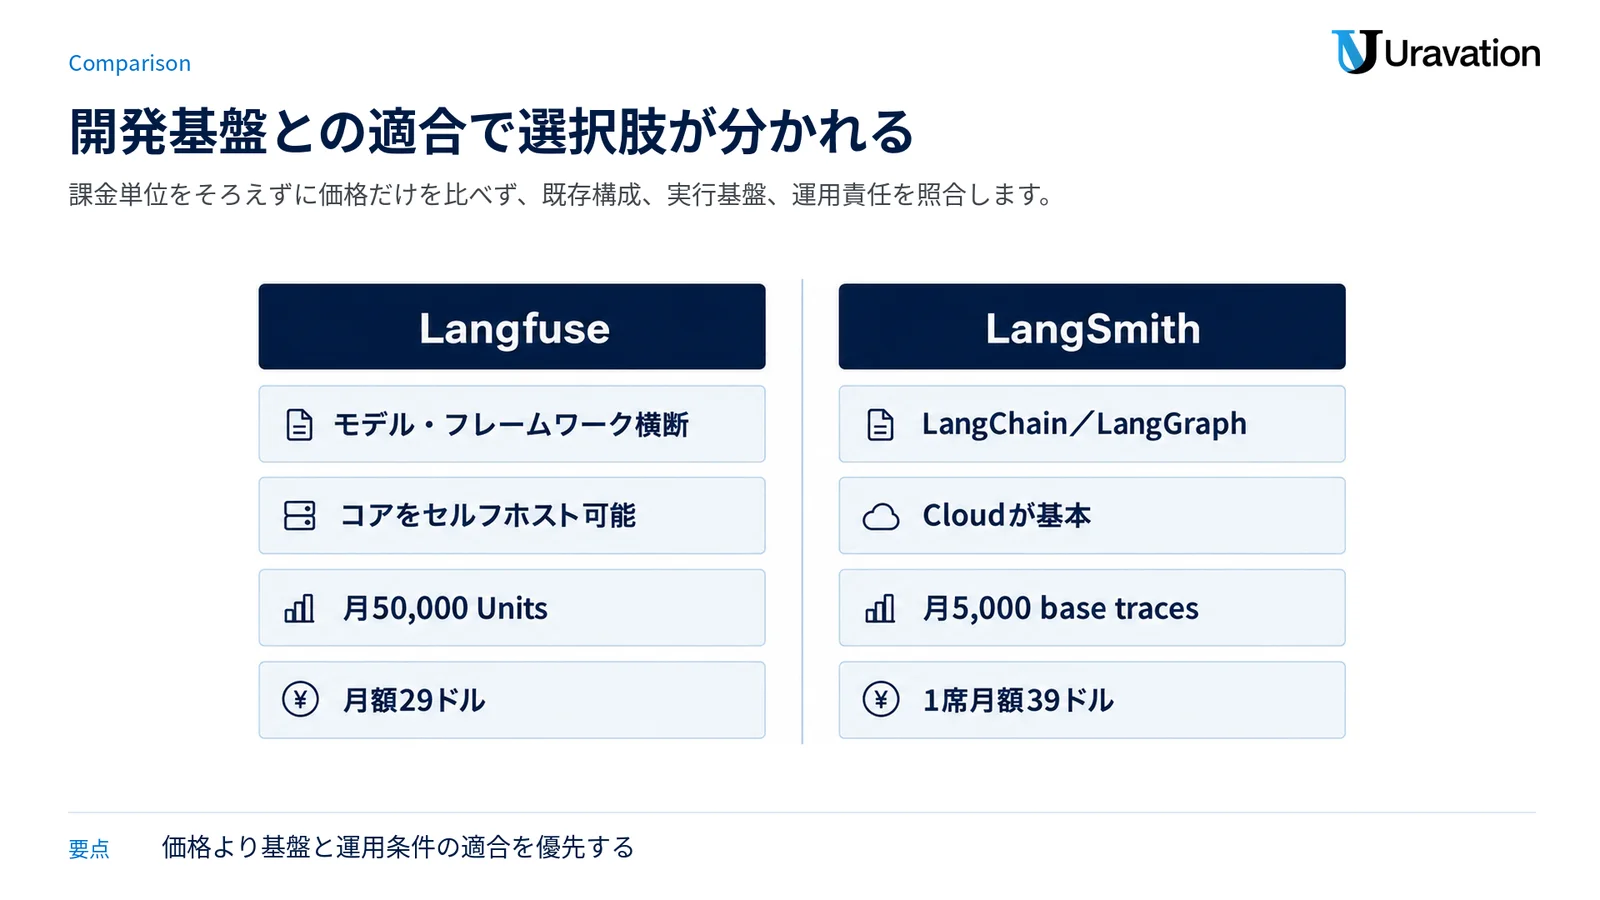
LangfuseとLangSmithは、どちらもLLMアプリのトレースや評価を扱うため比較されます。ただし、料金単位も提供範囲も異なり、「どちらが常に安い」とは言えません。LangfuseはTrace、Observation、Scoreの合計をUnitとして数えます。LangSmithはTraceとLangChain Standard Unitなどの体系を使います。想定する処理を両方の計算方法に当てて比べる必要があります。
| 比較軸 | Langfuse | LangSmith | 判断の目安 |
|---|---|---|---|
| 製品の立ち位置 | モデル・フレームワーク横断の観測、評価、プロンプト、実験 | LangChain/LangGraphとつながる観測、評価、開発・デプロイ機能 | 既存のアプリ構成と将来の実行基盤を見る |
| オープンソース | コアをセルフホスト可能 | Cloudが基本。Hybrid/Self-HostedはEnterpriseの選択肢 | 自社運用の必要性と担当者を確認 |
| 無料枠 | Hobbyは月50,000 Units、2ユーザー | Developerは1席、月5,000 base traces | 単位が違うため件数だけで比較しない |
| 有料入口 | Coreは月額29ドル、ユーザー無制限 | Plusは1席月額39ドル、月10,000 base tracesを含む | 人数とTrace内の処理数を含めて試算 |
| ホスティング | CloudまたはセルフホストOSS/Enterprise | Cloud、EnterpriseでHybrid/Self-Hosted | データ所在地、閉域、運用責任を照合 |
LangSmithの2026年10月3日時点の料金とホスティング条件は、LangChain公式のLangSmith Plans and Pricingで確認しました。LangChain/LangGraph中心でデプロイまで一体化したいならLangSmith、複数のモデルやフレームワークをOpenTelemetryで横断し、OSSセルフホストも選びたいならLangfuseを先に比較する、というのが一つの判断軸です。これは機能の優劣ではなく、現行の公式仕様から導く選定目安です。
LangGraphとの違いは「動かす」と「観測する」
LangGraphは、状態を持つエージェントやワークフローの処理を組み立てて実行するフレームワークです。Langfuseはその実行イベントをトレースし、評価・改善します。競合というより役割が違い、LangChain/LangGraph用のCallbackHandlerを通じて併用できます。実行グラフを設計するのがLangGraph、実行後の挙動を追うのがLangfuse、と分けると迷いにくくなります。
社内AIエージェントで監視するべき8項目
ダッシュボードへ何でも送ると、件数は増えても判断できません。社内AIエージェントでは、業務結果から逆算して次の8項目を設計すると、障害対応と改善を同じデータで進めやすくなります。
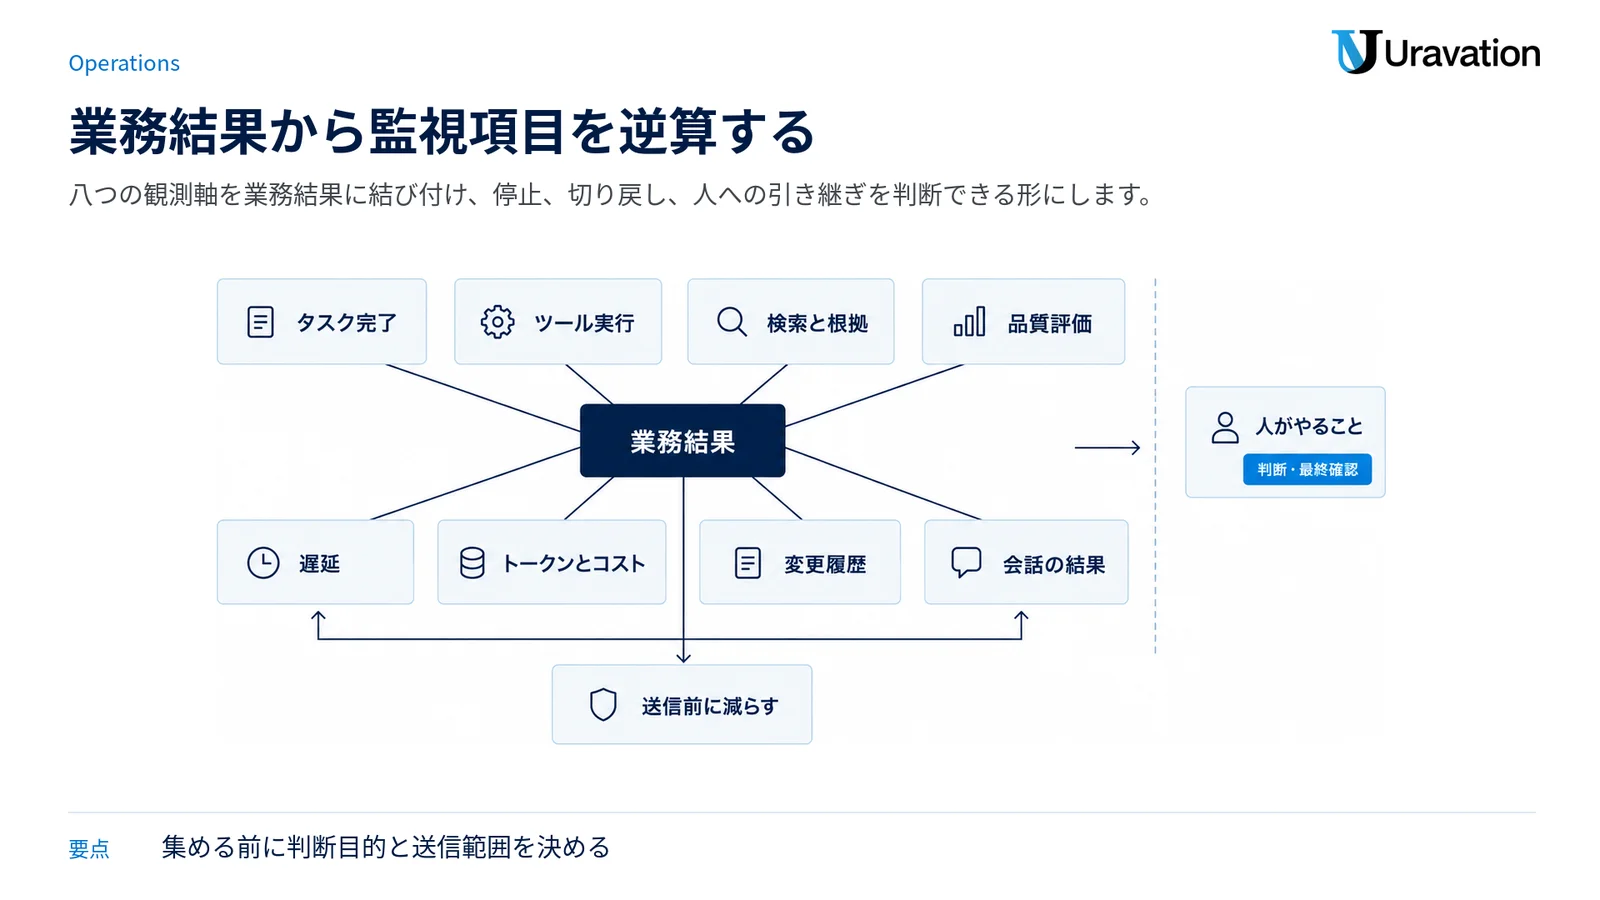
- タスク完了:依頼が完了したか、途中で停止したか、人へ引き継いだかをScoreやタグで残します。
- ツール実行:どのツールを何回呼び、成功・失敗・タイムアウト・再試行のどれだったかをObservationで追います。
- 検索と根拠:参照した文書、検索結果、最終回答への反映を分け、取得失敗と回答生成失敗を切り分けます。
- 品質評価:正確性、根拠性、形式遵守、業務ルール違反などを、コード、人手、LLM-as-a-Judgeで評価します。
- 遅延:全体時間だけでなく、モデル、検索、外部API、ツールごとの処理時間を見ます。
- トークンとコスト:モデル、機能、ユーザー、セッション、プロンプト版ごとに使用量を分解します。
- 変更履歴:アプリのrelease、environment、モデル、プロンプト版、評価器版を関連付けます。
- 会話の結果:訂正、再質問、否定的反応、解決確認、離脱などをSession単位で追います。
万能な合格ラインはありません。業務要件を基準に、誰が確認し、どの条件で停止・切り戻し・人への引き継ぎを行うかまで決めます。KPI設計はAIエージェント評価KPI完全ガイドで整理しています。
機密情報は「保存後に隠す」より送信前に減らす
プロンプト、取得文書、ツール引数、モデル出力には、個人情報や社内情報が入り得ます。Langfuseはクライアント側のマスキングを案内していますが、何を送るかを決める責任は導入企業側に残ります。氏名やメールアドレスを置換するだけでなく、業務上不要な本文を記録しない、識別子を仮名化する、権限を分ける、保持期間後の削除を確認する、といった多層の対策が必要です。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修4,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
法人導入は先に5つの設計を決める
導入の順番は、SDKのインストールから始めるより、判断に使う情報を先に決める方が安全です。次の5項目を短い設計書にしてから実装へ進みます。
1.対象業務と失敗の定義
「AIチャット全体」のように広く始めず、社内FAQ回答、議事録からのタスク抽出、問い合わせ分類など、完了条件が分かる1業務を選びます。誤回答、根拠不足、ツール失敗、未完了、過剰な再試行など、監視したい失敗を列挙します。
2.Trace・Observation・Sessionの境界
どこからどこまでを1 Traceとするか、ツールや検索をどのObservationにするか、複数ターンをどのSession IDで束ねるかを決めます。境界がチームごとに違うと、横断集計とUnit試算が崩れます。
3.評価方法と確認担当
自動評価だけに寄せず、コードで確定できる形式チェック、人が見るべき業務判断、LLM-as-a-Judgeに向く言語品質を分けます。低評価を誰が確認し、Datasetへ追加し、改善版の公開を承認するかも決めます。
4.Cloudとセルフホストの責任分界
PoCの速さだけで選ばず、データ所在地、閉域接続、認証、監査、保持、復旧時間、運用時間を比較します。セルフホストを選ぶなら、構築担当ではなく、継続して更新と障害対応を担う所有者を明記します。
5.費用の試算
代表的なTraceを実際の構造に近い形で作り、1 TraceあたりのObservationとScoreを数えます。それに想定件数を掛けてCloudのUnitを試算します。セルフホストは、計算資源、データベース、保存容量、バックアップ、監視、保守工数を含めます。モデルAPI料金はLangfuse料金とは別に管理します。
社内AIエージェントの構築パターンを先に確認したい場合は、AIエージェント開発実績とResponses API実践ガイドが参考になります。
Python・JS・OpenAI・LangChainへの組み込み
2026年10月3日時点の公式互換性ページでは、Serverはv4、Python SDKはv4、JavaScript/TypeScript SDKはv5が現行です。古い記事にあるlangfuse.trace()などのAPIを、そのまま現行コードへ混ぜないでください。GitHub上のOSS最新リリースは同日時点でv4.50.0です。Cloudの提供状態とGitHubのリリース番号は同一視せず、セルフホストでは公式のVersions & CompatibilityとGitHub Releasesを確認して更新します。
以下はすべて公式ドキュメントにある例の短い抜粋で、Uravation編集部では実行していません。パッケージの対応バージョン、初期化、環境変数、終了時のflush、エラーハンドリングを公式ページで確認してから検証環境へ入れてください。Secret Keyはコードや記事に書かず、シークレット管理へ保存します。
Python SDKで独自処理をトレースする
公式の例・編集部未実行:pip install langfuse後、クライアントを取得し、Observationのコンテキスト内で処理します。
from langfuse import get_client

langfuse = get_client()

with langfuse.start_as_current_observation(
    as_type="span",
    name="process-request"
) as span:
span.update(output="Processing complete")出典:Get Started with Tracing。短時間で終了するスクリプトでは送信完了を待つ処理が必要になるため、公式のflush説明も確認してください。
JavaScript/TypeScriptで独自処理を囲む
公式の例・編集部未実行:OpenTelemetryの初期化を完了したうえで、@langfuse/tracingの関数を使う最小部分です。
import { startActiveObservation } from "@langfuse/tracing";

await startActiveObservation("user-request", async (span) => {
  span.update({ input: { query: "..." } });
});出典:Get Started with Tracing。パッケージの導入だけでなく、@langfuse/otelとNode SDKを含むOpenTelemetry設定が必要です。
OpenAI Python SDKをラップする
公式の例・編集部未実行:OpenAI SDKのimportをLangfuseのラッパーへ置き換え、通常のクライアント呼び出しを使います。
from langfuse.openai import openai

client = openai.OpenAI()
response = client.responses.create(
    model="gpt-4o",
    input="Hello!"
)出典:OpenAI Python Integration。ストリーミングやbeta APIなどは対応範囲が異なる場合があるため、利用するOpenAI APIごとに公式の注意事項を確認します。
LangChain/LangGraphへCallbackHandlerを渡す
公式の例・編集部未実行:既存のchainへCallbackHandlerを渡す中心部分です。
from langfuse.langchain import CallbackHandler

handler = CallbackHandler()
response = chain.invoke(
    {"topic": "cats"},
    config={"callbacks": [handler]}
)出典:LangChain & LangGraph Integration。LLM、Tool、RetrieverなどのイベントがObservationとして記録されます。既存の独自Spanと併用する場合は、Traceが意図せず分かれないかを検証してください。
導入後に起きやすい4つの失敗
❌ すべての本文と属性をそのまま保存する
⭕ 必要な項目だけを定義し、送信前にマスキングする。デバッグに便利でも、権限のない担当者が機密情報を閲覧できれば運用事故になります。入力・出力の保存可否、仮名化、保持、削除、閲覧権限をデータ種別ごとに決めます。
❌ ダッシュボードの件数だけを追う
⭕ タスク完了、業務品質、エラー、遅延、コストを関連付ける。Trace数が増えたことは成功を意味しません。利用量と業務結果を同じSessionやversionで見られるようにします。
❌ LLM-as-a-Judgeの点数を絶対評価にする
⭕ コード評価、人手確認、利用者反応と組み合わせる。評価モデルや指示文も変化します。評価器版を残し、同じDatasetで再現できるようにして、重要な判断は複数の証拠で確認します。
❌ セルフホストを構築して担当を解散する
⭕ 更新、バックアップ、復旧、容量、セキュリティの所有者を置く。2026年9月末から10月初めのGitHub Releasesでも短い間隔で更新が続いています。導入時の構築より、継続運用を誰が担うかが重要です。
よくある質問
Langfuseは無料で使えますか?
はい。CloudのHobbyは月50,000 Unitsまで無料で、2ユーザー、過去データ参照30日などの制限があります。セルフホストOSSもコア機能の利用料とUnit課金はありません。ただし、セルフホストのインフラ、ストレージ、バックアップ、保守工数は別に発生します。
Langfuseは何を監視できますか?
LLM呼び出し、モデル入力・出力、トークン、コスト、遅延、エラー、ツール、検索、ユーザー、セッション、プロンプト版などをTraceとObservationで記録できます。業務上の正確性や完了率は自動的に決まるものではないため、Scoreとして評価方法を設計します。
LangfuseとLangSmithはどちらを選ぶべきですか?
複数フレームワークをOpenTelemetryで横断し、OSSセルフホストも選択肢にするならLangfuseを比較しやすいです。LangChain/LangGraph中心で開発・デプロイ機能との一体運用を重視するならLangSmithが候補になります。課金単位が違うため、自社のTrace構造と人数で試算してください。
LangfuseとLangGraphは競合しますか?
主な役割は競合しません。LangGraphはエージェントやワークフローを組み立てて実行し、Langfuseはその実行を観測・評価します。公式のLangChain/LangGraph連携を使って併用できます。
DifyやOpenAIで作ったアプリにも使えますか?
LangfuseにはOpenAIのPython/JS統合があり、Difyを含む各種連携情報も公式サイトにあります。ただし、連携ごとに記録できる粒度、対応バージョン、設定方法が異なります。導入時点のIntegrationsで対象製品の現行手順を確認してください。
現在のv4へ移行するときの注意点は?
Server、Python SDK、JS/TS SDKのバージョンを別々に確認します。2026年10月3日時点ではServer v4、Python SDK v4、JS/TS SDK v5が現行です。古いAPI例を混在させず、公式の互換性ページと各SDKの移行ガイドに沿い、検証環境でTrace、Score、Prompt取得を確認してから本番へ反映します。
ここまでの要点
Langfuseは、AIエージェントを動かす製品ではなく、LLMアプリの内部をトレースし、評価し、プロンプトとデータセットを管理して改善へつなげる基盤です。導入判断では、機能一覧よりも「何を失敗とするか」「1回の処理が何Unitsになるか」「誰が運用責任を持つか」を先に決める必要があります。
- まず確認:代表業務のTrace境界、監視したいObservation、業務結果のScoreを紙に書き出す
- 次に試す:Cloud Hobbyまたは検証用セルフホストで1本のTraceを送り、Unit数とデータ粒度を見る
- 本番前に決める:データ所在地、マスキング、権限、保持、評価担当、更新・障害対応の責任者を確定する
Langfuse単体ではなく運用基盤全体を比較するならAIエージェント観測・評価完全ガイド、社内AIエージェントの実装を具体化するならResponses API実践ガイド、開発対象の整理にはAIエージェント開発実績を続けて確認してください。
参考・出典
- LLM Observability & Application Tracing(Langfuse、参照日:2026年10月3日)
- Evaluation of LLM Applications(Langfuse、参照日:2026年10月3日)
- Open Source Prompt Management(Langfuse、参照日:2026年10月3日)
- Datasets(Langfuse、参照日:2026年10月3日)
- Langfuse Cloud Pricing(Langfuse、参照日:2026年10月3日)
- Self-Hosted Pricing(Langfuse、参照日:2026年10月3日)
- Billable Units(Langfuse、参照日:2026年10月3日)
- Data Regions & Availability(Langfuse、参照日:2026年10月3日)
- Catching conversation signals in Langfuse(Langfuse、公開日:2026年9月23日、参照日:2026年10月3日)
- Langfuse Releases(GitHub、参照日:2026年10月3日)
- LangSmith Plans and Pricing(LangChain、参照日:2026年10月3日)
著者プロフィール
佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。
100社以上の企業向けAI研修・導入支援。著書『AIエージェント仕事術』『Claude仕事術』(SBクリエイティブ・シリーズ累計約6万部)。
SBクリエイティブ「ビジネス+IT」ほかで生成AI連載を執筆(NewsPicks最大1,125ピックス)。
この記事の内容を社内で使うなら
AIエージェントの基礎から、経営としての導入判断まで。講演完全版のWeb資料を、ご登録いただいた方に閲覧URLでお送りします。
- 100社以上・研修4,000名以上の実績
- 初回30分無料・即日返信
資料は受け取りページからすぐにご覧いただけます。