Claude Status(稼働状況)を今すぐ確認したい方へ:公式の稼働状況ページは Anthropic が Atlassian Statuspage で公開している status.claude.com です。2026年9月27日18:40(JST/09:40 UTC)に取得した時点では、claude.ai・Claude Console・Claude API・Claude Code・Claude Cowork・Claude for Government の6コンポーネントすべてが operational(正常)、進行中のインシデントは0件でした。「いま自分の環境だけつながらないのか、全体障害なのか」をすぐ切り分けたい方は、公式ステータスを自動更新で表示している Claude障害 今の状況を自動更新で確認|つながらない時の対処法 が早道です。本記事は、そのページの読み方と、公式APIを使った自動監視・SLAの実態・止まらない設計の作り方までを扱います。
結論: Claude の稼働状況は status.claude.com の1ページで確認でき、同じ内容が認証不要の JSON API(/api/v2/summary.json)でも取れます。2026年9月27日09:40 UTC 時点は全6コンポーネント正常。ただし公式APIのインシデント記録を同日に数えると2026年9月(9/1〜9/27)だけで12件(うち major 7件)のインシデントが起きており、「見に行く運用」ではなく「通知が飛んでくる運用」に切り替えるのが実務解です。
この記事の要点:
- 要点1: 公式ページは
status.claude.com。旧status.anthropic.comは2026年9月27日時点で 301 リダイレクトされ、そのまま新URLに着地する - 要点2: 2026年9月のインシデントは公式API集計で12件(major 7・minor 4・その他1)。8月は25件(critical 1・major 7・minor 16・その他1)で、件数は月によって大きく振れる
- 要点3: Anthropic は2026年9月27日時点で、料金ページ・Enterpriseページ・Commercial Terms のいずれにも稼働率SLAを記載していない。SLAの数値が公式にあるのは AWS Bedrock などの経由サービス側
対象読者: Claude/Claude Code/Claude API が止まったときに切り分けと連絡を任される開発者・情シス・SRE・AI運用担当
読了後にできること: 公式ステータスの読み方を説明でき、通知を自動化し、SLAの有無を踏まえた社内説明ができる
「Claudeが落ちてる気がするんですが、どこを見ればいいですか」——AI導入の相談で、いちばん多い問い合わせのひとつがこれです。
やっかいなのは、「落ちている」と感じる原因が3種類あって、見るべき場所がそれぞれ違うことです。Anthropic側の全体障害なのか、自分のアカウント・回線・APIキーの問題なのか、それとも単なるレート制限なのか。公式ステータスページは1つ目しか教えてくれません。
この記事では、まず公式ページの読み方を最短で押さえ、そのうえで公式APIから当日取得した実データ(2026年9月27日09:40 UTC)で「実際どれくらい落ちているのか」を数字にし、最後に業務を止めないための通知・フォールバック設計まで通しで扱います。稼働状況とインシデントの数値は、すべて status.claude.com と Anthropic 公式ドキュメントの当日版だけを根拠にしています。
Claude Statusとは|status.claude.com で見る6つの稼働状況
Claude Status は、Anthropic が Atlassian Statuspage 上で運用している公式の稼働状況ページです。URL は https://status.claude.com/。ページ最上部に全体の状態が1行で出て、その下に監視対象のコンポーネントが並び、さらに下に過去のインシデント履歴が日付順に並びます。
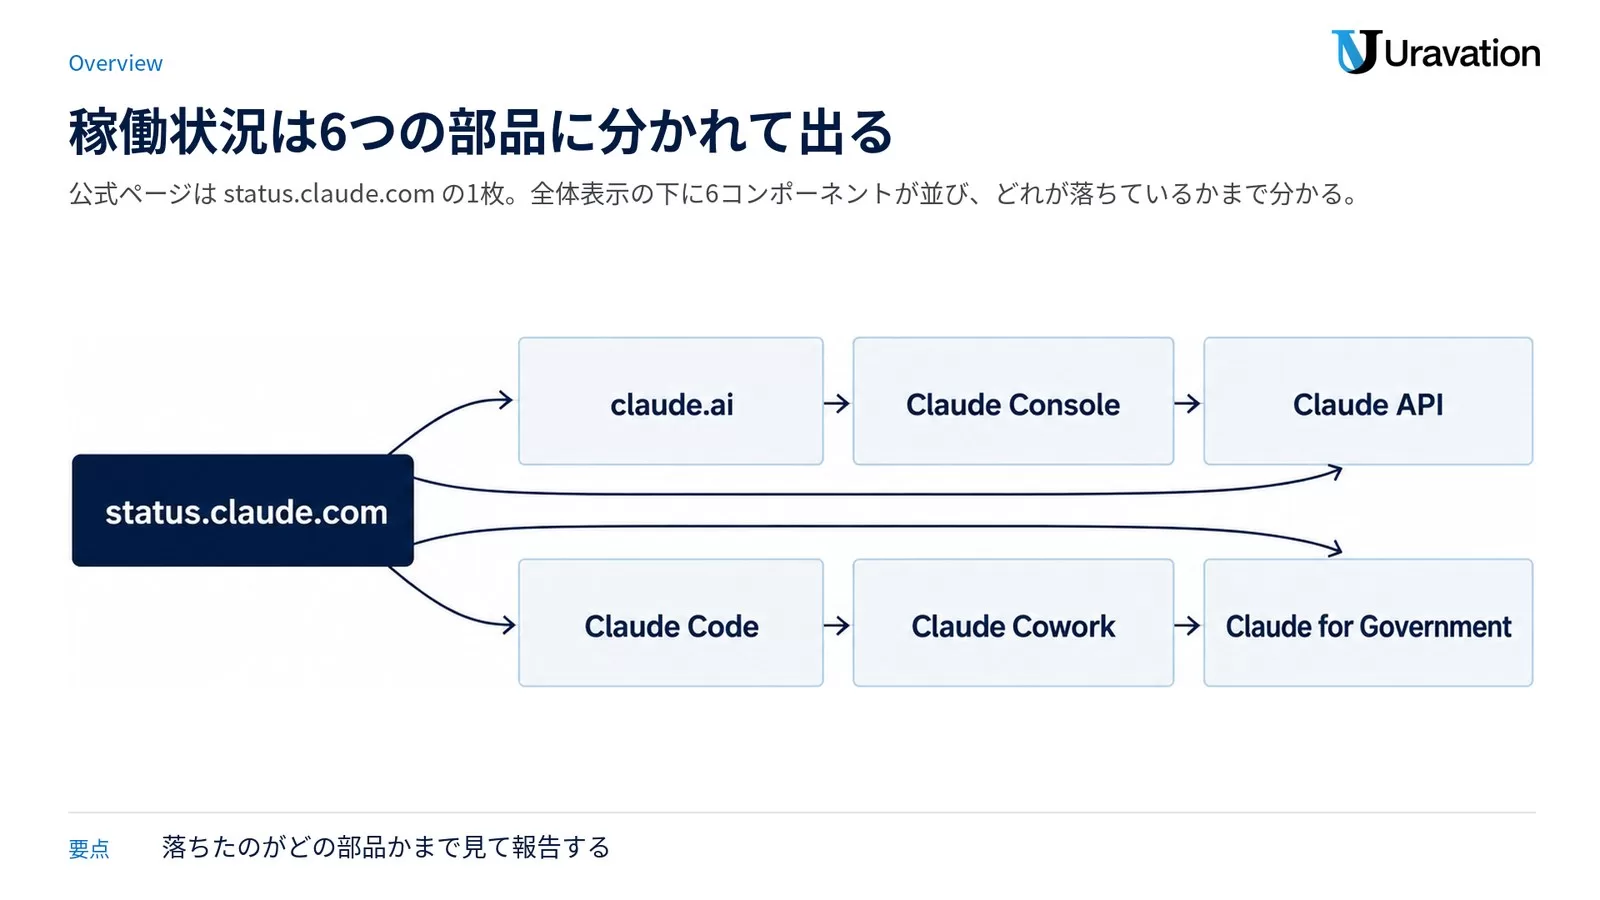
2026年9月27日09:40 UTC に /api/v2/summary.json を取得した時点の全体表示は All Systems Operational(indicator は none)、監視対象は次の6コンポーネントでした。名称は公式表記のまま載せます。
| コンポーネント(公式表記) | 実体 | 2026-09-27 09:40 UTC の状態 |
|---|---|---|
| claude.ai | Web/デスクトップ/モバイルの Claude 本体 | operational |
| Claude Console (platform.claude.com) | 開発者向けコンソール(APIキー発行・利用量) | operational |
| Claude API (api.anthropic.com) | APIエンドポイント本体 | operational |
| Claude Code | CLI/IDE のコーディング支援 | operational |
| Claude Cowork | チーム向けの協働機能 | operational |
| Claude for Government | 政府機関向け環境 | operational |
ここで押さえておきたいのは、コンポーネントが分かれている=落ち方も分かれるという点です。実際、2026年9月10日から14日にかけては「Degraded functionality for Claude Cowork on Windows」だけが継続し、claude.ai と API は正常でした。「Claudeが落ちた」とひとことで言わず、どのコンポーネントが何色かまで見て報告するだけで、社内の初動がまるで変わります。
なお、ページ上には各コンポーネントの90日間稼働率(%)も表示されますが、この数値は JavaScript で後読みされる領域にあり、2026年9月27日に curl で取得した HTML には含まれていませんでした(/uptime_showcase も空レスポンスを返します)。本記事では稼働率の%を転記せず、代わりに公式インシデントAPIから自前で数えた件数を後述します。
Anthropic ステータスの見方|4つの色と「更新時刻」の読み方
「Anthropic ステータス」で検索してたどり着いた方がまず知りたいのは、色の意味だと思います。Statuspage の全体インジケーターは4段階で、JSON API 上ではそれぞれ none / minor / major / critical という値になります。
| 表示 | APIの値 | 意味 | 実務での対応 |
|---|---|---|---|
| All Systems Operational(緑) | none | 全コンポーネント正常 | Claude側は正常。自分側を疑う |
| Degraded Performance(黄) | minor | 遅延・部分的な品質低下 | タイムアウト値とリトライを確認 |
| Partial / Major Outage(橙) | major | 一部または広い範囲で失敗 | フォールバックを起動・関係部署へ一報 |
| Major Outage(赤) | critical | 広範囲のサービス停止 | 切替と告知を同時に進める |
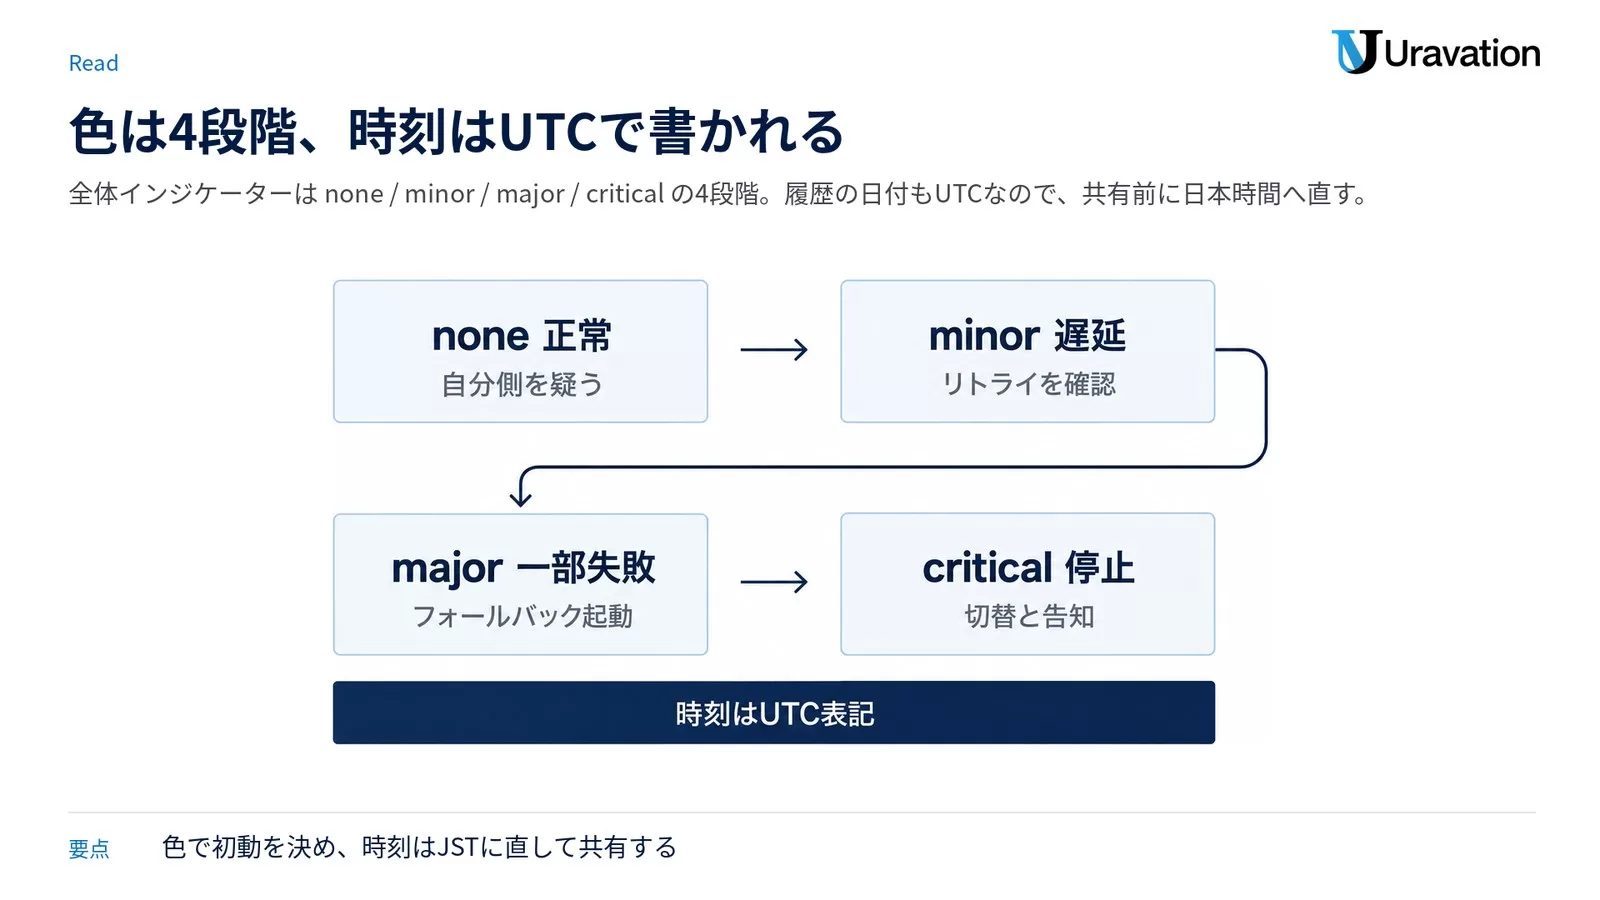
色と同じくらい大事なのが「更新時刻」です。公式ページのタイムゾーンは Etc/UTC(JSON の page.time_zone)で、履歴の日付も UTC 表記です。日本時間に直すには9時間を足します。2026年9月22日00:57 UTC のインシデントは、日本時間では同日09:57 開始です。社内共有のときに UTC のまま貼ると、「昨日の話だと思った」という食い違いが起きます。日時を書くときは必ず JST に直して併記してください。
もう1つ、公式が更新文の中で「影響時間」を明記することがあります。たとえば2026年9月22日の major インシデントの最終更新文には、原文で "Impact occurred from 5:50pm PT / 00:50 UTC to 7:10pm PT / 02:10 UTC." と書かれていました。インシデント作成時刻より実際の影響開始のほうが早いケースがあるため、事後のレポートを書くときは作成時刻ではなく更新文中の影響時間を採用します。
Anthropic status / Claude API status を一次ソースで確認する(API・RSS)
英語表記の「Anthropic status」「Claude API status」で探している場合も、行き先は同じ status.claude.com です。ただし人が見るページよりも、機械が読む口のほうが実務では役に立ちます。Statuspage は認証不要・無料の JSON API を公開していて、2026年9月27日に確認した時点で以下のエンドポイントがすべて HTTP 200 を返しました。
| エンドポイント | 用途 |
|---|---|
https://status.claude.com/api/v2/status.json | 全体の1行ステータスだけ。最軽量(応答は数百バイト) |
https://status.claude.com/api/v2/summary.json | 全体+6コンポーネント+進行中インシデント。監視はこれ1本で足りる |
https://status.claude.com/api/v2/components.json | コンポーネント一覧と個別の状態 |
https://status.claude.com/api/v2/incidents.json | インシデント履歴(直近50件) |
https://status.claude.com/api/v2/incidents/unresolved.json | 未解決のインシデントのみ |
https://status.claude.com/api/v2/scheduled-maintenances/upcoming.json | 予定メンテナンス |
https://status.claude.com/history.rss / history.atom | インシデント履歴のフィード購読 |
いちばん速い確認方法は、ターミナルで1行叩くことです。
curl -s -m 10 https://status.claude.com/api/v2/status.json
# => {"page":{...},"status":{"indicator":"none","description":"All Systems Operational"}}
indicator が none なら Anthropic 側は正常、それ以外なら障害または品質低下です。ブラウザでページを開くより速く、人に見せるときも「公式APIがこう返している」と言えるので話が早くなります。
旧ドメインについてもここで整理しておきます。2026年9月27日に確認したところ、https://status.anthropic.com/ は https://status.claude.com/ へ、https://status.anthropic.com/history.rss は https://status.claude.com/history.rss へ、いずれも 301 でリダイレクトされました。古い手順書やブックマークに旧URLが残っていても当面は着地しますが、監視スクリプトのURLは新ドメインに直しておくのが安全です。リダイレクトを追わない設定(curl の -L なしなど)だと、301 を「異常」と誤検知します。
「Claudeが落ちてる?」を切り分ける3ステップ
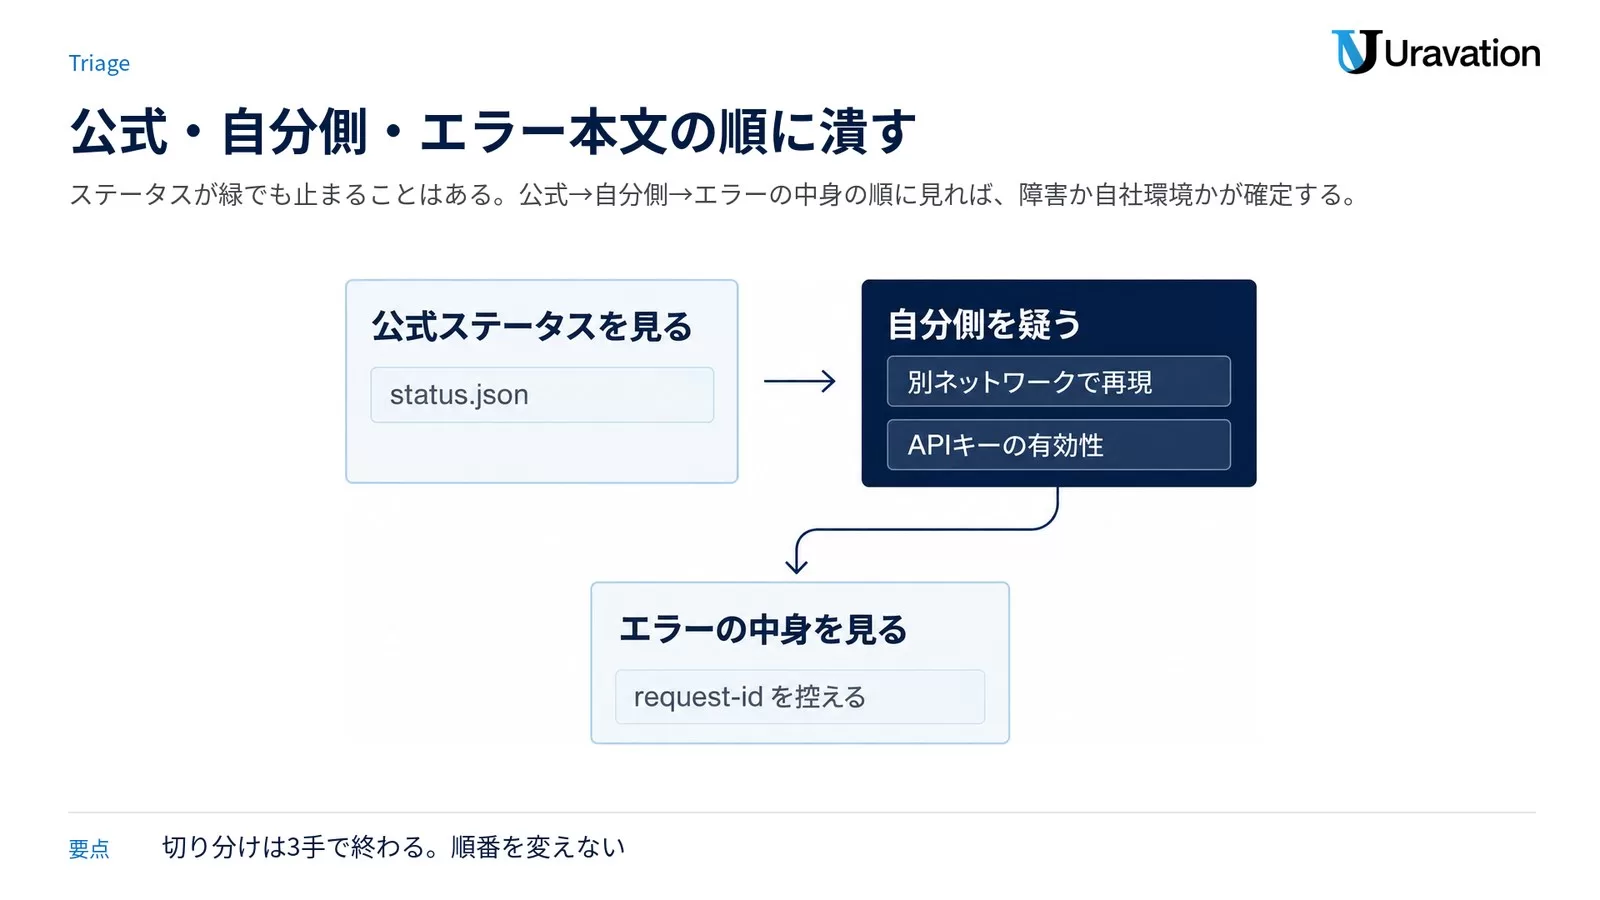
ここがこの記事のいちばん実用的な部分です。公式ステータスが緑なのに動かない、というのは珍しくありません。順番に潰していきます。
- 公式ステータスを見る:
status.claude.comかstatus.json。ここが緑以外なら Anthropic 側の問題で、こちらにできるのは待つか切り替えるかだけです。該当コンポーネント名と UTC/JST の時刻を控えます。 - 自分側を疑う:緑だった場合は、別ネットワーク(スマホのテザリング等)からの再現、別アカウントでの再現、APIキーの有効性、社内プロキシやVPNの遮断、ブラウザ拡張の干渉を順に確認します。ここで再現しなくなるなら、障害ではなく自社環境の問題です。
- エラーの中身を見る:APIなら HTTP ステータスコードと
error.type、そしてrequest-idヘッダ。公式ドキュメントによれば、すべてのAPIレスポンスに一意のrequest-id(例:req_018EeWyXxfu5pfWkrYcMdjWG)が付き、サポート問い合わせ時にはこのIDを添えることが案内されています。問い合わせる前に request-id を控えるだけで、往復が1回減ります。
切り分けが「Claude側」で確定したときの代替手段の並べ方は、AI障害時の対応マニュアル|Claude・ChatGPT・Gemini代替手段に業務別でまとめています。
Claude Code の /status と /doctor|手元の状態を見るコマンド
検索で「claude /status」「/status claude」と入力している方は、おそらくサービスの稼働状況ではなくClaude Code のスラッシュコマンドを探しています。これは公式ステータスページとはまったく別物なので、ここで分けて説明します。
| コマンド | 公式ドキュメントでの説明(要約) | 使いどころ |
|---|---|---|
/status | 設定画面を Status タブで開き、バージョン・モデル・アカウント・接続状況を表示する。応答中でも実行できる | 「自分のCLIはどのモデル・どのアカウントで、つながっているのか」を確認する |
/doctor | セットアップの健康診断。重複インストールや残骸、PATH の問題、壊れた設定ファイルなどを診断し、修正も提案する。別名 /checkup。ターミナルからは claude doctor で読み取り専用の診断だけを出せる | インストール・設定が原因で動かないときの一次切り分け |
/usage | セッションのコスト、プランの利用上限、利用統計を表示する。/cost と /stats は別名 | 「障害ではなく上限に当たっているだけ」を見抜く |
切り分けの実務では、この3つを「公式ステータス → /status → /usage」の順で叩くのが速いです。公式が緑で、/status の接続表示も正常で、それでも止まるなら、多くの場合は利用上限かローカル設定です。claude doctor はセッションを起動せずに読み取り専用の診断だけを出せるので、手が塞がっているときでも安全に回せます。
Claude Code 側の設定・インストールまわりでつまずいている場合は、Claude Code 使い方|インストールから自動化までに導入から運用までの手順を通しでまとめています。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修6,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
エラーコードで切り分ける|429・529・500・504の違い
「エラーが出た=障害」ではありません。Anthropic 公式ドキュメント(2026年9月27日取得)の記述をもとに、実務で紛らわしい4つを並べます。
| コード | error.type | 公式の説明 | 障害か | やること |
|---|---|---|---|---|
| 429 | rate_limit_error | レート制限、利用ティアの月間支出上限、または Claude Code ワークスペースの支出上限に達した | いいえ(自分側) | retry-after に従って待つ。支出上限由来の429は retry-after が付かず、再試行しても失敗し続ける |
| 500 | api_error | Anthropic 側の内部で想定外のエラーが発生した | はい(Anthropic側) | 指数バックオフで再試行。続く場合は request-id を添えてサポートへ |
| 504 | timeout_error | 処理中にタイムアウトした | どちらもあり得る | 長時間の処理はストリーミング版 Messages API の利用が案内されている |
| 529 | overloaded_error | APIが一時的に過負荷。全ユーザー横断で高トラフィックのときに発生し得る | はい(混雑) | 待って再試行。ステータスページが緑でも出ることがある |
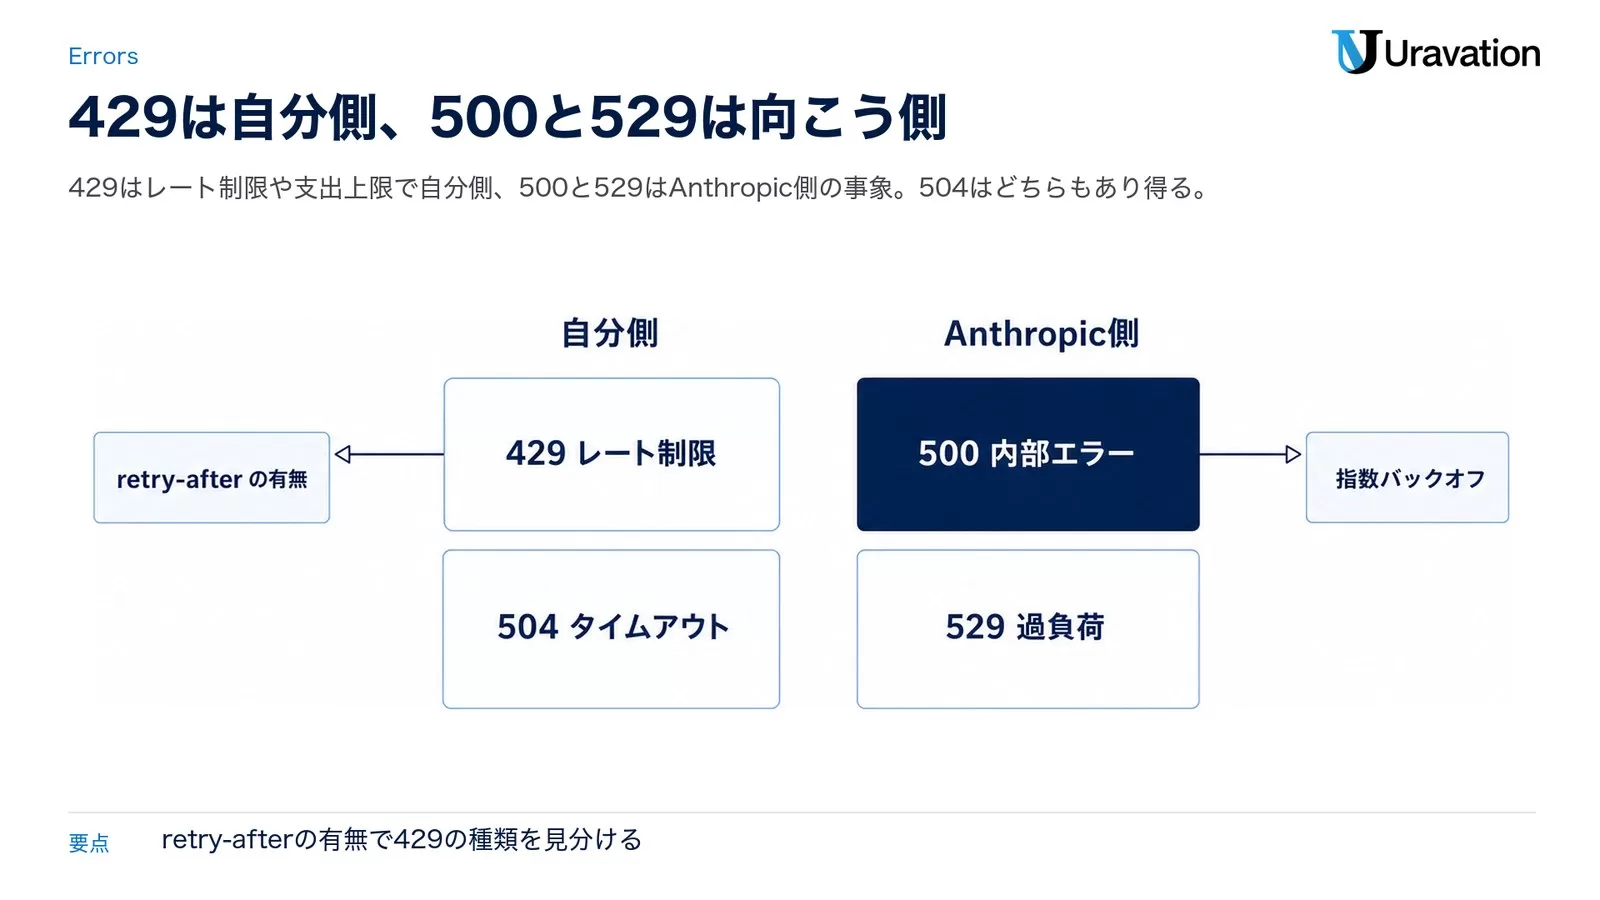
実務でいちばん効くのは、429 の2種類を見分けることです。公式ドキュメントは、レート超過の429には retry-after ヘッダが付き、支出上限(spend cap)に達した429には付かず「アクセスが再開するまで失敗し続ける」と明記しています。SDKの自動リトライも後者では無駄に終わります。retry-after の有無をログに残すだけで、「なぜかリトライが効かない」という調査が数分で終わります。
もう1つ。公式SDKは接続エラー・レート制限・5xx を既定で2回まで指数バックオフ付きで自動再試行し、retry-after があればそれに従います。回数は max_retries(TypeScript/Java/PHP は maxRetries、C# は MaxRetries、Go は option.WithMaxRetries)で変更・無効化できます。アプリ側で自前のリトライを重ねると、実際には「2回 × 自前の回数」になるので、二重リトライになっていないか一度確認してください。
2026年9月の障害実績|公式APIから数えた12件の内訳
「Claudeってどれくらい落ちるんですか」と聞かれたとき、体感で答えると話が進みません。そこで、2026年9月27日09:40 UTC に /api/v2/incidents.json を取得し、そのまま件数を数えました。APIが返すのは直近50件(最古は2026年7月30日05:57 UTC)なので、8月と9月は全量が含まれています。
| 期間 | 件数 | 内訳(impact) |
|---|---|---|
| 2026年9月(9/1〜9/27) | 12件 | major 7・minor 4・その他1 |
| 2026年8月(8/1〜8/31) | 25件 | critical 1・major 7・minor 16・その他1 |
| 直近30日(8/28〜9/27) | 15件 | major 8・minor 6・その他1 |
「その他」は impact が none の記録で、たとえば2026年9月16日の「Issues with Google Play subscriptions」のようにサービス本体の停止ではないものです。
直近30日を影響コンポーネント別に数えると、こうなります(1件が複数コンポーネントに紐づく場合は各コンポーネントに計上)。
| コンポーネント | 件数 | 影響時間の合計(作成〜解決) |
|---|---|---|
| claude.ai | 10件 | 約609分 |
| Claude Cowork | 9件 | 約6,665分 |
| Claude Code | 8件 | 約678分 |
| Claude API (api.anthropic.com) | 7件 | 約525分 |
| Claude Console (platform.claude.com) | 2件 | 約179分 |
Claude Cowork の合計が突出しているのは、2026年9月10日から14日まで続いた「Degraded functionality for Claude Cowork on Windows」(約5,961分)を含むためです。ここが読み方のポイントで、長時間の1件は「機能の一部が使いにくい」状態が続いたもので、全断ではありません。逆にモデル系の major は短く、9月の major 7件のうち6件は3時間以内(うち3件は30分以内)に解決しています。
この分布から言えることは単純です。Claude の障害は「長い全断」より「短いエラー急増」が主で、人間が気づいて手で切り替える速度では間に合わない。だから通知と自動切替の話になります。
数え方の注記: 件数は公式APIの
created_atを発生、resolved_atを解決として単純集計したものです。影響時間は「インシデントが開いていた時間」であり、稼働率(アップタイム)ではありません。公式が更新文で示す実影響時間とはずれることがあります(例: 9/22 は作成00:57 UTC・解決02:35 UTC に対し、公式の記載は影響00:50〜02:10 UTC)。
AnthropicのSLAはあるのか|公式に記載がないという事実
「Enterpriseなら99.9%とか保証されているんですよね?」とよく聞かれます。2026年9月27日に一次情報を当たった結論から言うと、Anthropic は公式ページ上に稼働率SLAの数値を載せていません。
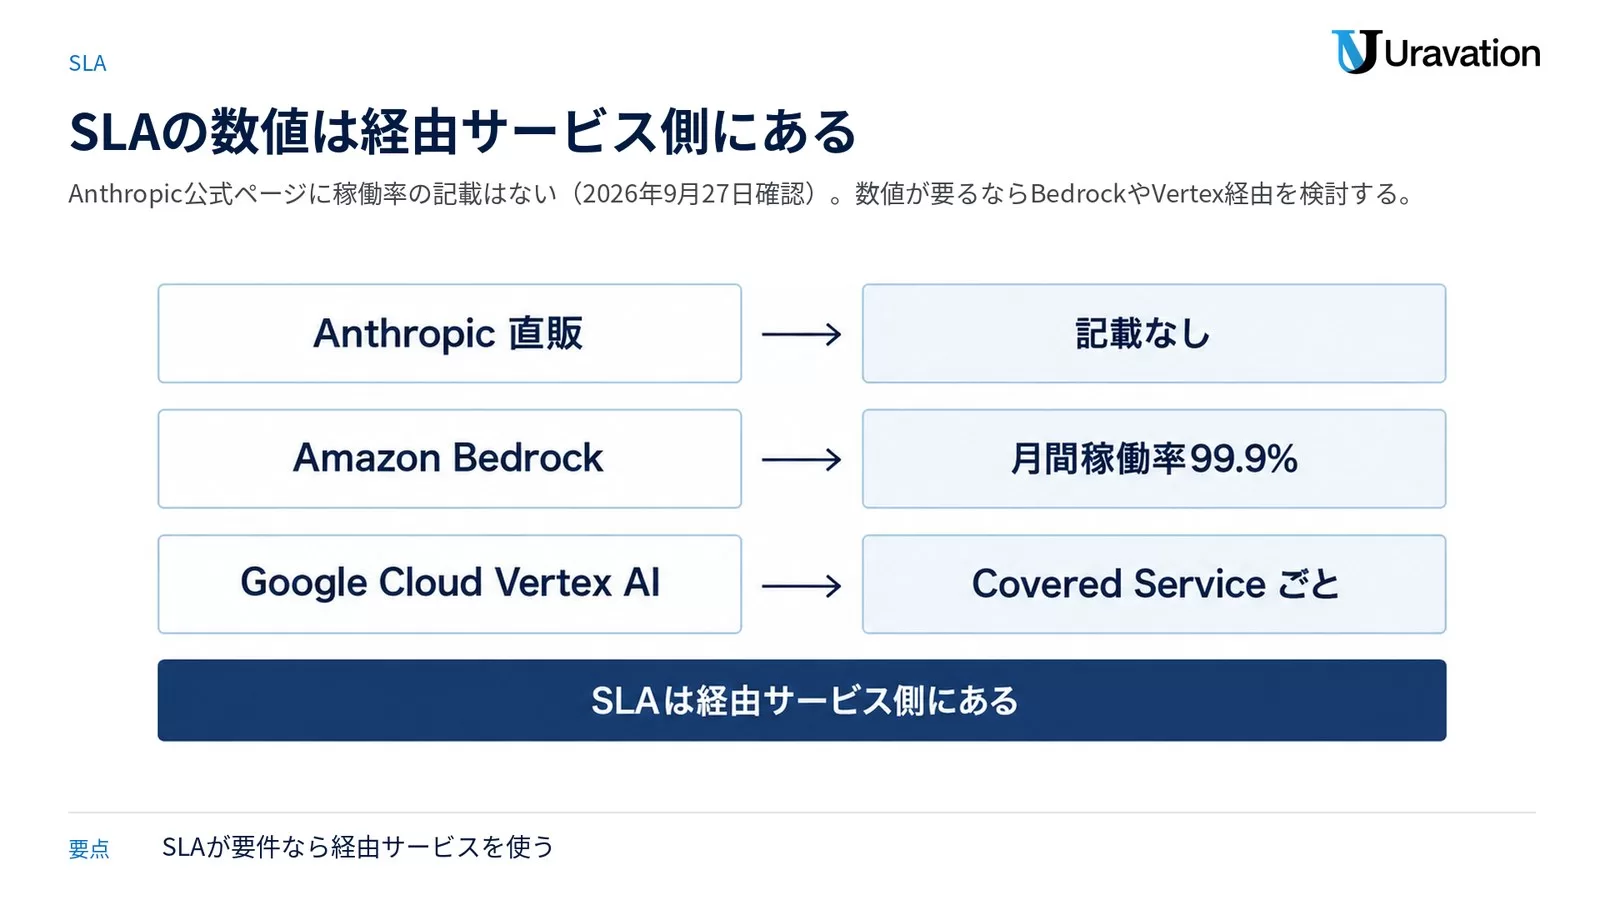
同日に claude.com/pricing、claude.com/solutions/enterprise、Anthropic Commercial Terms of Service の3ページを取得し、本文テキストから「SLA」「Service Level」「uptime」「99.」を検索しましたが、稼働率の保証値もサービスクレジット条項も1件も見つかりませんでした。したがって本記事は「Enterpriseは99.99%」といった数値を載せません。2026年9月27日時点で公式に記載なし、が正確な書き方です。
一方で、SLAの数値が公式に存在する経路はあります。Claude をクラウド経由で使う場合、SLAはそのクラウド事業者が出しているからです。
| 経路 | 稼働率SLAの公式記載(2026年9月27日確認) | 出典 |
|---|---|---|
| Anthropic 直販(API・Claude.ai・Team・Enterprise) | 記載なし | pricing / Enterprise / Commercial Terms の3ページ |
| Amazon Bedrock 経由 | 月間稼働率が99.9%未満でサービスクレジット10%、99.0%未満で25%、95.0%未満で100%(リージョン単位・月次請求サイクル単位) | Amazon Bedrock SLA(ページ表記 Last Updated: October 4, 2023) |
| Google Cloud Vertex AI 経由 | Covered Service ごとに月間稼働率の目標を明記(例: Training/Deployment/Batch Prediction は99.9%以上) | Vertex AI Platform SLA(ページ表記 Last modified February 12, 2026) |
ここは法人の稟議で必ず突っ込まれる論点なので、正確に書いておきます。Bedrock や Vertex のSLAは、その基盤サービスの可用性に対する約束であって、「Claudeモデルの応答品質」や「Anthropic側の混雑」を保証するものではありません。また Vertex の表は Vertex AI Platform の Covered Service 一覧なので、Claude をどの構成で呼ぶかによって当てはまる行が変わります。契約前に自社の構成でどの行に該当するかを、書面で確認してください。
実務上の判断としては、次の3段構えが現実的です。
- SLAが要件なら、経由サービスを使う:Bedrock や Vertex 経由にすれば、稼働率の約束とクレジット条項が文書化された相手と契約できます。設計の勘所はClaude LLM Gateway|3大クラウド連携設計に、AWS側の認証と課金はClaude Code×Amazon Bedrock連携|認証と課金にまとめています。
- SLAがなくても自社SLOは決める:「AI機能のエラー率が5分平均で何%を超えたらフォールバック」「復旧報告は何分以内」を先に数値で決めておけば、SLAの有無に関係なく動けます。
- 調達の観点で横比較する:SLA・レート制限・監査ログといった法人要件の見方は生成AI API選定5項目|SLA・レート制限・監査ログで整理しています。
障害通知を自動で受け取る7つの購読方法
公式ページの「Subscribe to Updates」から設定できる購読経路を、2026年9月27日にページの表記を確認したうえで全部並べます。
| 経路 | 通知される契機(公式表記ベース) | 向いている相手 |
|---|---|---|
| メール | インシデントの作成・更新・解決 | 個人・小規模チーム。更新まで届くので経緯を追える |
| SMS(国番号リストに日本も掲載) | インシデントの作成・解決 | オンコール担当。更新は届かない点に注意 |
| Slack | インシデント更新とメンテナンス情報 | 運用チームへの共有の既定線 |
| Microsoft Teams | 同上(チャンネルの Webhook URL を登録) | Teams 中心の社内 |
| Webhook | 作成・更新・解決に加えてコンポーネント状態の変化 | 自動フォールバックのトリガー |
| Atom フィード | 履歴の購読 | 既存のフィード基盤に載せる |
| RSS フィード | 履歴の購読 | 同上 |
メールとSMSは登録時に OTP(ワンタイムコード)の入力が必要でした。運用で使うなら、個人メールではなく共有メーリングリストで登録し、退職時に通知が消えないようにするのがおすすめです。
企業運用でいちばん効くのは Webhook です。7経路のうち、コンポーネント単位の状態変化まで飛ばしてくれるのは Webhook だけで、「Claude API だけが degraded になったら切り替える」といった細かい制御が組めます。人向けの共有は Slack、機械向けのトリガーは Webhook、と役割を分けて両方設定するのが定番です。
業務を止めない設計|監視Botとフォールバックの実装
ここからは、APIをプロダクションで使っているチーム向けです。やることは2つだけ、状態が変わったら人に届くことと、失敗したら自動で別の口に逃げることです。
状態変化だけを通知する監視Bot(最小構成)
ポーリングして、前回と状態が変わったときだけ Slack に流します。毎回通知すると誰も見なくなるので、差分検知は必須です。Slack への送信は Incoming Webhook ではなく chat.postMessage(Bot トークン)を使っています。トークンを環境変数から読み、コードに直書きしないための構成です。
#!/usr/bin/env python3
"""Claude Status 監視: 状態が変わったときだけ Slack に通知する"""
import json
import os
import pathlib
import requests

STATUS_API = "https://status.claude.com/api/v2/summary.json"
STATE_FILE = pathlib.Path(os.environ.get("STATE_FILE", "/var/lib/claude-status/state.json"))
SLACK_TOKEN = os.environ["SLACK_BOT_TOKEN"]      # xoxb-... 直書きしない
SLACK_CHANNEL = os.environ["SLACK_CHANNEL_ID"]


def fetch_snapshot():
    """公式APIから「全体 + 各コンポーネント」の状態だけを抜き出す"""
    resp = requests.get(STATUS_API, timeout=10)
    resp.raise_for_status()
    data = resp.json()
    snapshot = {
        "indicator": data["status"]["indicator"],      # none / minor / major / critical
        "description": data["status"]["description"],
        "components": {
            c["name"]: c["status"]
            for c in data["components"]
            if not c["group"]                          # 親グループ行は除外
        },
    }
    return snapshot


def load_previous():
    if STATE_FILE.exists():
        return json.loads(STATE_FILE.read_text())
    return None


def diff_lines(previous, current):
    """変化したコンポーネントだけを1行ずつ返す"""
    if previous is None:
        return []
    lines = []
    for name, before in previous["components"].items():
        after = current["components"].get(name)
        if after and after != before:
            lines.append(f"{name}: {before} -> {after}")
    return lines


def notify(current, changed):
    icon = {"none": ":large_green_circle:", "minor": ":large_yellow_circle:",
            "major": ":large_orange_circle:", "critical": ":red_circle:"}
    body = "n".join(changed) if changed else current["description"]
    text = (
        f"{icon.get(current['indicator'], '')} *Claude Status: {current['indicator']}*n"
        f"{body}n<https://status.claude.com/|status.claude.com>"
    )
    requests.post(
        "https://slack.com/api/chat.postMessage",
        headers={"Authorization": f"Bearer {SLACK_TOKEN}"},
        json={"channel": SLACK_CHANNEL, "text": text},
        timeout=10,
    )


def main():
    current = fetch_snapshot()
    previous = load_previous()
    if previous == current:
        return                                        # 変化なし: 何もしない
    notify(current, diff_lines(previous, current))
    STATE_FILE.parent.mkdir(parents=True, exist_ok=True)
    STATE_FILE.write_text(json.dumps(current, ensure_ascii=False))


if __name__ == "__main__":
    main()
これを cron や systemd timer で5分おきに回します。状態ファイルは /tmp ではなく永続ディレクトリに置いてください(/tmp だと再起動のたびに「復旧しました」が飛びます)。ポーリングだけでは最大5分遅れるので、前節の Webhook 購読を併用すると検知が早くなります。
フォールバックの3パターン
| パターン | 切替先 | 向いているケース | 弱点 |
|---|---|---|---|
| A: 他プロバイダーへ | Claude → 他社モデル | 要約・分類など、モデル差が結果を壊しにくい処理 | 出力の癖が変わる。プロンプトの再調整が要る |
| B: 同一プロバイダー内で降格 | 上位モデル → 軽量モデル | Claude固有の挙動に依存している処理 | 特定モデルだけの障害には効くが、全断には効かない |
| C: 経由サービスを変える | Anthropic直API → Bedrock / Vertex | 可用性の約束が要件になっている本番 | 認証・課金・モデルIDが別体系。事前の疎通確認が必須 |
9月の実データが示すとおり、「特定モデルだけが落ちる」障害が多数派です(9月の major 7件のうち、4件は特定モデル名が挙がり、2件は「multiple models」でした)。まず用意すべきはパターンBで、そのうえで全断に備えてAかCを足す、という順番が現実的です。どのモデルをどこに降格させるかはClaude SonnetとOpusの違い|どっちを選ぶ?を、料金差の判断材料は主要AIモデルAPI料金 横断比較を参照してください。
ルーターで自動フォールバックする
LiteLLM のような OpenAI 互換プロキシを挟むと、アプリ側のコードを変えずに切替を入れられます。下は Python SDK の Router を使った最小形です。
from litellm import Router

router = Router(
    model_list=[
        {"model_name": "primary",
         "litellm_params": {"model": "<provider>/<model-id>", "api_key": os.environ["PRIMARY_KEY"]}},
        {"model_name": "secondary",
         "litellm_params": {"model": "<provider>/<model-id>", "api_key": os.environ["SECONDARY_KEY"]}},
    ],
    fallbacks=[{"primary": ["secondary"]}],
    num_retries=2,
)

response = router.completion(model="primary", messages=[{"role": "user", "content": "..."}])
モデル文字列(<provider>/<model-id> の部分)はここに固定値を書きません。LiteLLM の対応モデル表記はモデル世代が変わるたびに更新されるため、実装時に LiteLLM 公式ドキュメントで現行の表記を確認してから埋めてください。古い記事の文字列をそのままコピーして「動かない」という相談が実際に多い箇所です。
再試行の設計で1点だけ注意します。公式SDKは既定で2回まで自動リトライするので、ルーター側の num_retries と合わせると回数が掛け算になります。リトライは1か所に集約するのが原則です。
設定しただけで終わらせない
フォールバックは、APIキーの失効・設定変更・モデル表記の更新などで静かに壊れます。月1回、意図的にプライマリを失敗させて切替が動くかを確認する日を決めておいてください。確認できていないフォールバックは、無いのと同じです。
インシデント対応の手順テンプレート
障害の最中に「何を、どの順で、誰に」を考え始めると必ず遅れます。先に決めておく分だけを、そのまま社内ドキュメントに貼れる形で置きます。
インシデントレベルの定義
| レベル | 公式ステータスの状態 | 自社への影響 | 初動 |
|---|---|---|---|
| P1 | major / critical | 主要機能が停止 | 5分以内に担当アサイン・切替 |
| P2 | major(一部コンポーネント) | 一部機能が停止・著しい遅延 | 15分以内 |
| P3 | minor | 品質低下・遅延 | 1時間以内 |
| P4 | none だが個別エラーあり | 軽微 | 翌営業日 |
P1 のランブック
## Claude 障害 P1 ランブック

### 検知(発生から5分以内)
- [ ] status.claude.com / api/v2/status.json で indicator を確認
- [ ] 影響コンポーネント名を控える(claude.ai / Claude API / Claude Code ...)
- [ ] 発生時刻を UTC と JST の両方で記録(公式表記は UTC)
- [ ] 自社側のエラー率を確認(Claude側か自社側かの確定)

### トリアージ(5〜15分)
- [ ] 影響する機能・ユーザー範囲を特定
- [ ] フォールバックが自動で動いているか確認(動いていなければ手動切替)
- [ ] 社内第一報(発生時刻・影響範囲・現在の対応・次報の予定時刻)

### 対応(15分以降)
- [ ] ユーザー向け告知を掲出
- [ ] 公式インシデントページの更新を定期確認(更新文に影響時間が載ることがある)
- [ ] 失敗したジョブを再処理キューへ退避

### 復旧確認
- [ ] 公式が resolved になったことを確認
- [ ] 自社側のエラー率が平常に戻ったことを確認してから切り戻す
- [ ] 退避したジョブを再処理
- [ ] 記録: 影響時間は公式更新文の値を採用し、request-id を添えて残す
ユーザー向け告知の型
【第一報】
現在、AI機能の一部で利用に支障が生じています。
発生時刻: YYYY年MM月DD日 HH:MM(JST)
影響範囲: [機能名]
次回更新: HH:MM 目安

【復旧報】
AI機能の障害は HH:MM(JST)に復旧しました。
影響時間: HH:MM 〜 HH:MM
原因: 利用しているAIサービス側の障害
対応: [自動フォールバック / 手動切替]
第一報で「次回更新の目安時刻」を必ず書くのがコツです。これがあるだけで問い合わせの再送が減ります。
特定ベンダーに依存しきらない前提の置き方は、AI導入戦略の全体像でマルチベンダー設計として整理しています。AIエージェント全般の設計に広げる場合はAIエージェント導入完全ガイドもあわせてどうぞ。
【要注意】よくある失敗パターン4選
失敗1: ステータス確認を目視に頼る
❌ 「ページをブックマークして、おかしいと思ったら開く」
⭕ 「状態変化のときだけ通知が飛ぶ仕組みを先に作る」
なぜ重要か: 9月の major 7件のうち3件は30分以内に解決しています。人が気づいて確認して共有する頃には終わっている一方、その間に失敗したリクエストは戻ってきません。検知を人に依存させないことが先です。
失敗2: 全体インジケーターだけ見て「正常」と判断する
❌ 「All Systems Operational だから問題なし」
⭕ 「自分が使っているコンポーネントの行と、進行中インシデントの一覧まで見る」
なぜ重要か: 2026年9月10日〜14日の Cowork の事例のように、特定コンポーネント・特定OSだけの不調は全体表示に強く出ません。使っている口がどれかを自覚したうえで見る必要があります。
失敗3: SLAがあると思い込んで稟議を通す
❌ 「Enterpriseなら稼働率が保証されている前提で説明する」
⭕ 「2026年9月27日時点で公式に記載がない、と事実のまま書き、必要なら経由サービスのSLAを使う」
なぜ重要か: 稟議や契約の前提が事実と違うと、障害が起きた後で揉めます。SLAの有無・数値・クレジット条件は、契約書(MSA/DPA等)で書面確認するべき項目です。
失敗4: 障害情報がエンジニアの中で止まる
❌ 「開発チームのチャンネルにだけ通知が来る」
⭕ 「カスタマーサポート・事業部・経営層まで、粒度を分けて届くようにする」
なぜ重要か: 開発が対応している間、サポートが「原因不明です」と答え続ける状態が、いちばんブランドを削ります。誰に何を、いつ流すかまでを通知設計に含めてください。
よくある質問
Q1. Claude Status はどこで見られますか?
A. https://status.claude.com/ です。Anthropic が Atlassian Statuspage 上で公開している公式ページで、claude.ai・Claude Console・Claude API・Claude Code・Claude Cowork・Claude for Government の6コンポーネントの状態と、過去のインシデント履歴が載ります。
Q2. status.anthropic.com は使えなくなったのですか?
A. 2026年9月27日に確認した時点で、status.anthropic.com は status.claude.com へ 301 リダイレクトされ、ブラウザでは問題なく新ページに着地します。ただし監視スクリプトやフィードリーダーがリダイレクトを追わない設定だと失敗するので、URLは新ドメインへ書き換えてください。
Q3. Claude API だけの状態を知るには?
A. ページ上では「Claude API (api.anthropic.com)」の行を見ます。プログラムからは https://status.claude.com/api/v2/summary.json を取得し、components のうち name が Claude API (api.anthropic.com) の要素の status を見るのが確実です。全体インジケーターだけでは、API以外の不調と区別できません。
Q4. 「claude /status」で調べたのですが、これは何ですか?
A. サービスの稼働状況ではなく、Claude Code のスラッシュコマンドです。公式ドキュメントによると /status は設定画面を Status タブで開き、バージョン・モデル・アカウント・接続状況を表示します。応答中でも実行できます。セットアップの診断は /doctor(別名 /checkup、ターミナルからは claude doctor)、利用量とプラン上限の確認は /usage(別名 /cost・/stats)です。
Q5. Anthropic は稼働率のSLAを公開していますか?
A. 2026年9月27日に claude.com/pricing、claude.com/solutions/enterprise、Anthropic Commercial Terms of Service の3ページを取得して確認した範囲では、稼働率の保証値やサービスクレジットの条項は記載されていませんでした。SLAが要件になる場合は、SLAを公開している経由サービス(Amazon Bedrock など)を検討するか、契約書で個別に確認してください。
Q6. 529 エラーが出たら障害ですか?
A. 529 は overloaded_error、公式の説明では「APIが一時的に過負荷」です。全ユーザー横断の高トラフィック時に起こり得るとされており、ステータスページが緑のままでも発生します。待って再試行するのが基本です。なお、利用量に急な立ち上がりがあると加速度制限により 429 になる場合があるとも案内されているため、トラフィックは段階的に増やすのが安全です。
Q7. ステータスは正常なのに Claude が遅い・止まるのはなぜですか?
A. 多いのは、レート制限(429)、利用プランの上限、社内プロキシやVPN、ブラウザ拡張、そしてローカル設定です。Claude Code なら /status で接続とアカウントを、/usage で上限を確認してください。APIなら retry-after ヘッダの有無で、レート超過なのか支出上限なのかを見分けられます。
Q8. 障害通知を Slack に流すにはどうすればいいですか?
A. いちばん簡単なのは、status.claude.com の「Subscribe to Updates」から Slack を選んで購読する方法です。自動切替のトリガーにしたい場合は Webhook を登録します。7つの購読経路のうち、コンポーネント単位の状態変化まで通知されるのは Webhook だけです。
Q9. status.claude.com 自体が開けないときは?
A. ステータスページ側の不調も記録として存在します(2026年8月14日に「Issues reaching status.claude.com」が公式に記録されています)。その場合は https://status.claude.com/api/v2/status.json や history.rss を直接叩く、Anthropic の公式Xアカウントを見る、といった迂回が有効です。自社の監視Botは、ステータスAPIが落ちていること自体をエラーとして扱わない設計(取得失敗と障害検知を分ける)にしておいてください。
まとめ:今日やること3つ
今日:
status.claude.comを開き、「Subscribe to Updates」から Slack かメールを購読する。あわせてcurl -s https://status.claude.com/api/v2/status.jsonを手元で1回叩き、確認の型を身体で覚える。今週: 状態変化だけを通知する監視Botを1本動かす。コンポーネント単位の Webhook 購読も登録し、通知が二重に飛ばないか確認する。
今月: フォールバックをパターンBから入れ、月1回の切替テスト日を決める。SLAが要件になる案件は、経由サービスのSLA文書を取り寄せて稟議の前提を事実に合わせる。
あわせて読みたい:Claudeが繋がらない時の確認手順|status確認・代替AI切替(今すぐ知りたい人向け)
参考・出典
- Claude Status — Anthropic公式ステータスページ(2026-09-27 09:40 UTC 取得。6コンポーネントの状態・購読経路を確認)
- Claude Status API: summary.json — 公式ステータスAPI(2026-09-27 取得。indicator=none / All Systems Operational を確認)
- Claude Status API: incidents.json — 公式インシデント履歴API(2026-09-27 取得。本記事の件数・影響時間の集計はこの直近50件が根拠)
- Claude API errors — Anthropic公式ドキュメント(2026-09-27 取得。429/500/504/529 の定義、SDKの既定リトライ2回、request-id を確認)
- Rate limits — Anthropic公式ドキュメント(2026-09-27 取得。retry-after の有無による429の区別、レート制限ヘッダを確認)
- Claude Code commands — Anthropic公式ドキュメント(2026-09-27 取得。
/status・/doctor・/usageの説明を確認) - Claude Pricing — Anthropic公式(2026-09-27 取得。稼働率SLAの記載がないことを確認)
- Claude for Enterprise — Anthropic公式(2026-09-27 取得。稼働率SLAの記載がないことを確認)
- Anthropic Commercial Terms of Service — Anthropic公式(2026-09-27 取得。稼働率保証・サービスクレジット条項の記載がないことを確認)
- Amazon Bedrock Service Level Agreement — AWS公式(2026-09-27 取得。ページ表記 Last Updated: October 4, 2023。月間稼働率とサービスクレジット率を確認)
- Vertex AI Platform Service Level Agreement — Google Cloud公式(2026-09-27 取得。ページ表記 Last modified February 12, 2026。Covered Service ごとの月間稼働率を確認)
著者: 佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。早稲田大学法学部在学中に生成AIの可能性に魅了され、X(旧Twitter)で活用法を発信(@SuguruKun_ai、フォロワー約10万人)。100社以上の企業向けAI研修・導入支援を展開。著書『AIエージェント仕事術』『Claude仕事術』(SBクリエイティブ)。SoftBank IT連載7回執筆(NewsPicks最大1,125ピックス)。
ご質問・ご相談は お問い合わせフォーム からお気軽にどうぞ。
この記事の内容を社内展開する方へ: Claude Code × ビジネス活用 実践ガイド(無料・PDF 30ページ+Excel) をダウンロードできます。