結論:Qwen4-Maxは、Alibaba(アリババ)グループのQwenチームが2026年11月16日に公開した、Qwen4シリーズ最初のモデルです(2026年11月17日時点)。2.4兆パラメータの土台を持ち、画像と動画を読み取り、100万トークンの文脈を扱えます。
- 要点1:APIの料金は100万トークンあたり、シンガポールの地域で入力1.5ドル・出力4.5ドル、東京などのGlobalと北京で入力1.413ドル・出力4.24ドルです。
- 要点2:公式の比較の図では、16のテストのうち6つ(DeepSWE v1.1・HLAB-Vals-1.1・BioMysteryBenchなど)でClaude Opus 5.5より高く、10(ProgramBench・Terminal-Bench 4.0など)で低い点でした。前の世代(図ではQwen3.8-Max-0902)と比べられる15のテストでは、すべて点が上がっています。
- 要点3:日本からは、QwenCloudの東京の地域でも提供されています(料金表で確認)。ただし東京のQwen4-Maxは、中国本土を含む空いている拠点で推論する「Global」の区分だけです。モデルの重みは、2026年11月17日時点でQwenのHugging FaceとGitHubに見当たりません。
対象読者:Qwen4-Maxを仕事で試すかどうか決めたい開発者・情報システムの担当・AI導入の担当の方
読了後にできること:使う窓口(API・Token Plan・チャット)と地域を決め、社内で確かめる規約の項目を一覧にできます。
最終更新:2026年11月17日
Qwen4-Max(クウェン・フォー・マックス)は、2026年11月17日時点でAlibabaグループの大規模言語モデル「Qwen」の最上位モデルで、2026年11月16日に公式ブログで公開されました。QwenCloud(Qwenのモデルを使うためのAlibabaのクラウド)のAPIと定額のToken Planのほか、公式ブログによるとQwenWork(報告書や資料づくりを任せるアプリ)・Qoder(AIエージェントでソフトを作る開発ツール)・QwenStudio(チャット)でも使えて、APIの料金は100万トークンあたり入力1.413〜1.5ドル、出力4.24〜4.5ドルです(地域で変わります)。
「中国の新しいモデルが、一部のテストでOpusに勝ったらしい。でも、うちの仕事で使っていいの?」と迷っている方は多いと思います。気になるのは、性能・料金・日本から使えるか・会社で使って大丈夫か、の4つですよね。
この記事では、Qwenの公式ブログ、QwenCloudの料金表と文書、利用規約をもとに、この4つを順に説明します。なお、当社ではQwen4-Maxをまだ動かしていません。性能は公式ブログの図と第三者の評価のページの値、料金は2026年11月17日時点で公式の料金表を確認した値です。
Qwen4-Maxとは|発表日・作り・使える場所
Qwen4-Maxは、Qwenチームが「仕事・創作・発見のためのAIの同僚」と位置づける最上位モデルです。公式ブログ(2026年11月16日)によると、新しいQwen4の作りで組まれ、2.4兆パラメータの土台、画像を読み取る力、100万トークンの文脈を持ちます。QwenCloudの文書「Latest model: Qwen4-Max」は、Qwen4ファミリーで最初のモデルと説明しています。
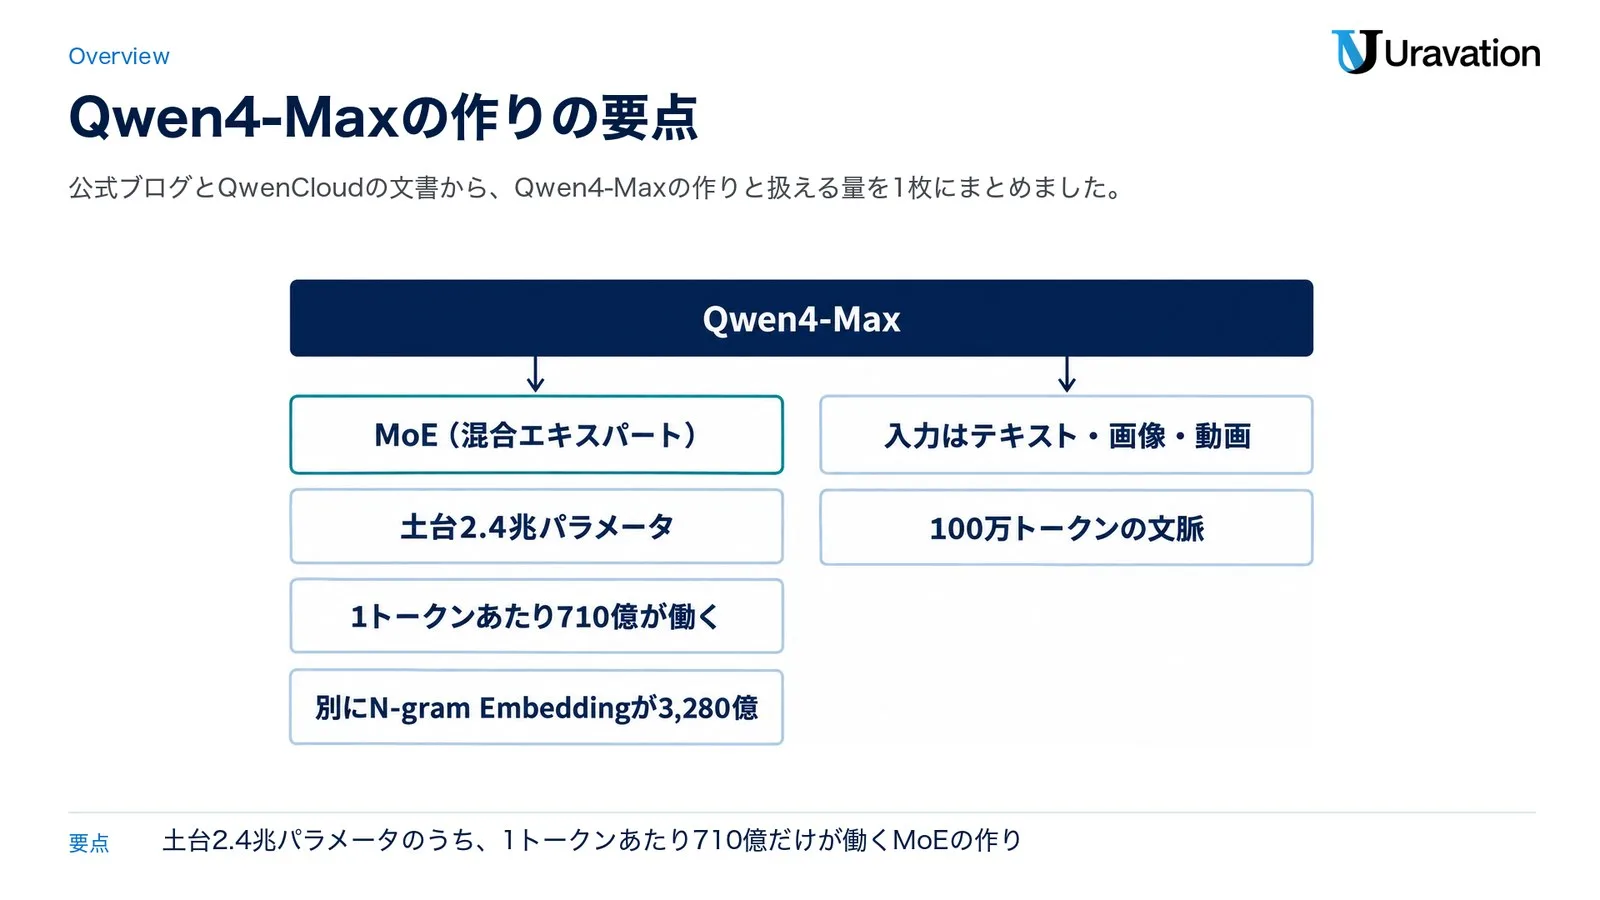
パラメータは、モデルの中で学習によって決まる数値の数のことです。Qwen4-Maxは土台に2.4兆の数値を持ちながら、1つのトークン(文字や語のかけら)を処理するたびに働くのは710億だけ、という作りになっています(このほかにN-gram Embeddingの3,280億があります)。必要な部分だけを動かすこの作りは「MoE(混合エキスパート)」と呼ばれ、大きさのわりに計算を抑えられるのが特徴なんです。
| 項目 | 内容 |
|---|---|
| 公開日 | 2026年11月16日(公式ブログの日付) |
| APIのモデルID | qwen4-max |
| 作り | 土台2.4兆パラメータ・1トークンあたり710億が働く・別にN-gram Embeddingが3,280億 |
| 入力と出力 | 入力はテキスト・画像・動画、出力はテキスト |
| 文脈の長さ | 100万トークン(最大の入力は思考なしで991,808・思考ありで983,616、出力は思考なしで131,072、思考と答えの合計で262,144) |
| 思考(推論) | 既定でオン。強さはlow・high・xhighから選べる |
| 主な機能 | 関数の呼び出し・JSONなどの決まった形の出力・Web検索・PDFの読み取り・コードの実行・MCP(外部のツールとつなぐ共通の手順) |
| 対象外の機能 | バッチ推論・微調整・デプロイ(微調整したモデルを動かす専用の推論環境をQwenCloudに作る機能)。いずれも文書「Latest model」の記載 |
| 使える場所 | QwenCloud(Token PlanかAPI)・QwenWork・Qoder・QwenStudio |
| 重み(モデル本体) | QwenのHugging FaceとGitHubに見当たらない(2026年11月17日時点)。公式ブログは同じ系統の小さいモデルを今後オープンソースで出すと記載 |
出典:公開日・作り・使える場所は公式ブログ、入力と出力はQwenCloudのモデルのページ、それ以外は文書「Latest model: Qwen4-Max」(モデルのページの機能の一覧にはBatchesとFine-tuningも並んでいますが、文書ではQwen4-Maxの対象外です)、重みはHugging Face・GitHub・Artificial Analysisで確認(2026年11月17日)。
作りの新しい点として、公式ブログは次の3つを挙げています。名前と狙いだけ押さえておけば十分です。
- GDNとQSA:過去の内容を決まった大きさにまとめ(Gated DeltaNet)、関係する文脈だけを選ぶ(Qwen Sparse Attention)ことで、長い入力の計算を減らす
- Gated Residual:層をまたいで情報を渡す道を4本並べ、読み書きの量を調整して学習を安定させる
- N-gram Embedding:近くに並ぶトークンの組み合わせを表から引き、計算をほとんど増やさずに容量を広げる。この部分が別に3,280億パラメータある
Qwenのこれまでのモデル(Qwen3.5〜3.8)の一覧と違いは、Qwenとは|モデル一覧と使い方にまとめています。
Qwen3.8-Maxから何が変わったか|トークンと費用
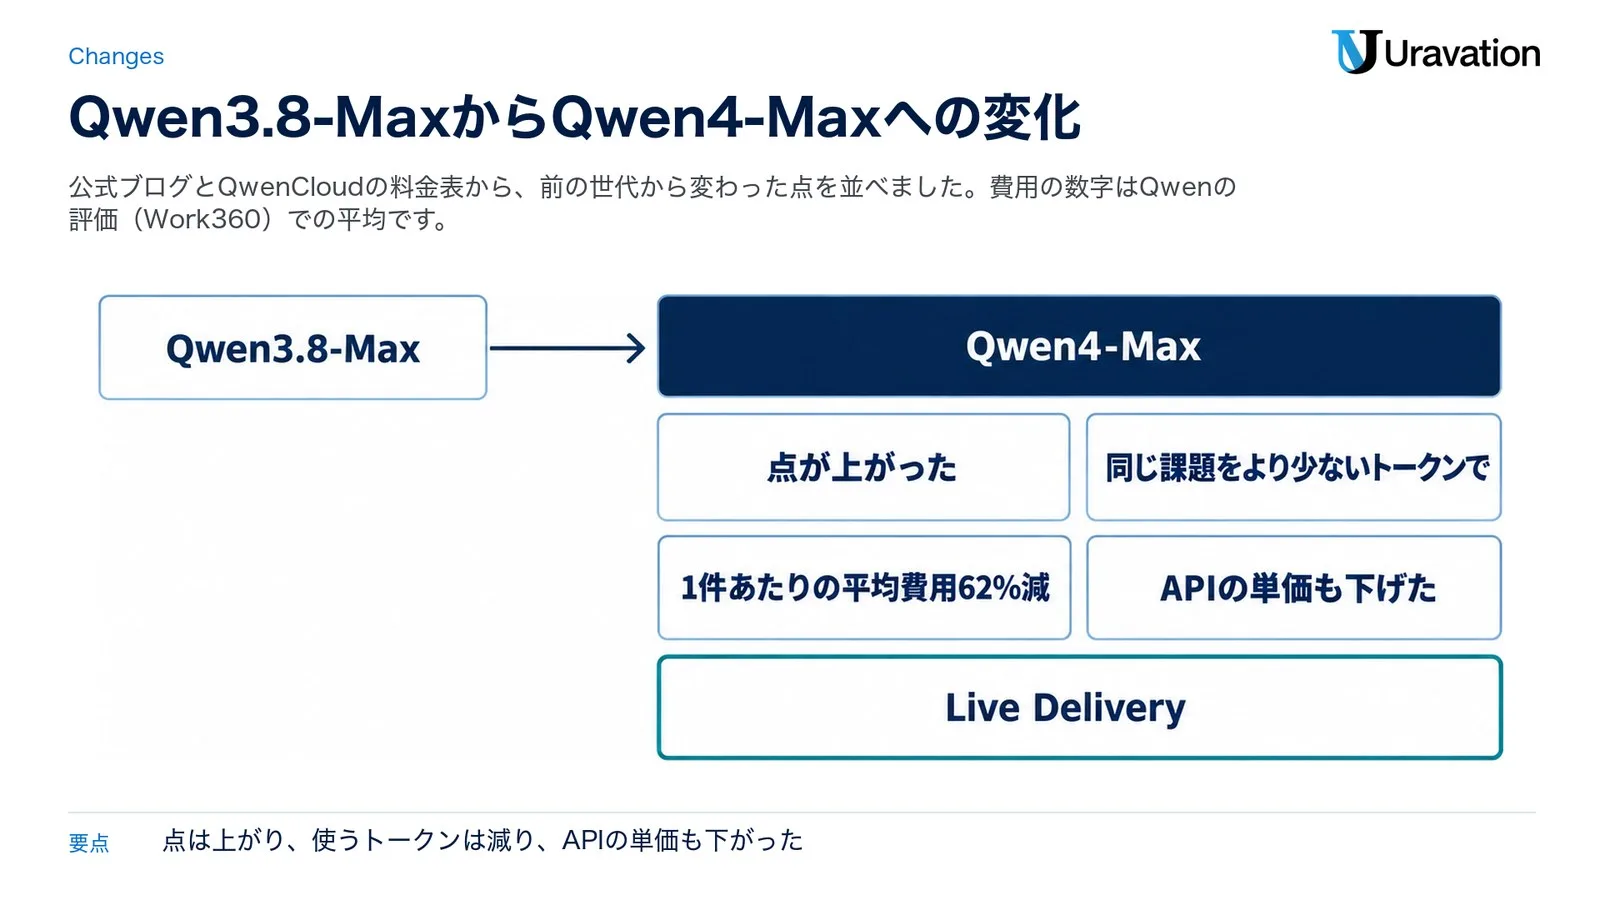
公式ブログは、Qwen4-Maxを前の世代のQwen3.8-Maxから大きく前進したモデルと説明しています。点が上がっただけでなく、同じ課題をより少ないトークンでこなし、APIの単価も下げた、というのが今回の目玉なんです。
| 比べた項目 | Qwen3.8-Max → Qwen4-Max |
|---|---|
| Work360の点 | 47.74 → 52.69 |
| Work360で使うトークンの量 | 推論の強さXhighで約24%減、Highで約35%減 |
| Terminal-Bench 4.0で使うトークンの量 | Xhighで約48%減、Highで約49%減 |
| Work360の1件あたりの平均費用 | 4.43ドル → 1.67ドル(62%減) |
| APIの単価(シンガポール・100万トークンあたり) | 入力2ドル → 1.5ドル、出力6ドル → 4.5ドル |
| APIの単価(東京などのGlobal・100万トークンあたり) | 入力1.65ドル → 1.413ドル、出力4.951ドル → 4.24ドル |
| 事前学習を終えた段階(Base)の社内評価 | BPB(予測の外れの大きさを表す値・低いほど良い)が約5〜13%低く、働くパラメータは25%少ない |
出典:点・トークン・費用・事前学習は公式ブログ、APIの単価はQwenCloudのModel pricing(2026年11月17日に確認)。
読むときの注意が3つあります。
- Work360は、Qwenチームが自分で作った仕事の評価です(26の大分類・182の中分類・721の専門分野)。他社が測った値ではありません。
- XhighやHighは「推論の強さ」、つまり答える前にどれだけ考えるかの設定です。トークンの減り方は設定とテストで変わります。
- 1件あたりの平均費用62%減(4.43ドルから1.67ドル)という数字は、Work360の課題での平均です。自社の仕事で同じ割合で下がるとは限らないので、正直ここは自社の課題で測るしかありません。
公式ブログは、APIの値下げは「とくにキャッシュ入力が大きい」とも書いています。キャッシュは、社内の決まりのように毎回同じ前置きを送る時、2回目以降を安く読ませる仕組みで、Qwen4-Maxの読み出しはシンガポールで100万トークンあたり0.075ドルです。Qwen3.8-Maxのキャッシュの単価は、2026年11月17日時点で料金表から値を確かめられませんでした。
もう1つの新しい点が「Live Delivery」です。長い作業で使える最初の版を早めに渡し、版を重ねて良くしていく仕組みで、途中で人が直したり方向を変えたりできます。試すためのプラグインはGitHubのQwen-Live-Delivery-Pluginで公開されています(Apache-2.0)。Qwen3.8-Maxより前のMaxはQwen 3.6-Maxの記事で振り返れます。
Qwen4-Maxの性能|公式の比較の図で見る
公式ブログには、コーディング・仕事・長い作業の16のテストで6つのモデルを並べた比較の図があります。並んでいるのはQwen4-Max、Qwen3.8-Max-0902、AnthropicのClaude Opus 5.5、OpenAIのGPT-6.1 SolとGPT-6 Astra、Moonshot AIのKimi K3.1です(図の表記はOpus5.5・GPT6.1-Sol・GPT6-Astra)。GoogleのGeminiは図に載っていないので、この図ではGeminiとは比べられません。
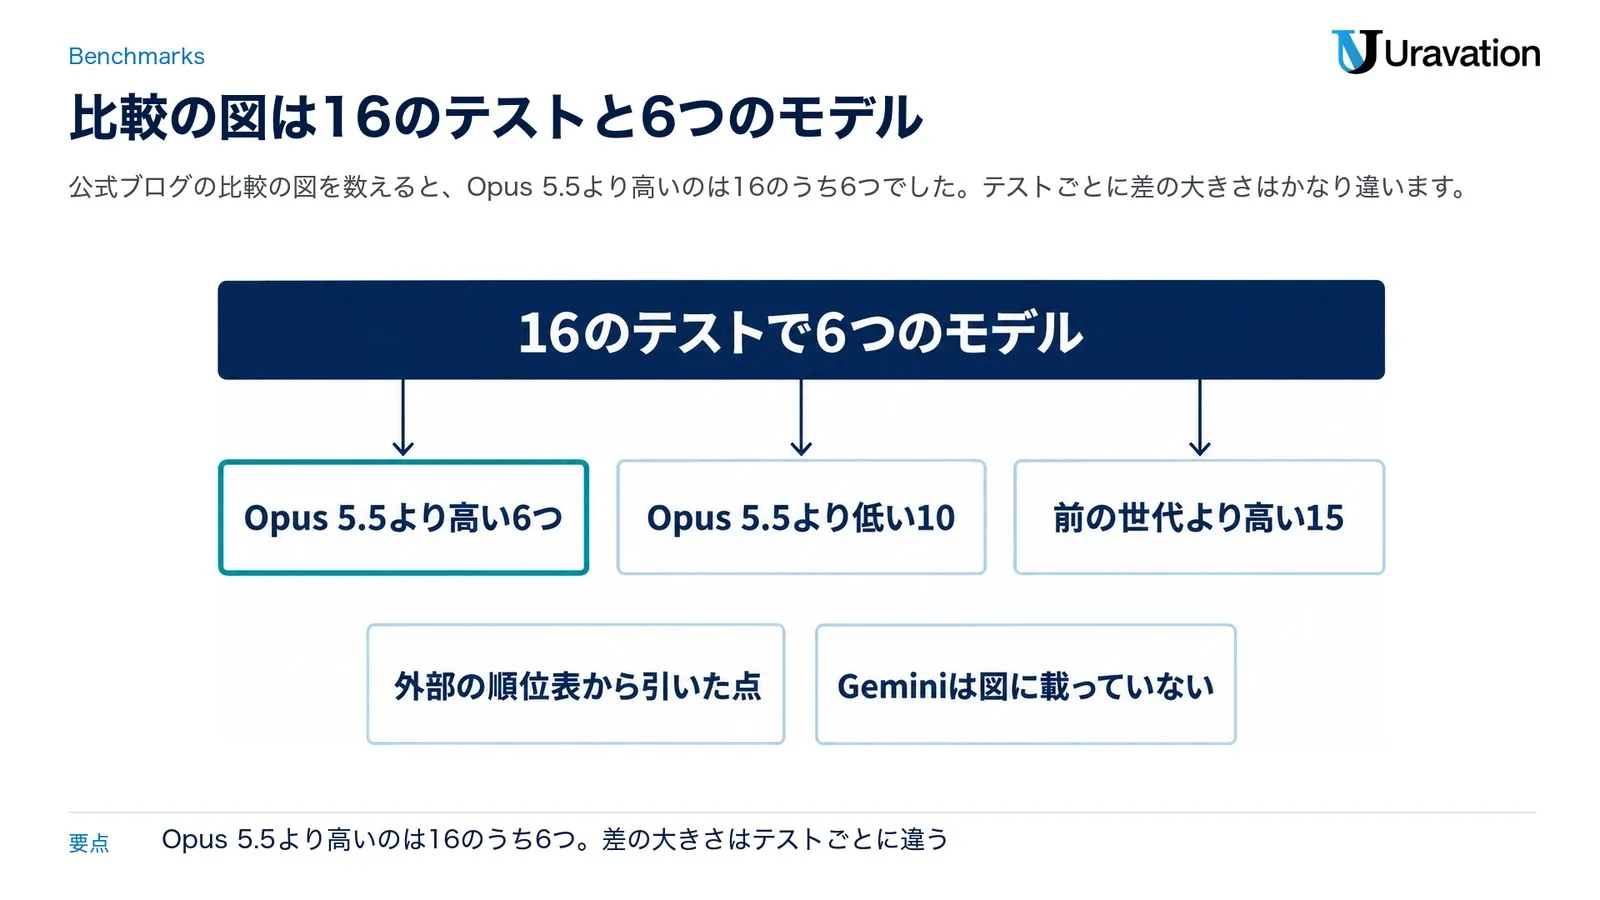
図の数字を書き写したのが下の表です。太字は、そのテストで6つのモデルのうち最も高い値です。「—」は、そのモデルが図に載っていないテストです。
| テスト(測る内容) | Qwen4-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 | Qwen3.8-Max-0902 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1(エージェントとしてのコーディング) | 75.7 | 74.2 | 75.2 | 74.1 | 75.5 | 69.3 |
| CodeArena(Web開発・Eloの点) | 1750 | 1816 | 1742 | 1763 | 1686 | 1676 |
| Terminal-Bench 4.0(ターミナルでのコーディング) | 48.5 | 59.6 | 56.1 | 59.1 | 67.2 | 38.9 |
| ProgramBench(中身の見えないソフトの再現) | 31.5 | 65.0 | 52.5 | 55.0 | 25.0 | 28.0 |
| AA-Briefcase v1.1(知識の仕事・Eloの点) | 1686 | 1801 | 1555 | 1569 | 1674 | 1605 |
| Agents’ Last Exam v1.1(時間のかかる価値の高い作業) | 46.7 | 43.4 | — | 42.6 | 43.4 | 27.9 |
| JobBench(職業の仕事) | 68.5 | 75.4 | 66.2 | 66.1 | 61.2 | 65.3 |
| APEX-Agents v1.1(専門サービスの仕事) | 72.1 | 73.5 | 60.0 | 64.7 | 65.5 | 63.3 |
| HLAB-Vals-1.1(法律の仕事) | 21.3 | 9.2 | 6.3 | 7.1 | 11.7 | 15.4 |
| AutomationBench-AA(SaaSの作業の流れ) | 72.5 | 69.5 | 64.9 | 68.5 | 73.3 | 56.2 |
| AgentArena(実際のエージェントの作業) | 7.5 | 18.2 | 11.8 | 13.9 | 3.9 | — |
| BioMysteryBench(生命情報の研究) | 85.0 | 81.9 | 84.4 | 78.9 | 80.6 | 84.1 |
| HealthBench Professional(臨床の推論) | 60.0 | 59.9 | 65.1 | 66.0 | 57.2 | 39.6 |
| Humanity’s Last Exam(分野をまたぐ推論) | 51.7 | 59.8 | 54.0 | 53.6 | 51.1 | 43.9 |
| Chartography(グラフの読み取り) | 54.2 | 66.3 | 67.8 | 71.1 | 50.0 | 42.0 |
| Video-Index(動画の理解) | 68.1 | 74.8 | 73.8 | 76.7 | 63.2 | 63.2 |
出典:Qwen公式ブログの比較の図(2026年11月17日に確認)。Eloは、対戦の勝ち負けから出す点です。
報道では、GIGAZINEが「一部テストでClaude Opus 5.5に勝利」と伝えました(2026年11月16日の記事)。図で数えると、Qwen4-MaxがOpus 5.5より高いのは16のうち6つです。
- Opus 5.5より高い6つ:DeepSWE v1.1(75.7対74.2)・Agents’ Last Exam v1.1(46.7対43.4)・HLAB-Vals-1.1(21.3対9.2)・AutomationBench-AA(72.5対69.5)・BioMysteryBench(85.0対81.9)・HealthBench Professional(60.0対59.9)
- Opus 5.5より低い10:CodeArena・Terminal-Bench 4.0・ProgramBench・AA-Briefcase v1.1・JobBench・APEX-Agents v1.1・AgentArena・Humanity’s Last Exam・Chartography・Video-Index
- 前の世代より高い15:Qwen3.8-Max-0902が載っている15のテストすべて
Qwen4-Maxが6つのモデルで最も高かったのは、DeepSWE・Agents’ Last Exam・HLAB-Vals・BioMysteryBenchの4つです。HLAB-Vals(法律の仕事)やAgents’ Last Exam(時間のかかる作業)で目立つ一方、ProgramBenchは31.5対65.0と差が大きく、グラフや動画の読み取りでもOpus 5.5とGPTを下回りました。HealthBenchのように差が0.1しかないテストもあり、「勝った」の中身はテストごとにかなり違います。
図の脚注によると、APEX-Agents・AA-Briefcase・AutomationBench-AA・CodeArena・AgentArena・HLAB-Vals・Agents’ Last Examの点は、外部の順位表から引いた点です(Mercor・Artificial Analysis・Arena・Vals Indexなど)。相手のモデルをどの設定で測ったかは、脚注で確かめられませんでした。
第三者の評価も見ておきましょう。Artificial Analysis(2026年11月17日に確認)では、総合の指数が43で、比べた中の中央値41を上回りました。一方で、1つの課題にかかる時間は32.1分で、比べた中の中央値13.3分より長く、評価で出したトークンも1億2,700万(比べた中の中央値は7,860万)と多めです(公式ブログの「使うトークンが減った」は、前の世代のQwen3.8-Maxと比べた話です)。この評価での1課題あたりの費用は3.27ドルでした。
Qwen4-Maxの料金|API・Token Plan・無料枠
Qwen4-MaxのAPIは使った分だけ払う従量課金で、100万トークンあたりの単価は地域によって2通りです。思考(推論)を使っても使わなくても同じ値で、入力の長さによる段階もありません。請求はどの地域でも米ドルです(QwenCloudの料金の文書・2026年11月17日に確認)。
| 項目(100万トークンあたり・ドル) | シンガポール(International) | 北京・Global(Frankfurt・Hong Kong・Tokyo・US Virginia) |
|---|---|---|
| 入力 | 1.5 | 1.413 |
| 出力(思考と答えの合計) | 4.5 | 4.24 |
| キャッシュの書き込み(5分) | 1.875 | 1.767 |
| キャッシュの書き込み(1時間) | 3 | 2.827 |
| キャッシュの読み出し(明示・暗黙) | 0.075 | 0.071 |
思考に使ったトークンは出力として数えられるので、考える量を増やすほど出力の費用が増えます。バッチ(まとめて後で処理して半額)の仕組みは、Qwen4-Maxでは対象外と文書に書かれています。また、Web検索などの組み込みの道具には、トークンとは別に1,000回あたりの料金がかかり、無料枠では払えません(Web検索は1,000回あたりシンガポールで10ドル、ほかの地域で0.573411ドル。コードの実行は期間限定で無料)。
無料枠はシンガポールの地域だけ(ふつう100万トークン・90日)
無料枠の文書によると、無料枠はシンガポールの地域だけで、モデルごとにふつう100万トークン(入力と出力の合計)です。Qwen4-Maxの料金表の行にも「1 million tokens」とあります。
- 支払いの情報を登録すると付く
- 期間はふつう90日。登録した日に出ていたモデルは登録日から、後から出たモデルは公開日から数える
- シンガポールで作ったAPIキーで、シンガポールの窓口を呼んだ時だけ使える(ほかの地域は最初から課金)
- 使い切った時に止める設定(Free quota only)を選べる
Token Plan(定額)とPreview版
Token Planは、プランに付くクレジット(Credits。使った分が差し引かれる利用の枠で、クレジットカードのことではありません)でモデルを使う定額の契約で、払い方は月・3か月・年から選べます。Claude Code・Codex・Qwen Code・QoderなどのAIツールから複数のモデルを使えます。個人向けはLite・Essential・Standard・Proの4段階(クレジットはLiteに比べて1倍・2.25倍・4倍・10倍で、上限は1か月ごと)、チーム向けはStandard・Pro・Maxの3種類の席です。チーム向けは、データをモデルの学習に使わないことを保証すると書かれています。
Token Planはシンガポールの地域だけで、専用の窓口と専用のAPIキー(sk-sp-で始まる)を使います。更新履歴によると、Qwen4-Maxは2026年11月16日に個人向けとチーム向けの両方に加わりました。料金のページには、個人向けのLiteとEssentialは通常月6ドルからとあり、新規向けのキャンペーンの価格はログイン後の購入画面で決まると書かれています。
名前が似ている「qwen4-max-preview」は別のモデルIDです。Token Planで先に使えたQwen4-Maxの先行版のモデルで、期間は日本時間で2026年11月11日11時から11月26日1時まで。期間中はクレジットの減りが最も低い場合で標準の20%になり、22時から8時はさらに60%引きと書かれています(公式の文は期間を協定世界時より8時間進んだ時刻で書いていて、この記事では日本時間に直しました。22時から8時がどの時刻の基準かは確かめられませんでした)。設定でモデルを選ぶ時に取り違えないようにしましょう。
ほかのモデルとの単価の比べ
| モデル(100万トークンあたり・ドル) | 入力 | 出力 | キャッシュの読み出し |
|---|---|---|---|
| Qwen4-Max(シンガポール) | 1.5 | 4.5 | 0.075 |
| Qwen4-Max(東京などのGlobal・北京) | 1.413 | 4.24 | 0.071 |
| Claude Opus 5.5 | 4 | 20 | 0.20 |
| GPT-6.1 Sol(標準) | 2.00 | 10.00 | 0.10 |
| GPT-6 Astra(標準) | 10.00 | 50.00 | 1.00 |
出典:QwenCloudの料金の文書、Anthropicの料金のページ、OpenAIの料金のページの標準(Standard)の表(いずれも2026年11月17日に確認)。OpenAIの値は入力が27万2,000トークン以下(Short)の時の値で、それより長い入力(Long)ではGPT-6.1 Solが入力4ドル・出力15ドル、GPT-6 Astraが入力20ドル・出力75ドルになります。キャッシュの読み出しの欄は、Anthropicの「Hits and refreshes」、OpenAIの「Cached input」の値です。
単価だけなら、Qwen4-MaxはOpus 5.5に比べて入力が4割以下、出力が4分の1以下です。ただ、Artificial Analysisの評価では、評価で出したトークンが比べた中の中央値より多めでした。単価が安くても1件あたりの費用が同じ割合で下がるとは限らないので、自社の同じ課題を流して「1件あたりいくらか」で比べるのが確実です。Geminiを含む主なモデルの単価は主要AIモデルのAPI料金の横断比較にまとめています。
Qwen4-Maxの使い方|始めるまでの手順
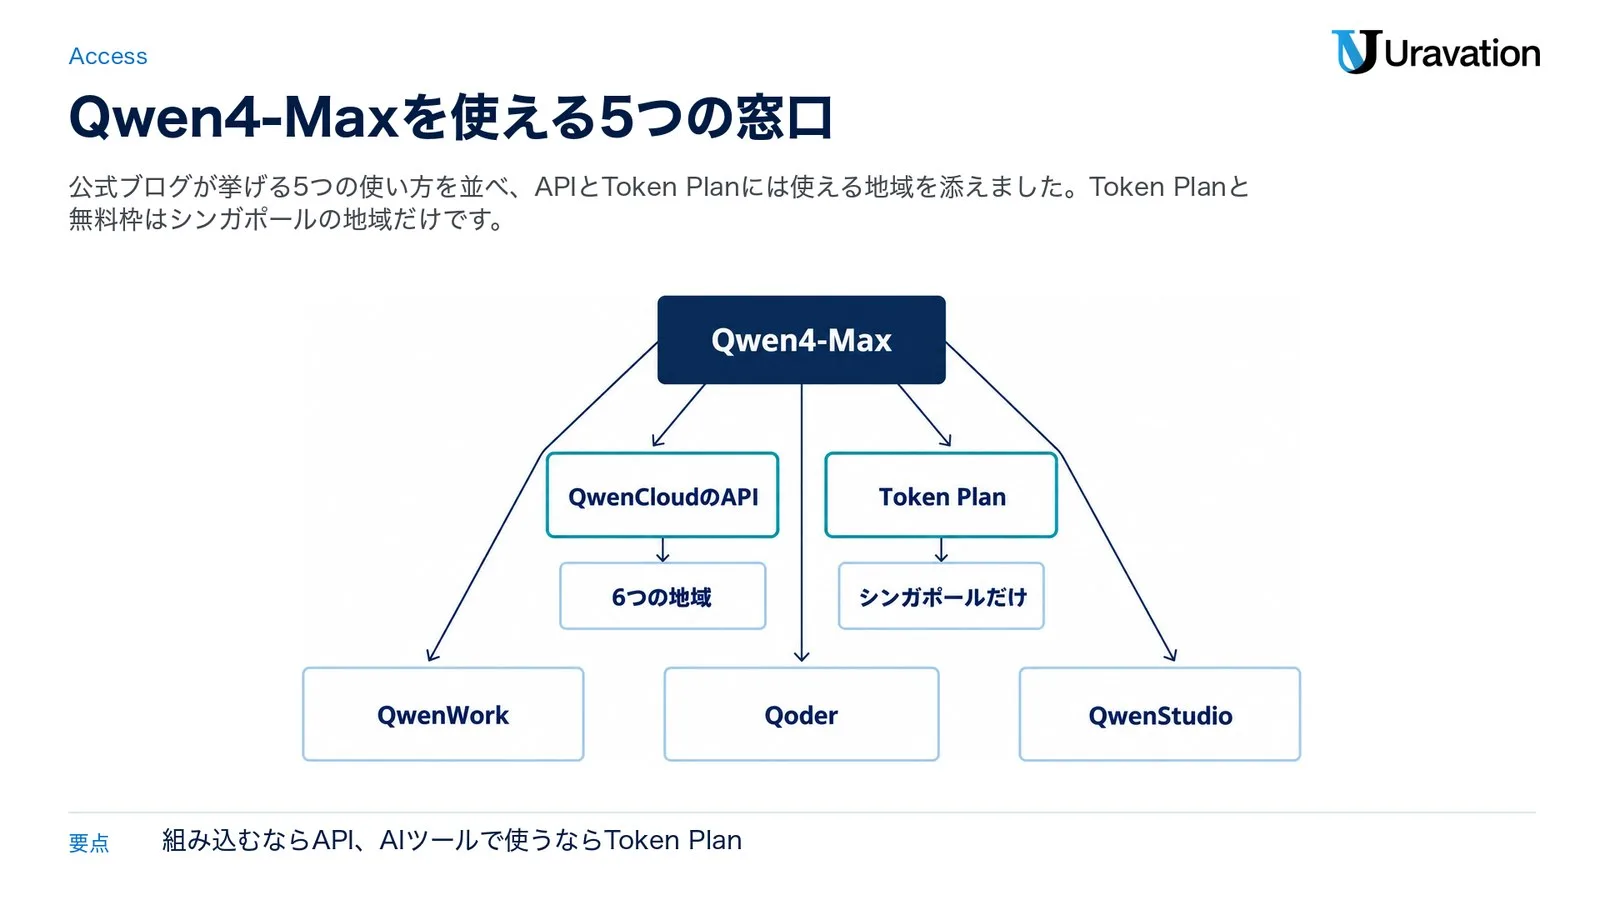
公式ブログが挙げる使い方は5つで、QwenCloudのAPIとToken Plan、それにQwenWork・Qoder・QwenStudioです。自社のシステムに組み込むならAPI、Claude Codeなどの道具で使うならToken Plan、という分け方が基本になります。
| 窓口 | 向いている使い方 | 払い方 | 地域・条件 |
|---|---|---|---|
| QwenCloudのAPI | 自社のシステムに組み込む | 従量課金 | 6つの地域。無料枠はシンガポールだけ |
| Token Plan | Claude Code・Codex・QoderなどのAIツールで使う | 定額(月・3か月・年の払い。クレジットで使う) | シンガポールだけ |
| QwenWork | 報告書・スライド・Webページを作る作業を任せる | 無料プランと500のボーナスクレジット。Token Planのクレジットも使える | MacとWindowsのアプリ・ブラウザ |
| Qoder | AIエージェントでのソフト開発 | 新規は上位のProfessionalを2週間無料で試せる | 日本語のページあり |
| QwenStudio | チャット(リンク先はchat.qwen.ai) | — | ログインしない画面では、Qwen4-Maxを選べるか確かめられなかった |
出典:窓口の5つは公式ブログ、払い方と条件はQwenCloudの文書とQwenWork・Qoderの公式サイト(2026年11月17日に確認)。
APIで始める6つの手順
QwenCloudのQwen4-Maxの文書と地域の文書に書かれた順番です。
- QwenCloudのアカウントを作り、支払いの情報を登録する(シンガポールの地域の無料枠もこの後に付きます。東京などほかの地域は最初から課金)
- コンソールの右上で地域を選ぶ(開いた時はシンガポール。東京はap-northeast-1)
- その地域でワークスペース(APIキー・使えるモデル・呼び出しの上限をまとめる単位)とAPIキーを作る(キーは作った地域の窓口でだけ使える。東京などでは、ワークスペースを作る時に推論の範囲を選び、後から変えられない。2026年11月17日時点の料金表では、東京のQwen4-MaxはGlobalの範囲の行だけ)
- 環境変数DASHSCOPE_API_KEYにキーを入れ、OpenAIのSDKを入れる
- base_urlを地域の窓口にし(シンガポールは https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 、東京はap-southeast-1をap-northeast-1に替える)、modelにqwen4-maxを指定して呼ぶ
- 必要なら推論の強さを変える(既定はhigh。low・high・xhighから選び、Chat Completionsではenable_thinking=falseで思考を切れる)
文書によると、Responses API・AnthropicのMessages API・DashScopeの形でも呼べます。Claude Code・Codex・OpenCodeから使う設定は、文書のツールごとのページにあります。100万トークンの文脈がほかのモデルと比べてどのくらいかは、主要AIモデルのコンテキスト長の横断比較で見られます。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修6,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
日本から使う時と会社で使う前に決めること
QwenCloudには東京の地域(ap-northeast-1)があり、2026年11月17日時点の料金表では、Qwen4-Maxも東京で提供されています。ただし東京のQwen4-Maxは「Global」の区分だけでした。Globalは、中国本土を含む空いている拠点のどこかで推論する区分です。
QwenCloudでは、データを保存する「地域」と、推論を動かす「範囲」(上で「区分」と書いたもの。公式の名前はservice deployment scope)が別々に決まります。地域の文書と料金表を合わせると、Qwen4-Maxは次のようになっています。
| 地域 | 推論の範囲 | 推論する場所 | Qwen4-Max |
|---|---|---|---|
| シンガポール | International | 中国本土の外の拠点 | 料金表にある |
| 北京(China North 2) | Chinese mainland | 中国本土 | 料金表にある |
| 東京 | Global | 中国本土を含む空いている拠点 | 料金表にある |
| 東京 | Japan | 日本だけ | 2026年11月17日時点の料金表で行を確かめられなかった |
| Frankfurt・Hong Kong・Virginia | Global | 中国本土を含む空いている拠点 | 料金表にある |
文書によると、リクエストのデータは呼んだ窓口の地域に保存され、推論の範囲はワークスペースを作る時に決まって後から変えられません(東京などの既定のワークスペースはGlobal)。データの決まりがある場合は、地理の境界がはっきりした範囲を選ぶよう案内されています。ただし、QwenCloudのCustomer Agreement(2026年9月11日発効)の中の、モデル(Models)の利用についての補足(Models Supplemental)には、入れた内容は契約の相手・関連会社・委託先が設備を置く国へ移されて保存・処理され、利用者の所在地と違う国になることがあると書かれています。通信はTLS 1.2以上、保存するAPIキーとアカウントの情報はAES-256で守られ(データの安全の文書)、Trust CenterにはISO 27001やSOC 2 Type 2などの認証が並んでいます。
入れた内容の扱いは窓口で違う
一番気になるのは、入れた内容が学習に使われるかどうかですよね。ここは窓口ごとに規約の文が違います。
| 窓口 | 規約・ポリシーに書かれていること(2026年11月17日時点) |
|---|---|
| QwenCloudのAPI | サービスの提供・維持や法令を守るのに必要な場合を除き、利用者の内容にアクセスしたり使ったりしない(第4条)。モデル(Models)の利用についての補足(Models Supplemental)には、利用者が別に同意しない限り、内容をモデルの開発・改善に使わないとある(Customer Agreement・2026年9月11日発効) |
| QwenCloudのTry AI(モデルを試す画面) | 入れた内容を、Try AIの提供・維持・開発・改善に使う。機密として扱わない(同じ規約の中のTry AIの補足) |
| Token Planのチーム向け | データをモデルの学習に使わないことを保証する(Token Planの文書)。個人向けに同じ保証があるかは、文書で確かめられなかった |
| QwenWork・Qoder | この記事では、それぞれの規約を確かめていない |
| Qwenのチャット(chat.qwen.ai) | 内容をモデルの学習に使うことがある。privacy@qwen.comに知らせると学習から外せるが、評価などのフィードバックは引き続き使われる。生の入力をそのまま学習に使うことはなく、特定の個人に結びつかない形にしたデータを使う(Qwen利用規約・2026年9月10日発効、プライバシーポリシー・2026年9月7日発効) |
QwenCloudの規約では、契約の相手は利用者の居住地か、登録した時の請求先の住所で決まります。英国・スイスなど欧州経済領域の外の欧州の利用者は英国の会社、欧州経済領域の利用者はオランダの会社、米国とマレーシアの利用者はそれぞれの国の会社、QwenCloudが事業を行うそれ以外の地域の利用者はシンガポールのAlibaba Cloud (Singapore) Private Limitedと書かれています(日本は名指しされていません)。準拠法はシンガポール法で、争いはシンガポール国際仲裁センター(SIAC)の仲裁で解決すると書かれています。チャットは、シンガポールのNth Power Global Tech Singaporeが運営し、入れた内容はAlibaba Cloud(Singapore)に送られてシンガポールで処理されます。
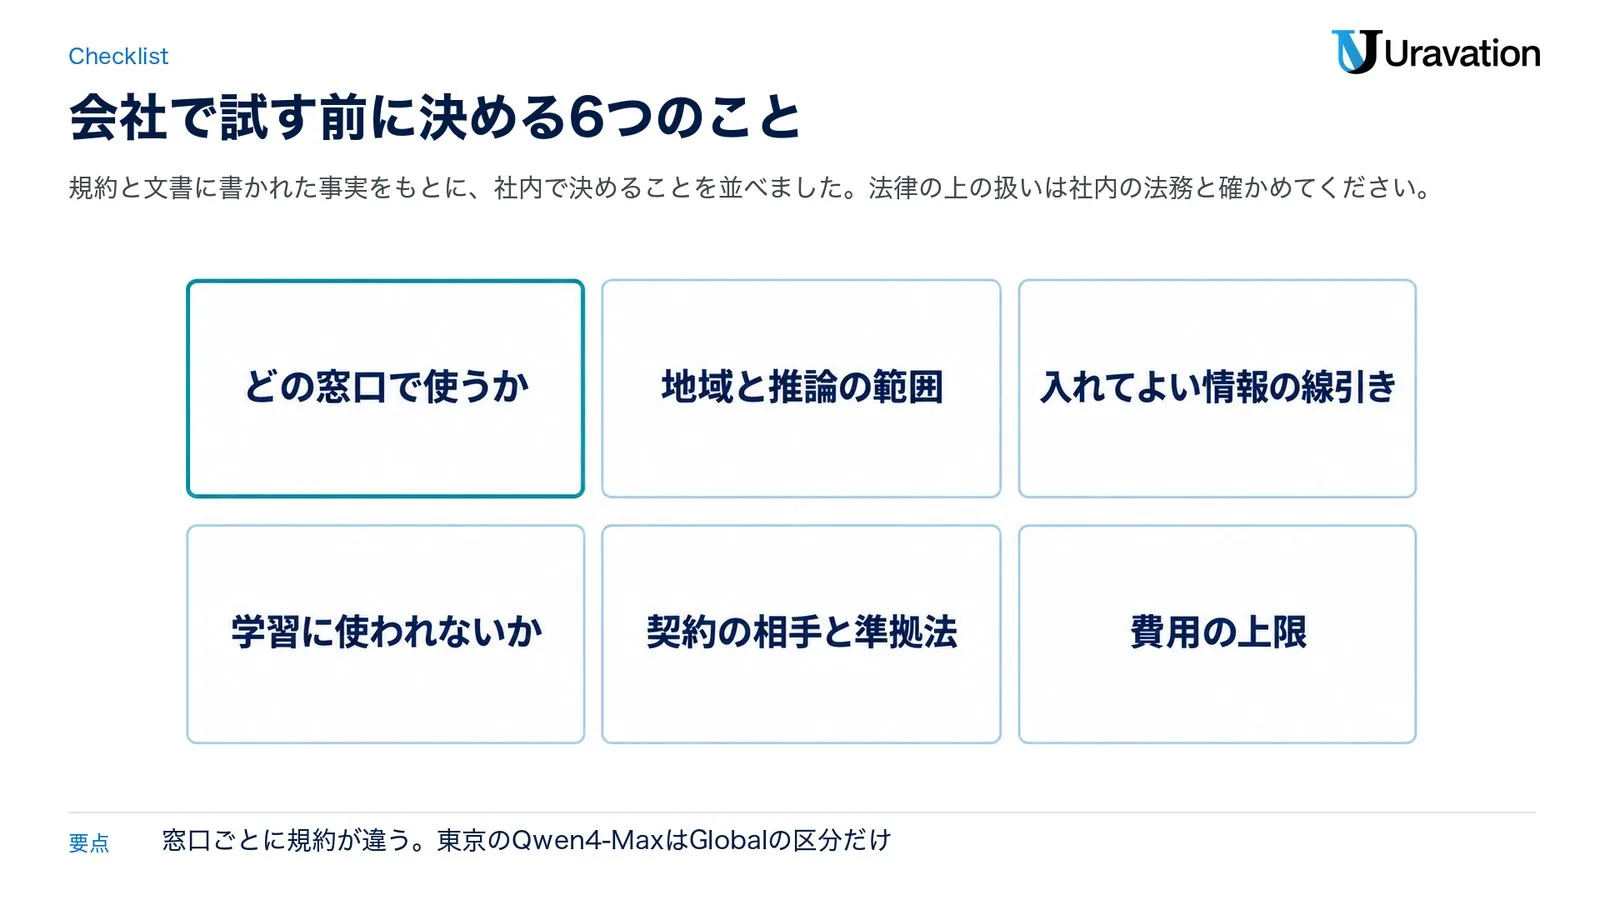
会社で試す前に決める6つのこと
| 決めること | 確かめる所・目安 |
|---|---|
| 1. どの窓口で使うか | API・Token Plan・チャットで規約が違う(上の表) |
| 2. 地域と推論の範囲 | 東京のQwen4-MaxはGlobalだけ。範囲は後から変えられない |
| 3. 入れてよい情報の線引き | 社内の情報の区分。個人情報や取引先の情報を入れるかどうか |
| 4. 学習に使われないか | APIの規約の文・チーム向けの保証・チャットの外し方 |
| 5. 契約の相手と準拠法 | 規約の相手の一覧・シンガポール法と仲裁 |
| 6. 費用の上限 | 無料枠を使い切ったら止める設定(Free quota only)・使った額が決めた額に達したらメールで知らせる設定(spending alert)・Token Planのプランと払い方・支払いの方法 |
ここに書いたのは、規約と文書に書かれている事実までです。自社の決まりや法律の上でどう扱うかは、社内の法務・情報システムの担当と一緒に確かめてください。
Claude Opus 5.5・Gemini 4・GPTとの使い分け
公式の図で見る限り、Qwen4-Maxの点が6つのモデルで最も高かったのは、HLAB-Vals(法律の仕事)・Agents’ Last Exam(時間のかかる作業)・DeepSWE(エージェントとしてのコーディング)・BioMysteryBench(生命情報の研究)の4つのテストで、DeepSWEとBioMysteryBenchは2番目のモデルとの差が0.2〜0.6でした。中身の見えないソフトの再現(ProgramBench)やターミナルでのコーディング、グラフや動画の読み取りでは、Opus 5.5やGPTのほうが高い点でした。単価はOpus 5.5よりかなり安い一方、第三者の評価では1つの課題にかかる時間が長めです。どれが上かは、仕事の種類によって変わると考えるのが自然です。
GoogleのGemini 4は、Qwenの比較の図に載っていないため、この図からは比べられません。Gemini 4・Opus 5.5・GPT-6 Astraの料金と使い分けは、GPT-6 Astra・Opus 5.5・Gemini 4の比較にまとめています。
Uravationならこう選びます。今の仕事で使っているモデルを、すぐに置き換えることはしません。まず公開してよいデータで、いつも頼んでいる課題を同じ条件で数件ずつ流し、1件あたりの費用・かかった時間・人が直した量を並べます。そのうえで、HLAB-Vals(法律の仕事)やAgents’ Last Exam(時間のかかる作業)のように、図でほかのモデルより点が高かったテストに近い仕事から、APIかToken Planのどちらか1つの窓口に絞って試します(HLAB-Valsの点は、最も高いQwen4-Maxでも21.3です)。窓口を1つに絞れば、確かめる規約も1つで済むからです。
よくある質問
Qwen4-Maxは無料で使えますか?
QwenCloudのAPIなら、シンガポールの地域に100万トークン(入力と出力の合計)の無料枠があります。支払いの情報の登録が必要で、期間はふつう90日です。ほかの地域とToken Planは有料です。QwenStudio(chat.qwen.ai)やQwenWorkの無料の範囲、Qoderの2週間の無料のお試しでQwen4-Maxを使えるかは、2026年11月17日時点で確かめられませんでした。
Qwen4-Maxは日本から使えますか?
公式の文書と料金表で確かめた範囲では、提供されています。QwenCloudには東京の地域(ap-northeast-1)があり、Qwen4-Maxも東京の料金表に載っています。ただし東京では、中国本土を含む空いている拠点で推論する「Global」の区分だけです。Token Planと無料枠を使う時は、日本からでもシンガポールの地域を選びます。日本の住所や支払いの方法で登録できるかは、2026年11月17日時点で確かめられませんでした。
Qwen4-Maxは日本語に対応していますか?
2026年11月17日時点で、公式ブログ・QwenCloudのモデルのページ・文書に、対応する言語の一覧や日本語の記載を確かめられませんでした。Qwenのサイトとチャットの画面、利用規約には日本語の版があります。仕事で使う前に、自社の日本語の文書で小さく試して確かめてください。
Qwen4-Maxの重み(オープンウェイト)は公開されていますか?
2026年11月17日時点で、公開されているのを確かめられませんでした。Hugging FaceのQwenの組織とGitHubのQwenLMにQwen4のモデルは見当たらず、Artificial Analysisも重みを公開していないモデル(Proprietary)として載せています。公式ブログは同じ系統の小さいモデルを今後オープンソースで出すと書いていますが、時期は2026年11月17日時点で公式に示されていません。手元のPCで動かすなら、公開済みのQwenを使うOllamaでQwenをローカル実行する手順が参考になります。
Qwen4-MaxはどこのAIですか?
中国のAlibabaグループのQwenチームが作ったモデルです。APIのQwenCloudは、利用者の所在地に応じてシンガポール・英国・オランダ・米国・マレーシアの各社が契約の相手になり(英国・欧州・米国・マレーシア以外の、QwenCloudが事業を行う地域の利用者はシンガポールの会社と規約に書かれています)、チャット(chat.qwen.ai)はシンガポールの会社が運営しています。会社で使う前の確認は「日本から使う時と会社で使う前に決めること」にまとめました。
Qwen4-MaxはClaude Codeで使えますか?
QwenCloudの文書には、Token Plan(個人・チーム)か従量課金のAPIで、Claude Code・Codex・OpenCodeから使う設定の案内があります。Token Planはシンガポールの地域で契約し、専用の窓口とAPIキー(sk-sp-で始まる)を使います。
まとめ
Qwen4-Maxは、2026年11月16日に公開されたQwen4シリーズ最初のモデルです。2026年11月17日時点の要点は3つです。
- 性能:公式の図では、16のテストのうち6つ(DeepSWE v1.1・HLAB-Vals-1.1・BioMysteryBenchなど)でClaude Opus 5.5より高く、10(ProgramBench・Terminal-Bench 4.0など)で低い点でした。前の世代(図ではQwen3.8-Max-0902)からは、比べられる15のテストすべてで上がっています。
- 料金:APIは100万トークンあたり入力1.413〜1.5ドル、出力4.24〜4.5ドル。シンガポールの地域に100万トークンの無料枠があります。
- 日本から:東京の地域でも提供されていますが、東京はGlobalの区分だけです。重みはQwenのHugging FaceとGitHubに見当たりません。
まずは使う窓口を1つ決めて、その窓口の規約の文を社内で共有するところから始めると、試すまでの話が早く進みます。QwenのほかのモデルはQwenとは|モデル一覧と使い方、Qwen3.8-Maxより前のMaxはQwen 3.6-Maxの記事もあわせてどうぞ。
参考・出典
- Qwen4-Max: Your New Teammate Has Arrived — Qwen公式ブログ(2026年11月16日・参照日: 2026-11-17)
- QwenCloud(モデルと料金):Qwen4-Max(モデルのページ)・Latest model: Qwen4-Max・Pricing・Model pricing・Free quota(参照日: 2026-11-17)
- QwenCloud(地域と安全):Regions, deployment scopes, and endpoints・Data security & privacy・Trust Center・Customer Agreement(2026年9月11日発効)(参照日: 2026-11-17)
- QwenCloud(Token Plan):Token Plan・Token Plan product updates・料金のページ(参照日: 2026-11-17)
- 利用規約 と プライバシーポリシー — Qwen(参照日: 2026-11-17)
- QwenLM/Qwen-Live-Delivery-Plugin — GitHub(参照日: 2026-11-17)
- Qwen — Hugging Face(参照日: 2026-11-17)
- Qwen4 Max: Intelligence, Performance & Price Analysis — Artificial Analysis(参照日: 2026-11-17)
- Pricing — Anthropic(参照日: 2026-11-17)
- Pricing — OpenAI(参照日: 2026-11-17)
- QwenWork と Qoder — 各サービスの公式サイト(参照日: 2026-11-17)
- 「Qwen4-Max」が登場、一部テストでClaude Opus 5.5に勝利し小型オープンモデルも後日公開予定 — GIGAZINE(2026年11月16日・参照日: 2026-11-17)
この記事の内容を社内展開する方へ: ローカルLLM 社内導入チェックシート(無料・PDF 32ページ+Excel) をダウンロードできます。