結論:Gemini TTS は、Google の Gemini API で文章を音声に変える音声合成のモデルで、2026年11月15日時点の最新は Gemini 3.8 Flash TTS(gemini-3.8-flash-tts)と Gemini 3.8 Flash-Lite TTS(gemini-3.8-flash-lite-tts)の 2 つです。Google AI Studio と Gemini API の無料枠で試せて、日本語は 2 つとも対応言語の表に入っています。
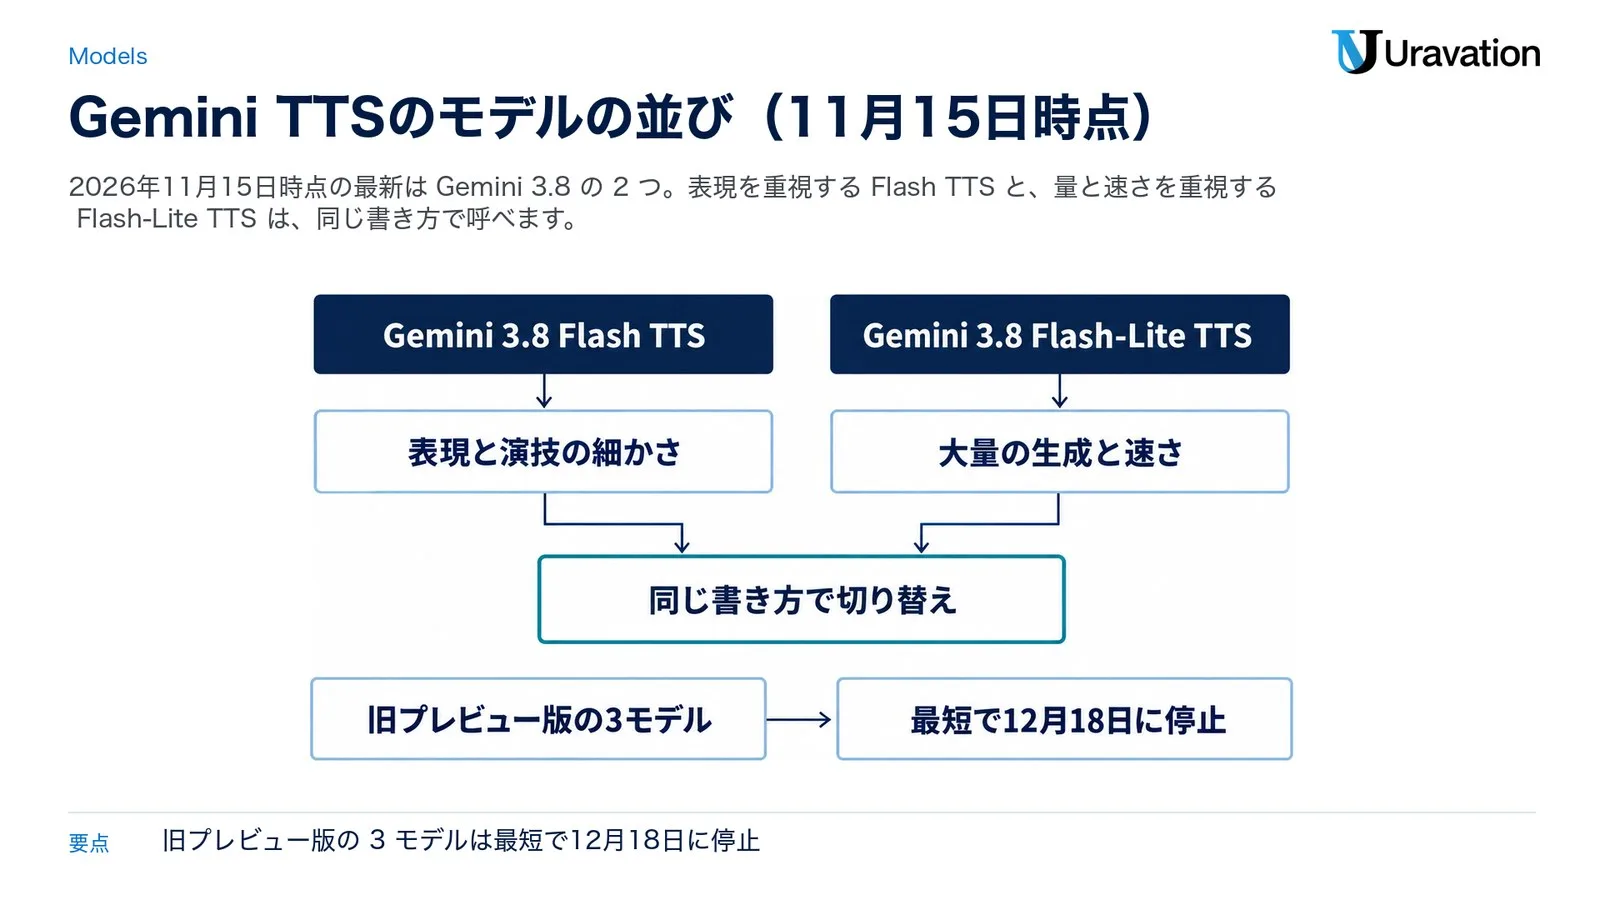
- 要点1:Flash TTS は演技や表現の細かさを重視するモデル、Flash-Lite TTS は大量の生成・速さ・費用を重視するモデルです。Gemini 4 の 3 モデルは出力がテキストだけで、音声合成は Gemini 3.8 の 2 つが担っています。Gemini API の旧プレビュー版の 3 モデルは、最短で2026年12月18日に止まる予定です
- 要点2:有料の段階(Paid Tier。請求先のアカウントをつないだプロジェクト)の標準の単価は 100 万トークン(AI が文字や音声を数える単位)あたり、入力(台本の文字)が 0.50 ドル、出力(音声)が Flash TTS 9.00 ドル・Flash-Lite TTS 6.00 ドルです(2026年12月31日まで)。2027年1月1日からはどれも 2 倍になります。音声は 1 秒が 25 トークンです
- 要点3:無料枠で送った文章と作った音声は、Google の製品の改善に使われ、人が読むことがあります。機密や個人の情報は無料枠に送らず、扱うなら有料の段階にします(有料でも、禁止された使い方を見つけるためなどにログが一定の期間残ります)。人の声を複製する時は本人の同意の録音を用意します。作った音声には SynthID の透かしが入ります
対象読者:研修動画のナレーション、電話や窓口の音声の案内、社内向けの音声資料を AI の声で作りたい会社の担当者と開発者
読了後にできること:どちらのモデルを使うか、無料枠と有料の段階のどちらで使うか、社内で何を確かめてから使い始めるかを決められます。
最終更新:2026年11月15日
Gemini TTS は、Google の Gemini API で文章を音声に変える音声合成(TTS:Text-to-Speech)の機能で、2026年11月15日時点の最新のモデルは、2026年9月に公開された Gemini 3.8 Flash TTS と Gemini 3.8 Flash-Lite TTS の 2 つです。Google AI Studio(Google が開発者向けに用意している、ブラウザで AI のモデルを試せる画面)で試せて、API(ほかのシステムから呼び出すための窓口)を使えば自社の仕組みに組み込めます。
例えば、研修動画のナレーションを社員が毎回録音している場合、台本を 1 行直すたびに録り直しになりますよね。Gemini TTS は、台本の文章と声の指定を渡すと音声ファイルを返すので、直した段落だけ音声を作り直す、という作り方が考えられます。話す人を 2 人にした会話の音声や、「ささやくように」「ゆっくり」といった話し方の指示にも対応しています。
一方で、無料枠のデータの扱い、人の声を複製する時の同意、2027年1月からの値上がりなど、会社で使う前に知っておきたい点もあります。この記事は、2026年11月15日時点で Google の発表、Gemini API のドキュメント・料金ページ・規約を確認し、モデルの違い・始め方・声の選び方・料金と無料枠・日本語の対応・使う前の注意を順に説明します。なお、当社は今回 Gemini TTS を動かしておらず、音の質については Google の説明の範囲で書いています。
Gemini TTSとは|2026年11月15日時点のモデルと機能
Gemini TTS は、Gemini API の音声生成の機能です。入力は文字だけ、出力は音声だけで、渡した台本の文字をそのとおりに読み上げます。話し方(明るく、ささやくように、など)は台本とは別の欄で指示する作りで、指示の文が読み上げられないようになっています(Gemini API の音声生成のドキュメント)。2026年11月15日時点で使える最新のモデルは、次の 2 つです。
| 項目 | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| モデル ID | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
| 状態 | 一般提供(GA)。Gemini API の更新履歴(2026年9月22日の項)の記載 | |
| Google の位置づけ | 表現と演技の細かさを最も重視する上位のモデル | 速さと費用を重視する、日々の大量の生成向けのモデル |
| 向いている用途(モデルのページの表) | オーディオブック、スタジオ品質のナレーション、込み入った 2 人の会話、発音の難しい語、地域の方言 | 大量の音声の生成、リアルタイムの音声エージェント、読み上げ機能、声の複製、ふだんの 1 人の読み上げ |
| 対応言語の数(モデルのページ) | 130 言語 | 101 言語 |
| 入力と出力 | 入力はテキスト、出力は音声 | |
| 1 回の上限 | 入力 8,192 トークン、出力 16,384 トークン(Gemini API の上限) | |
| 声を作る機能 | Voice design(言葉で声を作る)・Voice replication(声の複製)・Voice remixing(声の手直し)に対応 | |
| 後継の関係(モデルのページ) | 新しい上位の位置づけ | gemini-3.1-flash-tts-preview の後継 |
出典は、Gemini 3.8 Flash TTS のモデルのページとGemini 3.8 Flash-Lite TTS のモデルのページ(どちらもモデルの最新の更新は 2026年9月と表示)、Gemini API の更新履歴です。対応言語の数は資料によって書き方が違い、音声生成のドキュメントは「Flash TTS は 130 以上、Flash-Lite TTS は 100 以上」、Google の発表は 2 つまとめて「100 以上」と書いています。
発表は、Google の英語のブログ(Gemini 3.8 text-to-speech says hello)と日本語の Google Japan のブログで、どちらも2026年9月23日付です。Gemini API の更新履歴と非推奨のページの表は、公開日を 9月22日と書いています。
Gemini 4 に音声合成のモデルはあるか
2026年11月15日時点で、Gemini 4 の系統の音声合成のモデルは確かめられませんでした。Gemini 4 の 3 モデル(Carbon・Argon・Hydrogen)は、それぞれのモデルのページで出力がテキストだけと書かれ、音声生成(Audio generation)の欄は「対応していない」になっています(Gemini 4 Carbon のモデルのページほか)。モデル一覧の音声のモデルの表に Gemini 4 の名前は無く、旧モデルの移る先として挙がっているのは 3.8 の 2 つです。Gemini API の更新履歴も 11月12日の分まで見ましたが、音声合成の新しいモデルの項目はありませんでした。
旧プレビュー版の 3 モデルは最短で12月18日に停止
前の世代の音声合成のモデルは、Gemini API の非推奨のページで停止の予定が出ています。表の日付は「最も早く止まる可能性がある日」で、正確な日は前もって知らせると書かれています。
| 旧モデル | 公開日 | 停止の予定(最短) | 移る先 |
|---|---|---|---|
gemini-3.1-flash-tts-preview | 2026年2月26日 | 2026年12月18日 | 3.8 Flash TTS か 3.8 Flash-Lite TTS |
gemini-2.5-flash-preview-tts | 2025年5月20日 | 2026年12月18日 | |
gemini-2.5-pro-preview-tts | 2025年5月20日 | 2026年12月18日 |
前のモデルを使っている場合、移る時に書き方が変わる点があります。ドキュメントの移行の説明では、話し方の指示を台本の文から speech_metadata の style の欄へ移すこと、1 回で音声を返す呼び出しの既定の出力が、ヘッダーの無い生の音声データから WAV ファイルに変わったことなど、5 つの変更点が挙がっています。台本の頭に「明るく話して:」のように書いていた場合、3.8 ではその文まで読み上げられることがある、と書かれているので注意してください。
Gemini TTSを使える場所と始め方
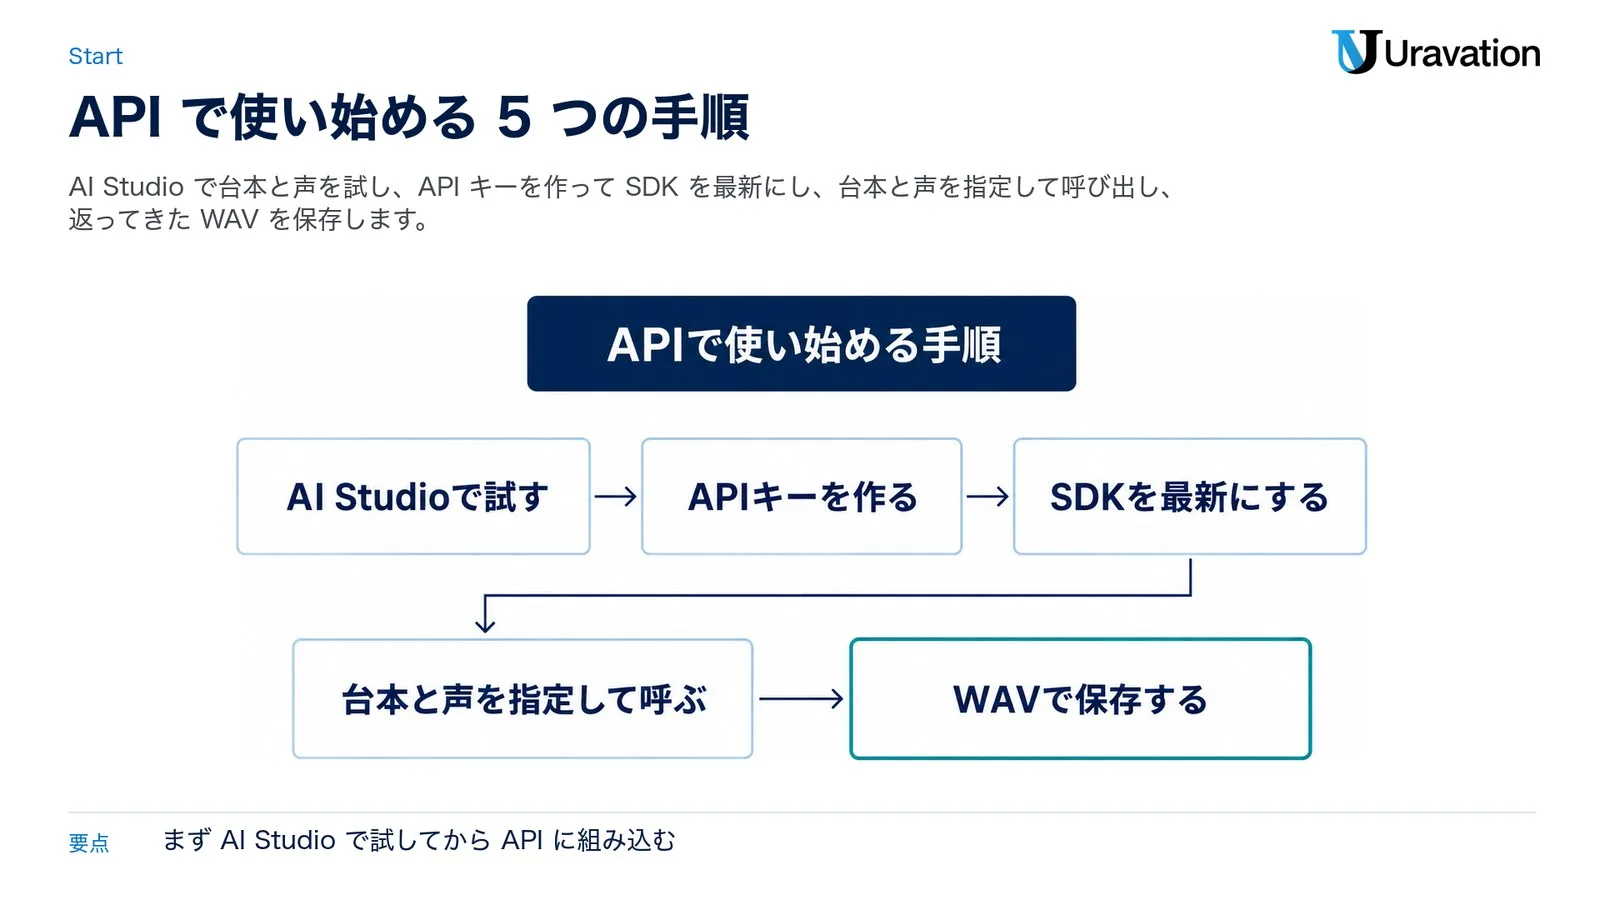
Gemini TTS は、開発者なら Google AI Studio と Gemini API で使えます。会社の Google Cloud の環境で使う場合は、Vertex AI を発展させた Gemini Enterprise Agent Platform(Google Cloud のブログ・2026年4月23日)から使えます。2026年11月15日時点の状態を場所ごとに表にまとめ、API で使い始める 5 つの手順を図にしました。
| 使う場所 | 主な利用者 | 2026年11月15日時点の状態 |
|---|---|---|
| Google AI Studio | 開発者・まず試したい人 | 2 つのモデルを試せる。言葉で声を作る画面と、声を複製する画面もある(声の複製は有料の段階〔Tier 1 以上〕のプロジェクトだけ) |
| Gemini API | 開発者 | 2 つのモデルとも一般提供(GA) |
| Google Cloud(Agent Platform API と、コードを書かずに試せる Agent Studio) | 企業 | 一般提供(GA)。言葉で声を作る機能と声の複製はプレビュー。2 つのモデルとも Cloud Text-to-Speech API からは使えない |
| Gemini Notebook(旧 NotebookLM) | すべての人 | 発表では、Flash TTS を提供 |
| Google Vids(Google の動画作成のサービス) | すべての人 | 発表では、Flash-Lite TTS を提供 |
Google AI Studio と Gemini API の欄は音声生成のドキュメントと更新履歴、Google Cloud の欄は Google Cloud の Gemini TTS のページ(2026年11月12日更新)と Cloud Text-to-Speech の Gemini-TTS のページ(2026年11月10日更新)、下の 2 行は 9月23日の発表によります。AI Studio の欄の声の複製の条件(Tier 1 以上)は、声の複製のドキュメントによります。NotebookLM が Gemini Notebook に名前を変えたことは、Google のブログ(2026年7月16日)で発表されています。
発表の時点では、企業向けの Gemini Enterprise の API は「近日提供」でした。今は Google Cloud のドキュメントで一般提供と書かれています。Google Cloud で使える場所は global(世界)・us(米国)・eu(欧州連合)の 3 つで、言葉で作った声や複製した声は global だけで使えます。データを置く国を社内の決まりで指定している会社は、この点を先に確かめてください。Gemini アプリの中で使えるかは、2026年11月15日時点で確かめられませんでした。
API で使い始める 5 つの手順
- Google AI Studio の音声生成のページ(aistudio.google.com/generate-speech)を Google アカウントでログインして開き、台本と声を試します。ドキュメントにも、組み込む前に AI Studio で試すと役に立つと書かれています
- Google AI Studio の API キーのページで API キーを作ります。初めて使う人には、利用規約に同意した後で、既定のプロジェクトと API キーが作られます。すでに Google Cloud のアカウントがある人には既定のプロジェクトは作られないので、使いたいプロジェクトを自分で AI Studio に取り込みます(インポート)。作ったキーを環境変数
GEMINI_API_KEYかGOOGLE_API_KEYに入れておくと、次の手順の部品集(SDK)が自動で読み込みます(API キーのドキュメント) - Google GenAI SDK(Google が用意しているプログラムの部品集)を最新にします。音声生成のドキュメントによると、Python は google-genai 2.25.0 以上、JavaScript・TypeScript は @google/genai 2.24.0 以上です(部品集を使わずに HTTP で直接呼ぶ REST API でも呼べます)
- モデル ID・台本・声・話し方を指定して呼び出します(下の例)
- 返ってきた音声を保存します。1 回で音声を返す呼び出しは、WAV(よく使われる音声ファイルの形式。24 kHz・モノラル・16 ビット)で返るので、文字の形(base64)で届いたデータを元に戻せば、そのままファイルに書き出せます
次の例は、音声生成のドキュメントに載っている Python の例そのままです。1 人の声で「Have a wonderful day!」を、明るく親しみやすい話し方で読み上げ、out.wav に保存します。
import base64
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Have a wonderful day!",
            "annotations": [{
                "type": "speech_metadata",
                "style": "cheerful and friendly",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": "Kore"},
        ]
    },
)

with open("out.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
例の見方は 3 点です。text に読み上げる台本、style に話し方、voice に声の名前(Kore は定番の声の 1 つ)を入れます。モデルを Flash-Lite TTS に替える時は、model の値を gemini-3.8-flash-lite-tts にするだけで、2 つのモデルは同じ書き方で呼べます。読み上げる言語は台本から自動で判定されるので、日本語の台本は text に日本語で書きます。
この例は Interactions API という呼び出し方の形ですが、モデルのページには、もう 1 つの呼び出し方である generateContent の形で呼ぶ時の書き方も載っています。作りながら少しずつ音声を受け取りたい時は、ストリーミング(stream: true)を使います。この時の既定の出力は、ヘッダーの無い 16 ビットの音声データ(24 kHz・モノラル)です。AI Studio の始め方と API キーの扱いは、Google AI Studioとは|無料枠はいつまで・APIキーでも説明しています。
声の選び方とスタイルの指示
Gemini TTS の声は、出来合いの声から選ぶ方法と、自分で作る方法を合わせて 5 通りあります(音声生成のドキュメントの「Voice options」)。
- 定番の声(Prebuilt voices):ドキュメントの表に載っている 30 種。その表にある名前(Kore・Puck など)を
voiceに書けば使えます - 拡張ボイスライブラリー(Extended Voice Library):言語・なまり・キャラクターの型ごとの数百の声。AI Studio で聞き比べられ、API では言語・地域・性別・声の高さ・向いている用途で絞り込めます
- Voice design:年齢・声質・なまり・基本の話し方を言葉で説明して声を作り、繰り返し使える声の ID(
voice_...)としてプロジェクトに保存します - Voice replication:本人の声の録音と、本人が同意文を読み上げた録音から声を複製します。条件は「使う前の注意」の節で説明します
- Voice remixing:定番の声や、Voice design で作った声を、言葉の指示で手直しして新しい声として保存します。発表では「近日提供」でしたが、更新履歴によると 2026年11月4日に公開されました
声の数は資料によって違います。ドキュメントは「定番 30 種と、ライブラリーの数百」、9月22日の更新履歴は「定番と自作を合わせて 150 以上を検索できる」、発表は「2,000 以上」と書いています。定番の 30 種は、ドキュメントの表に Kore(Firm)や Puck(Upbeat)のように、名前と声の特徴を表す英語の 1 語が並んでいます。
音声生成のドキュメント(「Custom voice limits and TTL」)によると、自分で作った声は、1 つのプロジェクトに 200 個まで保存でき、最後に使ってから 1 年使わないと自動で消えます。保存しない形の声のキー(voicekey_...)は 7 日で切れます。
2 人の会話は話者ごとに分けて書く
2 人の会話の音声は、speech_config の speakers に 2 人分の名前と声を設定し、台本を話者ごとのまとまりに分けて、それぞれに speaker と style を付けます。1 人の例との違いは、speech_config が声の一覧ではなく話者の設定(speakers)になる点です。書き方の例は、音声生成のドキュメントの「Multi-speaker TTS」に載っています。1 回の呼び出しで話せるのは、定番の声を使った 2 人までです。自分で作った声や複製した声で会話を作る時は、話者ごとに 1 回ずつ音声を作ってつなぎます。
話し方は style、一瞬の音はタグで指示する
- ひとまとまり全体の話し方(感情・速さ・声の大きさ)は
styleに書きます。例は「whispered urgently」「out of breath」「speaking slowly」など - その場の一瞬の音(咳・ため息・笑い・間)は、台本の中に山かっこのタグで入れます。例は
<short pause>・<long pause>・<sigh>・<laugh>・<cough> - 相づちは、2 人の会話で聞き手の反応を縦棒で囲みます(例
|oh really?|)
ドキュメントは、まず style を空にして試し、直したい所だけ短い指示を足す順をすすめています。年齢・性別・名前・なまりのような変わらない特徴は style に書かず、声を選び直すか Voice design で作ります。前のモデルの書き方のまま長い人物設定の文を送ることが、声がぶれるいちばん多い原因だ、とも書かれています。
Gemini TTSの料金と無料枠
Gemini TTS の料金は、入力(台本の文字)と出力(音声)のトークンの数で決まります。2026年11月15日時点の Gemini API の料金ページでは、2 つのモデルとも無料枠(Free Tier)の標準の利用は無料で、有料の段階(Paid Tier)は「2026年12月31日まで」と「2027年1月1日から」の 2 つの単価が並んでいます。音声は 1 秒が 25 トークンとして数えます。
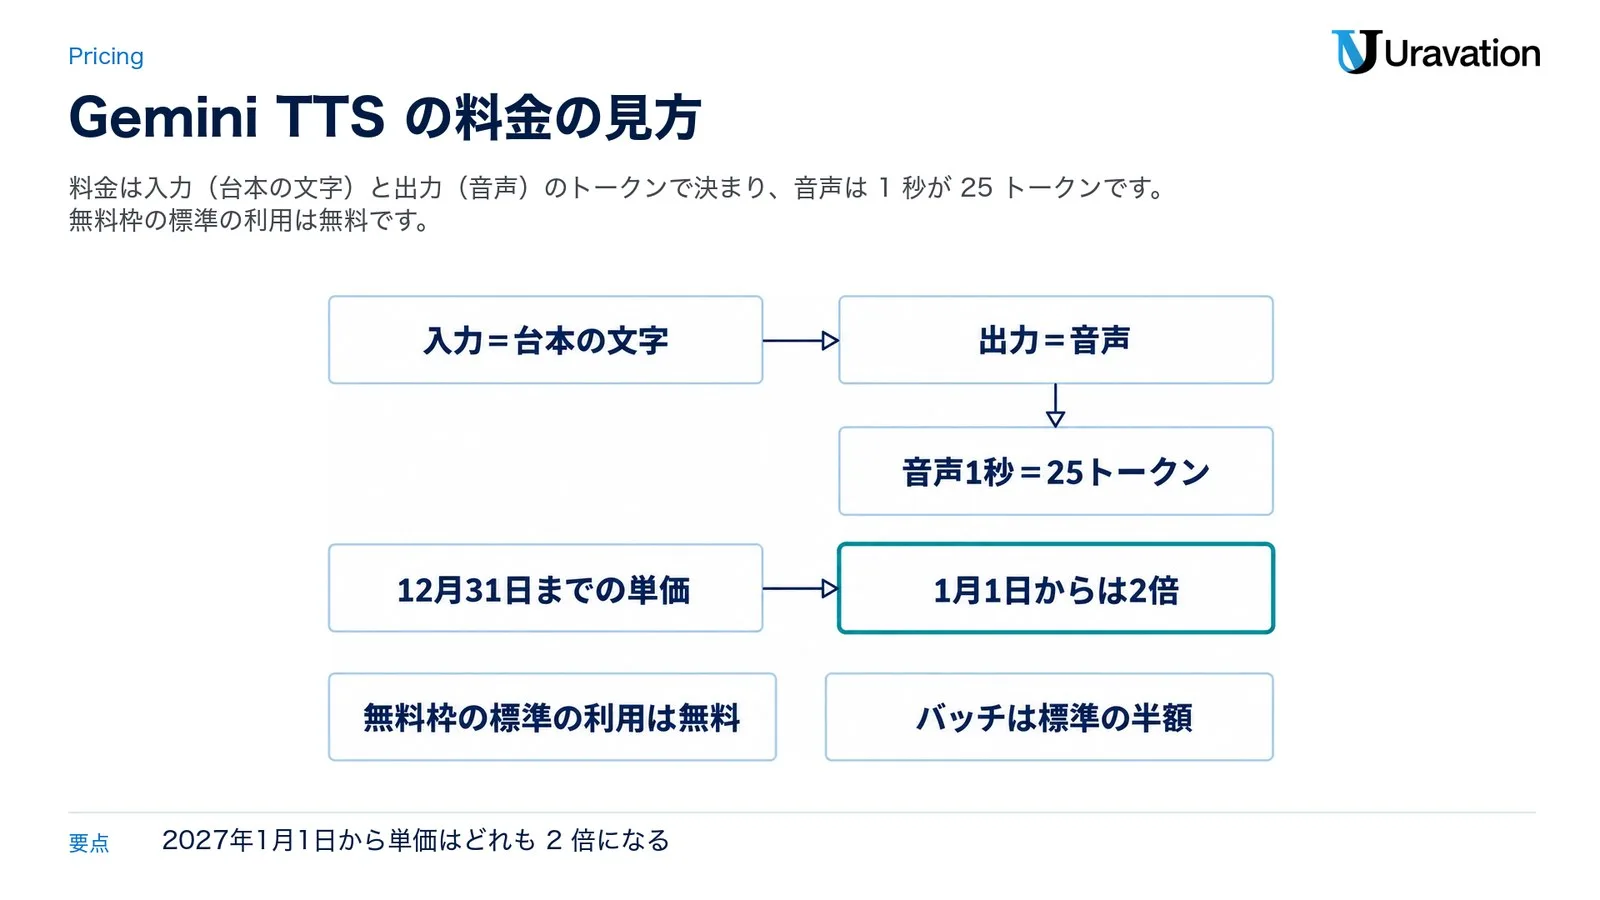
有料の段階の単価は次のとおりです(100 万トークンあたり・米ドル)。
| モデルと使い方 | 期間 | 入力(テキスト) | 出力(音声) | 音声 10 秒あたり |
|---|---|---|---|---|
| Flash TTS・標準 | 2026年12月31日まで | 0.50 ドル | 9.00 ドル | 0.00225 ドル |
| 2027年1月1日から | 1.00 ドル | 18.00 ドル | 0.0045 ドル | |
| Flash TTS・バッチ | 2026年12月31日まで | 0.25 ドル | 4.50 ドル | 0.001125 ドル |
| 2027年1月1日から | 0.50 ドル | 9.00 ドル | 0.00225 ドル | |
| Flash-Lite TTS・標準 | 2026年12月31日まで | 0.50 ドル | 6.00 ドル | 0.0015 ドル |
| 2027年1月1日から | 1.00 ドル | 12.00 ドル | 0.003 ドル | |
| Flash-Lite TTS・バッチ | 2026年12月31日まで | 0.25 ドル | 3.00 ドル | 0.00075 ドル |
| 2027年1月1日から | 0.50 ドル | 6.00 ドル | 0.0015 ドル |
バッチは、急がない大量の処理をまとめて送り、結果を後から受け取る使い方で、標準の半額です(バッチのドキュメント。目安は 24 時間以内で、generateContent の形でだけ使えます)。料金ページには、ほかに Flex(バッチと同じ単価)と Priority(標準より高い単価)の欄もあります。Flex は、応答までの時間が決まっておらず、混み具合によっては処理されないこともある代わりに標準の半額になる使い方、Priority は、標準より高い単価で、標準や Flex より優先して処理される使い方で、どちらもプレビューです(Flex のドキュメント・Priority のドキュメント)。ただし、この 2 つのドキュメントの対応モデルの表では、2026年11月15日時点で 3.8 の TTS の 2 つを確かめられませんでした(モデルのページは対応と表示)。2027年1月1日からは、どの欄の単価も 12月31日までの 2 倍になります。
無料枠で使えること・使えないこと
- 標準の利用は、無料枠でも入力・出力とも「Free of charge(無料)」です
- バッチと Flex は、無料枠では使えません(料金ページの表は「Not available」)
- 料金ページの表の「製品の改善に使われるか」の行は、無料枠が「Yes」、有料の段階が「No」です
- 声の複製(Voice replication)は、有料の段階(Tier 1 以上)のプロジェクトでないと使えません(声の複製のドキュメント)
無料枠で使える回数の上限(レート制限)は、使う段階などで変わり、AI Studio のレート制限の画面で確かめる仕組みです(レート制限のドキュメント)。3.8 の TTS の無料枠の回数は、2026年11月15日時点で確かめられませんでした。また、言葉で声を作る・複製する・手直しする機能に別の料金があるかは、2026年11月15日時点で料金ページに記載を確かめられませんでした。
有料の段階に上げるには、AI Studio で請求先のアカウントをつなぎ、最低 5 ドル(ほかの通貨ではそれに相当する額)を前払いします。アカウントによっては、前払い(Prepay)と後払い(Postpay)を選べる場合や、新しい前払いの仕組みが行き渡るまでの間は後払いに割り当てられる場合もあります(課金のドキュメント)。
Google Cloud で使う時の料金
Google Cloud の Agent Platform の料金ページでも、入力と出力の単価は Gemini API と同じ額が並んでいます。ただし、12月31日までの単価は「同じモデルの利用額の 50% をクレジットで戻す」形の販促価格だと注記されています。また、このページではモデル名に「Preview」と付いていて、一般提供(GA)と書く Google Cloud のドキュメントと表記が食い違っています。
試算例:10 分のナレーションの出力の費用
以下は試算です(実測値ではありません)。料金ページの単価と「音声 1 秒=25 トークン」から計算しています。
- 前提:10 分(600 秒)の音声を、有料の段階の標準の使い方で 1 回作る場合
- 計算:600 秒 × 25 トークン = 15,000 トークン。15,000 ÷ 1,000,000 × 9.00 ドル = 0.135 ドル(Flash TTS)、× 6.00 ドル = 0.09 ドル(Flash-Lite TTS)
- 2027年1月1日からは、同じ計算で 0.27 ドル(Flash TTS)と 0.18 ドル(Flash-Lite TTS)
- 入らない物:台本の文字(入力)の分。台本の長さで変わるので、上の額に別に加わります
Gemini TTSの日本語の対応
日本語は、2026年11月15日時点の音声生成のドキュメントの対応言語の表で、Gemini 3.8 Flash TTS と Gemini 3.8 Flash-Lite TTS の両方に対応の印が付いています。読み上げる言語は台本から自動で判定されるので、日本語の台本をそのまま渡せば日本語で読み上げます。
気をつけたいのはタグの書き方です。ドキュメントは、台本が英語以外でも、<short pause> や <laugh> のようなタグは英語のまま使うと良い結果になると書いています。タグを日本語に訳して「<笑う>」のように書くのは、このすすめとは違います。声の複製の同意文にも日本語(ja-JP)の文があり、声の持ち主が次の文を読み上げて録音します(声の複製のドキュメント)。
私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。
音の質については、Google が発表の中で、人が聞き比べる Voice Arena の評価で日本語を含む主要な言語で上位に入ったと書いています。当社は今回 Gemini TTS を動かしておらず、定番の 30 種の声が日本語の台本でどう聞こえるかは確かめていません。社内の用途に合う声は、AI Studio で外に出ても困らない台本(機密や個人の情報を含まない物)を入れて聞き比べて選ぶのが確実です。公開されたモデルを自社の環境で動かして日本語を読み上げたい場合の選択肢は、後の「他の音声AIとの違い」の節で触れます。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修6,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
法人での使いどころ|研修動画・電話の案内・社内の音声資料
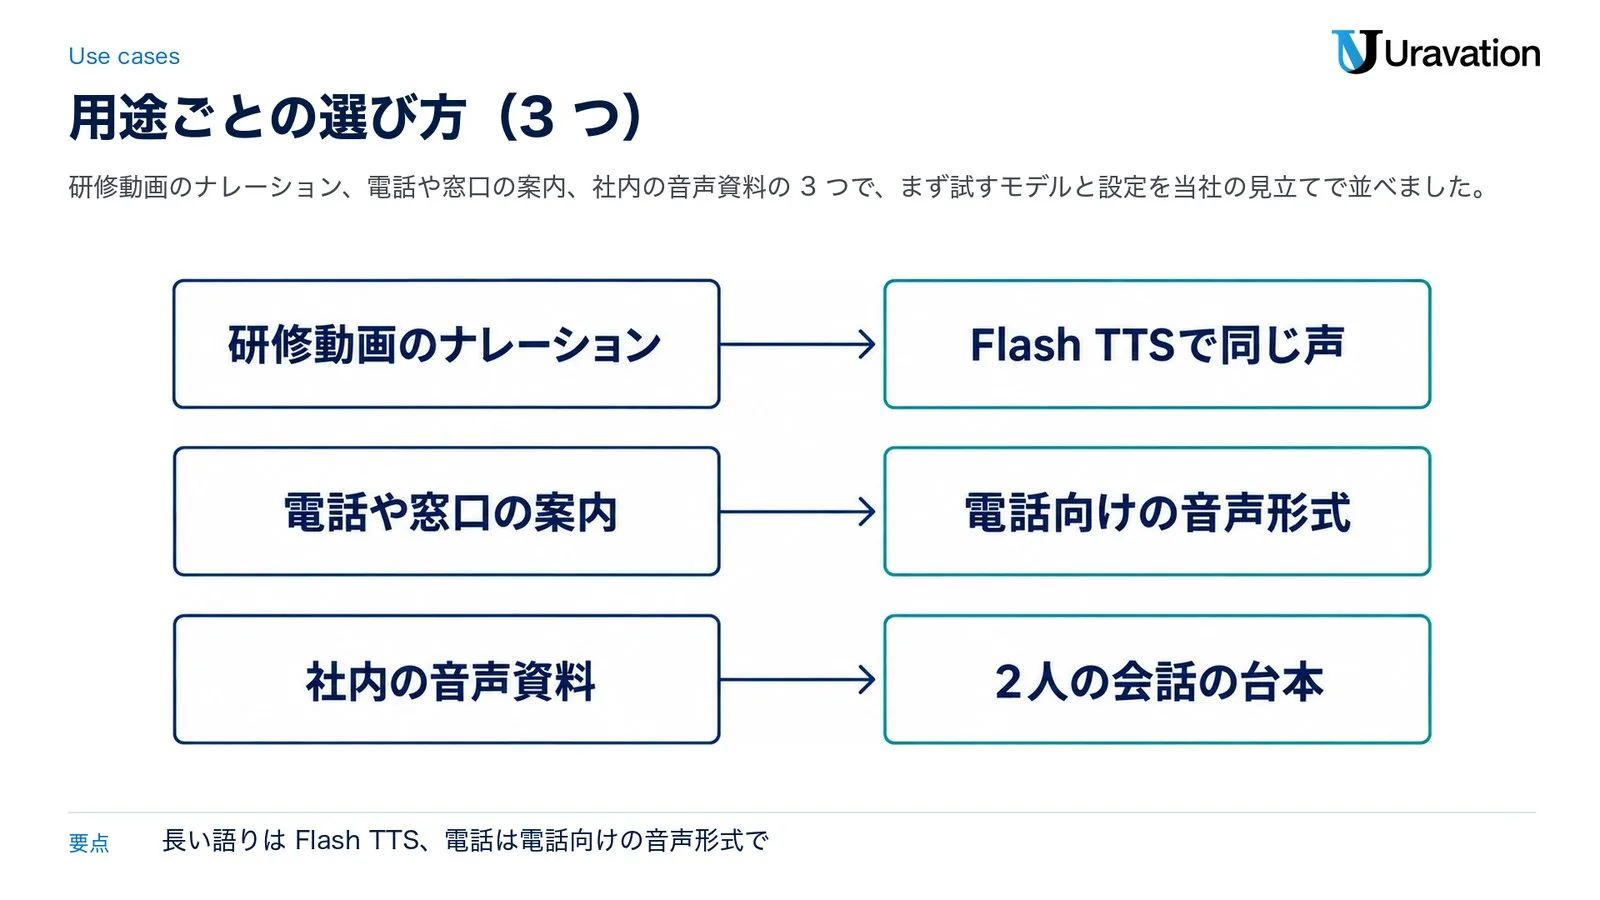
会社で使いどころになりやすいのは、研修動画のナレーション、電話や窓口の案内、社内の音声資料の 3 つです。ドキュメントに書かれた機能と Google の用途の説明をもとに、まず試すモデルと気をつける点を当社の見立てで並べました。
| 用途 | まず試すモデル | 使う機能・設定 | 気をつける点 |
|---|---|---|---|
| 研修動画のナレーション | Flash TTS | 同じ声で章ごとに作る | 1 回で作れる長さ・声の複製の同意 |
| 電話や窓口の案内 | Flash-Lite TTS | 電話向けの音声形式・ストリーミング | 自動の音声だと伝えるかを決める |
| 社内の音声資料 | 2 人の会話は Flash TTS、1 人の読み上げは Flash-Lite TTS | 2人の会話の台本 | 無料枠に社外秘の資料を入れない |
研修動画のナレーション
ドキュメントは、声と部屋の響きを長く安定させたいナレーションには Flash TTS をすすめていて、発表も、数時間の音声でも話者の音色のぶれを小さく保てると書いています。ただし、1 回の呼び出しの出力には 16,384 トークンの上限がある(モデルのページ)ので、長い台本は章ごとに分けて作るつもりで準備しておくと安心です。全部の章を同じ声の名前か同じ voice_... の ID で作り、style は空か、短い同じ指示にそろえると、章ごとの声のぶれを抑えやすい、とドキュメントは書いています。動画の作成に Google Vids を使っている会社は、発表で Flash-Lite TTS が Google Vids に入ると書かれている点も見ておくとよいです。
電話や窓口の案内
出力の形式は response_format で替えられ、ドキュメントの表には G.711 μ-law(audio/mulaw・8 kHz)が「北米と日本の電話で広く使われる」形式として載っています。これが電話向けの音声形式です。欧州と国際の電話で使われる A-law(audio/alaw)もあります。
電話の自動応答のように AI の応答の文を次々に読み上げる仕組みは、Flash-Lite TTS が向く用途として挙がっています。ドキュメントのすすめは、AI の応答の文が届くたびに 1 回ずつ TTS を呼ぶこと、長い応答は短く分けること、話者の人物設定を毎回送らないことです。ストリーミングを使えば、作りながら少しずつ音声を流せます。相手の声を聞きながらその場で話す会話そのものは、TTS ではなく Live API の役割です(「他の音声AIとの違い」の節)。案内の冒頭で自動の音声だと伝えるかどうかは、社内で決めておきましょう。
社内の音声資料
社内の手引きや週報を、聞いて分かる音声にする使い方です。2人の会話の台本にすると、ラジオの対談のような形にできます。ドキュメントは、込み入った 2 人の会話には Flash TTS をすすめていて、2 人の声が重なる話し方も Flash TTS のほうがうまくいくと書いています。1 人の読み上げは、Flash-Lite TTS が向く用途として挙がっています。発表では、Gemini Notebook に Flash TTS が入ると書かれています。社外秘の資料を台本にする時は、無料枠ではなく有料の段階で扱います(理由は「使う前の注意」の節)。
Uravation ならこう選ぶ
当社なら、まず無料枠の AI Studio で、外に出ても困らない台本を使って声と話し方を決めます。社内の資料や顧客の情報が入る台本を扱う段階になったら、有料の段階のプロジェクトか Google Cloud に切り替えます。研修動画のような長い語りは Flash TTS、電話の案内や大量の読み上げは Flash-Lite TTS から試し、2027年1月1日からの値上がりも入れて費用を見積もります。声の複製は、本人の同意の録音と社内の承認がそろってから使います。
他の音声AIとの違い|Gemini 3.8 Live・Qwen3-TTS・文字起こし
「音声の AI」と呼ばれるものには、読み上げ・会話・文字起こしの 3 つの向きがあります。Gemini TTS は、決まった台本を読み上げる側です。近い 3 つと並べると、次のとおりです(各セルは、表の下の公式の資料に書かれている範囲だけを書いています)。
| 名前 | 何をするものか | 入力と出力 | 使う形 |
|---|---|---|---|
| Gemini TTS(3.8 Flash TTS・3.8 Flash-Lite TTS) | 台本をそのとおりに読み上げ、話し方を細かく指示できる。ポッドキャストやオーディオブックのような場面向け | テキスト → 音声 | Gemini API・Google AI Studio・Google Cloud |
| Gemini 3.8 Live | 遅延の少ない音声エージェントの会話に使う、Live API の既定のモデル | 音声などを入れて音声で返す、双方向のやり取り | Gemini API の Live API |
| Qwen3-TTS | Qwen が公開した音声合成のモデルの一群。声の複製や、言葉での声の作成に対応。対応は日本語を含む 10 言語 | テキスト → 音声 | 公開されたモデルを入手して自分の環境で動かす(Apache 2.0 のライセンス) |
| Gemini 3.5 Transcribe | 遅延の少ない文字起こしのモデル。話している人の区別や、語ごとの時刻に対応 | 音声 → テキスト | Gemini API |
資料は、Gemini TTS と Live API の違いが音声生成のドキュメントの冒頭、Gemini 3.8 Live と Gemini 3.5 Transcribe の説明がモデル一覧、Qwen3-TTS が GitHub の README とライセンスのファイルです。
選び分けは、台本を読むか、相手と話すかで決まります。音声生成のドキュメントは、TTS を「台本を正確に読み上げ、話し方と音を細かく調整したい場面」向け、Live API を「相手とやり取りする、台本の無い会話」向けと分けています。研修動画のナレーションや決まった案内なら TTS、問い合わせの相手の話を聞いてその場で答えるなら Live API です(Gemini 3.8 Liveとは|裏でタスク実行する音声AIの料金と使い方)。会議の録音を文字にして議事録を作るなら、逆向きの文字起こしです(Gemini 3.5 Transcribeとは|精度と料金)。
同じ読み上げの Qwen3-TTS との違いは、使う形です。Gemini TTS は Google のサービスとして呼び出し、有料の段階では使った分だけ料金がかかり(無料枠の標準の利用は無料)、データの扱いは Google の規約に従います。Qwen3-TTS は Apache 2.0 のライセンスでモデルが公開されていて、入手したモデルを自分の環境で動かせます(README には Alibaba Cloud の API で使う道も載っています)。使い方と商用利用の考え方は、Qwen3-TTSとは|使い方・日本語対応・商用利用にまとめています。
Gemini TTSを使う前の注意|無料枠のデータ・なりすまし・透かし
会社で使う前に確かめたいのは、送るデータの扱いと、人の声の扱いの 2 つです。規約・禁止の方針・ドキュメントから、確かめる 6 つを先に並べます。
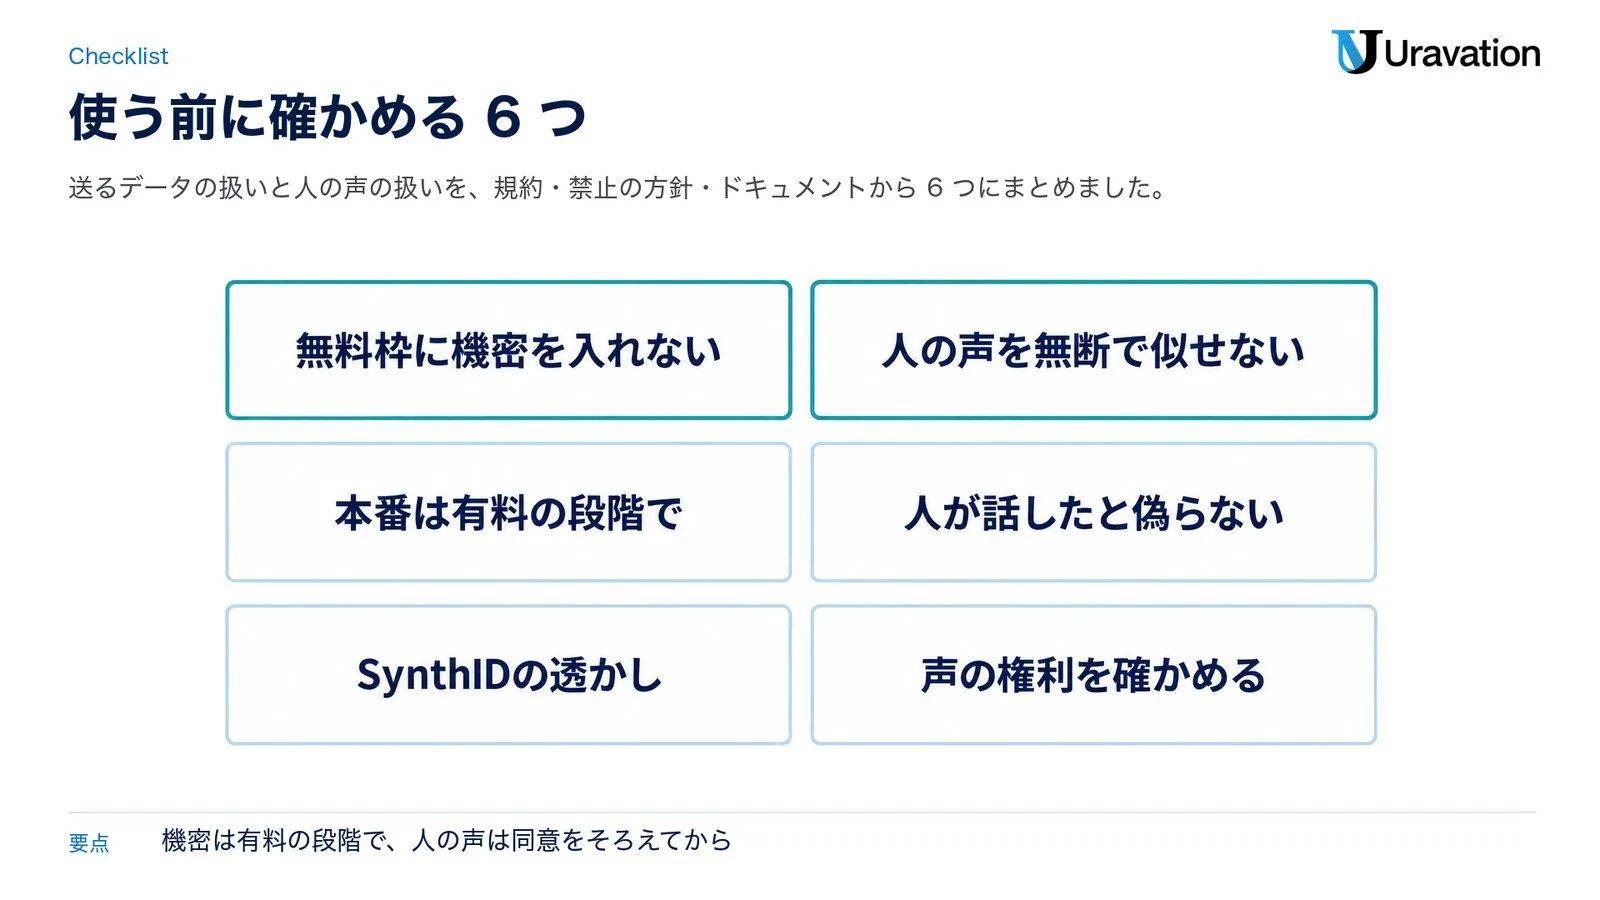
- 無料枠に機密を入れない:送った台本と作った音声は、製品の改善に使われ、人が読むことがあります
- 本番は有料の段階で:社内の資料や顧客の情報が入る台本は、有料の段階か Google Cloud で扱います
- 人の声を無断で似せない:声の複製には、声の持ち主の同意の録音が要ります
- 人が話したと偽らない:人をだます目的で、AI で作った音声を人だけが作ったものと偽ることや、明示せずに個人になりすますことは、禁止の方針に当たります
- SynthIDの透かし:作った音声には、聞いても分からない透かしが入ります
- 声の権利を確かめる:実在の人に似た声は、本人の同意と社内の承認を記録に残します
無料枠と有料の段階で、データの扱いが変わる
Gemini API の追加の利用規約(2026年3月23日発効)では、Google AI Studio を直接使う場合や Gemini API の無料枠は「無料のサービス」です。無料のサービスに送った内容と作られた応答は、Google の製品や機械学習の技術の提供・改善・開発に使われます。品質の向上のために人が入力と出力を読み、注釈を付けることもあり、その前に Google アカウント・API キー・Cloud プロジェクトとの結び付きを切る、と書かれています。そのうえで規約は、機密や個人の情報を無料のサービスに送らないよう求めています。
有料のサービスでは、入力と応答を製品の改善に使いません。ただし、禁止の方針に反する使い方を見つけて防ぐためなどに、一定の期間ログを残すと書かれています。Gemini API が有料扱いになるのは、有効な請求先アカウントにつながったプロジェクトから使う時だけです。AI Studio は、有効な請求先アカウントのある Cloud プロジェクトを使えるアカウントか、Workspace の enterprise のアカウントで使うと、無料で使っていても有料扱いになります。欧州経済領域・スイス・英国では、無料のサービスにも有料のデータの扱いが当てはまります。規約は、使う人が 18 歳以上であることと、18 歳未満の人に向けた、または 18 歳未満の人が使う可能性の高いサイトやアプリなどの一部として使わないことも求めています。
なりすましの禁止と、声の複製の決まり
Google の生成 AI の禁止の方針(2024年12月17日改定)は、次の使い方を禁じています。
- 人をだます目的で、そのことを明示せずに、存命か故人かを問わず個人になりすますこと
- 人をだます目的で、作った内容を人だけが作ったものだと偽り、出どころを偽ること
- 法律で必要な同意なしに個人のデータや生体の情報を使うなど、他人の権利を侵すこと
声の複製(Voice replication)のドキュメントでは、同じ大人の話者の録音を 2 つ用意する決まりです。1 つは複製したい声の 10〜30 秒の録音、もう 1 つは本人が決まった同意文を読み上げた録音です(発表は「30 秒のサンプル」と書いています)。合成した音声や、SynthID の透かし・C2PA(作られた経緯を記録する仕組み)の印が入った音声は受け付けません。使えるのは有料の段階(Tier 1 以上)のプロジェクトです。発表の注記によると、AI Studio の画面からの声の複製は、米国のイリノイ州・テキサス州、欧州経済領域、英国、スイス、インドでは使えません。API のドキュメントは、欧州経済領域・英国・スイスを含む対応地域で使えると書いていて、画面と API で扱いが違います。
SynthID の透かしは、聞いても分からない
発表によると、Gemini の音声のモデルで作ったすべての音声には、人の耳では分からない SynthID の透かしが入り、AI が作った音声だと機械で見分けられるようにしています。発表は、声の複製について、組み込みの同意の確認・SynthID の透かし・C2PA の証明情報で、開発者と声の持ち主の両方を守ると書いています。透かしは聞く人が気づくための物ではないので、社外に出す音声で AI の声だと伝えるかは別に決めておきます。透かしの見分け方の道具については、SynthID Detectorが一般公開|AI画像・動画・音声の見分け方と限界で説明しています。
人の声に似せる時は、声の権利も確かめる
東京地方裁判所は2026年9月30日の判決で、人の声は肖像と同じく個人の人格の象徴で、実演家の声などを無断で使う行為は、声に顧客吸引力(商品の販売などを促す力)があり、専らその利用を目的とする場合にはパブリシティ権の侵害に当たると解するのが相当、という考え方を示しました。パブリシティ権は、人の氏名や肖像が持つ顧客吸引力を、本人が独占して使える権利として裁判例の中で認められてきたものです。一般の人の声がどこまで対象になるかは、この判決からは分かりません。この事件の請求は棄却され、問題の動画が侵害に当たるかは判断されていません(第一審)。判決が示した条件と、AI の音声を使う会社が確かめておく点は、声もパブリシティ権の対象に|東京地裁判決とAI音声にまとめています。社員や役員の声を複製して研修動画に使う場合も、本人の同意と社内の承認を書面で残すまでは使わないでください。
よくある質問
Gemini TTSは無料で使えますか?
2026年11月15日時点の Gemini API の料金ページでは、Gemini 3.8 Flash TTS と Gemini 3.8 Flash-Lite TTS の標準の利用は、無料枠で入力・出力とも無料です。ただし、無料枠で送った台本と作った音声は Google の製品の改善に使われ、人が読むことがあるので、規約は機密や個人の情報を送らないよう求めています。有料の段階では改善に使われませんが、禁止の方針に反する使い方を防ぐためなどに、一定の期間ログが残ります。AI Studio は、有効な請求先アカウントのある Cloud プロジェクトを使えるアカウントか、Workspace の enterprise のアカウントで使うと、無料で使っていてもデータの扱いは有料のサービスと同じになります。ほかに、バッチは無料枠では使えず、使える回数の上限は AI Studio のレート制限の画面で確かめます。声の複製は有料の段階(Tier 1 以上)のプロジェクトでないと使えません。
Gemini TTSは日本語に対応していますか?
対応しています。音声生成のドキュメントの対応言語の表で、日本語は 2 つのモデルの両方に対応の印が付いていて、台本の言語は自動で判定されます。日本語の台本でも、<short pause> のようなタグは英語のまま書くのがドキュメントのすすめです。定番の声が日本語でどう聞こえるかは、AI Studio で外に出ても困らない台本(機密や個人の情報を含まない物)を入れて確かめてください。
Gemini 4に音声合成のモデルはありますか?
2026年11月15日時点で、Gemini 4 の系統の音声合成のモデルは確かめられませんでした。Gemini 4 Carbon・Argon・Hydrogen のモデルのページでは、出力はテキストだけで、音声生成は「対応していない」と表示されています。音声合成の最新は、2026年9月に公開された Gemini 3.8 Flash TTS と Gemini 3.8 Flash-Lite TTS です。Gemini API の前のプレビュー版の 3 モデル(gemini-3.1-flash-tts-preview・gemini-2.5-flash-preview-tts・gemini-2.5-pro-preview-tts)は、最短で2026年12月18日に止まる予定です。
Flash TTSとFlash-Lite TTSはどちらを選べばいいですか?
表現と演技の細かさを重視するなら Flash TTS、大量の生成・速さ・費用を重視するなら Flash-Lite TTS です。ドキュメントは、オーディオブックや込み入った 2 人の会話、長いナレーションに Flash TTS を、大量の生成・リアルタイムの音声エージェント・ふだんの 1 人の読み上げに Flash-Lite TTS をすすめています。2 つは同じ書き方で呼べるので、モデル ID を替えるだけで聞き比べられます。
Vertex AI(Google Cloud)でも使えますか?
使えます。Vertex AI を発展させた Gemini Enterprise Agent Platform の API と Agent Studio で、2 つのモデルとも一般提供と、Google Cloud の Cloud Text-to-Speech の Gemini-TTS のページ(2026年11月10日更新)に書かれています。ただし、言葉で声を作る機能と声の複製はプレビューです。また、2 つのモデルは Cloud Text-to-Speech API からは使えません。使える場所は global・us・eu の 3 つで、自分で作った声は global だけです。料金の扱いは「料金と無料枠」の節で説明しています。
社員の声を複製して使えますか?
条件を満たせば、声の複製(Voice replication)でできます。条件は、有料の段階(Tier 1 以上)のプロジェクトであること、同じ大人の話者の 10〜30 秒の声の録音と、本人が同意文(日本語の文もある)を読み上げた録音をそろえることです。AI Studio の画面からの複製は、発表の注記によると米国のイリノイ州・テキサス州、欧州経済領域、英国、スイス、インドでは使えません。作った音声には SynthID の透かしが入ります。社員の声でも、本人の同意と社内の承認を書面で残すまでは使わないでください。
まとめ
Gemini TTS は、Gemini API で台本の文章を音声にする音声合成のモデルで、2026年11月15日時点の最新は Gemini 3.8 Flash TTS と Gemini 3.8 Flash-Lite TTS です。Gemini 4 の系統に音声合成のモデルは確かめられず、Gemini API の前のプレビュー版の 3 モデルは最短で2026年12月18日に止まる予定です。日本語は 2 つのモデルとも対応言語の表に入っています。
無料枠で試せますが、送った内容は Google の製品の改善に使われます。社内の資料を扱う時は有料の段階に切り替え、2027年1月1日からの値上がりも見込んでおきましょう。
次にやることは 3 つです。
- AI Studio で、外に出ても困らない台本を入れて、2 つのモデルと声を聞き比べる
- 研修動画・電話の案内・社内の音声資料のどれに使うかを決め、2027年1月1日からの単価で費用を見積もる
- 有料の段階への切り替え、声の複製の同意の取り方、AI の音声だと伝えるかどうかを社内の決まりにする
参考・出典
- Gemini 3.8 text-to-speech says hello — Google(2026年9月23日・参照日: 2026-11-15)
- Gemini 3.8 音声合成モデルを発表 — Google Japan ブログ(2026年9月23日・参照日: 2026-11-15)
- Text-to-speech generation (TTS) — Gemini API ドキュメント(参照日: 2026-11-15)
- Gemini 3.8 Flash TTS・Gemini 3.8 Flash-Lite TTS — Gemini API のモデルのページ(参照日: 2026-11-15)
- Models — Gemini API のモデル一覧(参照日: 2026-11-15)
- Gemini 4 Carbon — Gemini API のモデルのページ(Argon・Hydrogen のページも同じ項目を確認・参照日: 2026-11-15)
- Gemini Developer API pricing — Gemini API の料金ページ(参照日: 2026-11-15)
- Release notes — Gemini API の更新履歴(2026年11月12日の分まで・参照日: 2026-11-15)
- Gemini deprecations — Gemini API の非推奨のページ(参照日: 2026-11-15)
- Voice replication — Gemini API ドキュメント(参照日: 2026-11-15)
- Rate limits・Billing・API keys・Batch API・Flex inference・Priority inference — Gemini API ドキュメント(参照日: 2026-11-15)
- Gemini API Additional Terms of Service — Google(2026年3月23日発効・参照日: 2026-11-15)
- Generative AI Prohibited Use Policy — Google(2024年12月17日改定・参照日: 2026-11-15)
- Generate speech with Gemini TTS — Google Cloud ドキュメント(2026年11月12日更新・参照日: 2026-11-15)
- Gemini-TTS(Cloud Text-to-Speech) — Google Cloud ドキュメント(2026年11月10日更新・参照日: 2026-11-15)
- Agent Platform Pricing — Google Cloud(参照日: 2026-11-15)
- Introducing Gemini Enterprise Agent Platform — Google Cloud ブログ(2026年4月23日・参照日: 2026-11-15)
- NotebookLM is now Gemini Notebook — Google(2026年7月16日・参照日: 2026-11-15)
- QwenLM/Qwen3-TTS(README・LICENSE) — GitHub(参照日: 2026-11-15)
この記事の内容を社内展開する方へ: 生成AI 料金・プラン早見表 2026年10月版(無料・PDF 35ページ+Excel) をダウンロードできます。